ARTICLE · 1055503
腾讯开源WeKnora 0.8.0:从文档检索到“动手”执行,知识库的架构升级
9月18日,腾讯WeKnora正式发布0.8.0版本。这个由微信AI团队主导开源的知识管理框架,在解决了“检索”之后,开始向“执行”延伸。
从“动嘴”到“动手”的架构跨越
传统企业知识库的痛点一直很明确:知识躺在文档里,模型能把答案说得头头是道,但真要落地干活,中间缺了手脚。
WeKnora 0.8.0 的核心突破,在于引入了 Skill Sandbox Runtime(技能沙箱运行时)。
这个机制允许系统把知识库里的内容封装成“技能”,在 Docker、E2B 或 CubeSandbox 等沙箱环境中安全执行。这意味着,模型不再是只输出文本建议,而是可以直接调用技能去跑数据、做计算,最后返回经过验证的结果。
图 · 图片来自开源知识库项目WeKnora技术拆解- Petter
要实现这个闭环,底层架构的模块化设计是基础。WeKnora 后端采用 Go 语言开发,前端界面则基于 Vue.js,整个系统通过 gRPC 协议协调各个微服务。
文档处理模块被抽离为独立的 docreader 服务,专门负责解析。这里有一个有趣的技术取舍:解析模块采用 Python 编写。虽然 Go 语言在并发性能上更有优势,但 Python 在 OCR(图像文字识别)、PDF 解析、Word 文档处理等领域拥有极其成熟的第三方库生态(如 PaddleOCR、python-docx、pypdf 等)。
为了弥补 Python 的性能短板,WeKnora 在解析端使用了 ProcessPoolExecutor 实现真正的多核并行处理,并通过异步消息队列(基于 Redis 的 Asynq)将耗时的文档解析、向量化任务与用户请求剥离开。据微信 AI 团队开源 WeKnora:知识库 的技术拆解显示,系统在创建知识条目时立即采用异步处理模式,无论是文件上传、URL内容还是文本段落,都会启动独立的 goroutine 进行后台处理。文档首先通过 docReaderClient.ReadFromFile 进行解析和分块,这种设计确保了用户请求不会被漫长的解析过程阻塞。
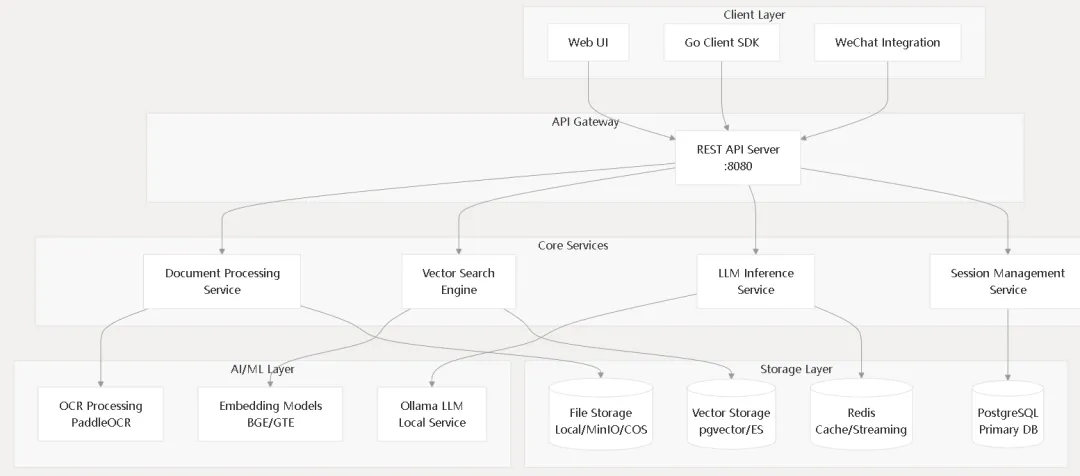
图 · 图片来自开源知识库项目WeKnora技术拆解- Petter
在检索与推理层面,WeKnora 引入了 anydoc 解析与 GraphRAG 技术。普通的 RAG 通常是向量检索、把相关片段捞出来拼给模型,而 GraphRAG 更进一步,把实体和关系抽出来建成图,回答“事物之间怎么关联”这类问题时,比纯向量检索靠谱得多。它能把 PDF 或网页文档自动整理,构建出实体关系图谱以支持深度推理。
这种架构设计,让知识库具备了“自治”的能力。
在 0.8.0 版本中,除了沙箱执行,系统还引入了 Wiki Mode(Wiki 模式)。Agent 能够自动从杂乱的原始文档中提炼知识,生成相互链接的 Markdown 知识库,并构建可视化的知识图谱。更关键的是,这套 Wiki 支持人工作用的介入:用户可以像管理普通文档一样,查看修订历史、进行行级对比(Diff),甚至一键回滚。
加上长期记忆(Long-term Memory),这套框架的意图很完整:解析、组织、检索、执行、记忆,一条龙。架构是模块化的,按需取用,许可证用的 MIT——开源友好,商用没负担,这也是它敢说自己面向“从个人到企业”的底气。根据 WeKnora-p 的贡献指南,该项目明确允许商业使用,包括 SaaS 与企业内部部署,同时提供“按现状”服务的免责声明,无额外担保,进一步降低了企业的商用门槛。
GraphRAG 与多源数据接入
如果说沙箱是 WeKnora 的手脚,那么检索引擎就是它的眼睛。
传统的 RAG(检索增强生成)主要依赖向量检索,把相关的文本片段捞出来拼给模型。这种方式在处理“事实查找”时很有效,但在回答“事物之间如何关联”这类需要深度推理的问题时,往往力不从心。
WeKnora 引入了 GraphRAG(知识图谱增强检索) 技术。它不再只是单纯地切片文档,而是自动提取文档中的实体和关系,构建出实体关系图谱。
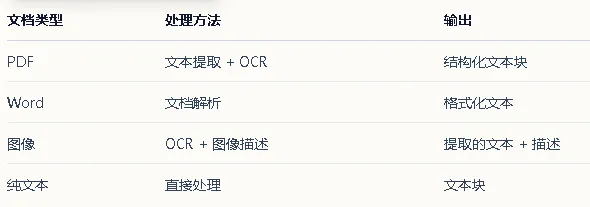
图 · 图片来自开源知识库项目WeKnora技术拆解- Petter
在向量数据库的选择上,WeKnora 展现出了极高的开放性。除了主流的 PostgreSQL(pgvector)和 Elasticsearch,官方文档还给出了集成 Apache Doris 4.1 的参考实现。
Apache Doris 是一种 MPP 架构的分析型数据库,WeKnora 通过 MySQL 协议进行 CRUD 操作,通过 HTTP API 调用 Stream Load。
在表结构设计上,Doris 的实现很有代表性:每个 embedding 维度对应一张物理表(如 weknora_embeddings_768),并通过 enable_unique_key_merge_on_write 支持流式数据的部分更新。
据 WeKnora 文档,针对 Apache Doris 的索引配置也颇为精细:倒排索引(INVERTED)涵盖 chunk_id、knowledge_id 等字段用于过滤,并对 content 字段配置 parser=chinese 以支持中文全文检索;同时在 embedding ARRAY 列上构建 ANN 索引(HNSW + cosine_distance)。在查询时,系统通过 HAVING score >= ? 进行阈值比较,再按 ORDER BY score DESC LIMIT ? 排序,从而兼顾召回率与响应速度。
这种对多源数据的深度支持,让 WeKnora 能够直接对接飞书知识库、飞书云盘、GitLab、Tencent IMA、Notion、语雀、钉钉文档和 RSS 等多种数据源。知识不再是孤立的文件,而是变成了流动的资产。
这种流动性也体现在文档处理环节。据微信 AI 团队开源 WeKnora:知识库介绍,WeKnora 提供了 anydoc 解析能力,PDF、Word、Markdown、网页等多种格式可以直接进入系统,无需预先转换格式。配合 Wiki 模式,它能将杂乱的文档自动整理成结构化的知识体系。在底层实现上,文档首先通过 docReaderClient.ReadFromFile 进行解析和分块,无论是文件上传、URL 内容还是文本段落,都会启动独立的 goroutine 进行后台异步处理,确保在创建知识条目时采用异步处理模式,不影响主线程响应速度。
许可证争议:MIT 还是 AGPL-v3?
关于 WeKnora 的许可证类型,开源中国 报道称其采用 MIT 许可证。MIT 协议非常宽松,允许企业自由商用、修改代码,只需保留版权声明即可。这解释了为什么 WeKnora 敢自称为“从个人到企业”都适用的框架。
然而,GitHub 用户 xiaohuangpin 发布的 WeKnora-pro 版本 却基于 AGPL-v3 许可证 发布。AGPL-v3 是著名的“传染性”极强的协议,如果通过网络提供服务,就必须公开所有衍生代码的完整源码。
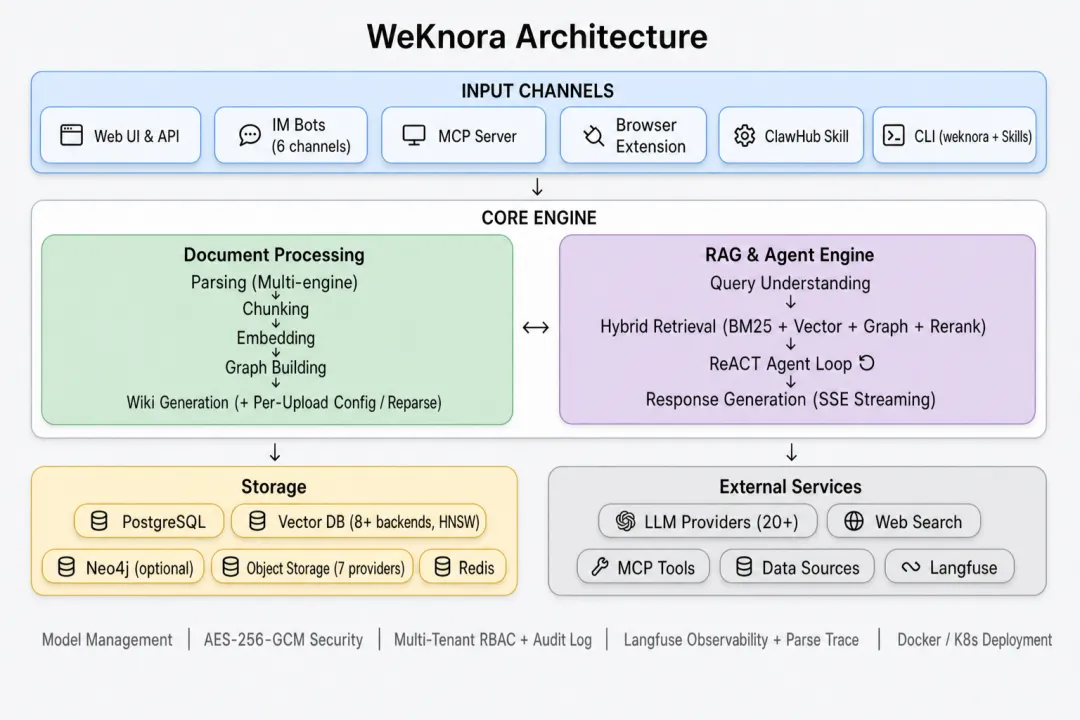
图 · 图片来自3个维度深度解析WeKnora:从文档孤岛到智能知识
这种分歧在开源社区并不罕见,但也带来了实际的使用困惑:
01官方原版:据 GitHub 官方仓库信息,Tencent/WeKnora 拥有 27991 个 Star。
02社区增强版:xiaohuangpin/WeKnora-pro 则获得了 121 个 Star。
WeKnora-pro 并非简单的复刻,它在原版基础上做了显著的增强。例如,它将文档解析的大小上限从原版的限制提升到了 300 MB,并通过 Mineru-API 支持了更强大的 OCR 与表格提取功能。
如果你是一家对代码合规性要求极高的企业,在接入 WeKnora 时,必须明确区分:你使用的是腾讯官方的 MIT 协议版本,还是社区基于 AGPL-v3 发布的增强版本。前者可以闭源商用,后者则可能面临开源义务的风险。
值得注意的是,腾讯官方原版之所以能如此“大方”地采用 MIT 协议,底气来自于其底层架构的模块化设计。据微信 AI 团队介绍,WeKnora 引入了 anydoc 解析与 GraphRAG 技术,能将 PDF、Word、Markdown 甚至网页直接输入,无需预先转换格式,即可自动整理并构建出实体关系图谱。这种“解析、组织、检索、执行、记忆”的一站式能力,让它在技术层面具备了很强的吸引力,从而让“开源友好,商用没负担”成为其核心卖点。
相比之下,社区版 WeKnora-pro 在技术实现上也有一些独特的调整。据 WeKnora 官方文档关于使用其他向量数据库的说明,原版架构中每个 embedding 维度对应一张物理表(如 weknora_embeddings_768),并构建了倒排索引(INVERTED)用于 chunk_id、knowledge_id 等字段的过滤,同时在 embedding ARRAY 列上构建 HNSW + cosine_distance 的 ANN 索引以支持向量检索。这些底层细节在增强版中可能会因硬件资源或性能优化需求而有所不同,进一步加剧了版本间的差异。
除了协议和技术实现的差异,底层执行机制也是两者区分的关键点。据微信 AI 团队开源 WeKnora:知识库的介绍,WeKnora 引入了 Skill Sandbox Runtime 机制,允许将知识库内容封装为技能并在 Docker 沙箱中安全执行,从而生成可验证结果。这种设计配合长期记忆(Long-term Memory),构成了“解析、组织、检索、执行、记忆”的完整闭环。而在处理流程上,据开源知识库项目 WeKnora 技术拆解 - Pe 的分析,系统在创建知识条目时采用异步处理模式,无论是文件上传、URL 内容还是文本段落,都会启动独立的 goroutine 进行后台处理。文档首先通过 docReaderClient.ReadFromFile 进行解析和分块,这种异步解耦的设计进一步降低了实时调用的延迟,也是官方版本在性能体验上保持优势的原因之一。
可观测性与工程化细节
WeKnora 不仅仅是一个原型项目,它具备企业级产品的工程化细节。
系统集成了 Langfuse 进行全面的可观测性监控。在 Agent 执行复杂任务时,Langfuse 能够追踪每一个推理步骤、Token 消耗以及管道流转情况。
此外,WeKnora 提供了 360 多个 API 端点 和 150 多个环境变量 供配置。从 API 的设计来看,它支持 Scoped API Keys(作用域受限的 API 密钥),允许开发者为不同的租户分配不同权限的访问令牌。
在消息流转方面,WeKnora 采用了 Redis Stream 配合 SSE(Server-Sent Events)机制。当用户发起提问时,系统不仅能流式推送 LLM 的回答,还能实时展示检索到的知识片段和 Agent 的执行进度。
图 · 图片来自3个维度深度解析WeKnora:从文档孤岛到智能知识
这种设计在用户体验上带来了直观的提升:用户不再面对一个黑盒,而是能清晰地看到知识是如何被提取、推理并转化为结果的。
底层架构的模块化设计也是其工程化的重要体现。据微信 AI 团队开源 WeKnora:知识库介绍,该框架采用了模块化架构,支持按需取用,且基于 MIT 许可证开源,允许商业使用(包括 SaaS 与企业内部部署),同时提供“按现状”服务的免责声明,为面向个人到企业级的落地扫清了合规障碍。
在数据处理与执行引擎上,WeKnora 同样具备深度的工程考量。据微信 AI 团队开源 WeKnora:知识库,框架引入了 anydoc 解析 技术,能够直接处理 PDF、Word、Markdown 及网页文档,无需格式转换即可自动整理为结构化知识体系,并配合 Wiki 模式构建知识图谱。配合 GraphRAG 技术,系统不仅进行普通的向量检索,更通过抽取实体与关系构建图谱,在回答“事物之间如何关联”这类复杂问题时比纯向量检索更可靠。
此外,系统通过 SkillSandboxRuntime 机制,允许将知识库内容封装为技能并在 Docker 沙箱中安全执行,从而生成可验证结果。结合长期记忆(Long-term Memory),WeKnora 实现了从解析、组织、检索、执行到记忆的全链路闭环。
在底层存储与检索优化方面,据 WeKnora/docs/使用其他向量数据库,系统支持表结构与维度分表(如 weknora_embeddings_768),并采用倒排索引(INVERTED)对 chunk_id、knowledge_id 等字段进行过滤,同时针对 content 字段开启 parser=chinese 以支持中文全文检索,进一步夯实了工程化底座。
这种检索优化的深度还体现在对 ANN 索引的精细控制上。据 WeKnora/docs/使用其他向量数据库,系统在 embedding ARRAY 列上构建基于 HNSW 算法的 ANN 索引,并使用 cosine_distance 作为距离度量。查询时通过 HAVING score >= ? 进行阈值过滤,并利用 ORDER BY score DESC LIMIT ? 进行排序。特别需要注意的是,据 WeKnora/docs/使用其他向量数据库,Doris 的 ANN 索引是在建表后异步构建的,在索引未就绪期间,查询会自动退化为 brute-force(结果正确但速度较慢),这要求运维在上线初期对性能预期有清晰认知。同时,对于关键词检索,系统依赖 Doris 内建的 MATCH_ANY 与 chinese parser,无需在 Go 端额外引入 jieba 分词,简化了技术栈依赖。
在数据入库的执行层面,据开源知识库项目WeKnora技术拆解- Pe,系统采用了异步处理模式以提升吞吐量。无论是文件上传、URL 内容还是文本段落,系统都会启动独立的 goroutine 进行后台处理。文档首先通过 docReaderClient.ReadFromFile 进行解析和分块,这一过程支持多模态处理,包括 OCR 文字提取和图像描述生成。解析后的内容随后传递给 processChunks 方法进行向量化处理,整个链路从创建知识条目开始就实现了非阻塞式的异步流转。
为什么现在开源?
2026 年的 AI 应用市场,正在经历从“拼模型”到“拼数据”的转向。
腾讯选择在这个节点将 WeKnora 开源,释放了几个明确的信号:
WeKnora 搞出了一套标准化企业 RAG 的落地范式,从文档解析、向量化、知识图谱构建一直包办到技能执行,全套链路都开源了,企业试错成本直接打下来。微信 AI 团队透露,这框架塞进了 anydoc 解析和 GraphRAG 技术,anydoc 能直接啃 PDF、Word、Markdown 和网页这些杂乱格式,不用倒腾,再配合 Wiki 模式自动整理成结构化知识;GraphRAG 则把实体和关系抽出来建图,回答“事物咋关联”这种问题时,比纯向量检索靠谱多了。再加上长期记忆,整个解析、组织、检索、执行到记忆的闭环就通了。
除了能无缝插进微信生态的公众号和小程序,它还深度兼容飞书、GitLab、Slack、Telegram 这些主流办公协作工具,摆明了是要打造通用的企业级知识基础设施,不想只当微信的附属品。微信 AI 团队自己手里就有海量文档和复杂内部知识,开源就是为了吸引社区开发者去贡献插件,比如 ClawHub 和 SkillHub 上的技能市场,顺便优化解析算法,反过来给腾讯内部 AI 应用落地输血。架构模块化,想咋用就咋取用,许可证用的是 MIT,开源友好,商用没负担,这也是它敢喊出面向“从个人到企业”的底气。
WeKnora 的开源,标志着 AI 知识库正在从“被动问答”走向“主动执行”。当知识库不仅能告诉你“怎么做”,还能直接在沙箱里替你“跑一遍”时,AI 在垂直行业的落地门槛将被大幅降低。据微信 AI 团队开源 WeKnora:知识库,系统通过 SkillSandboxRuntime 机制,允许将知识库内容封装为技能并在 Docker 沙箱中安全执行,从而生成可验证结果。
在底层实现上,WeKnora 对高并发场景做了细致优化。据开源知识库项目 WeKnora 技术拆解- Pe,系统在创建知识条目时立即采用异步处理模式,无论是文件上传、URL 内容还是文本段落,都会启动独立的 goroutine 进行后台处理。文档首先通过 docReaderClient.ReadFromFile 进行解析和分块,且解析过程支持多模态处理,包括 OCR 文字提取和图像描述生成。
对于开发者而言,无论是直接使用官方的 MIT 协议版本,还是基于 AGPL-v3 的社区增强版,WeKnora 都提供了一个观察企业级 AI 应用架构的绝佳样本。