ARTICLE · 1055498
Hypit 深度笔记 00:105 篇文档、121 个包,这套 AI 视频框架全貌
Hypit Skill 深度阅读笔记
这是我从「会用」读到「能开发」的一份中文笔记。 7 篇正文 + 1 篇附录(外加你正在读的这份导读),从整体框架一路读到
packages/里的源码。对象:
hypit-main——skills/hypit/(给 Agent 的 Skill 文档)+packages/(实现) 版本:@hypit/hypitv0.2.9 | 实测日期:2026-09-21
0. 一句话
Hypit 是给 AI Agent(Claude Code / Codex 等)用的视频制作框架:丢一条参考视频进去,Agent 把它变成一份可编辑、可复跑的视频工程,而不是一次性渲染。
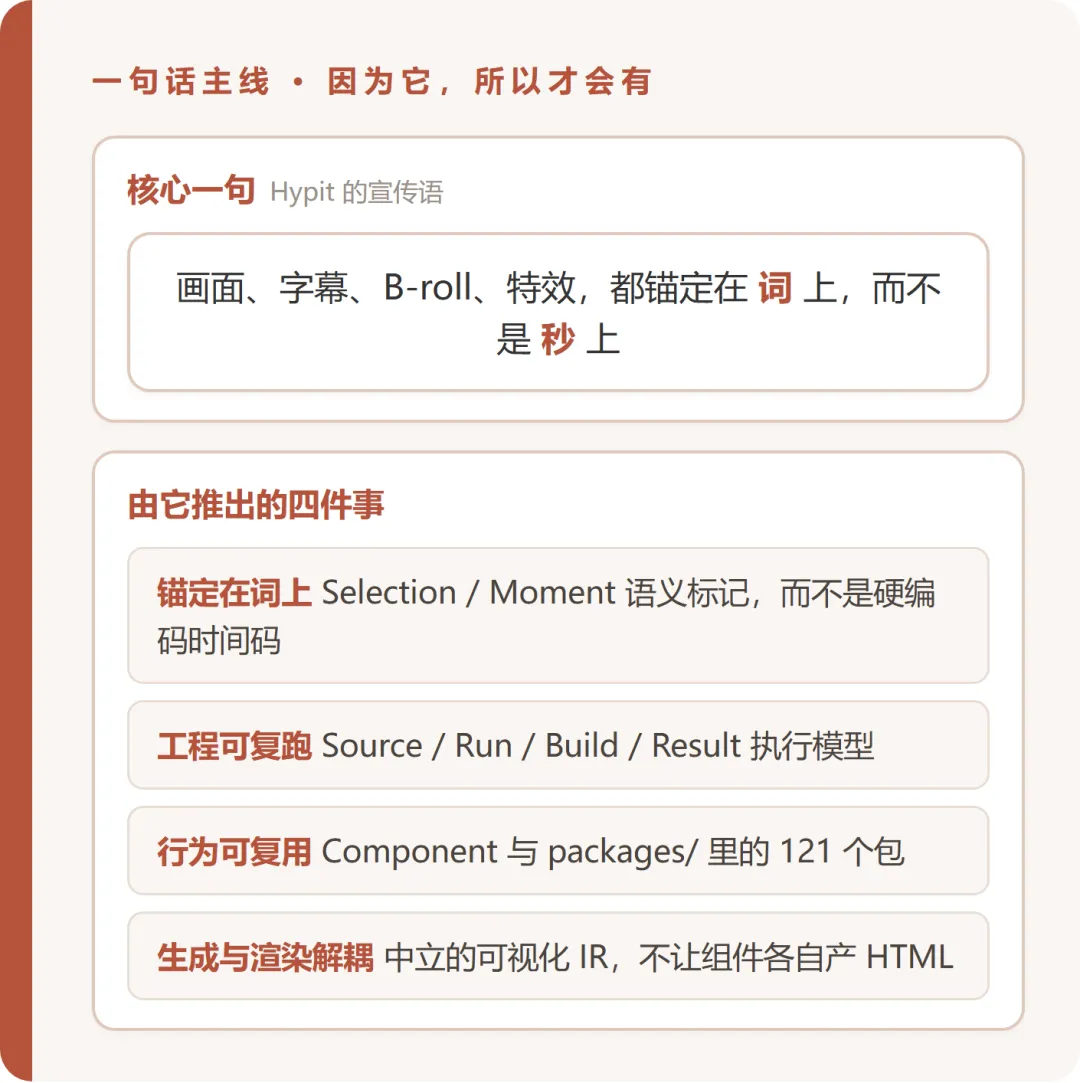
它最核心的一句话是:画面、字幕、B-roll 和特效都锚定在词上,而不是秒上。
这句话看起来只是"写得优雅",往后读你会发现它是一整条设计主线:
SelectionMoment 这类语义标记,而不是硬编码的时间码 | |
SourceRun / Build / Result 这套执行模型 | |
Componentpackages/ 里那 121 个包 | |
这份笔记要回答的就是:这一整套东西,从一行 SVML 到一条 MP4,中间到底发生了什么。
1. 这份笔记读的是什么
skills/hypit/ | 105 篇 Markdown / 13,844 行 | |
packages/ | 121 个包hypit.activation);官方发行版只选 34 个 | |
services/ | image-opencv / whisperx / yt-dlp) | |
examples/ | ranking-football、minimal-author-package、provider-package) |
说清楚边界:这份笔记只覆盖我读过并核对过的部分(约 7 篇核心文档 + 若干包的源码),不假装覆盖全库。 全库的完整清单和"接下来读什么",在 附录 A · 阅读地图。
2. 适合谁
✔ 适合你,如果你:
想深度使用:要自己做片,要知道钱花在哪一步,要改掉默认行为 想参与开发:要写自己的 Component / Model / Provider 包 已经看过 README,但读完还是不知道"这一行 during={story.selection.proof}到底发生了什么"
✘ 不适合你,如果你:
只想尽快出片 —— 直接看官方 Quickstart 和仓库 README 就够了,不需要这 8 篇 完全不想碰代码 —— 第 05~07 篇会读到 packages/*/src/*.ts
3. 章节表
SKILL.mdproduction/system.md、两张 index.md、creation/project-files.md | |||
<script>,知道"以后怎么改"由"现在怎么写"决定 | production/script-syntax.mdproduction/timing.md | ||
production/examples/ | |||
packages/markupsource、elaborator、各包的 activation.ts | |||
hypit vocabulary 查表,知道"母表"是怎么拼出来的 | packages/*/package.jsondocs/zh/guide/packages.md | ||
@hypit/ranking,知道怎么写自己的包 | packages/ranking/src/* | ||
references/ + environment/ |
4. 三条阅读路径
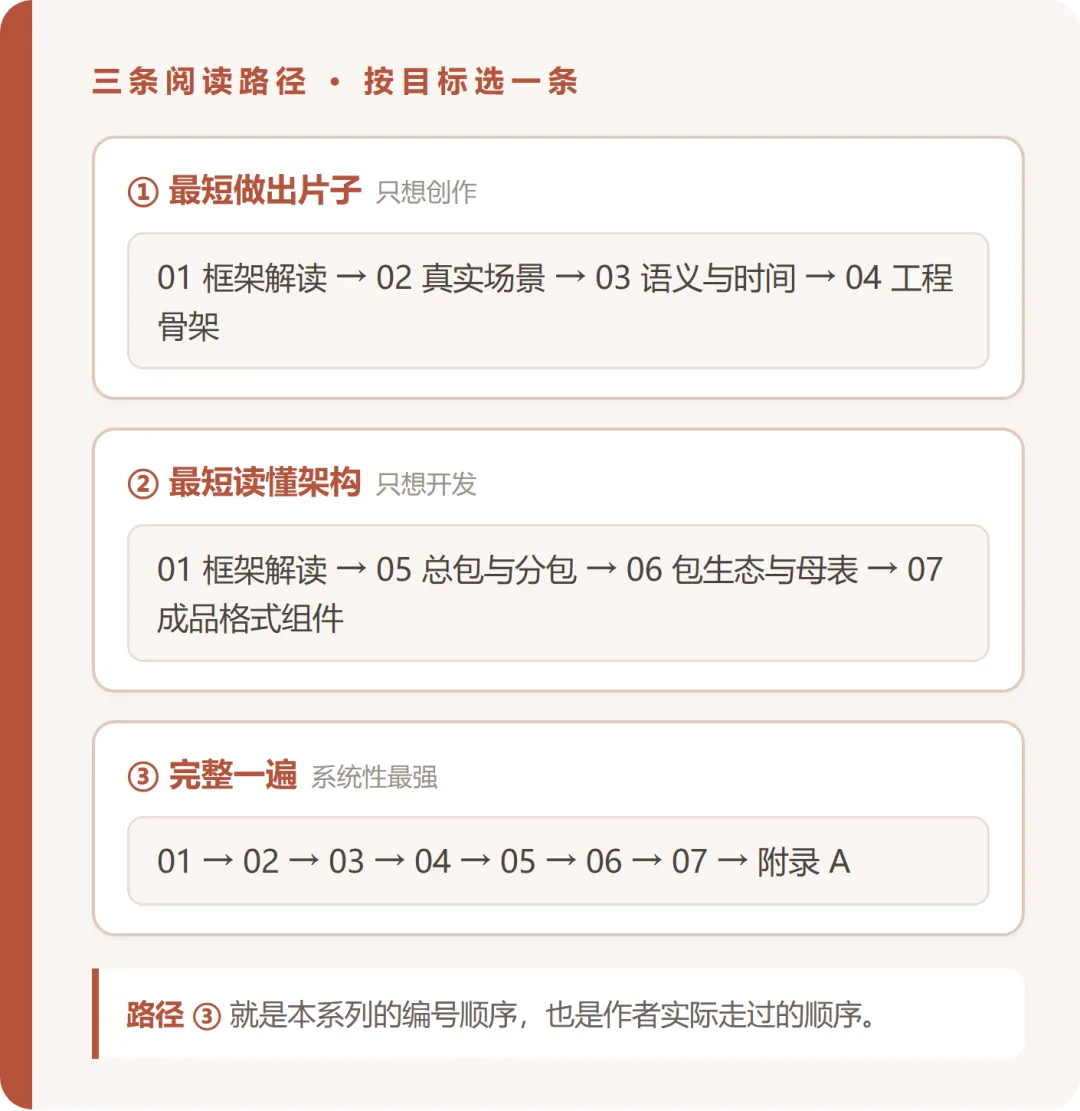
① 最短做出片子(只想创作)
01 框架解读 → 02 真实场景 → 03 语义与时间 → 04 工程骨架 理由:04 是唯一一份"能跑"的真实工程。走完这四篇,你手上的东西已经能改成自己的片子。
② 最短读懂架构(只想开发)
01 框架解读 → 05 总包与分包 → 06 包生态与母表 → 07 成品格式组件 理由:05 讲机制、06 讲生态、07 是范本。走完这三篇,你具备"照着写一个自己的包"的全部前置知识。
③ 完整一遍
01 → 02 → 03 → 04 → 05 → 06 → 07 → 附录 A 这就是本笔记的编号顺序,也是我自己实际走过的顺序。
5. 贯穿案例:山汐民宿(虚构)
后面的章节会反复用同一个案例讲事:
山汐民宿 —— 一位叫小林的主理人,在莫干山开了一家小民宿(270° 山景浴缸、手作早餐、可带宠物)。 她的诉求是:照着一条爆款"城市民宿探店"视频,做一条自己家的版本。
⚠️ 这个案例是虚构的,是为了让概念有具体落点而编的,不对应任何真实客户、真实民宿或真实视频。
为什么用一个案例贯穿:Hypit 的文档是"按主题分房间"的(时间在一个房间、组件在另一个房间),但干活是一条线。如果每章都换例子,你会记住 9 套术语却不知道它们怎么连起来。一个案例走到底,才能看见"同一个决定在不同层留下的痕迹"。
6. 版本与证据:这份笔记的可信度规则
这套框架演进很快,所以我把"可信"定义成三件可检查的事:
6.1 三类标注,互相不混
| 官方原文 | |
| 我的推论 | |
| 未验证 |
这条规则不是我发明的,是 Hypit 自己的常驻责任之一("Write what a tile, frame, clip, or transcript shows, and write your interpretation as your interpretation.")。 我把它用在自己的笔记上。
6.2 数字都给复现命令
所有"多少篇 / 多少行 / 多少个包"都写成可复现的形式,例如:
cd hypit-main/skills/hypit find . -name "*.md" | wc -l # 105 find . -name "*.md" -exec cat {} + | wc -l # 13844 你看到的数字和我不一样,是正常的 —— 那说明仓库变了,以你跑出来的为准。
6.3 版本锚定方式
这个仓库不是 git 检出(没有 commit 可引用),所以版本锚定只能写成:
@hypit/hypitv0.2.9 | 实测日期 2026-09-21 | 每条数字附命令
6.4 提前说明一处不一致
仓库里同时存在英文原文与官方中译两套文档。本笔记讲的是机制,引用以英文原文为准; 如果你只想读中文,官方中译已经覆盖得比大多数人以为的多(见 附录 A 第五节)。
7. 术语约定
规则:领域名词保留英文,叙述用中文。
这条规则来自仓库自带的官方译名基准 skills/hypit/references/production/zh/TRANSLATION-GLOSSARY.zh-CN.md, 它的依据是 Studio 官方 UI 词条和 docs/zh/**。我照它执行,理由是:保留英文你才能在源码、Studio 界面和官方文档之间对得上号。
Script | ||
Selection | ||
Moment | ||
Role Cue | ||
Dual Text | <显示|朗读> | |
Surface | ||
SemanticTake | ||
VisualTrack |
⚠️ 请把"助记法"和"官方术语"分开记:相框、图钉、场记板、台词本都不是官方叫法, 官方中译里这些词一律保留英文。我保留助记法,是因为它确实好记;但在正式场合、在代码里、在跟官方文档对照时,请用英文原词。
8. 目录
README.md ← 你在这里(导读) 01-框架解读.md 02-真实场景串联.md 03-语义与时间.md 04-工程骨架-示例走读.md 05-总包与分包.md 06-包生态与母表.md 07-成品格式组件.md 附录A-阅读地图.md 9. 证据与出处
cd skills/hypit && find . -name "*.md" | wc -l | |
packages/ | ls packages | wc -l |
grep -l '"activation"' packages/*/package.json | wc -l | |
package.json | |
skills/hypit/references/production/zh/TRANSLATION-GLOSSARY.zh-CN.md | |
README.md:"...all anchored to words instead of seconds." |
10. 我不确定 / 没验证的地方
- "121 个包"里有多少是官方发行版真正启用的
:这个我已经查清了 —— packages/video-cli/package.json的dependencies是 34 个(见 06 章 第 1 节)。 - 仓库演进速度
:本笔记全部数字来自 2026-09-21 的一次快照。官方中译看起来是正在补齐的状态,你读到时可能又多了。