ARTICLE · 1056316
AI 落地最难的一步,是把它装进你的电脑
数据资产 AI 治理项目 · 客户实践 ④
导语
前面三次现场,我们和客户把一件事讲透了:资料该怎么整理——目录怎么分、文件怎么命名、哪些该进库、哪些不该进库。
规则定完,接下来是一件更朴素的事:把这套系统,真正装到客户自己的电脑上,让它跑起来。
后来发生的一切,可能是整篇文章里最"不 AI"的部分。但它恰恰回答了一个很多人忽视的问题:
为什么那么多 AI 项目,最后没能用起来?
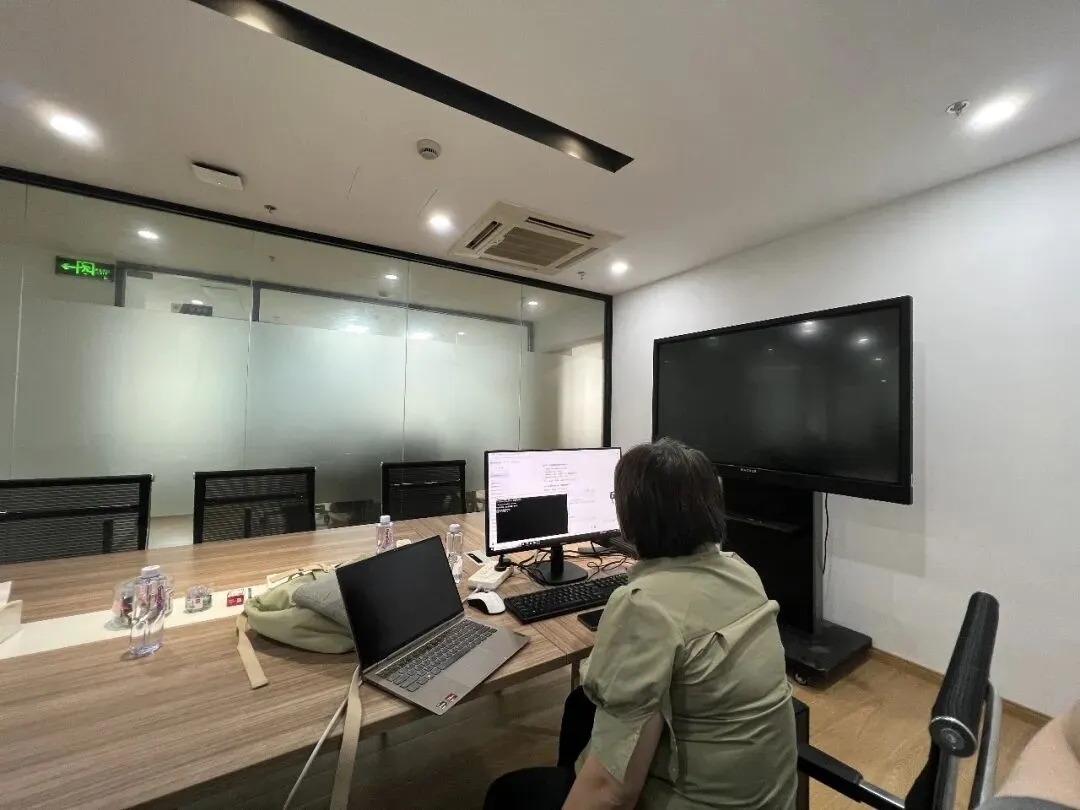
一、三个小时,围着一台电脑
原定三个小时的现场工作,一直忙到傍晚。
没有新的方法论,没有漂亮的演示,只有一个个具体得不能再具体的问题:
最后的破局办法很"土",也很有效:把已经拉好的环境打包导出,直接拷到这台电脑上重新导入——彻底绕开了现场网络这条最不稳定的链路。
当屏幕上终于跳出那个熟悉的界面时,双方几乎同时松了口气:"感觉好像看到希望了。"
这一天的成果:一套完整运行在客户自己电脑里的知识库工作台,初始化完成、专属空间建好、管理员账号与智能接口配置就位。
二、为什么不放在云上
部署方式不是随意选的。
我们坚持把系统装在客户指定的电脑上,资料存在本地盘,而不是公有云端。
原因很直接——这是标书资料。
企业经营数据、合同金额、投标底价……这些东西一旦上传到公网服务器,风险不可控。本地部署意味着一句话:
数据留在自己手里,检索在自己机器上发生。
这也是整套方案与"注册个账号就能用的在线工具"最根本的区别:它不是 SaaS,而是装进企业内部的资料中枢。
三、环境这道坎,才是真实世界
这次现场最耗时的,恰恰不是 AI,而是环境。
三类问题,一类一类处理:
网络不稳——排查后判断为端口链路问题,最终改用本地拷贝导入的方式绕开
防火墙拦截——逐项放行安装程序的通信
权限不足——以管理员身份运行,必要时重启
这些事说起来都不难,但它们有一个共同特点:只有真正坐在现场的人才能解决。
AI 项目的最后一公里,从来不是模型问题,是环境问题。
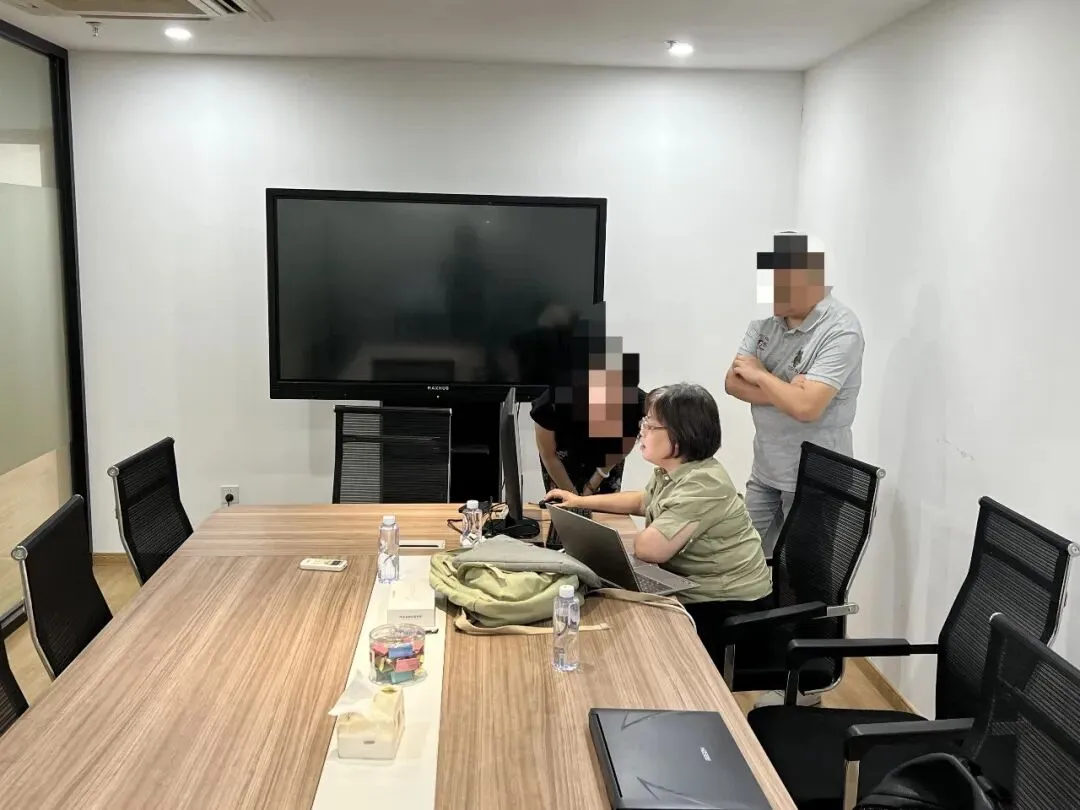
四、装的不是软件,是一整套运行环境
给非技术背景的同事解释部署架构,是这次现场反复发生的事。
我们用了一个很朴素的比喻:
听懂这个比喻,也就理解了为什么这件事耗时长、为什么对磁盘和网络有要求:这不是装一个软件,而是在企业现场的电脑里,搭起一整套小型运行环境。
五、它不是某个人的工具
系统跑起来之后,客户方问了一个很关键的问题:
"以后大家上传资料,是不是都得跑到这台电脑上来?"
答案是:不用。
那台电脑是部署环境,不是工位限制。机制是这样设计的:
部署一次,全员可用;权限集中,资料分散不了。
六、顺带说清楚一件小事:智能服务怎么买
整套系统的"大脑",接的是国产大模型服务。
我们的建议很明确:选用团队版(相比个人版在安全性上更有保障),并且——先按一个席位、按月开通试用;跑通之后再改为按年付费。
理由很实在:先把链路打通、把实际用量跑实,再决定长期投入。对企业来说,避免一开始就为一堆用不上的额度买单,也省去每月重复报销的麻烦。
七、接下来会发生什么
环境跑通了,接下来才是真正见真章的部分:
真实资料进库——把整理好的合同、订单、发票按既定规范导入,检查识别情况
真实场景检索——拿一份真实招标文件里的业绩要求,现场查合同、查订单、查发票,并打开原件逐份核对
真实的人来用——由招投标岗位的人亲自上传、提问、看结果,把"查不到、找错、识别不准"的情况一条条记下来
前面三次现场定下的所有规范,都是为了这一刻准备弹药。
而这一步能不能打响,取决于另一件事:有没有人愿意蹲在现场,把权限、网络、磁盘这些脏活一个个解决掉。
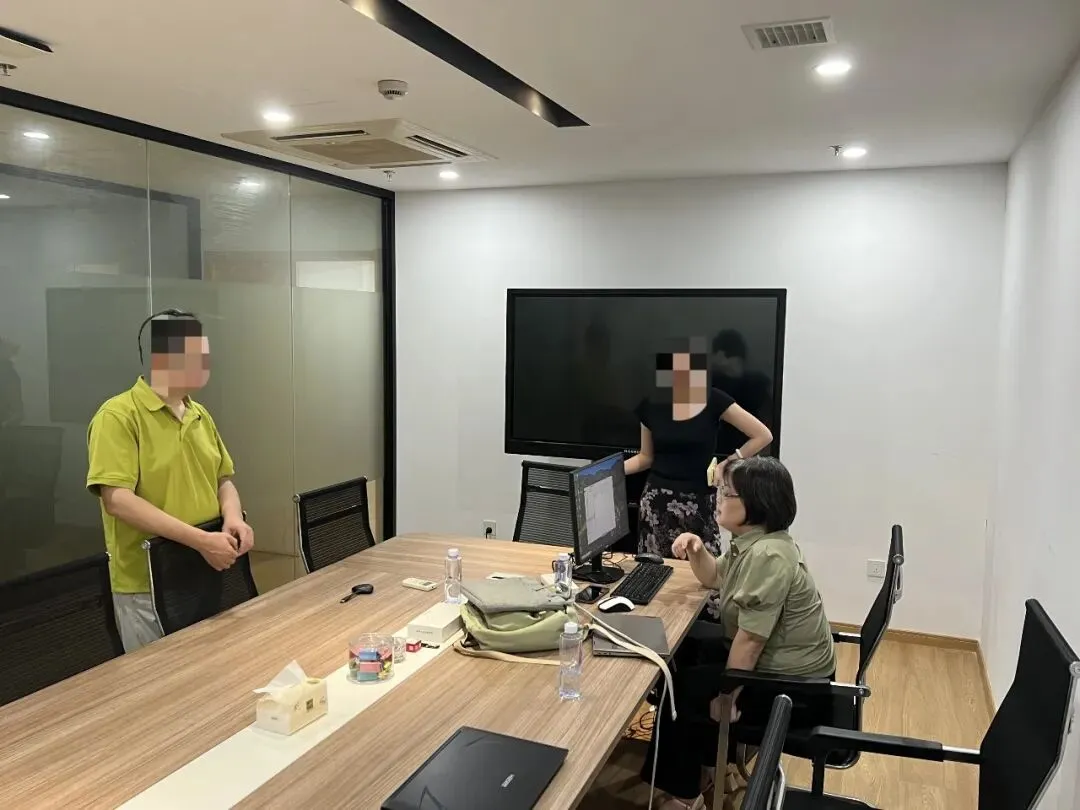
写在最后
我们常常高估 AI 的能力,也常常低估落地的成本。
一个模型可以在几秒钟内读完一份上百页的合同;但为了让这台电脑能跑起来,我们用了一整个下午。
真正拉开差距的,从来不是谁选的模型更强,而是谁愿意把手弄脏。
数据资产 AI 治理走到第四步,我们越来越确认一件事:
前面所有的规范、目录、命名,都是为最后一公里准备的;而最后一公里,从来不在 PPT 上。
丨如果你的企业也想把 AI 真正装进自己的业务里,而不是停在演示阶段,欢迎和我们聊聊。