ARTICLE · 1058577
Jev 实测:AI 自动分类 43 篇文章,只错 3 篇
我给一个 AI 出了 43 道题。它用了 30.6 秒答完,和我原来的归档对上了 40 道,一共花了我不到一分钱。
它叫 Jev,9 月 15 日发布。不能聊天,不会写代码,连一句完整的回复都给不了你。
上线当天,它在 Hacker News 上拿到 1679 分,到截稿已经涨到 1937 分。接入 Vercel 平台之后,24 小时内近 13% 的付费团队用过它;平台方给的对比是,这个数字是 GPT-5.6 系列的两倍、Fable 5.1 的六倍多。他们也在同一篇里补了一句:真正的考验,是这些团队会不会留下来。
一个连话都不会说的模型,凭什么?
它到底能干什么
整个接口只有三种问题类型。
Choice(选择):从你给的选项里挑一个。选项是你自己定义的,比如“这条工单该转给账务、技术还是销售”。
Score(打分):沿着你写的等级量表打分。等级也是你自己描述,比如“平静陈述事实 / 不满但克制 / 非常愤怒”。
Noul(是非):一个是非判断,返回 0 到 1 之间的概率。
它和聊天模型最大的用法差别在这里:用 ChatGPT 那类模型,你写的是提示词,然后从它吐出的一大段话里想办法把数据抠出来;用 Jev,你写的是问题的结构,拿回来的直接是程序能用的值,不需要解析。
而且同一个请求里可以混着问很多个问题,并行算完,几乎不增加响应时间。不过 token 会跟着涨,成本还是要算的。
我拿 43 篇文章试了一遍
光看介绍没用。9 月 21 日上午,我把站里当时全部 43 篇文章的标题和摘要丢进去,问它三件事:这篇该归到哪个栏目、属于什么类型(评测 / 横评 / 教程 / 预警 / 工具箱)、一年后是否还成立。
结果:30.6 秒跑完 43 篇,平均每篇 0.71 秒。和我原来的归档一致 40 篇,一致率 93%。总成本 0.0013 美元,按汇率不到一分钱。
这里的“对”,比的是它和我自己现有归档的一致性。但那三篇偏差偏得都很有道理:它们全部落在“数字生活”这个栏目上。那个栏目本身就是个兜底筐,什么都能往里装,边界本来就模糊。
你现在就能试一件小事
不用碰代码。官方控制台里有个 Playground 页面,注册完就能用,界面上一栏填材料、一栏写问题,点一下就跑。
给你一个能直接抄的用法:把攒下来的东西一次性扔进去。
State 那一栏,粘上你收藏夹里攒了一个月没看的网页标题,一行一个。Questions 那一栏给它几个选项,比如“这篇属于哪一类?选项1:工具教程;选项2:行业动态;选项3:可以先不看”。
点运行,它会给出每一篇落在哪个选项、概率多少、置信度多少。
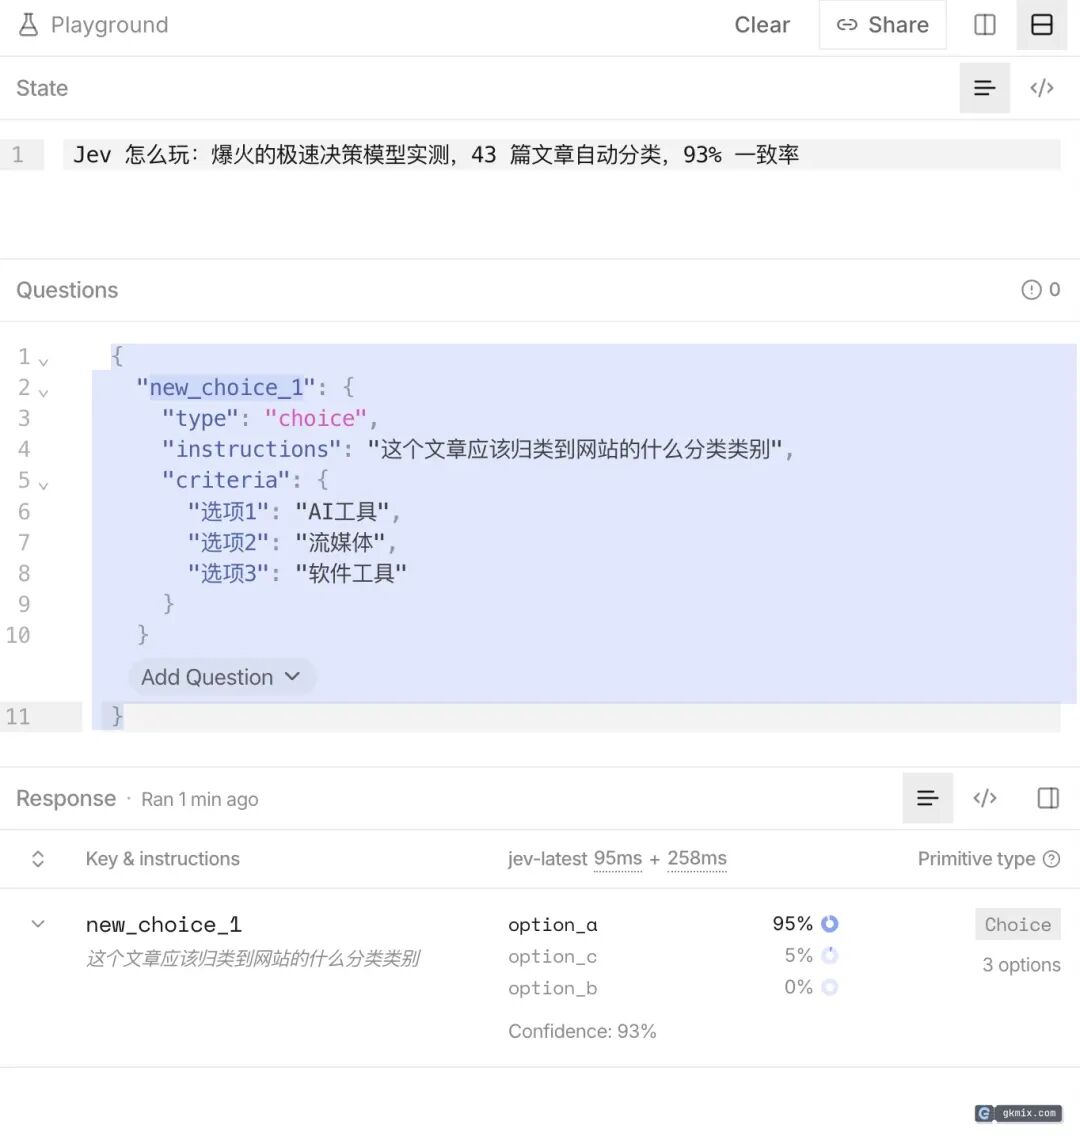
TypeSafe 官方控制台的 Playground,上面填材料、下面写问题。图片可以点开放大看
这类活的共同点是:单次价值不高,但量大、规则清楚、你自己不想干。符合这三条,就值得拿它试一次。
真正关键的是:它知道自己有多确定
它不会给你一个答案就完事。每个选择类、打分类的答案都带着完整的概率分布,以及一个由这个分布算出来的置信度。
我拿一条客服消息试过:客户说收款账号三天连不上、订单一直失败。我问它该转给哪个团队。
它选了账务,但置信度只有 57%。因为“收款账号连不上”这句话,本来就同时像账务问题和集成问题。它选了,但把这份不确定也一起报了回来。
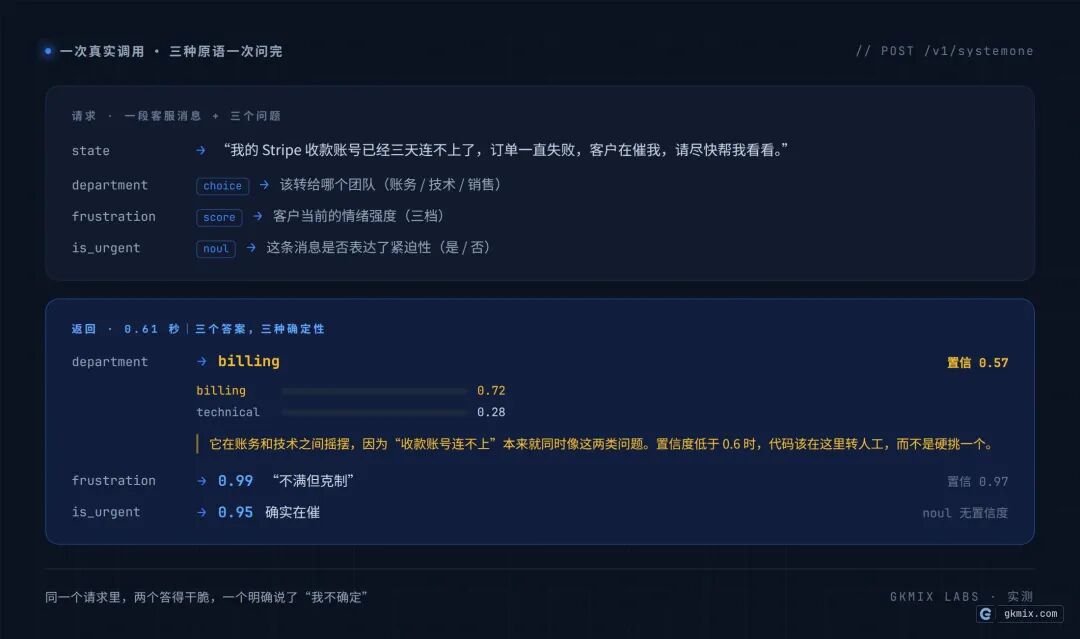
一次真实调用的返回:选项、概率和置信度一起给出来
同一批问题里的另外两项,客户情绪的置信度是 97%,“是否紧急”这个是非判断的概率是 0.95。
有一点要提前说清:置信度算的是它自己在这个选项上有多稳,不是它答对的概率,官方文档专门写了这一条。我自己那 43 篇也能看出这个区别:三篇判断偏差里,有两篇的置信度是 0.94 和 0.97。
所以它更像一个用来分流的旋钮。把它当成正确率保险用,会出事。阈值定多少,得拿你自己的数据校准一遍,官方给的也是这个建议。
官方文档的思路是分三档:高置信度自动执行,中等的话标记出来等人过一眼,低的直接转人工。一个说不出自己有多确定的模型,是没法接进生产流程的。
另外一条路:开源版快 8 倍,但要自己喂数据
Jev 上线之后,判断类模型这个方向热闹了起来。有一批开源实现走的是同一条路,其中一个叫 Laya,Apache 2.0 完全开源,可以自己部署。
它的模型卡里写,在 T4 显卡、模型预加载的条件下,单个问题的延迟是 32.8 毫秒,对比 Jev 的 236 到 276 毫秒,快了将近 8 倍。这里要说清一句:Jev 那一侧的数字来自第三方的公开数据,Laya 从来没有在自己的环境里实测过 Jev,两边不是同一套测试条件。
而且它的模型卡自己写得很实在:零样本情况下,某项判断基准上它只有 0.362 分,随机基线是 0.318,多数类基线是 0.461,基础版本的分数比全程猜同一个答案还低。那个漂亮的 0.766 分,是在那项基准自己的训练集上微调之后才拿到的。
说白了,它是个需要你用自己的数据去喂的底座。有数据、有人手做微调的团队可以试试;直接拿来上,很可能翻车。
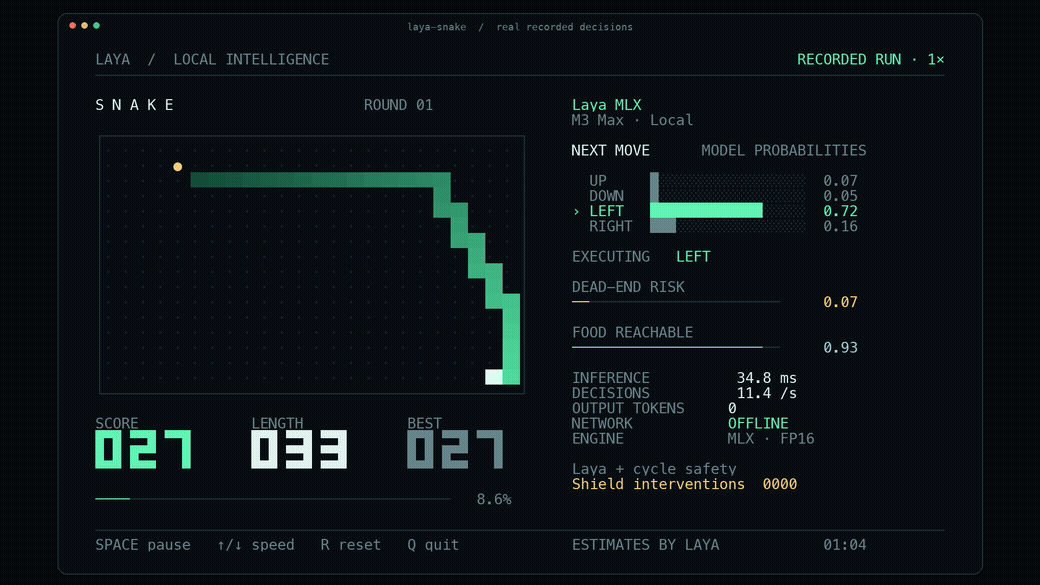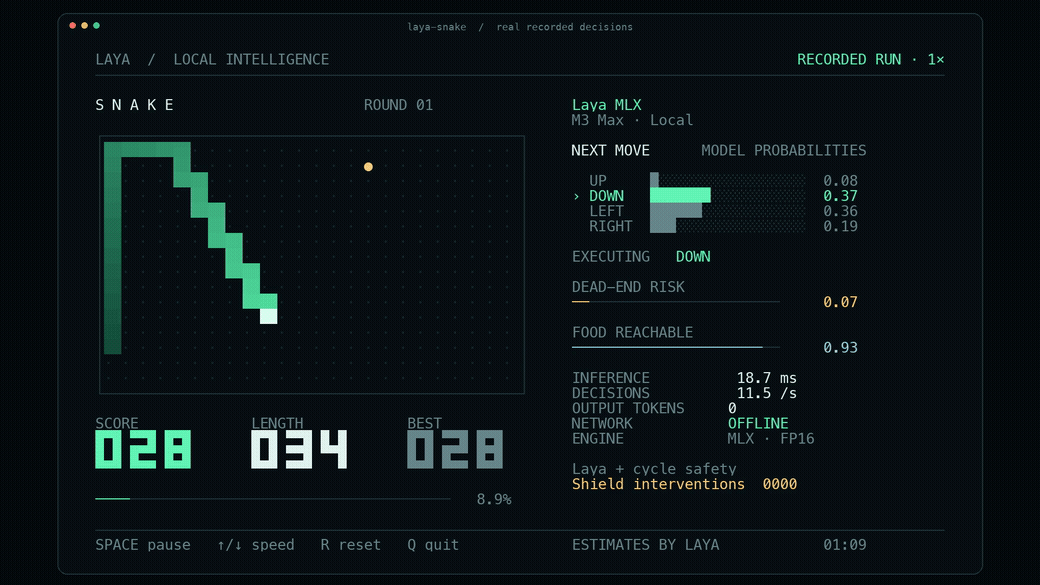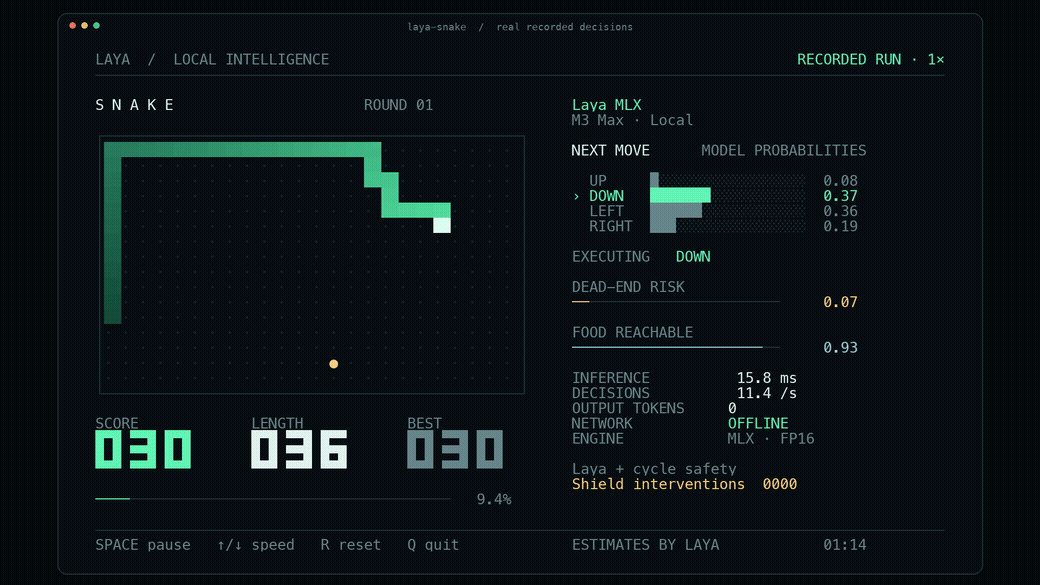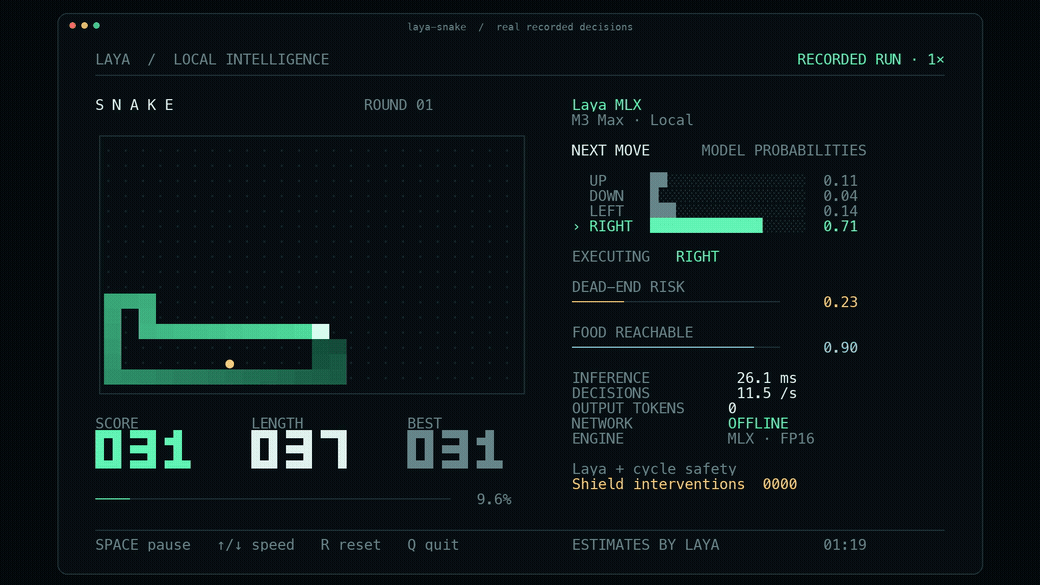
一组独立测试:它赢了速度,没赢准确率
国内 36 氪和硅星人 Pro 用 50 条中文客服问题做过一组独立测试,每条要完成紧急度、售前概率、处理类别、严重度四项判断,四项全部符合人工标注才算对。
Jev 的完整准确率是 64% 到 65.2%,在同价位的小模型里排第二,并没有甩开谁。放到更强的模型组里,它的分数排在最后。
它赢的是另外两项:平均每题 0.73 到 0.75 秒,50 题总成本 0.002 美元,都是那组测试里最低的。
那组测试还挖出一个细节:Jev 的失分有不少卡在阈值附近。
人工标注某条消息的严重度下限是 2.00,它给出 1.99。数字看着差不多,但如果你的业务规则写的是“达到 2.00 才转人工”,1.99 和 2.00 在程序眼里就是两个完全不同的信号。
另一条临期食品问题的紧急度标注 0.75,它给 0.71 到 0.72。那组测试重复跑了 15 次,有 3 道题在通过和不通过之间反复。
阈值别卡在临界点上。要么留余量,要么把边界情况单独路由给人工复核。
最后补两句那组测试自己说的限定:50 条中文客服样本,不足以代表它在所有任务上的表现;他们那套按题目判分的测法,也没法验证它的概率校准做得好不好。
所以它到底适合谁
适合:需要在软件里做大量重复判断的场景。判定条件很简单:这个判断一年要做几千次,而且你能把判断标准写清楚。
不适合:想要一个“更好的 ChatGPT”的;需要生成内容的;需要它讲出推理过程的(它只给结论和可能性);以及中文高要求场景直接上生产。
最后这条是官方自己写的。原文的意思是:包括中日韩文字在内的其他语言都能处理,但效果和英语不一样好;非英语任务在依赖它之前要先拿自己的内容测一遍,并且特别注意置信度。注意官方说的是所有非英语,不只是中文。
官方还专门列了一页已知缺陷,写得很坦白:它不会数数,别拿它做算术和日期比较;材料里塞太多无关内容,准确率会掉;选项的排列顺序会影响它的答案;对提示注入式的对抗文本不设防。它也只吃文本,不收图片和音视频。
它在这件事上倒是很省心:不用你的数据做微调,所有账号用的是同一份权重。
我是 GK。有想拿它试的场景,或者拿不准自己的需求适不适合,在这里回我就行。
完整的实测数据、三篇判断偏差的逐条明细,还有 Playground 的入口地址,都在左下角“阅读原文”那篇里。
身边有谁天天在手工给一堆东西分类,转给他看看。
本文原创,非广告。