ARTICLE · 1061025
OpenAI狂买几万台Mac塞进机房!苹果坐不住了:联手黄仁勋杀回服务器
在硅谷最神秘的一些数据中心里,正在上演极为魔幻的一幕。
成千上万台原本摆在设计师桌面上的 Mac mini 和 Mac Studio,被工程师们暴力拆掉了包装,拔掉了显示器、键盘和鼠标,像一块块冰冷的铝合金砖头一样,被塞进了定制的铁架机柜里。
这些豪掷重金的买家,正是 OpenAI 和 Anthropic 的顶级 AI 团队。
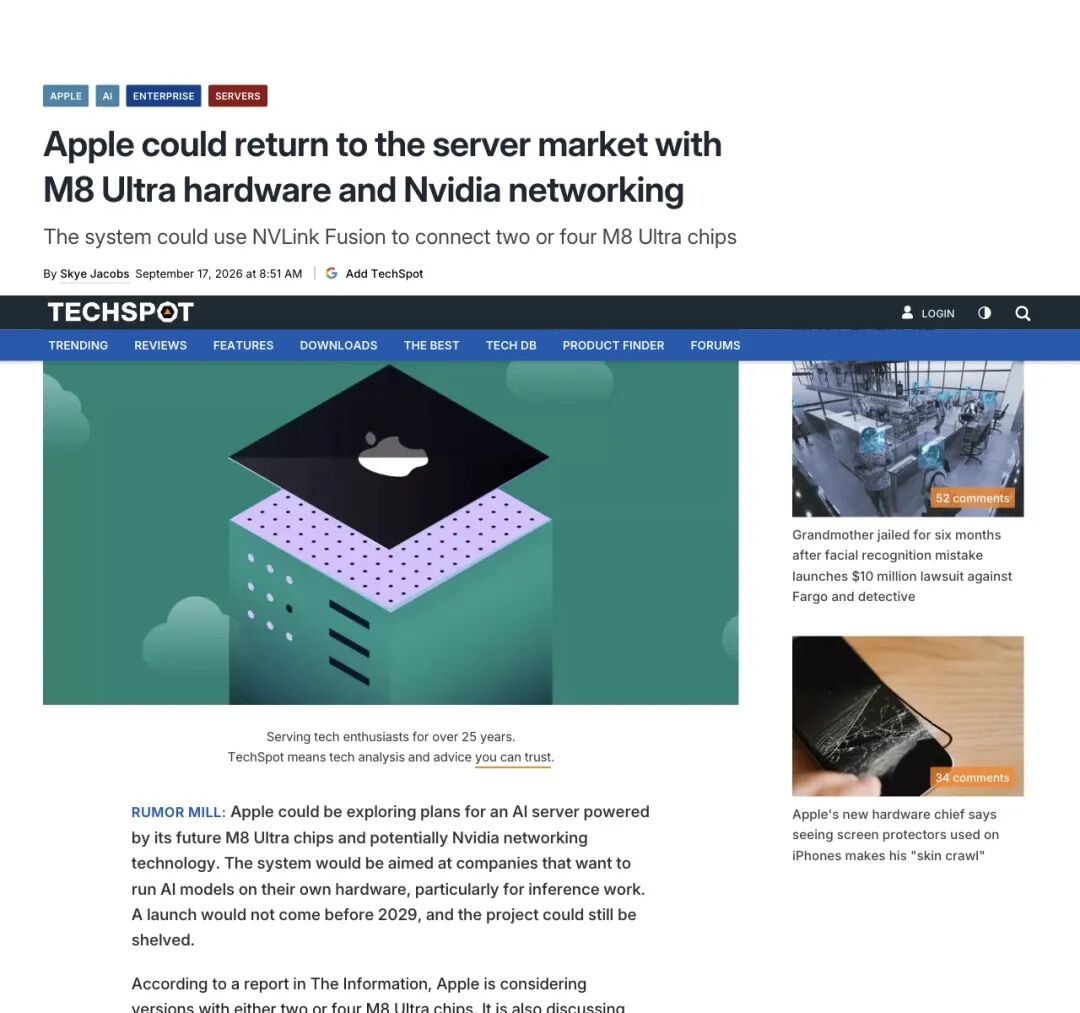
▲ 科技媒体曝光科技巨头采购 Mac 作为无头节点跑 AI 负载
为了让 AI 智能体(Agent)日夜不停地通过强化学习自我进化,这群全世界最聪明的人,竟然把苹果电脑当成了机房里的“苦力”。
这直接导致了一个极其夸张的财报现象:上一季度,苹果 Mac 业务营收逆势暴涨近 30%,狂揽约 104 亿美元。
看着自家原本给剪辑师、程序员设计的个人电脑被各路大厂当成服务器疯狂扫货,库克和他的硬件团队终于坐不住了。
来自供应链与科技媒体的重磅爆料打破了平静:苹果正在秘密评估一款专为机房打造的企业级 AI 服务器,计划搭载 2 到 4 颗尚未面世的 M8 Ultra 顶级芯片,甚至还在与老对手英伟达接洽,打算引入英伟达的高速互联技术,NVLink Fusion!
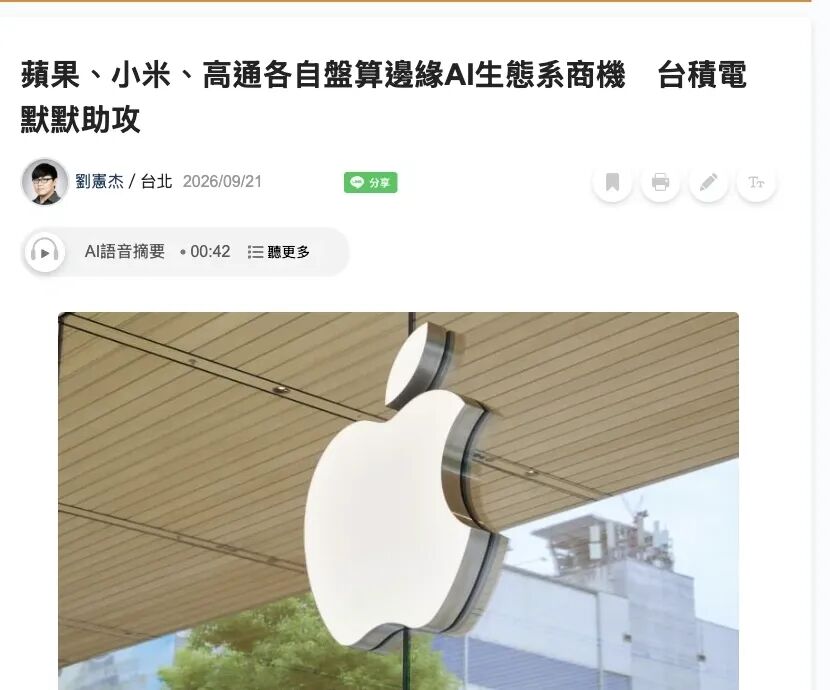
▲ DigiTimes 披露苹果、高通等巨头在边缘 AI 生态的全新布局
一台被当成“奴隶”的 Mac,撕开了万亿 AI 市场的遮羞布
为什么 OpenAI 和 Anthropic 会干出“拿 Mac 拼机架”这种看似滑稽的事情?
答案只有四个字:统一内存(Unified Memory)。
▲ 业内人士热议 M8 Ultra 带来的极致算力密度与低延迟
在大模型的世界里,天下苦英伟达久矣。英伟达的顶级 GPU 算力通天,但采购价格高昂且显存容量寸土寸金;在传统的服务器架构里,CPU 的内存和 GPU 的显存又是彻底分开的两个世界。
打个通俗的比方:传统服务器就像一个厨房,厨师(GPU)手边的切菜板(显存)非常小,每次做菜,助手都得从几十米外的冷库(CPU 内存)里一趟趟把食材搬过来。食材在路上来回倒腾的时间,甚至比炒菜的时间还要长。
当你在跑当红的 AI Agent(智能体) 或者复杂的强化学习时,模型一会儿要调用系统工具,一会儿要推演下一步行动,数据需要在系统与模型之间千百次反复横跳。传统架构光是在 CPU 和 GPU 之间搬运数据,就能把带宽和延迟活活拖垮。
▲ 苹果在 M1 Ultra 上首次展示的封装级统一互联技术
而苹果的 M 系列芯片,走了一条完全不同的野路子。
苹果把 CPU、GPU 和神经网络引擎(NPU),统统焊在了同一块基板上,共享同一池超大容量、超高带宽的统一内存。这相当于厨师和冷库直接坐在了一张桌子前,谁也不用搬运数据,一抬手就能直接读取。
几万块钱的一台顶配 Mac Studio,就能拥有高达 192GB 甚至更高的超大共享内存,能够一口吞下一整个庞大的开源大模型,常驻在内存里随时调用。
这种原本为了剪辑 8K 视频而设计的架构,阴差阳错成了当下 AI 推理和智能体演练的性价比神机。
走出机箱:苹果的芯片胶水,遇到了“物理天花板”
但用 Mac 拼机架,终究是野路子
机房运维工程师面临巨大的维护压力:方案缺乏冗余电源与远程带外管理,网线和电源线在机架后方缠成乱麻;而且单台机器算力再强,终究只是一座孤立的算力节点。
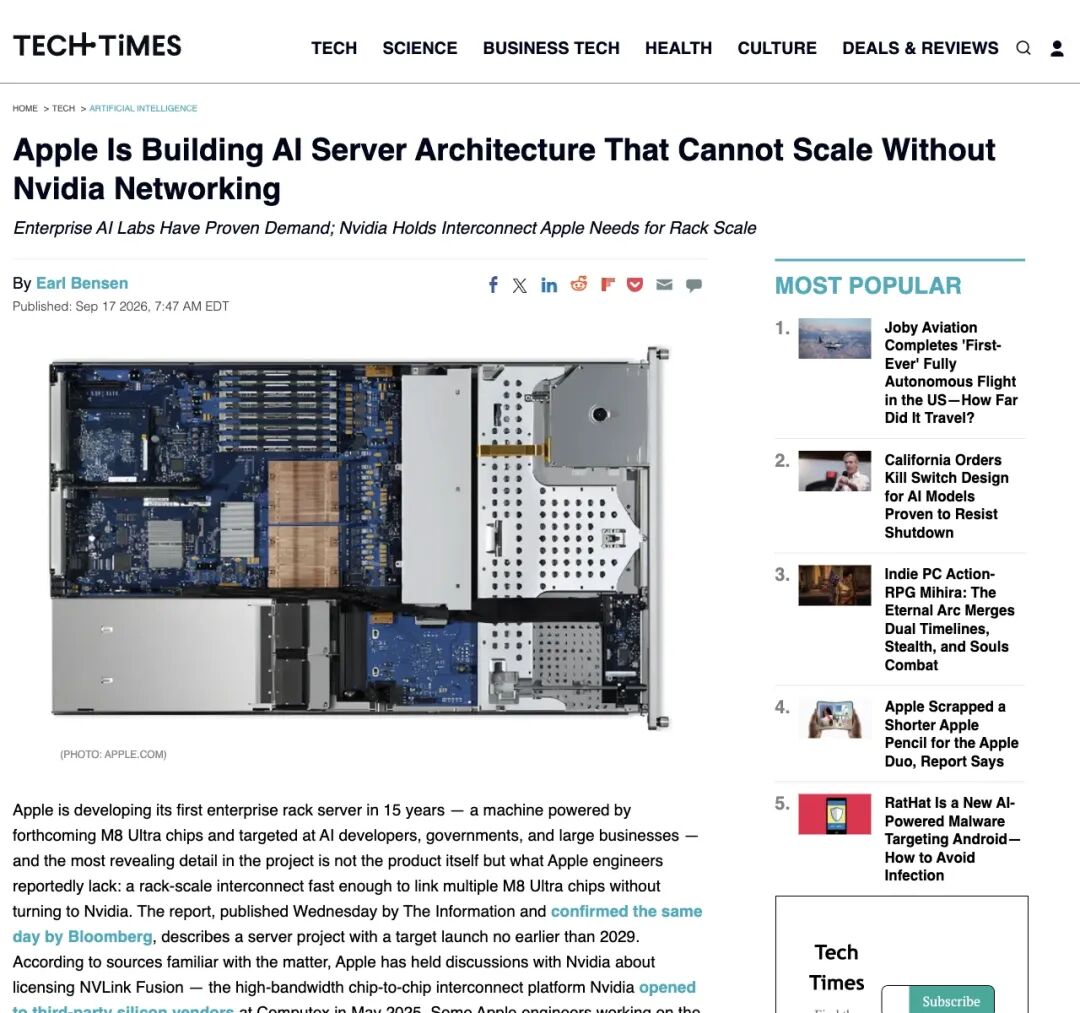
▲ 行业分析指出苹果自研互联技术在面对机柜级扩展时的局限
苹果在消费级芯片上有一项看家本领,UltraFusion。
简单来说,就是用极其精密的封装技术,把两颗芯片像拼积木一样“粘”在一起,直接向系统软件呈现为一颗完整的超大芯片。
但这项技术只能在同一个芯片封装内部生效。
一旦你想把两颗、四颗 Ultra 芯片塞进同一个企业级机架,甚至想把几十个机架连成一片算力海洋时,苹果现有的技术储备就彻底不够用了。
机柜与机柜之间的通信,需要的是能扛住海量数据并发的网络织物(Fabric)。如果走传统的网络接口,数据传输慢得就像在高峰期走下班公路。
这时候,那个统治着整个 AI 宇宙的男人,带着他的终极武器登场了。
黄仁勋的降维打击:你可以不用我的卡,但必须走我的路
提到英伟达的护城河,许多人首先想到 CUDA 与 GPU。但在顶级硬件架构师眼中,英伟达的核心壁垒实则是 NVLink。
这套高速互联技术,能让几千颗芯片之间的数据交换如同在同一块芯片内部一样狂飙。
▲ 市场消息指出苹果正在讨论采用英伟达 NVLink Fusion 方案
黄仁勋近两年的商业谋略同样深远:推出 NVLink Fusion,把这项原本专属于英伟达显卡的独门技术,向第三方定制芯片开放!
联发科、高通、Marvell 纷纷接入,而现在,谈判桌对面坐着的,正是苹果。
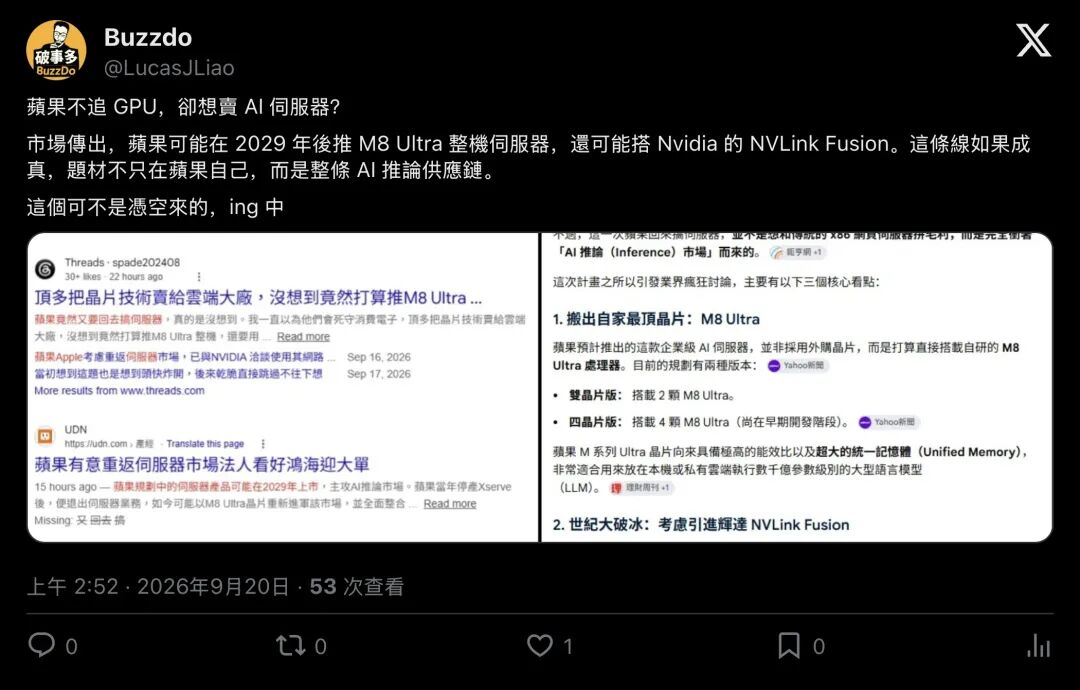
▲ 华语科技圈热议:苹果不造训练卡,却可能重构整个 AI 推理供应链
这笔潜在交易的精妙之处,足以写进商业教科书:
对于苹果而言,自己从零研发一套机柜级高速互联协议和交换机芯片,不仅周期长、成本高,还极易踩坑。直接接入 NVLink Fusion,就能让 4 颗甚至更多 M8 Ultra 瞬间打通经脉,把统一内存池的规模推向史无前例的恐怖高度。
对于黄仁勋而言,这更是一场降维打击:哪怕你苹果不买我的 GPU,你也得买我的 NVLink 交换机,用我的互联生态,给我交“过路费”。
在数据中心的血管里,流动的依然是英伟达的血液。
历史的轮回:沉睡15年的“服务器之魂”再度觉醒?
资深科技观察者都清楚,苹果早在多年前就涉足过服务器硬件。
早在 2002 年,乔布斯就曾骄傲地推出过机架式服务器 Xserve,银色铝合金面板搭配酷炫的指示灯,一度成为设计界和高校机房的宠儿。
但到了 2011 年,因为企业级市场曲高和寡,苹果果断拔掉了 Xserve 的呼吸机,退出了专用服务器硬件市场。
但今天的时代,已经完全变了
当年的 Xserve,跑的是邮件系统、文件共享、目录服务;而今天传闻中的这台 M8 Ultra 怪物,只为了 AI 推理(Inference)而生。
训练一个万亿参数的基础大模型,是少数万亿美元巨头在云端进行的“大炼钢铁”;但要把模型部署下去,服务千家万户、处理企业核心机密数据,靠的则是数以亿计的边缘推理节点。
▲ 苹果 Private Cloud Compute 架构展现出其在云端安全算力的深厚积累
苹果在内部其实早有实践为了支撑 Apple Intelligence,苹果在自建的 Private Cloud Compute(私有云算力) 中就已经大规模部署了自研芯片节点,主打数据“用完即焚”的高安全性。
但此前,外部客户跪求苹果出售这套硬件,苹果统统回绝。
如今,把 M8 Ultra 包装成企业级产品对外出售的计划被摆上台面,意味着苹果第一次动了把底层算力直接变现的念头。
胜负手在冰山之下:苹果面临的现实硬仗
不过,这一场突袭战,远没有想象中那么容易。
多位业内分析人士和社交平台上的硬核玩家都指出了同一个事实:目前一切仍处于评估阶段,距离 2029 年的目标窗口期,随时可能发生变数,甚至取消。
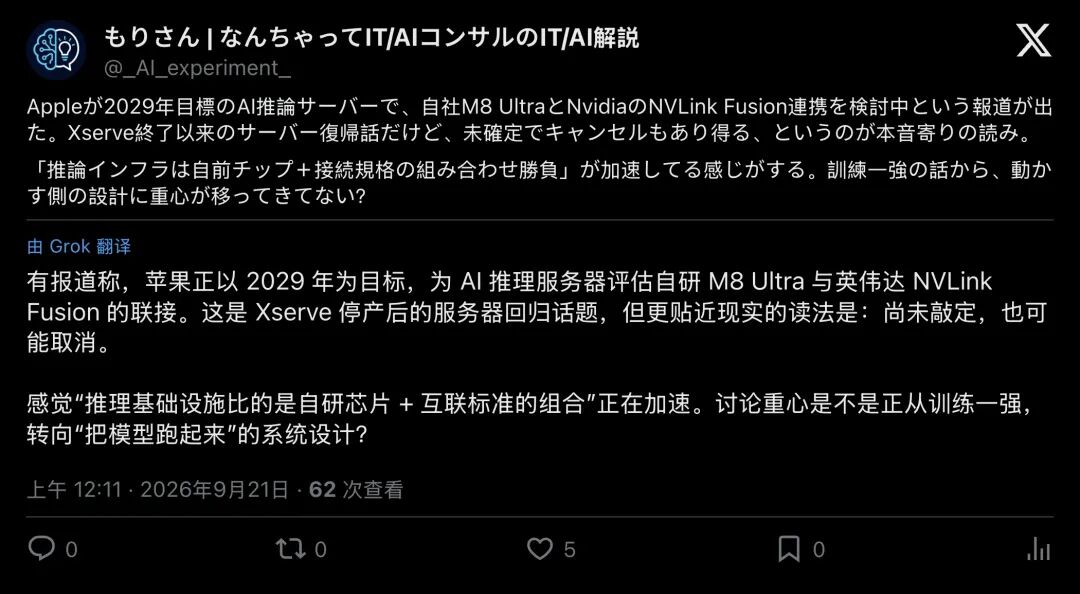
▲ 日本行业观察者指出:AI 基础设施重心正在从纯训练转向推理连接架构
要打赢这场企业级战役,苹果面前横亘着三座大山:
第一座大山,是企业级生态的残酷鸿沟。卖一台 8000 块的 Mac,用户遇到 Bug 可以等下次系统更新;但卖一台几十万的企业服务器,客户要的是 7x24 小时不间断运行、双路冗余电源、热插拔配件以及 4 小时内上门的企业级 SLA 维保体系。这套脏活累活,苹果已经生疏了 15 年。
第二座大山,是软件栈与框架的壁垒企业级 AI 几乎完全长在英伟达 CUDA 和开源生态之上。苹果虽然拿出了针对 Apple Silicon 深度优化的 MLX 机器学习框架,性能极为惊艳,但如何让全球成千上万的企业开发者把生产环境的复杂模型平滑迁移过来,仍需跨越巨大的工具链门槛。
第三座大山,是群雄逐鹿的边缘战场战场上不止苹果一个聪明人高通已经拿出了专门针对边缘推理的 Dragonfly 机柜方案;小米也在概念发布会上端出了搭载多颗自研芯片的 AI Cube 工作站;台积电更是在先进封装领域默默为各大厂商提供弹药。
终局:从“炼丹”到“干活”,AI 基础设施大洗牌
回看整个 AI 产业的演进,我们会发现一个清晰的轨迹:
过去三年,所有人的目光都聚焦在训练端,大家比拼谁能烧几万张 H100,炼出更聪明的大脑。
而接下来的几年,重心正在转向推理端,怎样用最低的功耗、合理的成本、安全的数据闭环,将模型落地到生产环境,化身为不知疲倦的数字劳工。
这正是苹果最擅长的战场
当 OpenAI 的工程师们无奈地把消费级 Mac 塞满机架的那一刻起,时代的风向就已经变了。
如果 2029 年,那台通体黑化、搭载 4 颗 M8 Ultra 芯片、流淌着 NVLink 血液的苹果 AI 服务器真的轰鸣着推入全球数据中心,我们不应感到意外。
这是一家消费电子巨头在洞悉算力架构变局之后,蓄势已久的战略升级。