ARTICLE · 1074914
AI怎样预演下一秒?一个杯子,讲清CausalWM的新思路
短短几秒,藏着一连串彼此相连的变化。而这件日常小事,恰好打开了理解人工智能的一扇窗:AI怎样预测物体运动,又怎样知道一个动作会带来什么结果?
最近,Aether AI发布了因果世界模型CausalWM。这个拥有160亿参数的模型,给出了一条有趣的路径:先推演运动,再理解空间变化,最后生成未来画面。
想读懂CausalWM因果世界模型,可以先记住一句话:把下一秒拆开来看,未来就有了可以追踪的来路。
让未来带着过程一起出现
世界模型是什么?你可以把它想成一个能够在脑海里预演场景的系统。给它当前画面,再告诉它准备做什么,它就尝试呈现接下来可能发生的变化。
放到机器人身上,这种能力像一次行动前的彩排。拿起瓶子、拉开抽屉、搬动零件,每个动作都对应着周围环境的变化。
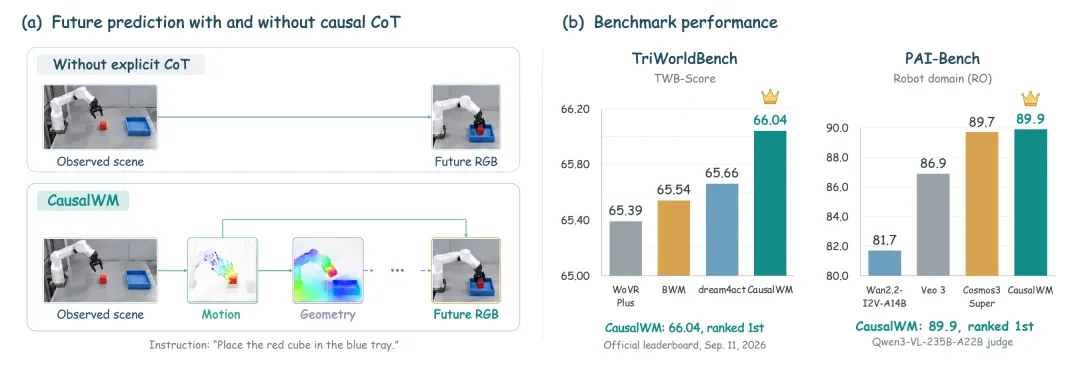
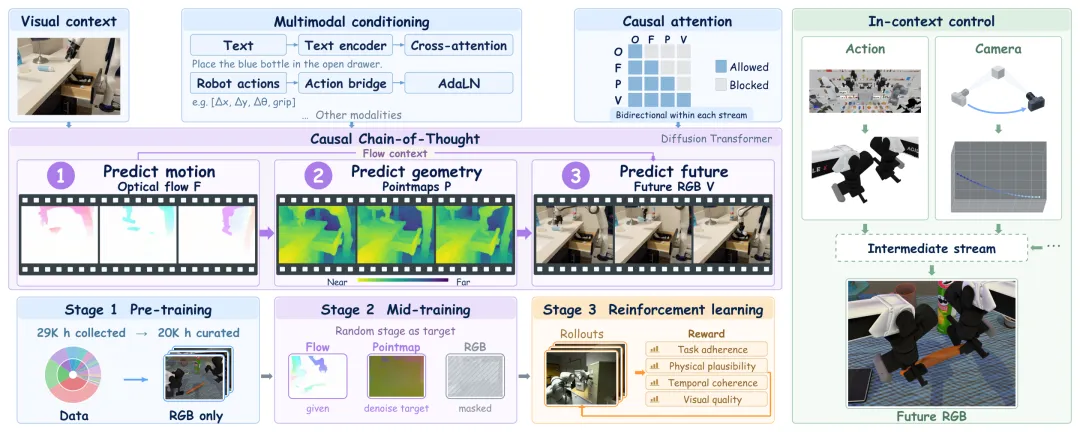
CausalWM带来的因果思维链工作原理,是把这些变化分成有顺序的步骤。就像我们看慢镜头回放,既能看见结果,也能跟着过程理解结果怎样出现。
这让具身智能世界模型多了一种值得探索的表达方式:把原本隐含在生成过程中的运动与空间信息,变成可以观察的中间结果。
比如收拾餐桌,同样是把杯子放进托盘,起点、路线和托盘位置不同,过程也会不同。预演的价值,就在于把这些条件放回具体场景,让每个动作都有相应的环境变化与之呼应。
第一眼看运动,第二眼看空间
机器人如何理解物理世界?不妨继续看那个杯子。
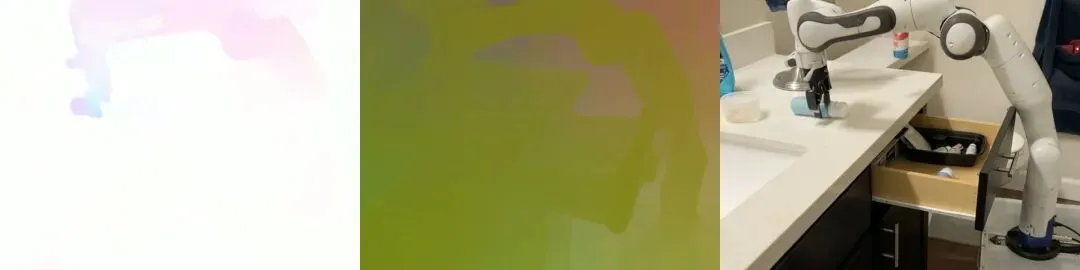
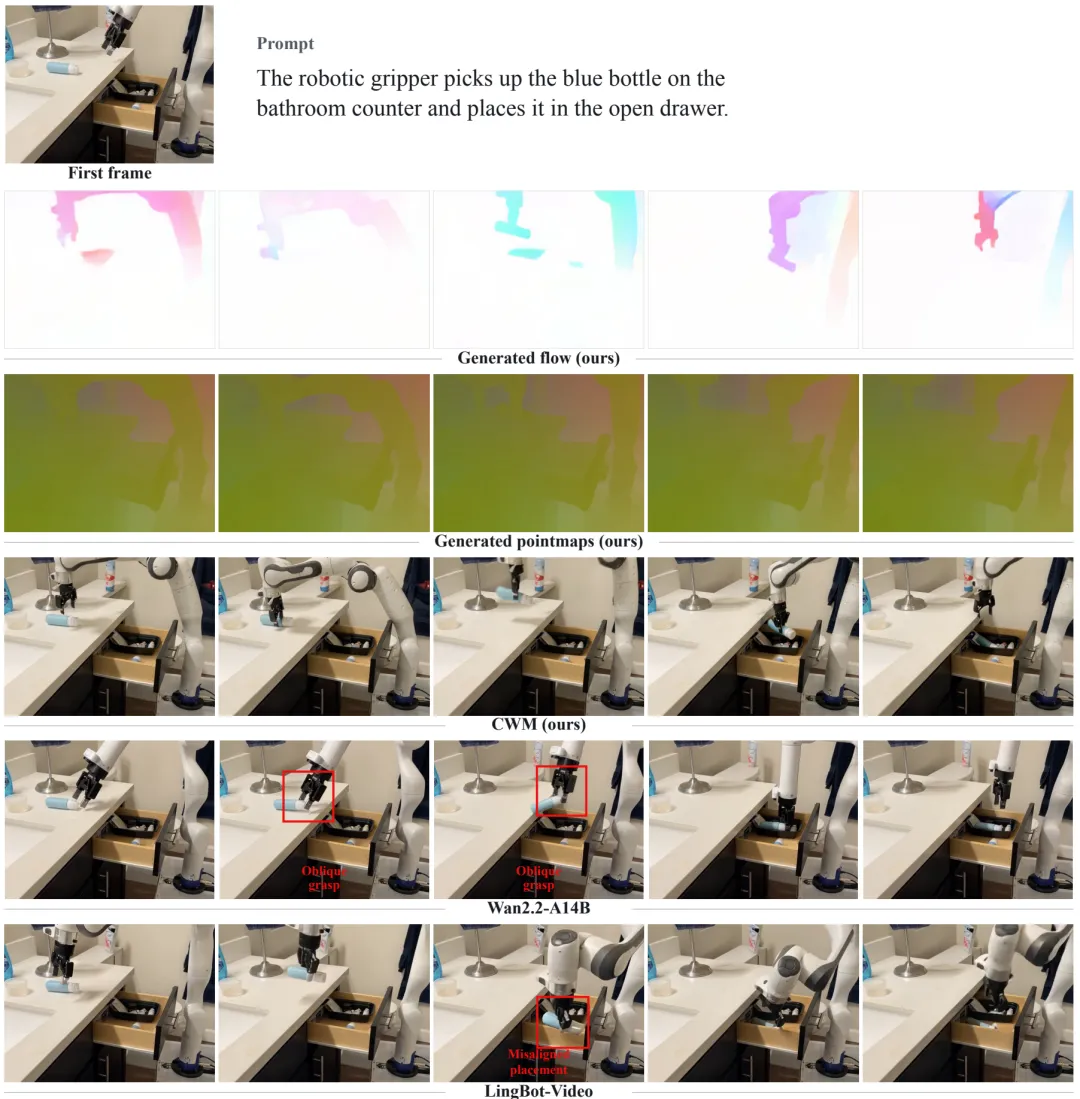
模型首先关注运动。画面里哪些地方正在变化,往哪个方向移动,幅度有多大,都可以通过光流来表达。理解光流预测物体运动,就像给连续画面添上一张运动地图。
接着,模型关注几何关系。杯子距离镜头多远,机械臂与杯子的位置如何变化,需要更明确的空间信息。
深度描述远近,三维点图则为像素提供三维坐标。三维点图空间理解,可以想成给平面画面补上一份空间地址簿。
有了运动与几何,模型再继续生成未来视频。于是,整条路径连了起来:当前观察、物理运动、空间变化、未来画面。
最有意思的是,前一步的结果会进入下一步,成为继续推演的依据。光流帮助预测几何,几何又参与生成画面,几个环节接力完成同一次预演。
这里的思维链以视觉物理信息呈现。读者在示例里看到的彩色光流、点图和普通画面,分别对应同一段操作的不同侧面。把它们并排观看,就像同时打开动作地图、空间地图和现场镜头,一次移动的细节也变得更容易理解。
三轮训练,把预演练得更扎实
要理解世界模型训练方法,可以把CausalWM的训练看成三轮练习。
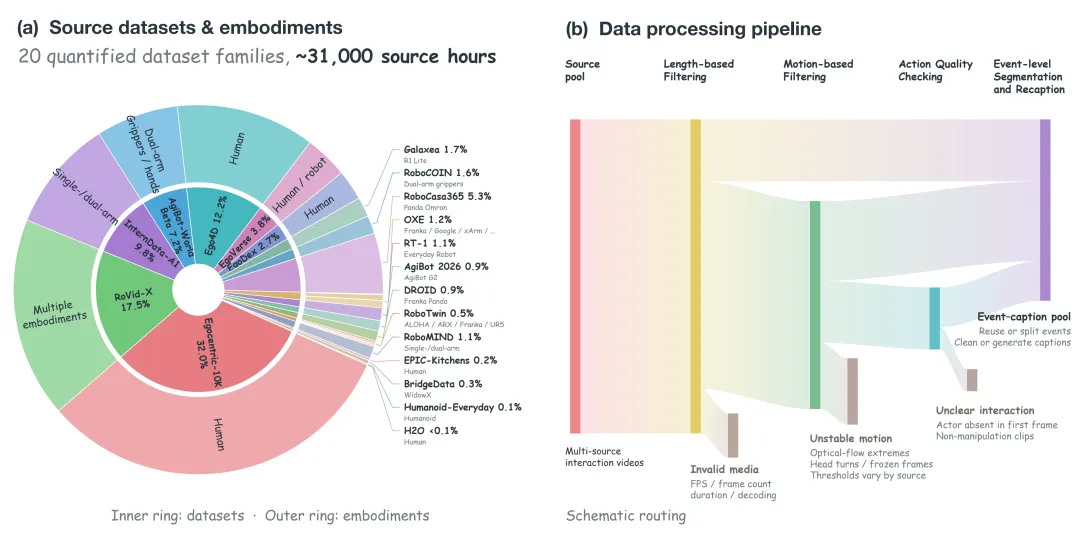
第一轮,先积累对世界的观察。团队收集约三万一千小时的具身视频,覆盖人类第一视角活动、真实机器人演示和仿真操作,再进行筛选与整理。
模型从中学习连贯的未来画面,也借助潜在动作表示,把不同机器人、不同视频里的动作变化放到更统一的表达中。
第二轮,练习按顺序推演。模型学习先生成光流,再生成三维点图,最后生成画面。每一步读取相应的信息,训练与实际使用沿着同一方向展开。
第三轮,比较多种可能的未来。面对同一个场景,模型生成不同候选结果,再综合物理一致性、视觉质量和任务完成度获得反馈。
这就是多目标强化学习训练在这里的作用:让最终结果帮助优化前面的推演路径,让运动、空间与画面配合得更好。
给机械臂画条路线,看看未来怎么变
读到这里,一个很自然的想法出现了:既然中间过程能影响结果,我们能否主动给它一条路线?
CausalWM为机械臂轨迹控制提供了一个研究入口。
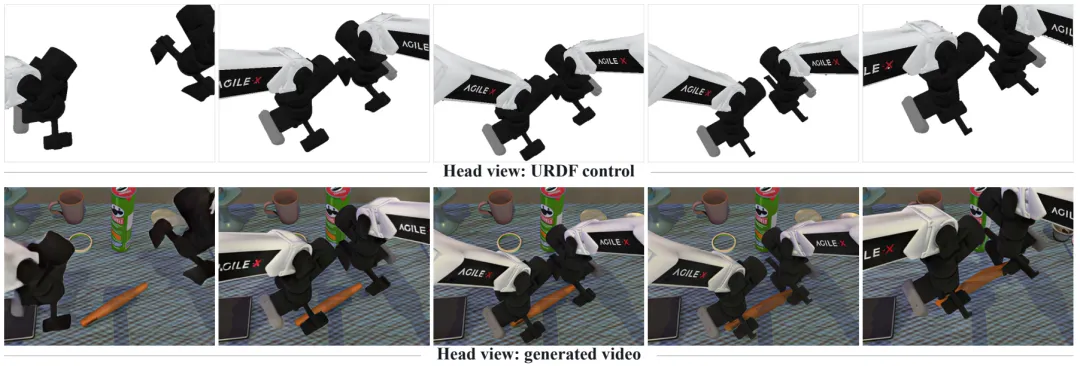
研究人员可以先在仿真器里规划关节运动,再根据机器人结构,把轨迹渲染成视觉信号,送入模型上下文。经过少量微调,模型便能生成与控制轨迹对应的未来视频。
这让机器人动作条件预测变得直观起来:先指定怎样移动,再观察场景可能怎样变化。人工绘制的物体路径等视觉信息,也能通过类似接口参与生成。
对于具身智能仿真训练,这样的能力提供了一种探索空间。研究人员可以比较不同动作对应的预测结果,为后续规划积累参考。
三个镜头,讲述同一件事
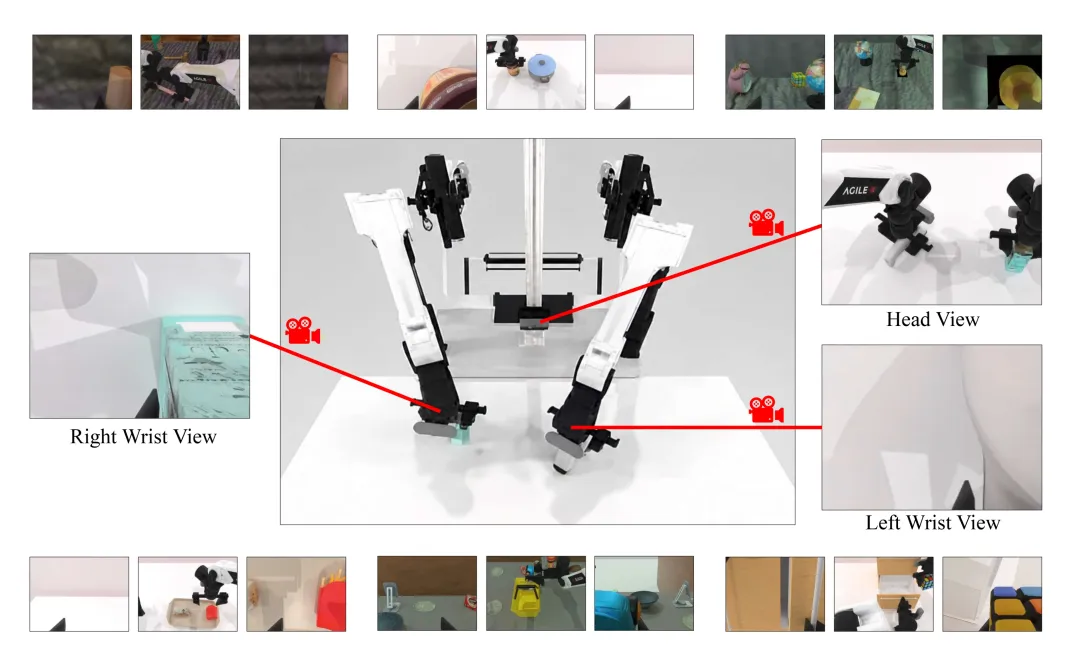
真实机器人常常同时使用多个摄像头:头部看全局,左右手腕看局部。
因此,机器人多视角一致性很有意思。机械臂抓住一个物体时,三个镜头应该从不同角度呈现同一个状态,动作时序与物体位置也要相互对应。
你可以把它理解为一场有三个机位的直播。镜头各有侧重,发生的始终是同一次操作。
对普通读者来说,这也提供了一种轻松的观察方法:看演示时多留意动作与空间怎样相互配合,一次抓取就能读出更多细节。
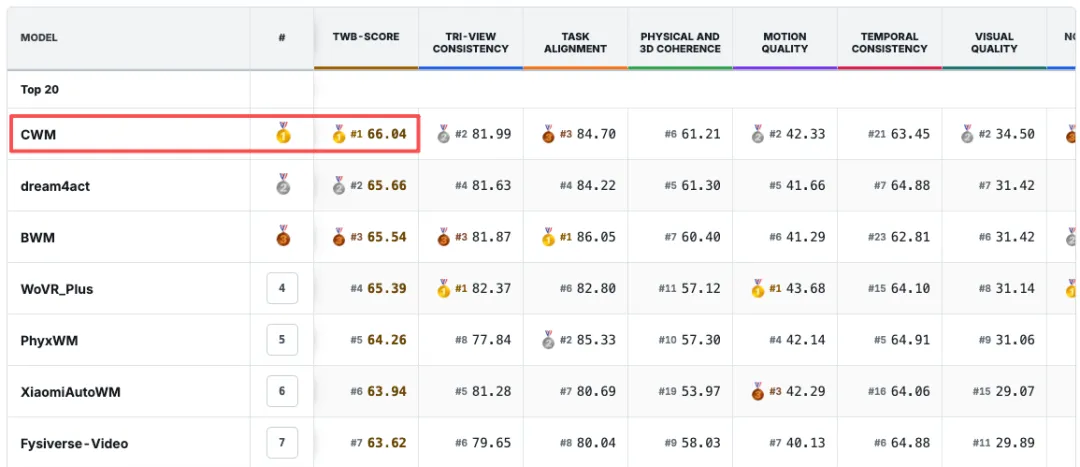
TriWorldBench机器人评测,正是观察这类能力的窗口。它把任务、运动、视角和画面等要求放在一起,让世界模型接受更完整的检验。
根据项目页展示的二〇二六年九月十一日榜单快照,CausalWM以66.04分位列第一。这个成绩体现的是该次评测设置下,多种能力共同呈现的结果。
在PAI-Bench机器人领域评测中,团队报告的RO分数为89.9。项目页也列出了本地评测和提示词设置,方便读者结合实验条件理解这一成绩。
观察世界模型物理一致性,可以沿着这些细节继续看:动作是否连贯,物体变化是否合理,多个视角是否说得上同一件事。
下一次进步,也许藏在中间那一步
CausalWM让人感兴趣的地方,是它把一个宏大的问题落到了具体过程里:运动怎样改变空间,空间怎样影响下一帧。
围绕AI因果推理应用,研究也因此多了一组可以观察、调整和比较的中间变量。研究者能沿着它们追踪预测过程,探索行动与结果之间的联系。
这项研究目前呈现的是未来视频预测与视觉条件控制。更完整的因果发现、反事实推理,以及与真实机器人行动的衔接,是团队继续探索的方向。带着这样的坐标去看演示,每一项进展都有清晰的位置。
从拿起瓶子到把它放进抽屉,未来画面背后那些细小的变化,正在成为模型学习的内容。
当机器人能够更细致地预演行动,我们也就更容易想象它参与日常生活的样子:整理桌面、协助收纳、搬运物品,每一步都与身边的空间自然衔接。
#人工智能 #世界模型 #因果世界模型 #CausalWM #AetherAI #机器人学习 #物理AI #机器视觉 #三维空间理解 #机械臂控制