ARTICLE · 1074938
AI审合同之后:核验这笔账,怎么付
丁凌AI实录 · 法务AI实测 / 07
AI把审查意见写出来了,我还不能直接发给业务。
意见里引用的法条,要对回原文;事实,要追到出处。出稿越快,这道工序越显眼。如果核验一份AI稿的成本,逼近我从头写一份的成本,省下来的时间就又还回去了。
所以,这篇我想算一笔账:核验这个动作,能不能也用工具降成本?
我目前的做法是,让工具取原文、做比对、留记录;对原文、版本和效力的确认,仍然留给人。至于究竟省了多少时间,我还没有足够的记录给出数字。
01
问一句“你确定吗”,还不算核验
第一直觉是把意见发回模型,问它:“你引的法条对吗?”
但模型再回答一次“对”,不会自动多出一份可以检查的依据。我需要的是:这条引用对应哪段原文,出自哪里,使用的是什么版本。
我的核验工具因此做得很简单:针对一条法条引用,取出可追溯的原文,逐字比对,给出三种状态——证实、证伪、查无。把命中的原文和出处截图,放进核验记录里。
这里的“证实”“证伪”,针对的是明确的比对项,例如引文是否与原文相符。法条引用准确,不等于这条意见的法律判断已经成立;事实是否具备、条文是否适用,还要另行判断。
“查无”则表示:这一步没找到可核对的依据,先停下来。它不能直接改写成“这条法规不存在”。
签字时,我希望垫在下面的是一份能翻查的比对记录。我的时间想省在这里。
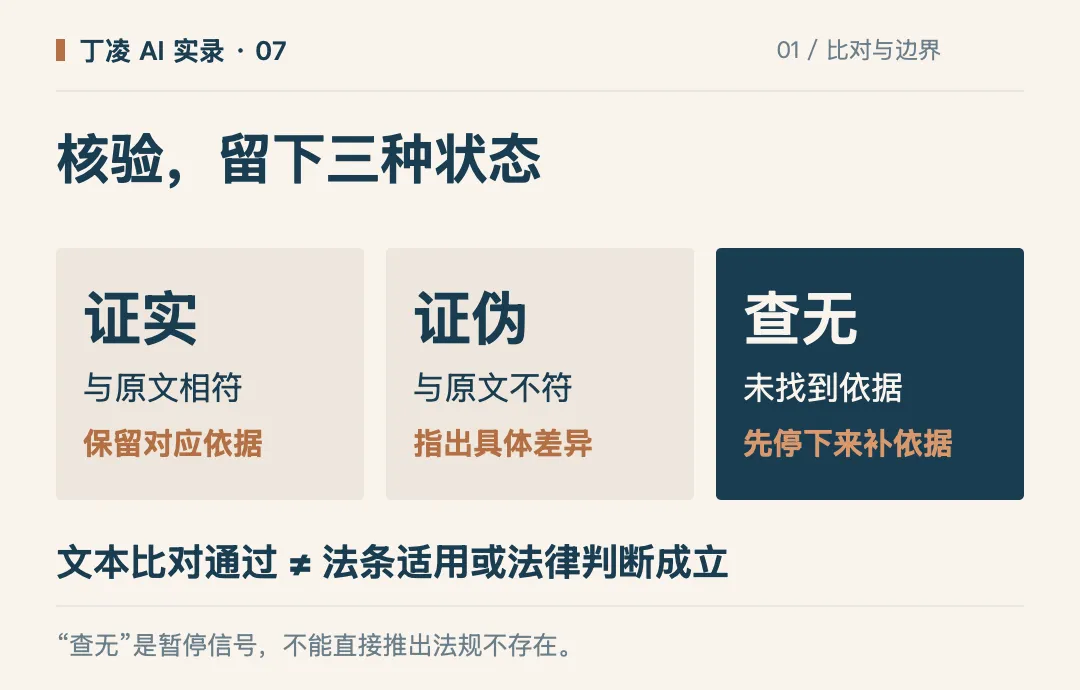
先核对可追溯的原文,再记录比对结果;查无时暂停。
02
我做了一轮重复检索
9月初,我把一家商用数据库的检索接口从自己的核验层级里摘了出来。当时凭的是使用印象:个别法规,偶尔召不回。
印象可以指导我自己的选择,写进文章还不够,所以我补了一轮测试。
从日常审查中选10个固定查询,包括违约金调减、竞业限制、显失公平等。外部接口每个查询连续查5遍,每次取前10条。本地自建法规库做同样的查询和重复次数。两边合计留下100份原始返回。
结果比我预想的温和。
外部接口的10个查询,5遍里的第一名都没变。前10条结果集,两两比对的平均重合度是97.5%。
变化主要出现在后面的条目和位次。我把它叫作:头部很稳,尾部在呼吸。
每个查询的5次返回,两两组成10对;10个查询,一共100对。其中28对返回序列不同:14对只是位次变化,另14对存在条目进出。有的法规,5次里只出现1到2次。
本地库按相同口径得到100对比较,结果集重合度和排序一致率都是100%。
这组数字只说明本轮返回的稳定性。第一名没变,不代表它一定正确;本地结果每次一样,也不代表库里的内容一定可靠。
方法注:97.5%是100对结果集的平均Jaccard重合度,即交集条数除以并集条数。28%的分母也是这100对比较,不是100次检索,更不是错误率。外部50次、本地50次,共100份原始返回;两侧各有100对比较。
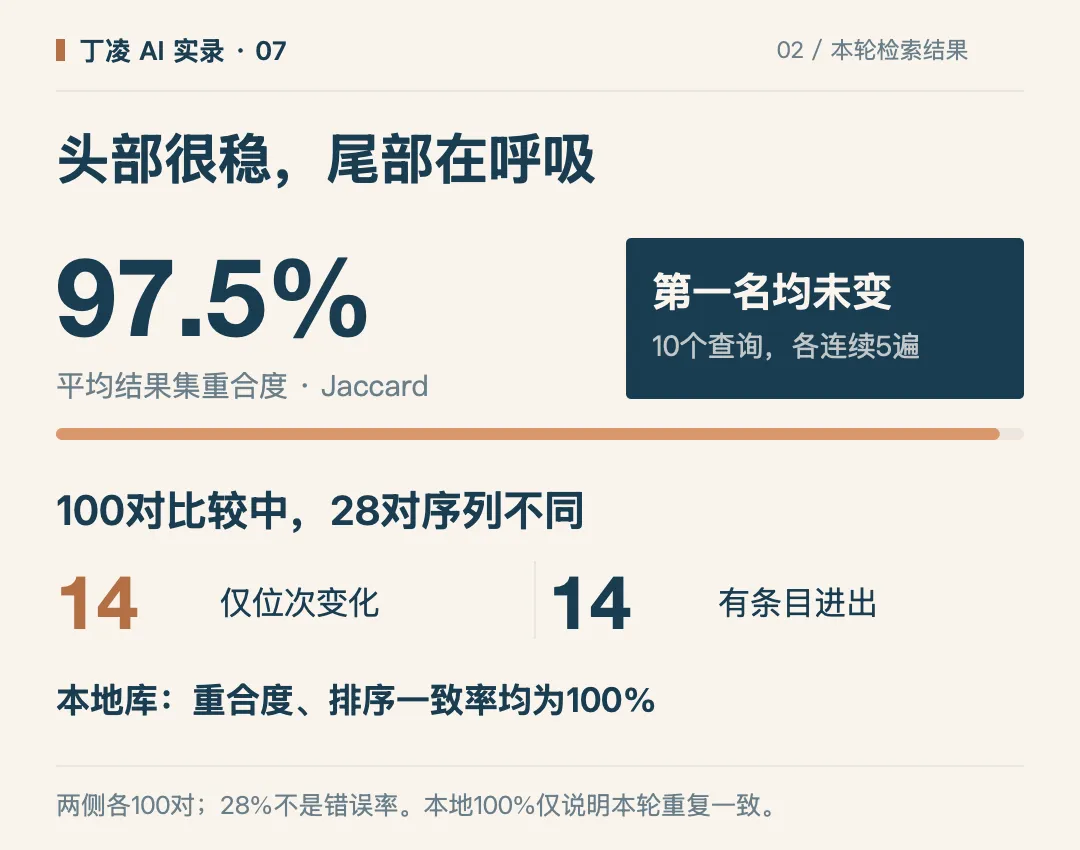
本轮每侧100对比较。重合度与序列变化不是正确率。
03
没出现在前十条,不等于不存在
这轮测试让我重新安排了分工:外部接口负责发现线索,本地库承接已有材料的核验。
这里有个必须拆开的信号:“查无”。
某部法规这次没进外部接口的前10条,可能是这次没有召回。仅凭这10条,我不能宣布它不存在。
本地库也一样要说清范围。某次查询没命中,首先只能说“本库在当前检索条件下没有找到”。要进一步确认库里确实没有,还得检查检索方式和覆盖范围;即便库里没有,也不能推出整个法律体系里没有。
因此,查不到时,我让流程停下来,补材料或继续查。确定性检索便于重复和检查,但它不能替我把知识边界变大。
04
查回来的东西,先做候选
我的流程是:先查本地库;无法核验,就提示补充材料或去外部查。外部查回的结果先作为入库候选,人工确认原文、版本和效力之后,再纳入自己的材料库。
对我来说,数据库像采购渠道,自己的积累才是日常反复使用的材料。采购回来,还要验收。
这道确认值得留下。一条错误如果进入知识资产,往后每次调用都可能把它带出来。原本只是偶尔漂进结果的噪声,会变成反复引用的“依据”。
沉淀层的门槛必须高于运行时。这是我在规则库里踩过的坑,在法规库里又用上了一次。
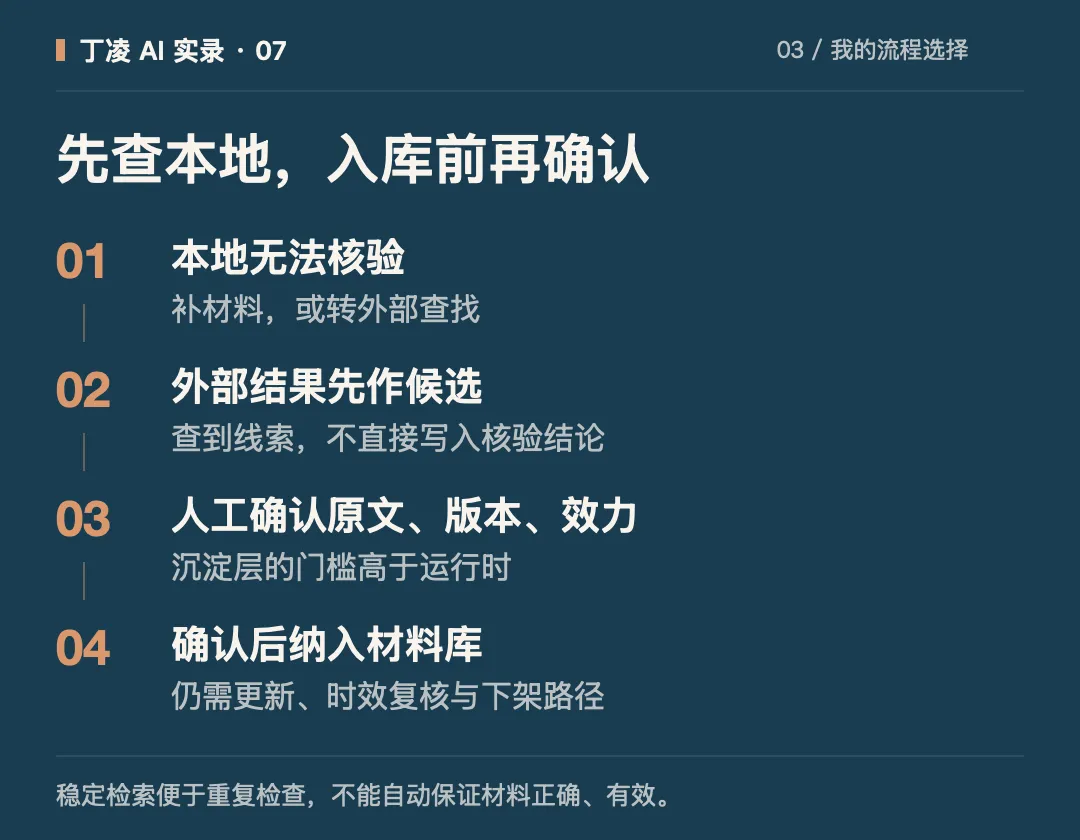
外部结果先做候选,确认原文、版本和效力后再纳入材料库。
05
本地库也可能确定性地错
我的库有九千余部法规,入库时没有带时效字段,全部默认现行有效。这是我已经知道的缺口,不该藏在“本地核验”四个字后面。
如果一部已废止的法规没有更新,确定性检索可以每次都把同一份旧文本取出来。结果很稳定,内容仍然可能错。
因此,我需要补上版本和日期记录、时效复核,以及明确的下架路径。库要能上,也要能下。
还要交代覆盖范围。我的库围绕自己的执业领域积累,遇到不熟悉的领域,查不到首先可能是覆盖不足。一个人维护的库,质量也受这个人的覆盖和更新能力限制。
06
带走一份核验记录
这套工具的前身,是我审查私募基金宣传材料时用的举证工具:给每一个宣传主张,找一段可指认的依据原文。
给业务材料挑错,和给自己的意见垫底,最后落到了同一个动作:让主张对得上依据,也把对不上的地方留下来。
如果要把这件事做成一份可复用的记录,我会保留这些栏:
01 · 待核验主张或引用
本次到底在核哪一句
02 · 对应原文与出处
依据能否被再次找到
03 · 版本、日期与效力核对情况
是否存在旧文本或状态不明
04 · 比对结果
证实、证伪,还是查无;针对哪一项
05 · 截图与人工复核记录
结论怎样得出,哪些问题尚未解决
查无时补一句原因:本库覆盖不足,还是当前检索未命中。两种情形都不自动等于引用错误。
AI判对的部分,扣掉核验成本,才是到手的提效。这笔账究竟能省多少,我还没有数字,后续会根据实际记录再写。
这轮只测了一家接口、10个日常查询,连续重跑,没有覆盖隔天隔周的变化。它支持我调整自己的流程,不能拿来给所有外部数据库下结论。
下一篇把这些坑收拢成三个问题:哪些信息在文本里,哪些需要补口径或由人判断,这一步到底交付批注还是成品。
你核验AI稿时,最费时间的是找出处、核版本,还是判断是否适用?
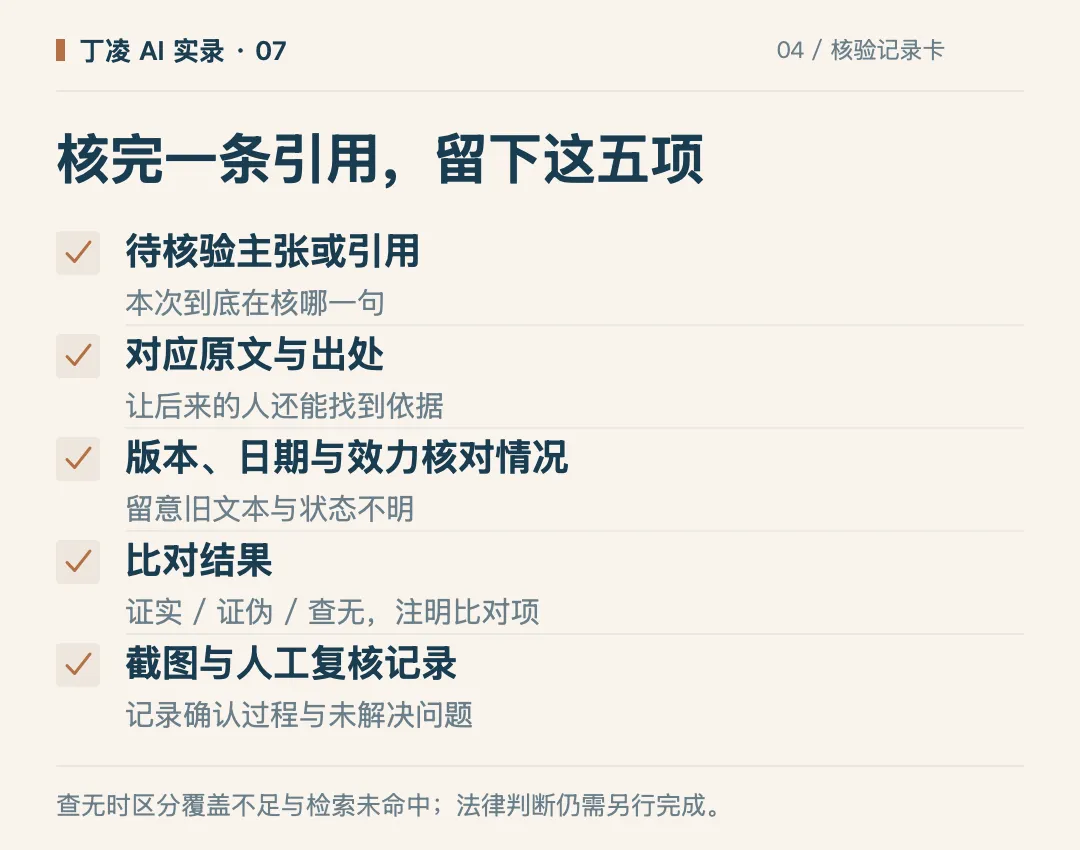
核验记录五项:主张、依据、版本、比对结果、复核记录。
丁凌AI实录 · 法务AI实测
个人独立运营,专注 AI 原生法务的实测与思考。
不构成具体法律意见,不代表任何任职机构立场。