ARTICLE · 1075113
AI助手记得住,但记一次太贵,Jev-Mem把记忆成本砍了80%
你的 AI 助手每次"记住"一条信息,背后要调用至少 3-5 次大模型
你的 AI 助手有记忆功能,对吧?
但你知道它每次"记住"一条信息,背后要调用多少次大模型吗?
答案是:3-5次。
01
PART
记忆系统的隐性成本
HIDDEN COST OF MEMORY
现在的 AI Agent 记忆系统,基本流程是这样的:
用户说了一句话 → 大模型判断:这条信息重要吗?
如果重要 → 大模型判断:和之前的哪条记忆相关?
下次提问时 → 大模型判断:需要检索哪些记忆?
检索到候选 → 大模型判断:这些记忆真的相关吗?
最后 → 大模型综合记忆生成答案
每一步都在调用 LLM,每一步都在烧 token
对话越短感觉不到,一旦进入长对话场景(比如连续工作 8 小时),记忆系统的 token 消耗可能占到总成本的 40%。
02
PART
Jev-Mem:把记忆管理成本砍掉 80%
SYSTEM ONE / SYSTEM TWO
最近 Hugging Face 趋势榜上有个新项目 Jev-Mem,核心思路很简单:
不是所有记忆管理决策都需要大模型
它借鉴了人类认知的双系统理论:
System One(快思考)
专门做结构化决策——这条信息重要吗?和哪条相关?现在该停止检索吗?响应时间 70-500 毫秒,成本是大模型的 1/100。
System Two(慢思考)
只在最后生成答案时出场,做真正的深度推理。
关键点:90% 的记忆管理操作,根本不需要生成文本,只需要一个"是/否"或"选 A/B/C"的判断。
这就好比你整理书桌,不需要每次都请建筑师来帮忙判断"这本书该放哪"。
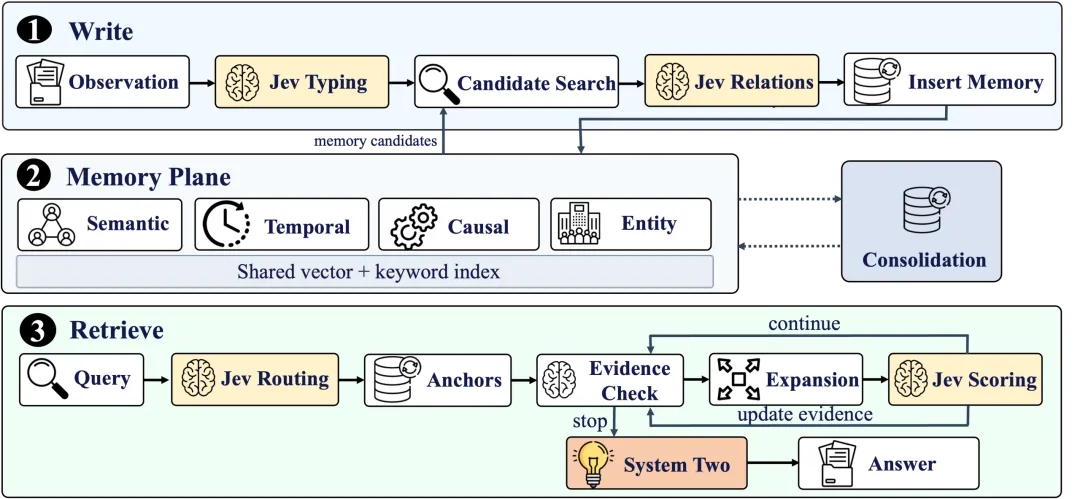
— Jev-Mem 架构:System One 控制记忆写入和检索,System Two 只负责最终答案生成
03
PART
性能对比:同样准确,但快 6.6 倍
BENCHMARK RESULTS
在 LoCoMo 长期对话记忆基准测试 上:
准确率略高,但速度和成本优势碾压
04
PART
落地场景:谁最该关注这个方案?
REAL-WORLD USE CASES
光说性能不够,来看几个真实场景。
程序员的 8 小时编程助手
小张是个全栈工程师,习惯用 AI 编程助手连续工作一整天。早上讨论数据库设计,下午写 API 接口,晚上调试前端 bug。一天下来,对话历史超过 200 轮。
传统记忆系统的问题:每轮对话都要调用大模型判断"哪些信息要记住",一天下来,记忆系统的 token 消耗比实际写代码的消耗还高。而且随着记忆积累,检索越来越慢,响应延迟从 1 秒变成 5 秒。
Jev-Mem 的方案:用 System One 做记忆分类和关联判断,只在真正需要综合推理时才调用大模型。结果是:同样的 200 轮对话,记忆构建时间从 17 分钟降到 2.5 分钟,查询延迟稳定在 1 秒以内。
小张的感受:"以前下午开始就明显变卡,现在一整天都很流畅。"
客服机器人的成本账
某电商平台的智能客服,每天处理 5000 个咨询。用户经常跨多天咨询同一个问题。传统记忆系统下,5000 个用户 × 平均 10 轮对话 × 每轮 3-5 次大模型调用 = 每天 15 万-25 万次额外的 LLM 调用。按 token 计费,每月记忆系统的成本占到总成本的 35%。
Jev-Mem 的方案:用结构化决策模型处理 90% 的记忆管理操作。实测结果:记忆相关成本降低 78%,响应速度提升 40%。
个人助理的长期记忆
小李用 AI 个人助理管理日常工作,希望它能记住工作习惯、常合作的同事、项目优先级。传统方案短期记忆还行,长期记忆成本指数级上升。
Jev-Mem 的方案:用多关系记忆图谱(语义、时间、因果、实体)组织记忆,System One 快速判断关联关系。实测在 3 个月的连续对话场景下,记忆检索时间稳定在 1 秒以内,而传统方案已经退化到 8 秒以上。
小李的感受:"它真的像有个秘书在帮我记事情,而不是每次都从头问起。"
05
PART
如何集成到你现有的 AI 工具中?
INTEGRATION GUIDE
说了这么多,最关键的问题:我怎么用上?
Jev-Mem 底层的 Jev 模型来自 TypeSafe AI,已经有成熟的集成方案,覆盖主流 AI 编程工具。
方式一:Claude Code / Codex 一键安装(最简单)
如果你在用 Claude Code 或 Codex CLI,两条命令搞定:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
安装后输入 /typesafe,粘贴你的 API Key,就能用了。注册 TypeSafe 账号送 $5 免费额度,日常使用很难花完。
⚠️ 注意:安装完不是自动生效的
TypeSafe 技能的作用是教 Claude 如何调用 Jev API。安装后你有两种使用方式:
让 Claude 帮你写调用 Jev 的代码——在对话中说"使用 TypeSafe 技能",Claude 就会加载这个技能,帮你写调用 Jev 的程序。比如你可以说:
"用 TypeSafe 技能,帮我写一个客服工单分类系统,自动判断工单属于哪个部门、是否紧急。"
安装上下文压缩插件(最实用)——如果你最关心"聊天越来越慢、token 越来越贵",那真正需要的是 fast-jev-compaction 插件:
claude plugin marketplace add tamaratran/fast-jev-compaction
claude plugin install fast-jev-compaction
安装后重启 Claude Code,输入 /compact 就会用 Jev 压缩上下文。有用户反馈,上下文从近 100 万 token 压缩到 8.6 万,只用了 1 秒。
其他集成方式
如果你有更复杂的需求,Jev 生态也提供了其他选择:
Python 项目集成
如果你是开发者,可以在自己的项目里直接调用 Jev-Mem 的记忆 API,实现自定义的记忆管理逻辑。
轻量级 Jev 调用
不需要完整记忆系统,只想在代码里加几个"快速判断"?Jev 提供了 Python 装饰器,一行代码就能把普通函数变成结构化决策。
MCP Server
如果你用的是支持 MCP 协议的 AI Agent(比如 Hermes、Cursor),可以跑一个 Jev MCP Server,让 Agent 在工作过程中直接调用 Jev 做判断。
具体文档可以参考 GitHub 仓库和 TypeSafe AI 官网。
///
LAST
写在最后
FINAL THOUGHTS
AI Agent 的记忆问题,不是"能不能记住",而是"记住的代价有多大"。
Jev-Mem 的价值在于,它让记忆管理从"每次都调用大模型"变成"只在必要时调用"。这不是技术细节的优化,而是架构层面的重构。
更关键的是,它已经不是一个停留在论文里的方案——从 Claude Code 插件到 Python SDK 到 MCP Server,你今天就可以在自己的工具里用起来。
当你的 AI 助手能记住 8 小时的工作对话,而成本只增加 20% 时,真正的长对话场景才会到来。
项目地址:github.com/libingzheren/Jev-Mem在线体验:huggingface.co/spaces/libingzheren/Jev-MemTypeSafe AI 官网(注册领 $5 额度):typesafe.ai
我是小黑,热衷于分享 AI 观察与实战干货。如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。