ARTICLE · 1075116
让 AI 读遍公开网页:firecrawl、wigolo、BrowserAct 三条路线实测,与四组判例划出的边界
丢给 AI 一个链接让它总结,回你一句"抱歉,我无法访问",你信不信? 换个网站,迎面一整屏滑块;狠下心挂上无头浏览器,对面悄悄发来一个伪装正常的假页面。只要让 AI 帮忙查过资料,这三个场景多少都碰见过。
反爬墙不是越来越厚这么简单——就在九天前(2026-09-15),Cloudflare 给带广告的页面改了默认规则:来路不明的 AI 爬虫,默认请出去。墙开始收费了,这是和去年完全不同的一页。
这篇把当下代表三条路线的工具一次讲透:谁解决什么、花多少钱、软肋在哪。其中一条路上,我本机有完整的安装、使用、卸载留档;另外两条,我把官方基准和第三方评测对着查了一遍——全文数字都标了口径。
最后给你看四组法院判例:它们决定前面这些工具敢不敢用、怎么用,看完那节再动手。
一、先看懂墙:拦截正在变成"收费站"
Cloudflare 这道墙挡在大约五分之一的网站前面。它 2026 年 9 月公布的一组自家口径数字,值得每个用 AI 查资料的人看一眼:互联网流量里非人类占比首次过半;6 月份为训练目的的爬虫请求占 52%,而 2025 年春天还是 22%。
更扎眼的是"抓取-回访比":Anthropic 的爬虫每给内容站带来 1 个真人回访,自己先读 73000 页;OpenAI 是 1700:1;Google 搜索的老规矩才是 14:1。
于是规则从"允许直到你拒绝"翻成"拒绝直到你允许":新域名默认拦 AI 爬虫,付费放行走 HTTP 402(对,就是那个闲置了二十多年的"Payment Required"状态码),按次谈价——这套 Pay Per Crawl 目前还在内测。
一句话:墙不是变厚,是在变收费站。
适合谁:所有用 AI 抓过资料的人都该知道这个背景。不适合谁:还按"公开网页=随便读"规划数据管道的人——那个默认值已经改了。
二、路线一 · firecrawl:云端自来水厂
把任意公开网页变成 LLM 能直接吃的 Markdown 或结构化数据,一个 API 搞定——JS 渲染、代理轮换、PDF/Word 解析、点击滚动这些脏活全在云端替你干。
按官方 2026 年 1 月跑的 1000-URL 基准(厂商自测口径),覆盖率 96%,同场景 Puppeteer 是 79%、裸 curl 75%。
它的商业形态最能说明这条路线的本质:自来水厂模式。免费档每月 1000 credits,之后 16到599 月档按量计费;数据先过它的云。
昨天(9 月 23 日)它官宣 7500 万美元 B 轮,顺手发了个新东西:一边和 Wikipedia 签付费数据协议,一边让 AI 代理按需付费引用内容方——从"帮你爬"升级成"卖你一张通行证"。官方口径已有 150 万+开发者在用,Zapier、Replit 都在名单里。
社区风评也要给全:HN 和 Reddit 上最常见的抱怨是免费额度天花板来得早、新能力云端版先行、自托管开源版慢慢追。
一句话:省心是订阅制的,账单替你数着页。
适合谁:要规模化、接受按量付费的团队。不适合谁:数据敏感不想出本机、预算为零的个人。
三、路线二 · wigolo:自家院子里打井
开源项目,作者是个孟加拉独立开发者,GitHub 目前 5200 多星,还在公测(v0.2.1)。思路跟 firecrawl 正好相反:所有东西跑在你本机——不要 API Key、不按次付费,搜索、抓取、爬站、提取、缓存、研究一条龙。
接进 Claude Code 或 WorkBuddy 这类智能体只要一行:
npx wigolo init --agents=claude-code
它的两招挺聪明。一是分层路由:先试普通 HTTP 请求,发现是 JS 渲染或触了反爬,自动升级本地浏览器引擎重渲染;而且按域名记仇——某个站被标记"需要浏览器",下次直接走浏览器通道。
二是诚实:真绕不过的墙,返回明确的 blocked_by_challenge 标签,不会把反爬页伪装成正文糊弄你;拿不准的字段返回 null,不编。
代价写得明明白白:下载引擎加本地模型约 1.5GB,资源吃在你自己机器上;18 个搜索引擎的查询也好、目标网站的抓取也罢,挨盯的是你本人的 IP——云端服务替你扛的东西,打井之后全归你扛。
一句话:免费上网,水表装在你家。
适合谁:零预算、隐私优先、日常读几十页的个体。不适合谁:要批量采集硬目标的人——它按研究级规模设计,不是采集器。
四、路线三 · BrowserAct:工程车——我装过,又卸了
前两条都进不去的站,才轮到它——它的设计是三层递进、一层兜一层。
环境层:把浏览器伪装到指纹检测都过关,官方自述 reCAPTCHA v3 评分 0.9。执行层:常见验证码自动解,复杂图形官方称识别率 92%+;真解不了的走人工层——remote-assist 生成实时链接,你手机上点两下接管登录,Agent 无缝继续。
官方演示里最狠的一手:复用本地 Chrome 登录态,从人机验证以严格著称的内容平台上抓了 84 条公开笔记并自动出分析报告。第三方评测给 4.0/5,积分制计费、大部分功能免费。
那为什么我说我又把它卸了?
去年 7 月,我给自家知识库爬虫配过它当反爬兜底——正是"普通抓取失手时顶上来"的定位。
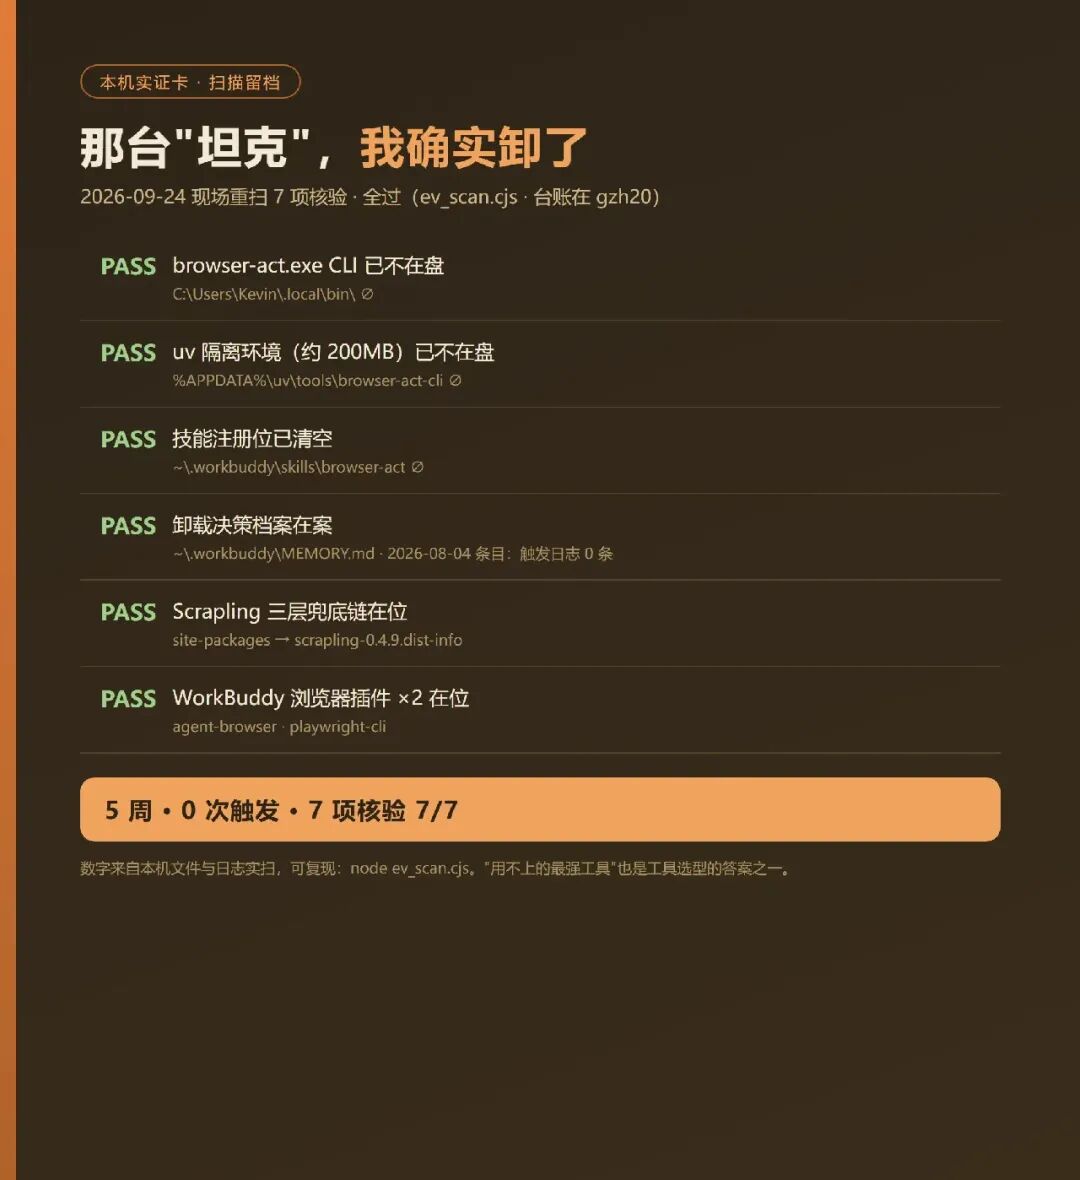
接入之后我留了完整的触发日志。到 8 月初,我把整套东西(CLI、隔离环境约 200MB、技能注册位)全部卸载,日志里的触发记录是一条——零条。
不是我遇到的站太温和,而是我抓的那批公开站点,Scrapling 三层(普通请求→stealth 请求→动态渲染)配静态兜底就全接住了——坦克的活,一场没轮到。
一句话:工具的尽头不是最强,是"用不上"。
适合谁:有明确硬目标、常规手段全失效的攻坚任务。不适合谁:读普通网页的轻量需求——还有,战场没到"堡垒级"的人,先看看下一条。
五、被你忽略的第四路线:先盘点家里
写这篇时我核了一遍本机:Scrapling 0.4.9 在位、两个浏览器自动化插件在位、上面那张实证卡 7 项核验全过。这条"先盘点家里"的路线对 WorkBuddy 用户几乎零成本:
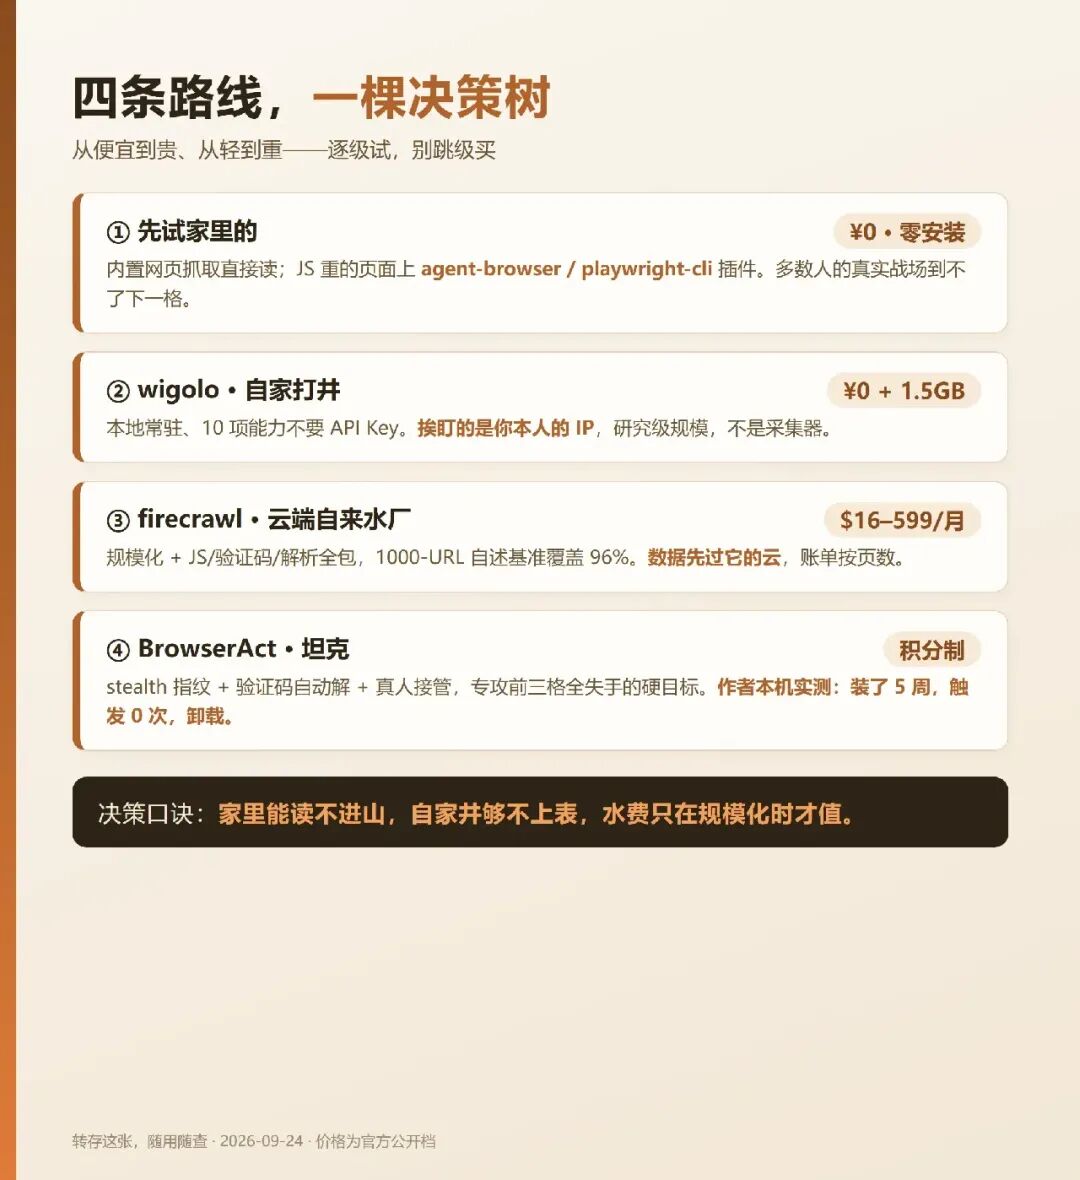
普通页面,内置的网页抓取能力直接读;JS 重的页面,agent-browser / playwright-cli 插件顶上。 再硬的骨头,才轮到 wigolo / firecrawl / BrowserAct 出场。我的知识库爬虫就是这套配置跑出来的——51 万段文档里相当一部分,没经过任何一家第三方。
选型其实就一棵树,做成卡了:转存这张,随用随查。
六、压轴:四组判例——能力相同,合法性两样
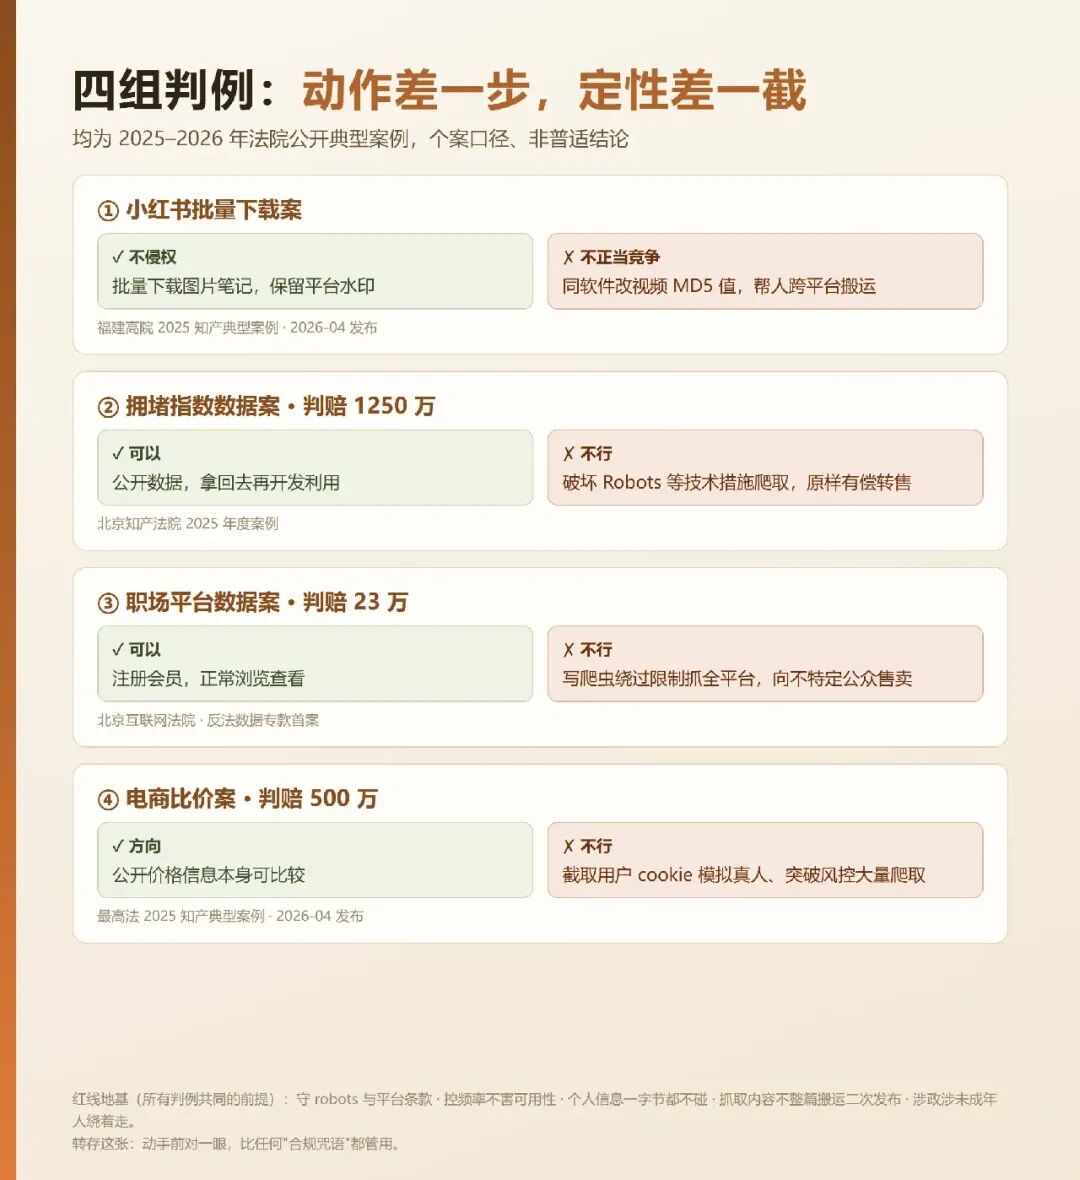
前面五节讲的都是"能不能"。这一节决定"该不该",用的是 2025-2026 年法院真实划的四道线(均为法院公开发布口径,个案认定,不展开法律意见):
第一组:同样是"下载"。 小红书诉批量搬运工具案(福建高院 2025 典型案例):用工具批量下载平台图片笔记、保留水印——不构成不正当竞争;同一款软件的另一功能,改视频 MD5 值帮人跨平台搬运——构成。技术动作只差一步,一个是"自己看",一个是"冒充原件卖"。
第二组:同样是"公开数据"。 拥堵指数案(北京知产法院):反映路况的数据人人可见,但某公司破坏 Robots 协议等技术措施持续爬取、原样有偿转售,判赔 1250 万。法院把话说清了:公开数据,再开发利用可以,搬走原样卖不行。
第三组:同样是"会员权限"。 职场平台数据案(北京互联网法院首例适用反法数据专款):充值会员、写爬虫绕过技术措施抓全平台数据、向不特定公众售卖,判赔 23 万。"我是买了会员的"不是挡箭牌——付费看和批量卖是两种行为。
第四组:同样是"比价服务"。 电商数据案(最高法 2025 典型案例):绕开反爬、截取用户 cookie 模拟真人爬商品数据,判赔 500 万——法院特别点名了侵犯消费者隐私。
四组合起来,就是"爬取自由"的真实边界:公开≠你的;能读≠能卖;自动化≠无门槛;技术中立≠手段中立。 至于 robots 协议、平台条款、抓取频率、个人信息——那是所有判例共同的地基,不用背,抓之前把对应那组判例看一眼就有数。
七、两分钟起步
今天就动,按这个顺序来:
一、先试家里的:把上周没打开成功的那个链接丢给 WorkBuddy,读到了就到第四节歇着——你的战场可能根本用不上外购武器。
二、要免费常驻:装 wigolo,跑一次 doctor 自检。
三、要规模化:firecrawl 注册拿免费 1000 credits 试一个真实任务,心里有账单再谈升级。
四、硬骨头:BrowserAct 定向攻坚——动手前把第六节那张卡看一遍。
你的 AI 缺的从来不是聪明,是一条既丝滑又踩在线内的上网通道。
你的 AI 这个月说了几次"抱歉,我打不开这个链接"?评论区报上那个站名和你的用途,我告诉你该走哪条路线。