ARTICLE · 1076237
AI 不是固定模式,五个台阶,你在哪?
月初部门会,讨论要不要把 AI 工具"统一"一下。有人提议:“干脆定一个,全都用同一个,省事。”我没马上接话。
因为“省事”这个念头,我自己早就犯过了。之前我给系里推过一个 AI 工具,想法很朴素:够强、够好用,大家应该都会喜欢。结果一周后,三种反应摆在我面前:
学生说:“太重了,我就想查个无人机条款。”老师说:“功能不清晰,我要的是直接出消防课件。”鉴定中心的同事更干脆:“这个,我不敢用,资料里有当事人的名字。”
同一个工具,落在三拨人手里,长出三种表情。
我这才明白:AI 不是一把尺子,是一排台阶。
你站在第一级,就别急着看第五级的东西。
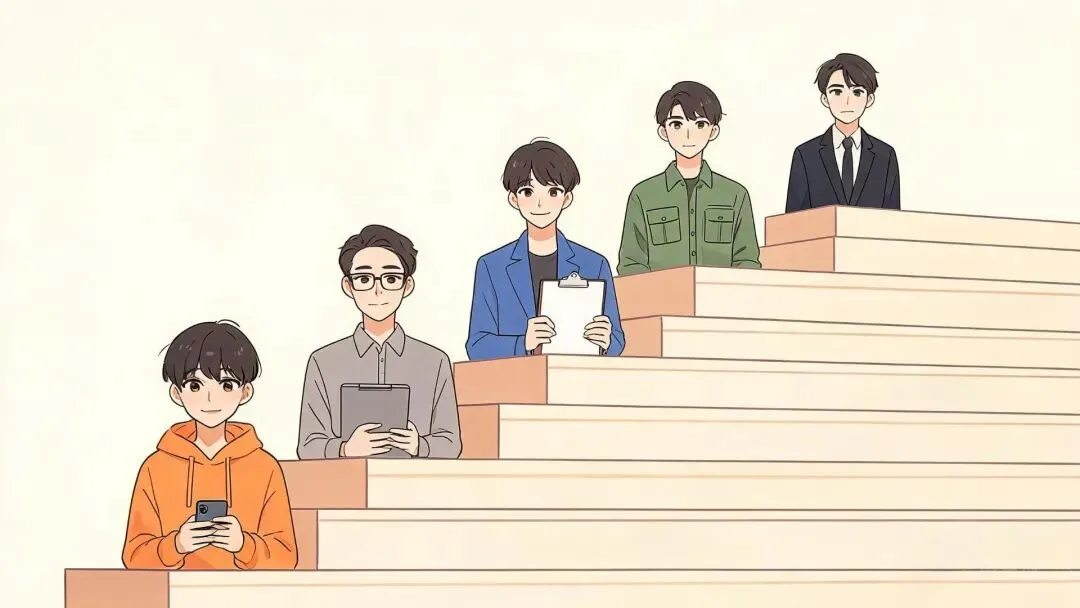
第一级:学生,一台手机就够
学生要的从来不是“最强”,是“够用,而且马上能用”。
配法就一个:IMA + 一个自己不断攒出来的知识库。
把课程讲义、法条、实训手册丢进去,随时问。司法警务的学生建“公安司法法规库”,鉴定方向的学生建“案件标准库”等等,考前翻起来特别顺。
零成本、零配置、手机就能用——这才是高职学生真实的设备条件; 这一级别想着加东西。越简单越好,加任何一样都是负担。
我只留一句话给学生:它不是帮你写作业的,是帮你把老师讲过的东西,重新问一遍。
第二级:教师,从“聊天”到“干活”
到了这一级,关键词变了。老师不满足于“问”,他要“产”。
配法是组合拳:IMA 管存+WorkBuddy 管产
IMA 把一门课的课标、教案、题库沉下来,是系里内容的老底子; WorkBuddy 直接读你电脑里授权的文件夹,一句话出课件、出试卷、批量改文件名——这是普通聊天 AI 做不到的。
现在市面上同类有 豆包工作、Trae、Coze(扣子),搭轻量助手很快;但老师日常最缺的,是“手上这份文件,直接变成成果”,所以能操作本地文件的 Agent 更对味。
我见过的实例:一位老师上午还在 IMA 里翻自己攒的资料,下午资料就变成了课件和一套卷子。
这一级真正的坎,不在技术,在习惯——你得先接受它不是搜索框,是AI同事。
第三级:教学管理者,把 AI 用成“组织知识库”
这一级,是我的位置。教学负责人、专业带头人、鉴定中心负责人,多半卡在这里。
配法:WorkBuddy 打主力 + 组织级知识库 + 定时自动化。
WorkBuddy 三个模式:Ask 问事、Plan 出方案、Craft 直接交付。申报书初稿、汇报 PPT、专业调研报告,都在射程里; 知识库从“我的”升级成“大家的”(ima 的共享知识库):专业建设材料、政策文件、历年申报,沉下来——这是系里最值钱的东西; 再加自动化:比如每天自动汇总一条“职教 / 司法鉴定新政”。
这一级有个信号:当你第三次教它“同样的流程”,就该把它固化成模板或技能 Skill 了。 从“用工具”,到“搭系统”。
想自己搭的同行,可以看:Dify(企业级应用)、n8n(复杂流程自动化)。我用“Obsidian + LLM Wiki”,如果大家需要我后续可以来个教程~;谨记:别贪多,先挑一个能跑起来的。
第四级:鉴定中心,数据不能出门,就本地部署
前面三级,都能在网上跑。到这一级,一堵墙横在那儿:数据不能出内网+权限控制
司法鉴定涉及当事人信息,这是红线,没得商量。配法必须换:
本地 Ollama(跑模型)+ RAG(本地知识库检索)+ 本地向量库。
Ollama 一键装,一台带显卡的机器就能跑,是本地部署里门槛最低的入口; RAG 是关键:把鉴定标准、方法规范、内部流程做成知识库,先查再答——隐私不出门、少胡说、知识还能实时更新。
同类本地方案,按需求挑:
- AnythingLLM——开箱即用,隐私天花板,个人 / 小团队首选;
- RAGFlow——吃扫描件、表格、复杂版式最准;
- FastGPT——中文优化、部署最快;
- Open WebUI——给同事一个像 ChatGPT 的本地界面;
- Cherry Studio——桌面端零配置,先试水。
说个好消息:内网算力主机就是这一级的雏形。把它接上 RAG 和向量库,就是一个“鉴定专用助手”。鉴定中心也在 NAS 上面部署了,后续准备用腾讯刚开源没几天的“WeKnora”试试!
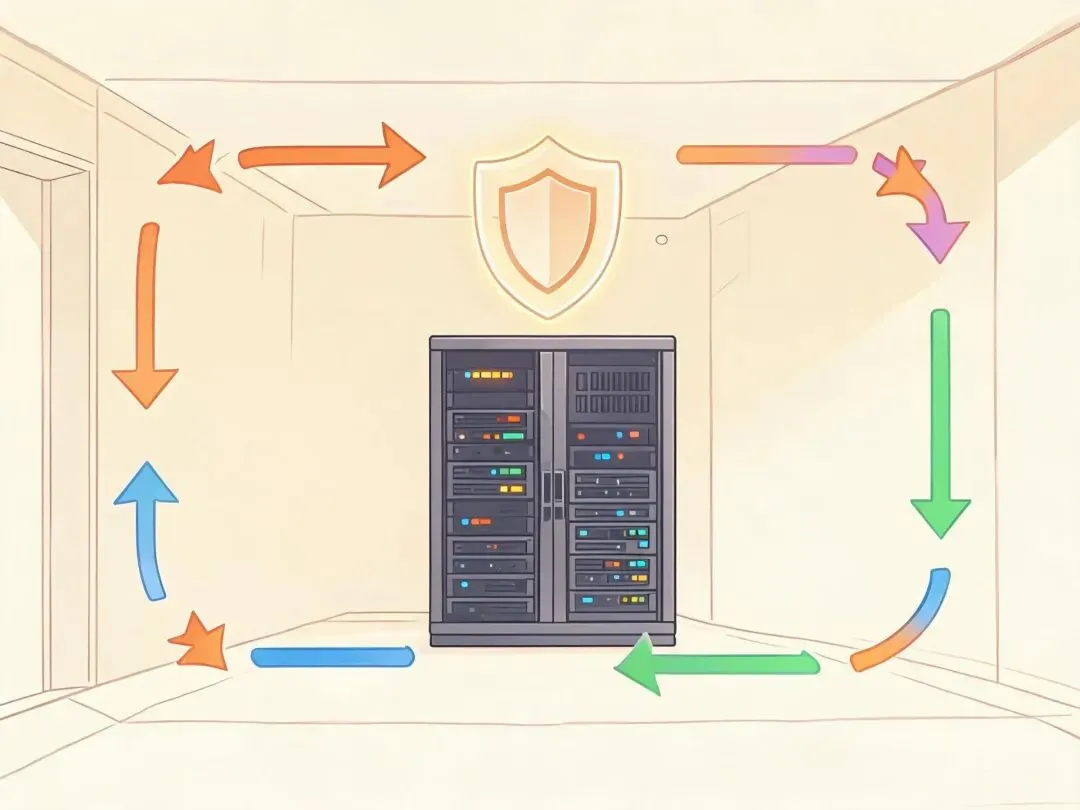
但别忘了合规那几件事:关掉默认端口、上访问白名单、关键结论必须给出处、全程留痕。 做到这几条,才敢让业务真用。
第五级:校级平台,从“能跑”到“能扛、懂行”
这一级不是个人该操心的,是学校信息化部门的活。但它决定了天花板。
配法:vLLM(高并发推理)+ LoRA 微调(注入领域知识)+ Agent 编排 + 评测。
Ollama 到 vLLM 的分水岭,一句话:Ollama 是一个人用,vLLM 是一群人同时用;(学校信息中心已经部署了本地免费大模型了) 微调补短板:RAG 管“知识不在模型里”,微调管“说话不像这行的”; 编排和评测:多智能体接力干活,同时建评测集——防止越训越差。
框架这一层,什么LangChain / LangGraph、Dify、Coze、Manus (都是天书)各有各的位子。真到这一级,那是纯技术的事了,咱就不管了。
什么时候该往上走?
这才是关键。
不是所有人都要上第五级,也不是所有人都该老死在第一级。
升级,是被"卡点"推着走的:
一句话:别急着给所有人配最强的,先给最卡的人配最对的。
回到开头那个问题——“要不要统一一个工具?”
我现在的答案是:工具可以统一,台阶不能。
学生就该轻,鉴定中心就该稳,中间那一层,该把流程沉下来。
最后问你一句:你带的团队,现在卡在第几级?你有没有给谁,配了一套他用不动的“最好的工具”?
💡 今日思考:最好的工具,往往不是最强的那个,而是刚好接住你那一级的那一个
~🥮顺祝大家中秋安康🌸