ARTICLE · 1083466
AI 智能体该「调工具」还是「写代码」?一个决策决定了成本与准确率
一句话摘要:工具调用把每个中间结果都摆到模型面前;代码执行让模型通过自己写的代码,精确决定哪些结果能返回。它不是风格偏好,而是可量化的架构选择。
🤔 一个问题:20 个人谁超了差旅预算?
一个听起来简单的问题背后藏着真正的成本。Agent 要回答"20 位员工谁超了 Q3 差旅预算",需要每个员工的每笔费用明细,对照他们级别的预算上限。
用最"显然"的方式做——让模型逐个人调用工具——就是 20 次工具调用,每次返回几十上百个明细项,而每一个都要塞进模型的上下文,只为让它做一次求和。超过 2000 个明细项、50KB 原始数据,模型其实根本不需要读——它只需要一个总和。
这就是大多数教程跳过不谈的真实成本:Agent 到底怎么在真实世界采取行动?
⚙️ 两种动作原语(Action Primitive)
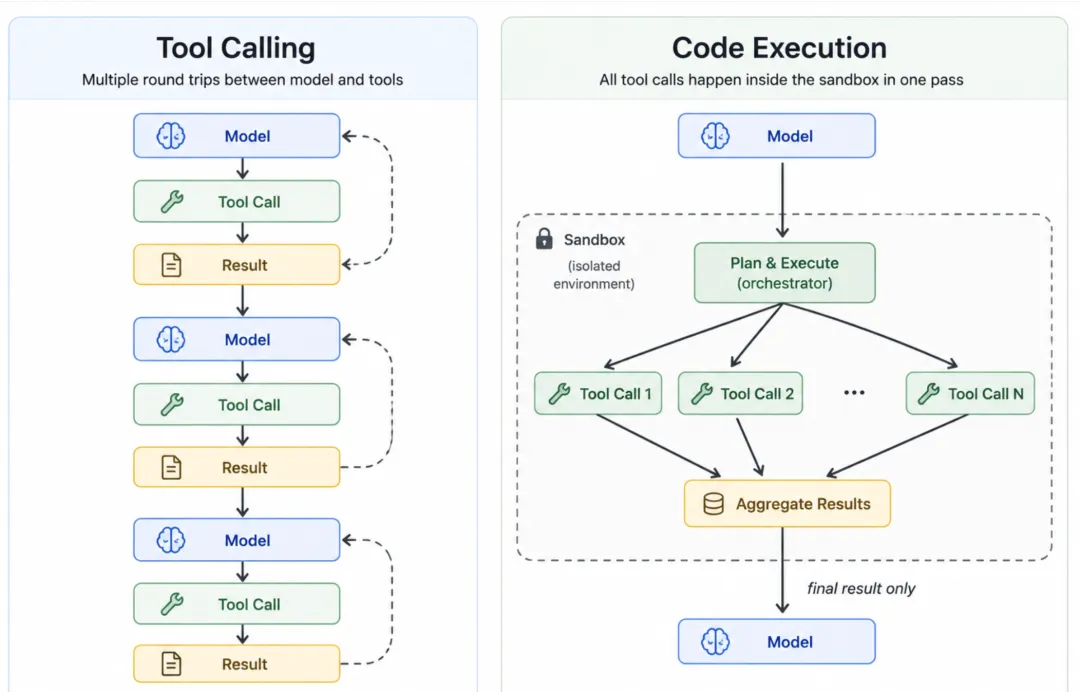
工具调用(Tool Calling):模型一次输出一个结构化请求,宿主程序执行,结果回到对话里,模型再决定下一步。这是大多数人的第一个选择。
代码执行(Code Execution):模型写一个真正的 Python/TypeScript 程序,在沙箱里顺序或并行执行多次动作,只有程序的最终输出返回给模型。
两者不是彼此的包装,也不是谁取代了谁——它们机制不同、失败模式不同、基础设施要求和成本曲线都不同。
一句话概括全部区别:
工具调用把每个中间结果都摆在模型面前;代码执行让模型通过它写的代码,精确决定哪些结果能返回。
🧩 机制上的关键差异:Programmatic Tool Calling
让代码执行真正"不一样"(而非重新贴标签的工具调用)的,是 Anthropic 在 2025 年 11 月推出的 Programmatic Tool Calling:
在工具定义里加一个 allowed_callers字段,把工具标记为"可从生成的代码中调用"同时把 code_execution工具加到请求里模型要行动时,写一个完整脚本(循环、条件、错误处理),在沙箱里直接调这些工具 - 每个单独的工具调用照样按普通工具调用方式执行
,但结果被脚本截获处理,而不是推进模型上下文 只有脚本跑完,最终输出(而不是别的)才返回模型
weather_tool = { "name": "get_weather", "description": "...", "input_schema": { ... }, # 这行是关键:把工具标记为可从生成代码中调用 "allowed_callers": ["code_execution_20250825"],}加上这行后,模型就能写脚本,自己调 15 次 get_weather(很可能用 asyncio.gather 并行)、求和排序、只打印最终答案。15 次查询里的 14 次,以及所有中间比较,都不进 Claude 的上下文。
📉 为什么代码执行在大规模任务上更胜一筹?
不只是直觉,有真实数字:
- Anthropic 官方案例
:Google Drive → Salesforce 工作流,token 从 15 万降到 2000,减少 98.7%——因为完整会议记录留在执行环境里,没有穿过模型两次 - 内部基准
:复杂研究任务平均 token 从 43,588 降到 27,297(-37%),而 GAIA 准确率反而从 46.5% 升到 51.2%,内部知识检索准确率从 25.6% 升到 28.5% - 学术支撑
:2024 年 CodeAct 论文发现,用可执行代码行动的 Agent,在复杂多步任务上比用 JSON 工具调用的成功率最高高出 20%
关键点:这不是纯省钱。把编排逻辑交给真正的代码,而不是让模型用自然语言在脑子里追踪十来个中间值,确实降低了模型"算错账"这类错误。
🛡️ 什么时候工具调用仍然赢?
代码执行不是无条件升级:
- 单次调用
:一次调用、一个小结果,起个沙箱纯属加延迟 - 需要模型在自然语言层面推理中间结果
:如果某一步的意义就是让模型注意到文档里某个微妙之处并对话式回应,把它过滤掉反而坏事 - 没有现成沙箱基础设施
:起一套安全沙箱是真实运营成本 - 可审计性
:一个工具调用是干净、可记录的单一事件;而复盘一个生成脚本内部到底干了什么——尤其事后查事故时——是真正的调试难题
🧭 决策框架
🔄 现实是混合:大多数生产 Agent 两者都用
别被标题带偏——这不是一次定终身的架构决定,而是逐任务的判断。Anthropic 自己的建议是:先看你那个 Agent 真正的瓶颈(工具定义太多撑爆上下文?大中间结果污染上下文?参数错误?),再对症加功能,而不是第一天把所有能力都堆上。
一个写得好的 Agent 往往:简单单发查询用普通工具调用,一旦任务需要扇出、聚合或处理太大/太敏感而不宜放模型面前的数据,就切到代码执行。真正值得练的技能,不是一次性选个原语,而是逐任务看出当前工作在真正需要哪个。
笔者锐评
这篇把"为什么 Agent 会慢、会贵、会算错"讲得很实在——很多号称"智能体"的产品,问题恰恰出在最不起眼的动作原语选择上。作者那个"20 人差旅预算"的例子特别戳:几千个明细项全部灌进上下文只为求个和,既浪费 token 又容易让模型在中间值里打转出错。
对国内做 Agent 落地的团队,最实用的是那个决策框架。很多场景(尤其处理大量表格、行项目、财务数据)天然适合"代码执行聚合",但团队往往默认只做工具调用,既因为习惯也因为沙箱基建没跟上。先把"哪些任务只需最终数字、无需模型读中间数据"划出来,再决定要不要为它们搭沙箱,是性价比最高的切入。
求点赞 👍 求关注 ❤️ 求收藏 ⭐️你的支持是我更新的最大动力!