ARTICLE · 1084744
AI算力狂飙撞上物理死穴!硅光独角兽公开行业隐疾:几万美元的芯片全被激光器难哭
在AI大模型吞噬算力的疯狂军备竞赛中,全球半导体巨头们正在集体撞上一堵看不见的物理高墙。
当英伟达、博通、Meta等巨头把算力芯片堆到极致时,一个让整个行业颇感棘手的尴尬事实浮出水面:铜线快被榨干了,光互连成了唯一的救命稻草;但整套先进的光学互连系统,竟然被一个指甲盖大小的元件卡住了脖子。
这个元件,就是激光器
2026年9月下旬,估值数十亿美元的光子计算与硅光互连独角兽 Lightmatter 在社交平台抛出重磅预告:其高级首席激光架构师 Jessie Rosenberg 将在波士顿举办的国际微电子与封装学会(IMAPS)硅光峰会上发表演讲。
演讲的题目直击行业痛点,《从 TOSA 到晶圆厂:重新思考共封装光学中的激光器集成》。
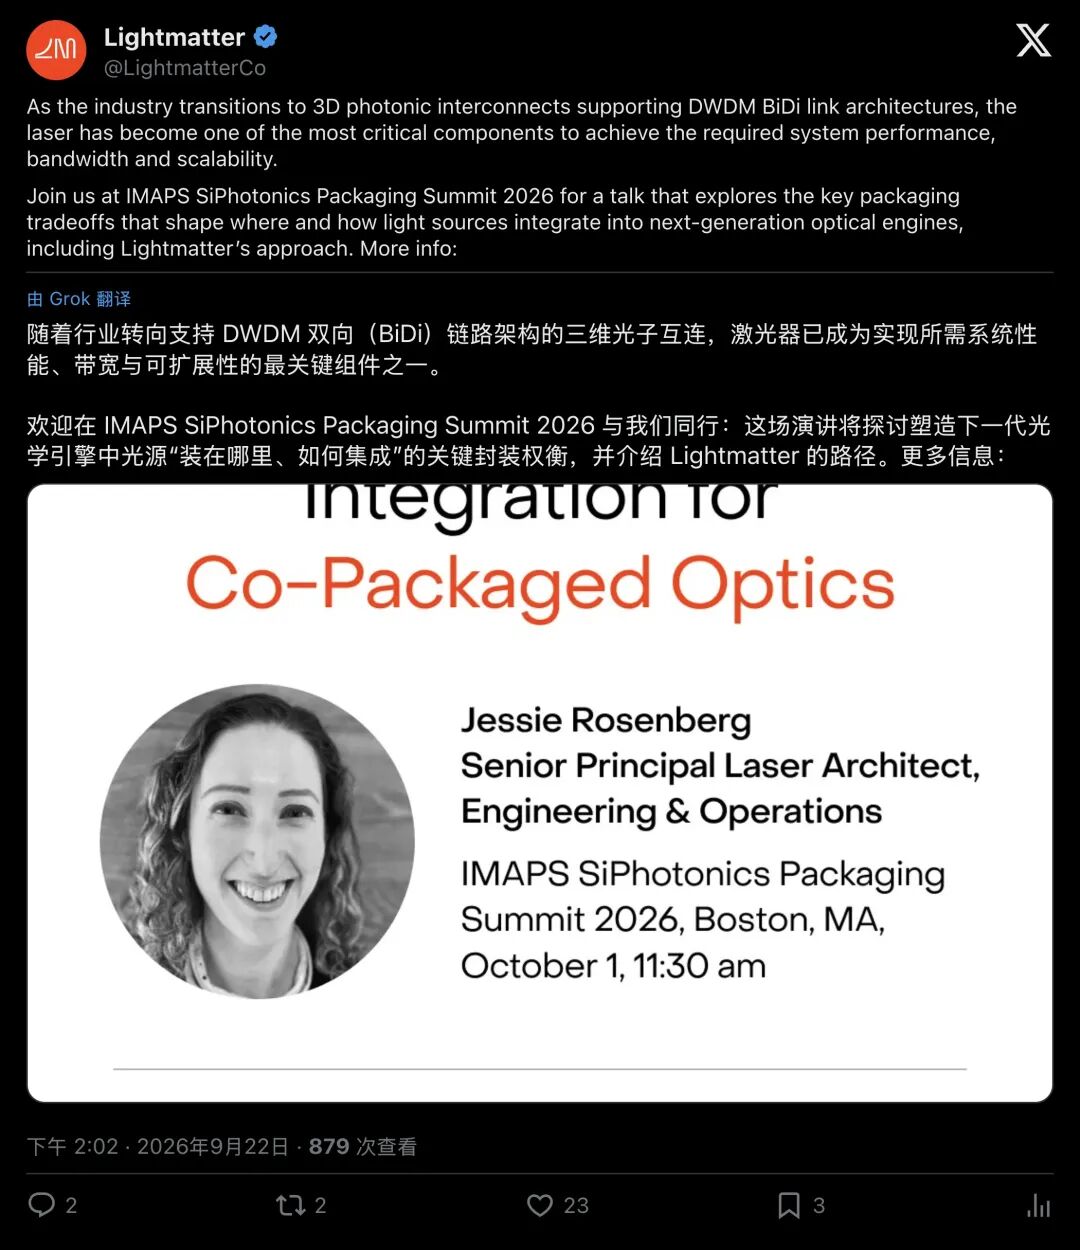
▲ Lightmatter在X平台发布官方预告:激光器已成为光互连中至关重要也最难安放的瓶颈
官方摘要写得毫无保留:随着硅光技术走向共封装光学(CPO)与三维光子中介层,激光器已经成为现代算力系统里最难“安放”的组件。
这绝非单一厂商的公关发声,它直击关乎万亿AI基础设施生死的底层物理围猎。
01冰与火之歌:芯片界最尴尬的“联姻”
要理解为什么激光器会让全行业的顶尖工程师抓狂,必须先看清一个残酷的半导体物理现实。
人类制造现代计算芯片的基石是硅(Silicon)。硅是电子世界的绝对王者,做逻辑计算、做晶体管、做波导路由,无所不能。
但上帝在造物时给硅留下了一个致命短板:它属于“间接带隙半导体”,天生是个哑巴,根本无法高效发光。
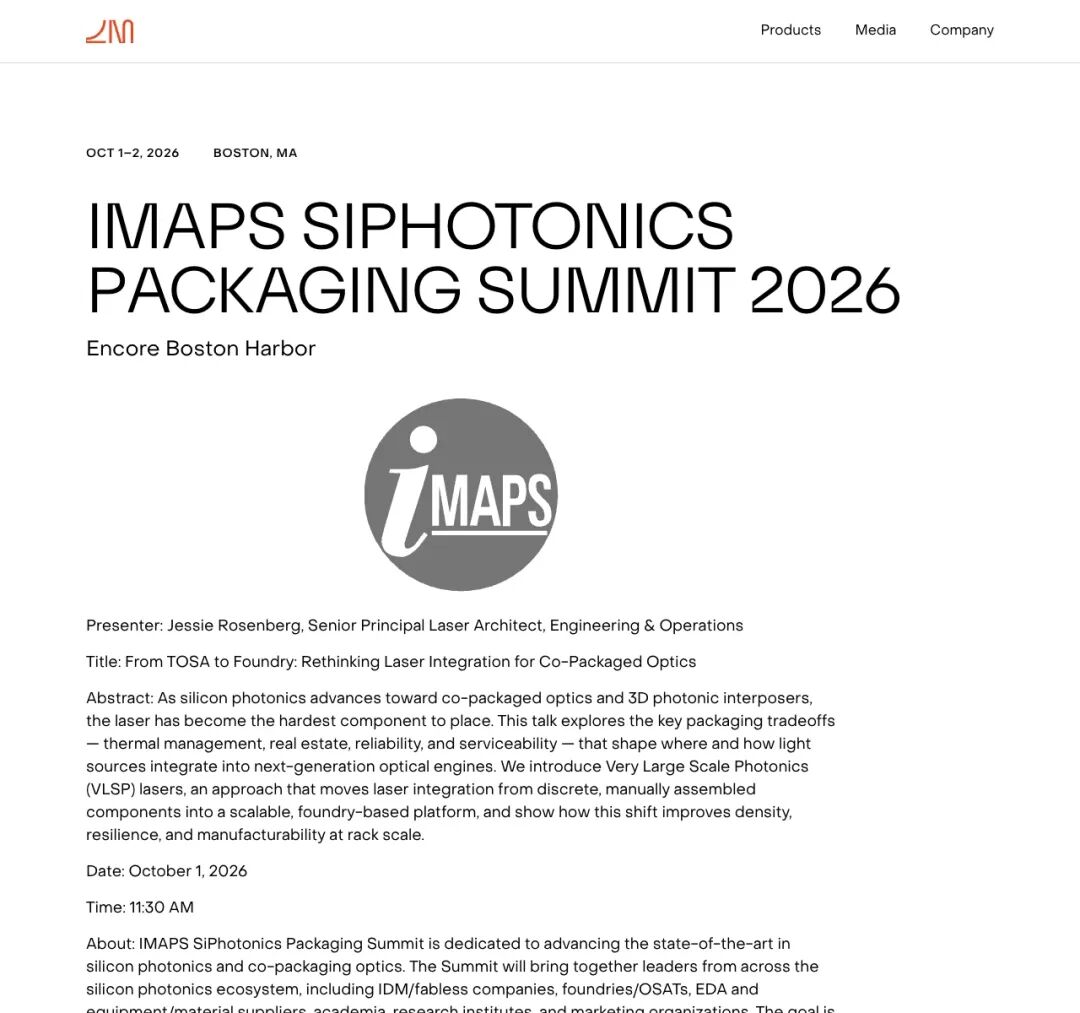
▲ 官方活动页面直言:随着走向3D光子互连,光源的封装权衡成为行业最大难题
在半导体材料中,磷化铟(InP)这类 III–V 族化合物天生擅长“无中生有制造光”。
于是,在AI数据中心里,一个极其荒诞的“冰与火之歌”上演了:
一边是负责核心计算的 GPU 或交换机 ASIC。为了追求极致算力,这些芯片功耗动辄几百瓦甚至上千瓦,表面烫得像一块滚烫的电烙铁;
另一边是负责发光的磷化铟激光器这种材料生性娇贵,对温度敏感到了极点,结温每升高一点,发光效率断崖式下跌,波长剧烈漂移,器件寿命更是指数级暴跌。
如果你把激光器紧紧贴在 GPU 身边(所谓的片上集成),无异于把一支娇贵的雪糕直接扔进了烧烤炉。
芯片还没算完几轮矩阵,激光器早就被活活烤死。
02算力机房的破产算术:坏一颗激光器,整块GPU陪葬?
物理层面的“高温烤死”只是第一道关卡,商业运维中还潜藏着高昂的“破产陷阱”。
在超大规模数据中心的海量运营数据中,激光器向来是光电系统中失效率排名前三的“常客”。
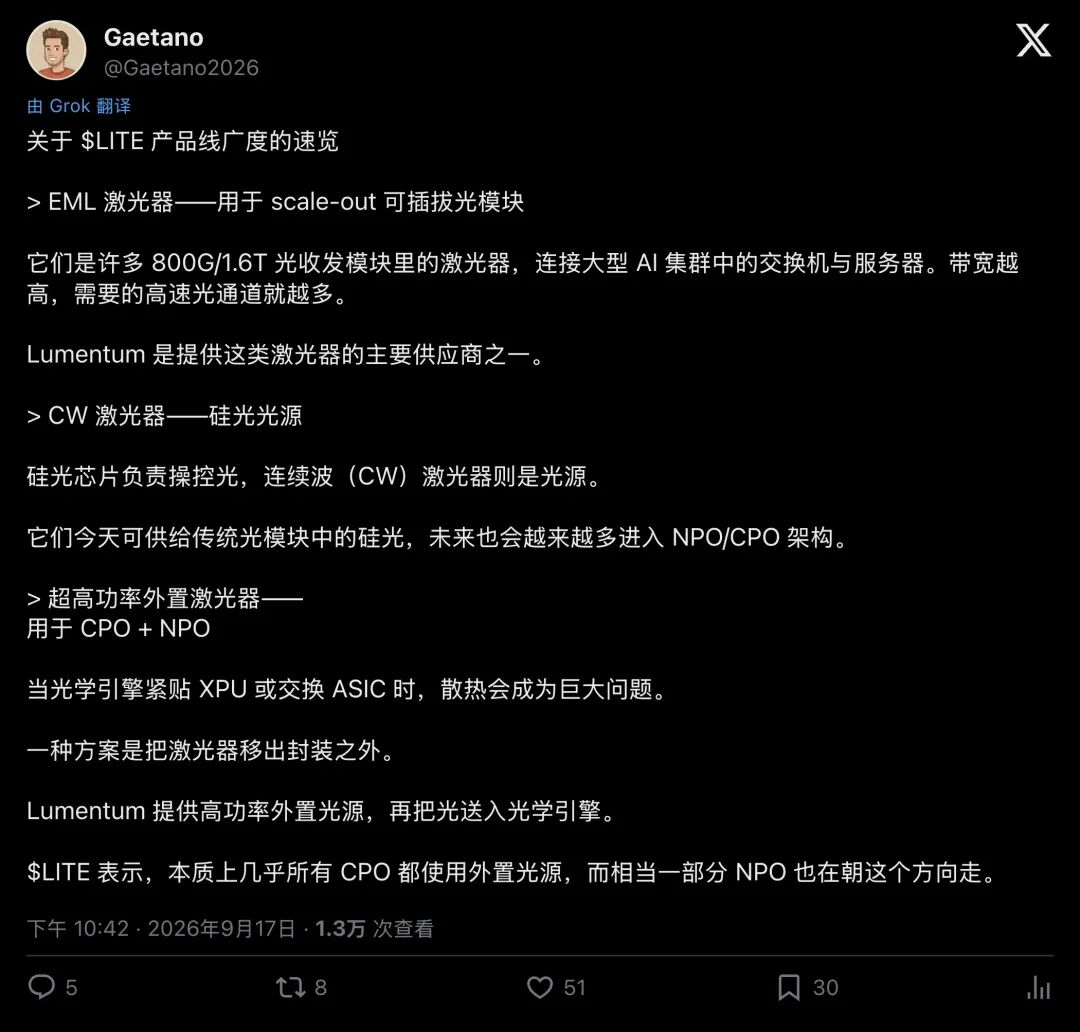
▲ 产业分析指出:XPU热量过高,将激光器移出核心发热区是业界的共同选择
试想一下:在共封装光学(CPO)时代,如果为了缩短光路,工程师把激光器硬生生和昂贵的 GPU、高带宽内存(HBM)死死封装在一起,会发生什么?
一旦某颗微小的激光二极管因老化而熄灭,整块价值数万美元的顶级算力模块就必须整包报废!
没有任何一家数据中心运营商能够承受这种恐怖的维护成本。
于是,整个行业不得不妥协,退守到一条看似折中却极其务实的工程路线:外置激光源(ELS / ELSFP)。
所谓外置,就是把发热的激光器从 ASIC 旁边的火炉里拉出来,做成一个个独立的可插拔模块,安装在机箱前面板上。
平时由前面板吹冷风降温,再通过光纤把持续恒定的连续波(CW)激光喂给内部的硅光引擎去进行数据调制。
一旦激光器坏了,运维工程师只需在机架前轻轻一拔,换个新模块就行,完全伤不到核心算力芯片分毫。
03“激光农场”的灾难:从手工作坊走向晶圆代工
然而,按下葫芦浮起瓢外置激光虽然保住了芯片的命,却在机房里制造了另一场灾难,“激光农场”(Laser Farms)。
随着AI模型参数爆炸,交换机带宽一路冲向 51.2T、102.4T 乃至更高。要喂饱这些吞吐海量数据的光引擎,机箱前面板需要插满密密麻麻的外置激光模块。
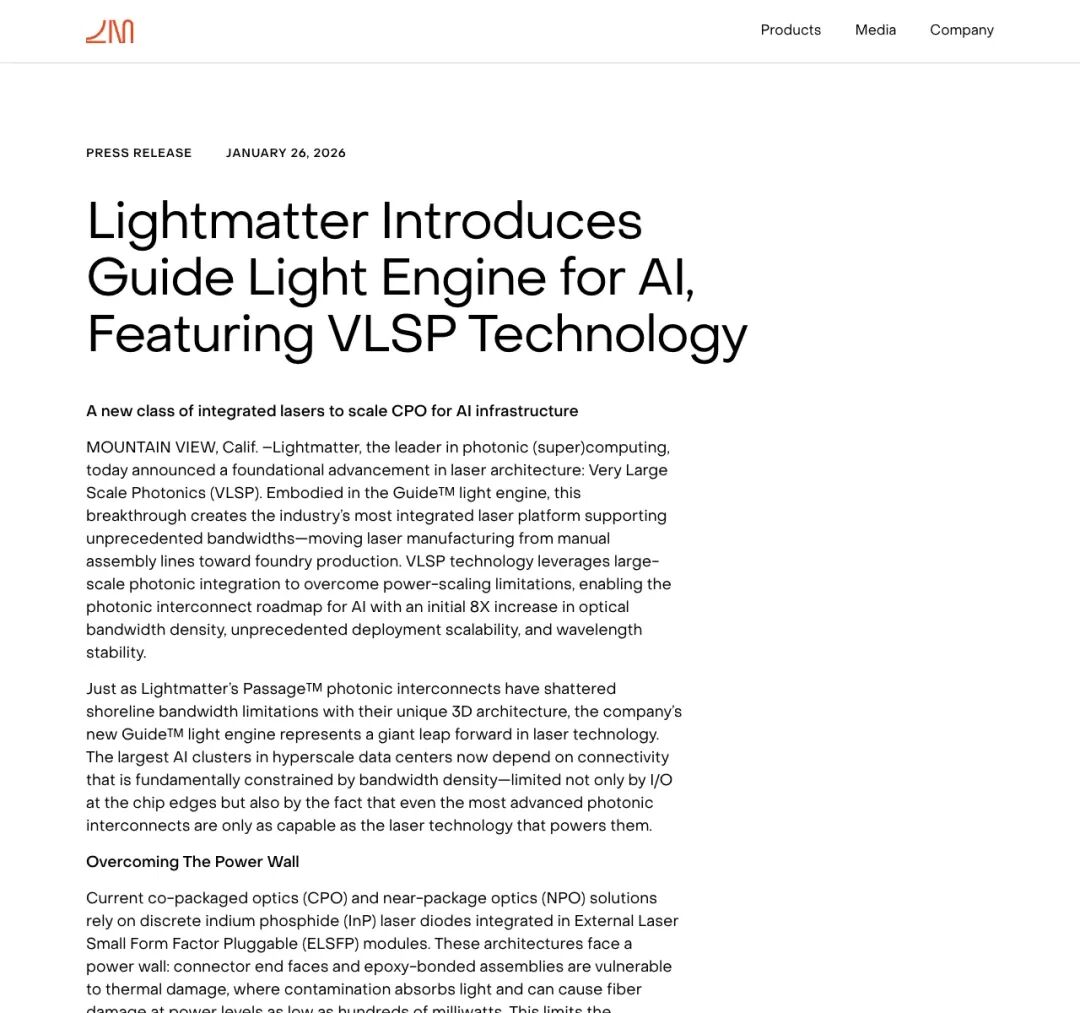
▲ Lightmatter发布Guide光引擎与VLSP技术:将激光从手动装配线推进到晶圆厂规模化量产
Lightmatter 在发布其 Guide 光引擎时算了一笔令人窒息的账:
如果用传统的离散 ELSFP 模块去支撑一个 100 Tbps 级别的交换系统,前面板需要插大约 18 个模块,占据 4RU 的机架空间; 每一个模块内部,都充斥着传统光通信的“手工作坊”遗毒:人工或半自动对准的透镜、隔离器、微型贴片和环氧树脂胶水; 在极高光功率下,胶水端面极易吸热受损,成百上千根外置光纤接头更是把故障点数量推向了失控边缘。
这就是 Jessie Rosenberg 演讲标题中 “From TOSA to Foundry”(从发射光组件到代工厂) 的历史性转折点。
过去的激光器制造,像老钟表匠坐在工位上用镊子对光路;而AI时代需要的,是像造半导体芯片一样,在晶圆厂里用光刻机把激光阵列、波长校准和控制电路一次性流片出来!
Lightmatter 主推的 VLSP(超大规模光子学) 技术,正是试图用软件定义的多波长光引擎,把原本需要占用 4RU 机架空间的庞大“激光农场”,硬生生压缩进 1RU 的单薄机箱中。
04巨头结盟:DWDM 与 BiDi 撕开新战局
在这场围绕光与热的围剿战中,全球算力霸主们早已悄悄结盟。
2026年3月,由 NVIDIA、Meta、Microsoft、OpenAI、Broadcom、AMD 等巨头共同主导的 OCI(Optical Compute Interconnect)MSA 发布了 v1.0 接口规范。
这篇规范奠定了未来AI互连的两大铁律:DWDM(密集波分复用) 与 BiDi(双向单纤传输)。
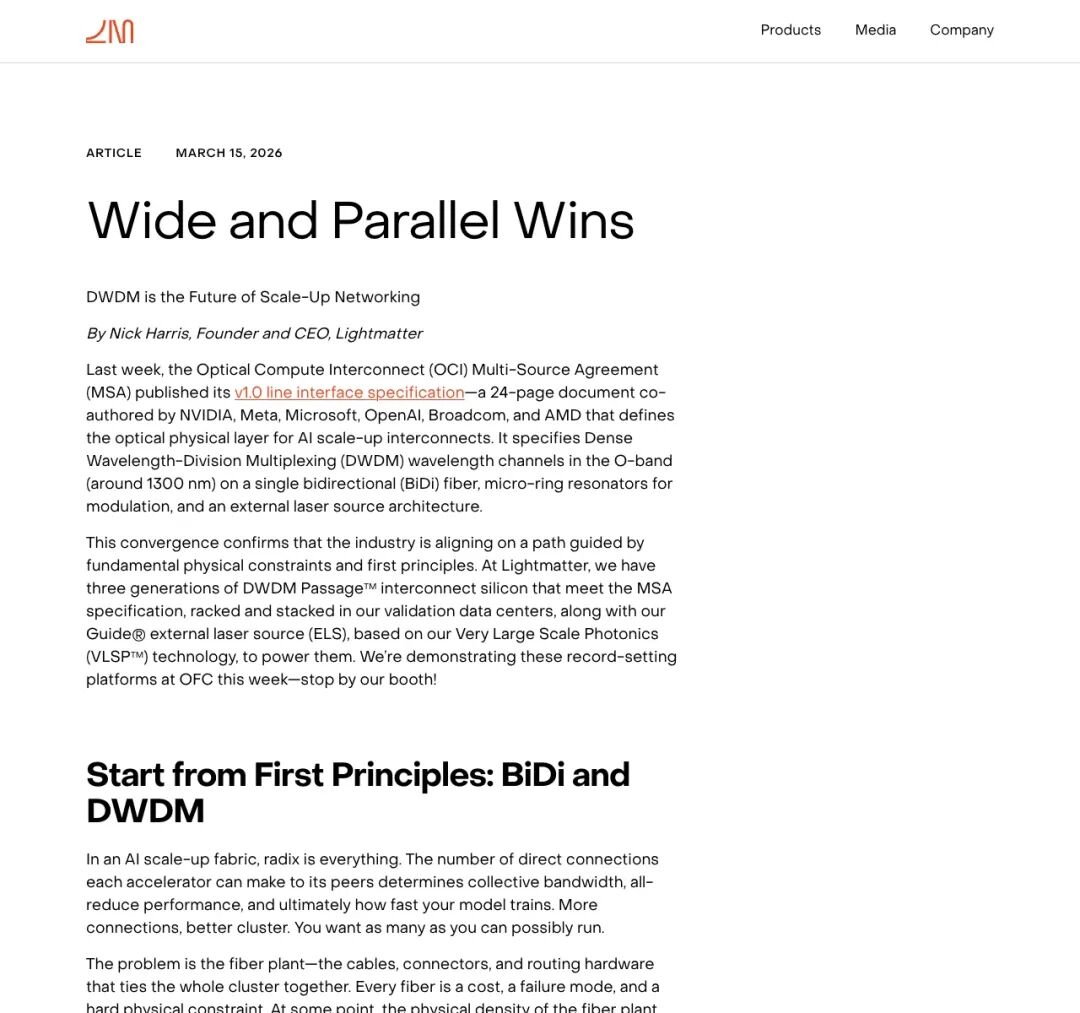
▲ Lightmatter CEO Nick Harris 发文《Wide and Parallel Wins》,论证为何密集波分与多通道并行是AI scale-up的必由之路
Lightmatter 创始人兼 CEO Nick Harris 在其长文《Wide and Parallel Wins》中给出了直击本质的解释:
在数千颗加速器互联的超算织物(Fabric)里,光纤数量和连接器体积是物理硬约束。
- DWDM(密集波分复用)
:就像在一条高速公路上划出16条甚至更多车道,用不同颜色的光同时跑数据; - BiDi(双向传输)
:把原本“一根发射、一根接收”的双纤结构,合并到同一根光纤内对向传输,直接把布线数量砍掉整整一半!
就在9月中旬,Lightmatter 宣布加入 Open CPX 联盟,并发布了 Passage L20 CPX 近封装光学引擎。
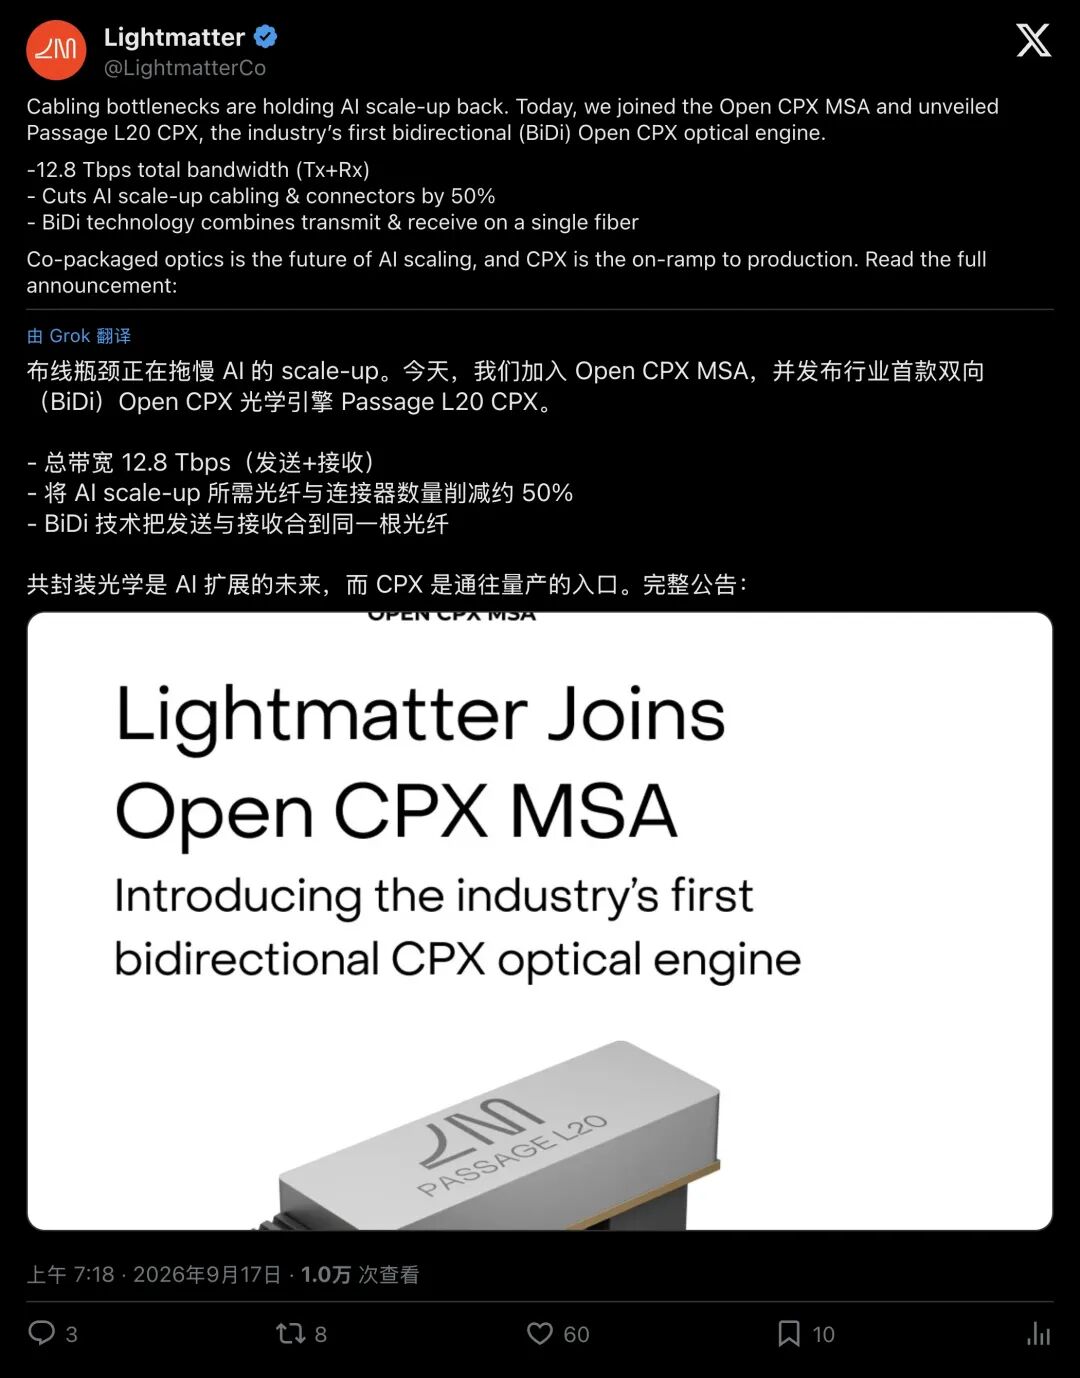
▲ Lightmatter推出业界首款双向CPX光学引擎,宣布可将AI集群的光纤与连接器数量减半
在512颗 GPU 规模的计算单元(Pod)中,这种架构可以直接省下超过 200 英里(约320公里)的光纤,减少约 1.6 万个连接器。
与此同时,传统的激光巨头们也在疯狂展示肌肉。在欧洲光通信博览会(ECOC 2026)上,光学老牌劲旅 Lumentum 针锋相对地掏出了面向 OCI 标准的 八波长 DWDM ELSFP 激光模块。
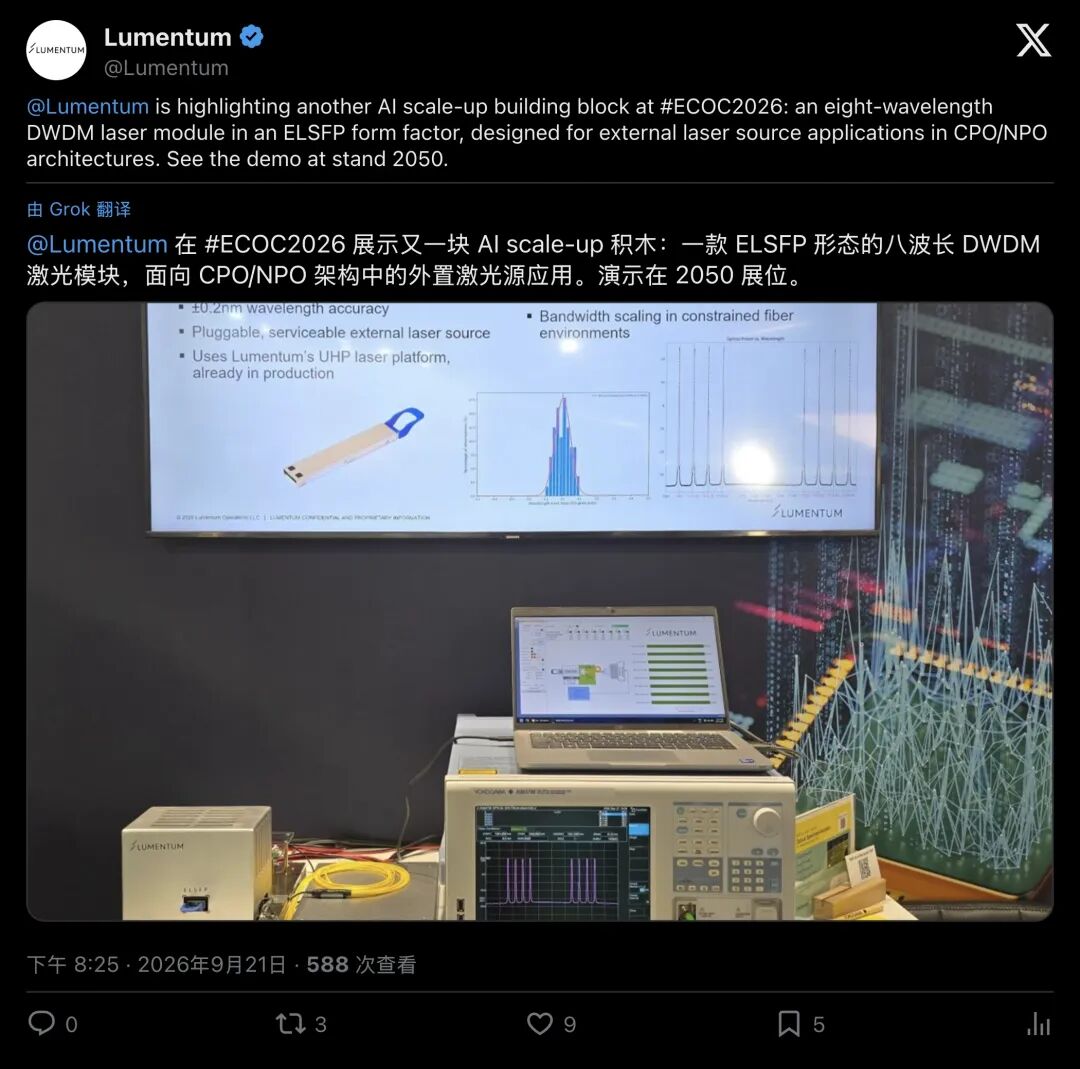
▲ Lumentum 展示符合 OCI 标准的八波长超高功率外置激光源,每波长出纤功率高达 250 mW
单模块提供高达 24 dBm 的超高出纤功率,波长精度锁死在 ±0.2 nm 以内,整个产业链都在疯狂给这套“外置多波长光源”的战车加码。
05终局:谁驯服了光,谁就拿到了下一个时代的钥匙
回看半导体发展的七十年,每一次计算范式的飞跃,除了算法与架构演进,全伴随着一场场极其繁琐、极其艰难的物理工程妥协。
从风冷到液冷,从铜线到硅光,人类为了搬运比特,正在把物理学底层的边角料压榨到极致。
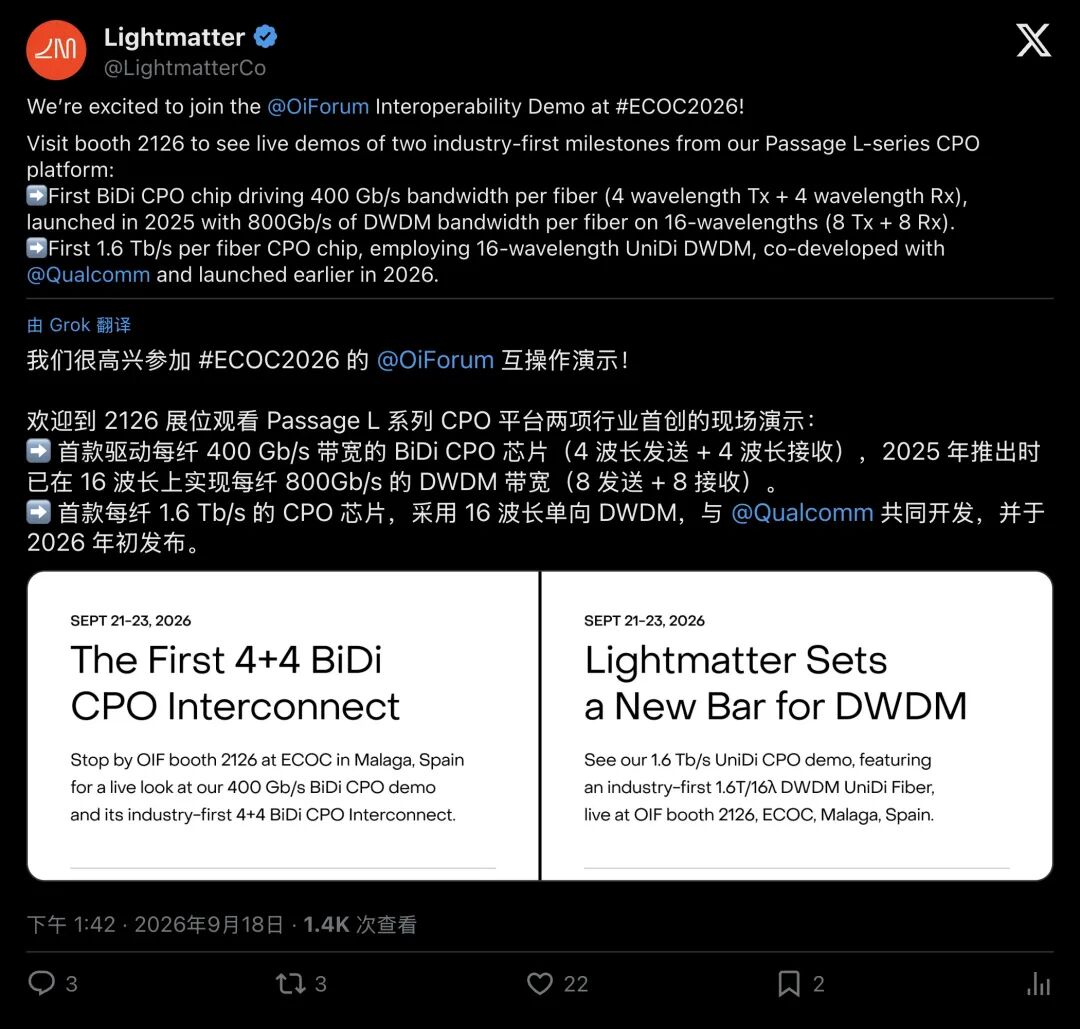
▲ 展会现场密集展示的16波长单纤高速传输芯片,印证了多波长高密度集成的不可逆趋势
激光器究竟该放在哪里?
贴在核心上,它会被高温活活烧死; 扔在机箱外,它会用密密麻麻的接头和线缆逼疯运维; 维持手工作坊式生产,它会被百万卡集群的恐怖需求瞬间挤兑到断货。
把娇贵的发光管芯,改造成可软件标定、可在晶圆厂规模化量产、可弹性插拔维护的“标准化光子引擎”,这正是从 Lightmatter 到英伟达、博通等所有玩家拼死突围的方向。
AI的算力狂飙还在继续但这一次,决定算力扩展上限的关键,已延伸到了芯片晶体管之外,那一束既暴烈又脆弱、不知该安放在何处的微光。