ARTICLE · 1086690
AI 更强了,我却换回了日常工具和模型?
适合:正在使用/选择AI 工具的个人或团队 |预计阅读 3 分钟
欢迎点击上方“VAI演武场”关注我。
最近忙着转变,新的工具、新的环境、新的赛道。
周更变成了月更,emmm……
虽然早有认知和预期。
不仅不同的大模型有着自己独特的个性和擅长之处。
AI 工具更是百花齐放,各有所长。
这次机缘巧合,工作伙伴切换成了 Workbuddy。
第一天就很快认识到:以前在 Codex 里觉得顺手的事,换个工具还真不一定顺手。
我们彼此需要快速磨合和适应。
实测记录
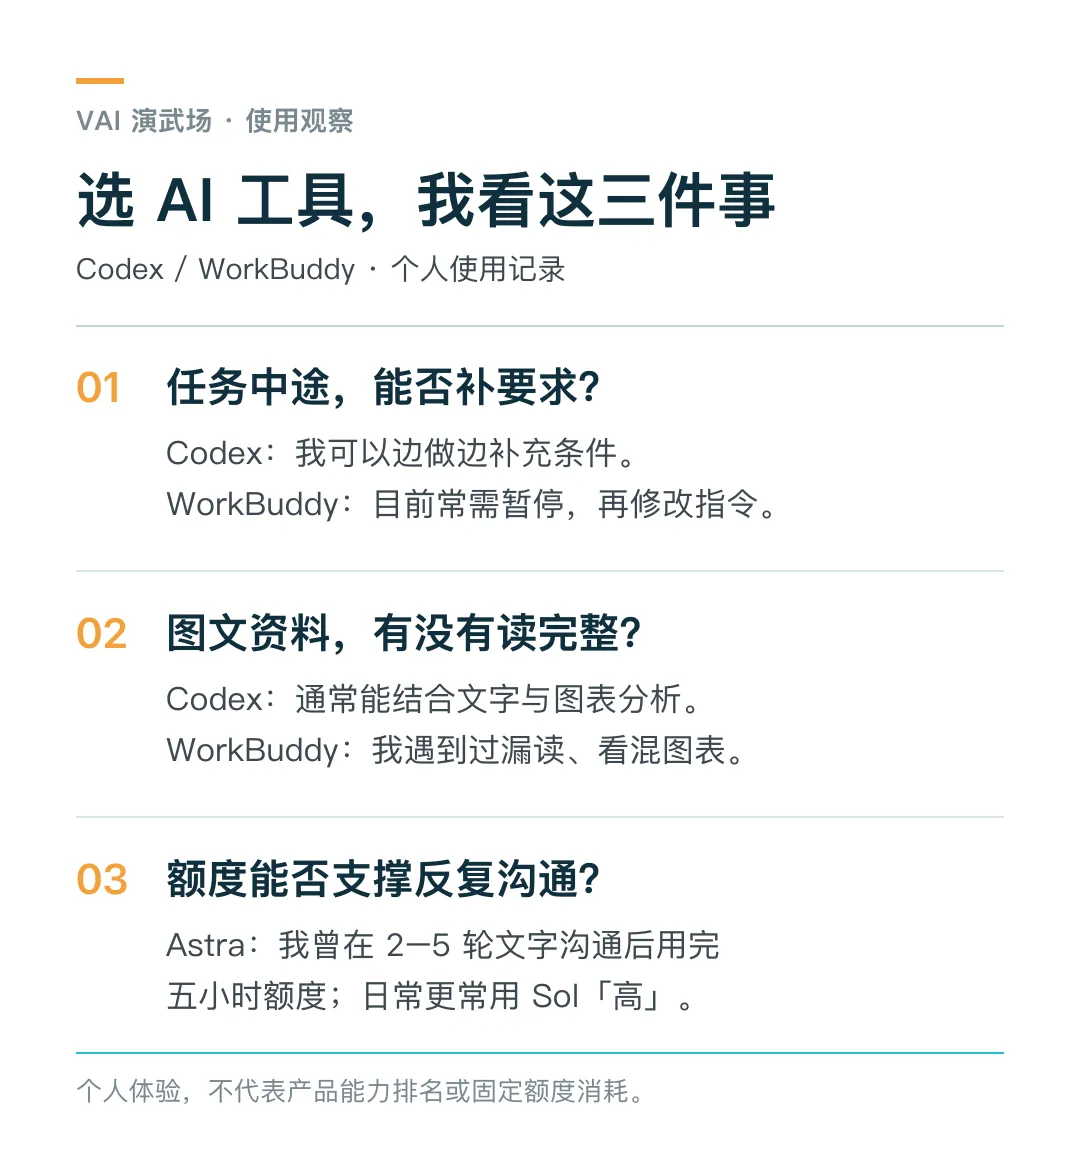
01 下需求的习惯要调整了
我习惯了开着语音、直接口述任务指令给到 Codex。
想到哪里说哪里,随时在过程中增补需求。即使有口头禅或者部分发音的个人习惯,Codex 也已经习惯了我的碎碎念。
目前用 WorkBuddy 时,我常要先暂停,再回头修改任务指令。语音一是不方便,二是它识别的不太好,每次要单独修正。需求本来就会边做边变,这一步是否顺畅,对效率的影响还是明显的。
不知道其他人是否有跟我类似的情况?
02 图文资料的解读差异有点大
分析下载的网页文档时,Codex 通常能把文字和图表放在一起看。
图文混排的.md 文档读起来也很顺利。
近几天发现,WorkBuddy 有时只读了文字,或者把图表信息看混。
当然,这只是我近几天的使用状况,不代表 WorkBuddy 一概读不了图表。
用的是 DeepSeek v4 pro 模型和 Kimi 3,还没太试GLM。先从熟悉的开始。
Workbuddy的官方说明也提到,文件读取效果可能与所选模型、插件和 Skill 有关。
因此这里还待继续观察。
03 Token 消耗更外显
相较许多工具来说,Workbuddy Token 消耗情况更外显,让人清楚地知道每个任务 token 燃烧状况。
这点十分良心了。
这里不得不吐槽Codex/GPT 一下。
这小一年以来,在 token 重置和消耗上主打一个任性。
重置规则改了又改,重置时间任性的很。
最近 GPT6更新后,对比完 Astra 的烧钱速度,抠抠嗦嗦的我竟然把 Sol high 设置成了默认模型。
毕竟曾在两三回合纯文字沟通内用完 Plus 的五小时额度。
04 最后说说工具和模型选择
从娱乐往严谨场景说,陆陆续续用过这些工具:
(实际更多,好多名字已经消失在时间里)
随手拍一拍乐一乐,用过豆包。
做音乐,用过 QQ 音乐、Vemus 等等。
做图做视频,用过即梦、liblib、libtv、seko等等。
查文献资料,用过秘塔。
看中文逻辑,用Kimi。
看严谨报告,用DeepSeek。
做市调,爱用 Gemini。
作为工作伙伴,爱用 Codex。
……
工具百花齐放。
不变的是我那些个.md文档和 Obsidian。
接下来说模型,先只紧着最近嗖嗖烧 token 的 GPT来说。
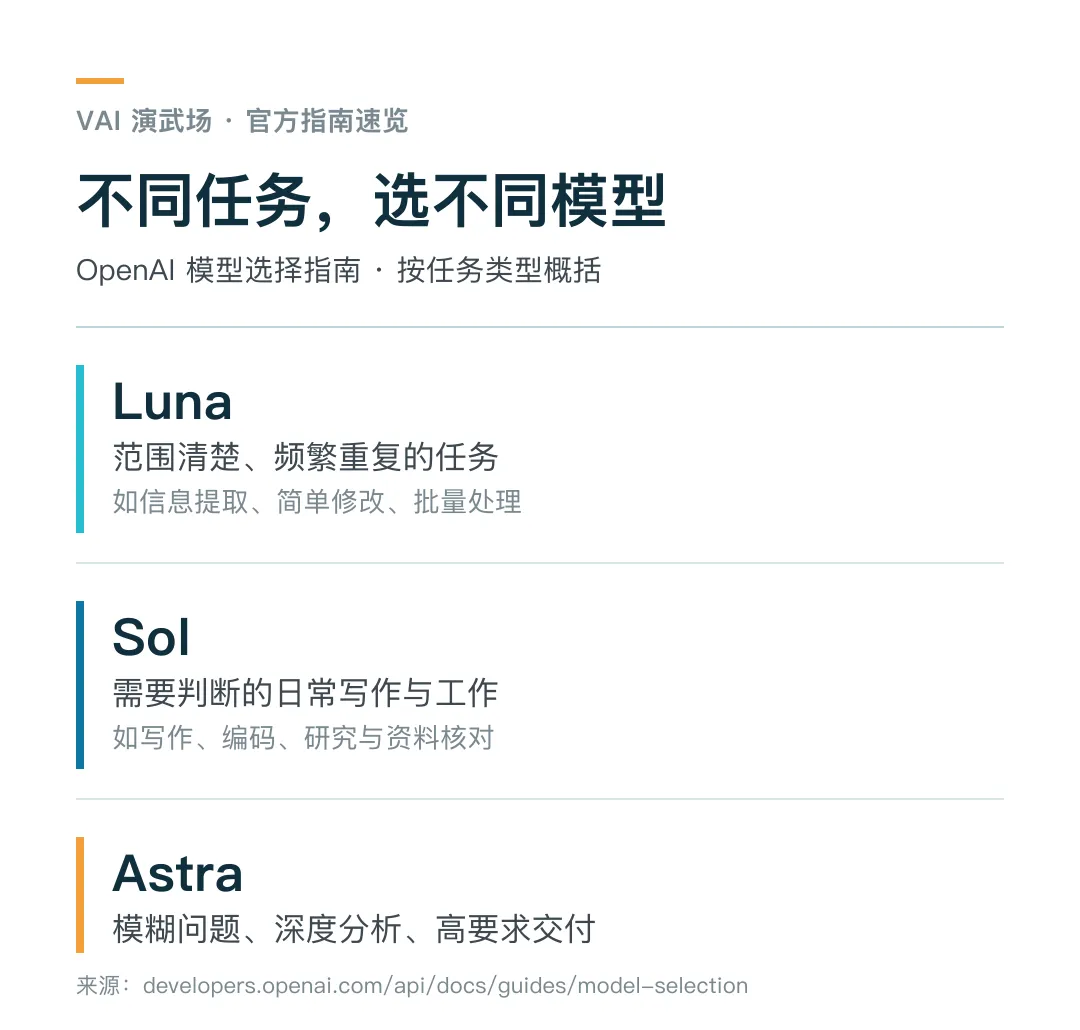
范围清楚、频繁重复的任务 用 Luna;
需要判断的日常工作 用 Sol;
模糊、复杂且要求高的任务 用 Astra。
通常不用 Astra。
简言之,模型不是越高级越好,工具不是越花哨越好。
多试一试才知道什么是适合的。
继续演练
中秋快乐
《 点这里,领一枚属于你的月亮签 → 》