ARTICLE · 1087437
一篇论文如何改变了 AI 的发展格局
从 RNN 到 Transformer:一篇论文如何改变了 AI 的发展格局
一篇 11 页的论文,八位研究员,一次彻底的架构颠覆。2017 年,Transformer 的诞生重写了 AI 的未来——从 ChatGPT 到 DALL·E,从 Midjourney 到 Gemini,当代 AI 的一切繁荣,都始于这场注意力机制的革命。
一、深度学习时代的困局
人工智能的发展历经数次浪潮。从 1956 年达特茅斯会议正式确立"人工智能"这一概念,到 1997 年 IBM 深蓝击败国际象棋世界冠军卡斯帕罗夫,再到 2006 年杰弗里·辛顿提出深度信念网络开启深度学习时代,AI 走过了漫长而曲折的道路。
然而,在自然语言处理领域,一个根本性的技术瓶颈始终存在。2017 年之前,机器翻译和语言理解任务的主流架构是**循环神经网络(RNN)**及其变体 LSTM 和 GRU。这类模型面临三重困境:
谷歌大脑的研究员们深刻感受到了这些限制。Illia Polosukhin 在后来回忆时表示,如果要构建能真正处理海量文档的模型,当时的 RNN 远远无法满足需求。
正是在这种技术困局中,一场革命悄然酝酿。
二、八位研究员与一个革命性构想
2017 年,谷歌的八位研究人员——Ashish Vaswani、Noam Shazeer、Niki Parmar、Jakob Uszkoreit、Llion Jones、Aidan Gomez、Lukasz Kaiser 和 Illia Polosukhin——联合发表了一篇题为《Attention Is All You Need》的论文。这篇论文提出了一个全新的深度学习架构:Transformer。
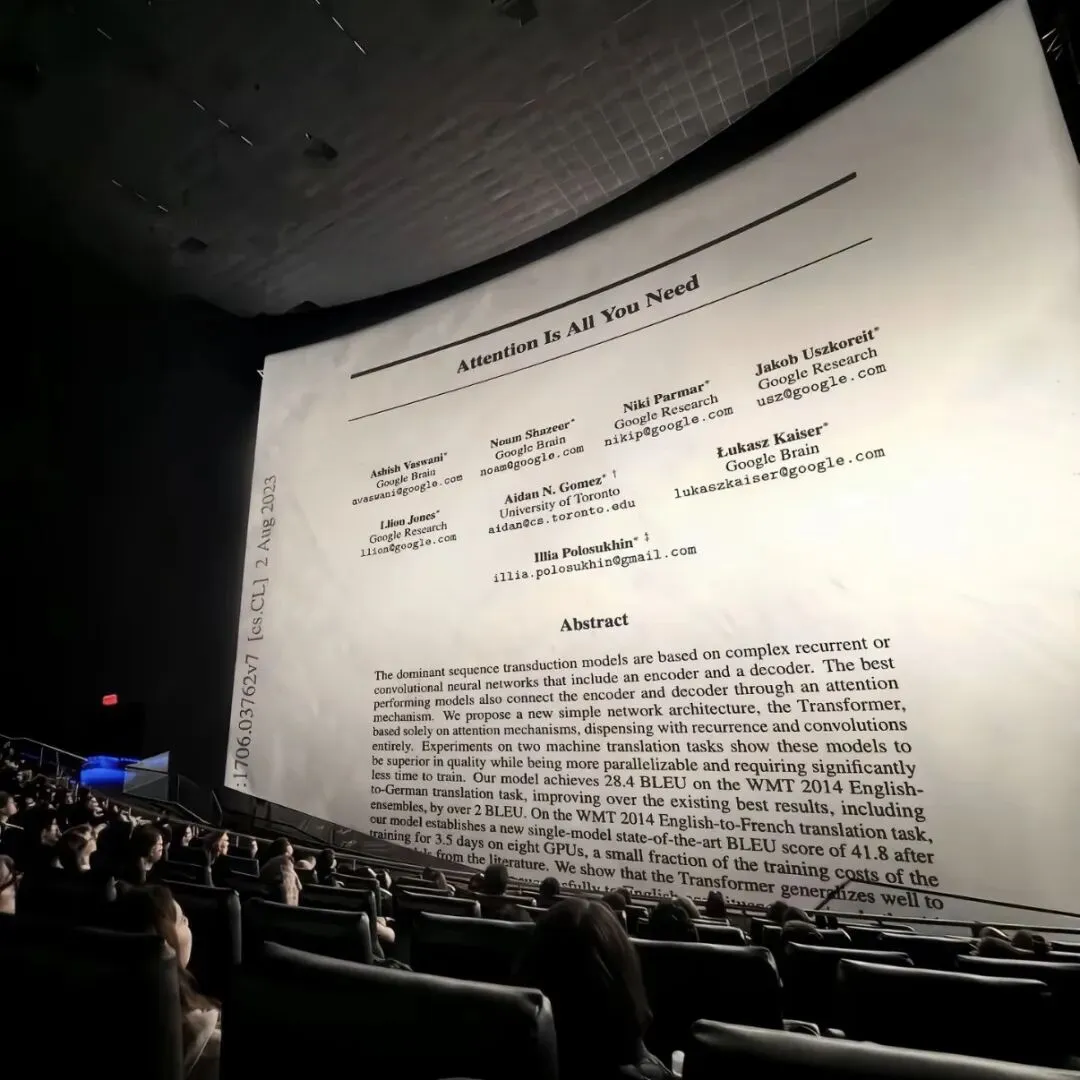
值得注意的是,八位作者做出了一个在当时颇为大胆的决定:他们在论文脚注中明确标注"各位作者的贡献同等重要,名次排列完全随机"。这在学术圈内并不常见,因为作者排序向来是敏感而微妙的问题。
论文的核心思想可以用一句话概括:
完全抛弃 RNN 和 CNN,仅用自注意力机制构建序列到序列模型。
这一构想的大胆程度,在当时的学术界引起了巨大的震动。Llion Jones 回忆道:
团队当时在做"切除实验",尝试扔掉模型的各种组件,结果令他们自己都惊讶——即便扔掉所有卷积层,模型反而变得更好。
Transformer 的命名本身也颇具深意。Jakob Uszkoreit 解释说,这个模型"改变了数据生产模式",它实际上转换了整个信号。这个看似简单的名字,后来成为 AI 领域最炙手可热的关键词。
三、技术突破:注意力机制的革命
Transformer 架构的精妙之处在于其核心组件——自注意力机制。用公式表达即:
Attention(Q, K, V) = softmax(QK^T / √d_k) · V其中 Q 代表 Query(我在找什么),K 代表 Key(我有什么标签),V 代表 Value(我的实际内容)。直觉上理解,每个词都会对其他所有词做一次"相关性投票",投票结果决定这个词应该关注谁。
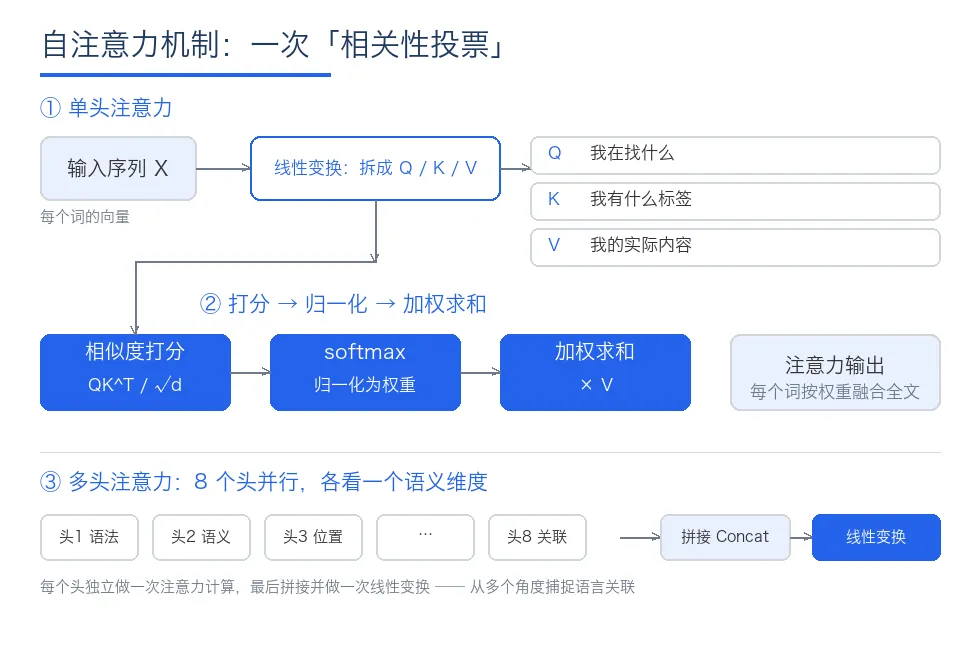
Transformer 还引入了多头注意力机制——不是做一次注意力计算,而是同时做 8 次,每个"头"关注不同的语义维度:
最后将 8 个头的结果拼接起来。这种设计让模型能够从多个角度捕捉语言中的复杂关联。
由于注意力机制本身是并行计算的,无法感知词的顺序,研究人员还引入了位置编码,通过正弦和余弦函数为每个位置注入位置信息。
在硬件层面,Transformer 的训练效率令人惊叹。论文报告,模型在一台配备 8 块 NVIDIA P100 GPU 的机器上训练,基础模型每步训练仅需约 0.4 秒,完整训练仅用 3.5 天。
而此前的 SOTA 模型 GNMT 训练需要约 1.1×10²¹ FLOPs,是 Transformer 的近 48 倍,却只达到了 41.16 BLEU 分数。Transformer 在翻译质量上超越了所有先前模型,同时训练速度提升了一个数量级。
四、从论文到产业革命
《Attention Is All You Need》发表在 2017 年的 NeurIPS 会议上。此后,这篇论文的影响力以指数级速度增长。
截至 2025 年 6 月,论文被引次数已超过 18 万次;到 2026 年,这一数字突破了 25 万次,使其跻身 21 世纪被引用最多的十篇论文之列。
仅论文第一作者 Ashish Vaswani 个人的 Google Scholar 总引用量就达到约 29 万次,h 指数为 56。
Transformer 架构的影响力迅速从学术圈蔓延到产业界。以下是大模型参数规模的演进历程:
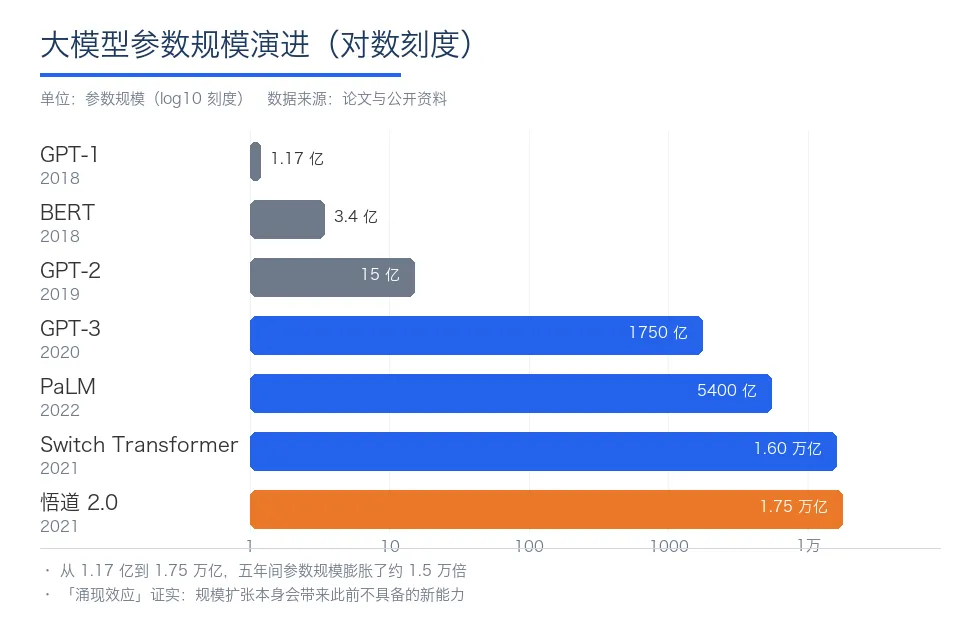
2018 年,谷歌发布基于 Transformer 的 BERT 模型,在 11 个 NLP 任务中取得了最优结果。同年,OpenAI 推出 GPT-1。此后,参数规模的膨胀速度令人瞠目。
大模型的"涌现效应"——通过扩大参数规模获得此前不具备的新能力——被后续研究进一步证实,为大模型的持续扩张提供了理论依据。
五、深远影响与未竟之问
Transformer 的影响远不止于 NLP 领域。正如辛顿所评价的那样:
若无 Transformer,今日之成就不复存在。
从 ChatGPT 到 DALL·E,从 Midjourney 到 Gemini,几乎所有当代 AI 产品的底层架构都建立在 Transformer 之上。
在硬件产业层面,Transformer 与 GPU 形成了"天作之合"。Transformer 的并行计算特性完美契合了 GPU 的架构优势,使其成为深度学习的主流训练平台,英伟达在后续的大模型时代获得了压倒性的生态优势。英伟达甚至在 Hopper 架构中专门引入了针对 Transformer 的硬件优化引擎。
然而,这场技术革命的代价也在逐渐显现:
更大的隐忧在于,Transformer 的八位作者在论文发表后全部离开了谷歌。他们中有的创办了 Character.AI、Cohere、Essential AI 等明星创业公司,有的加入了 OpenAI。Noam Shazeer 在 2026 年宣布加盟 OpenAI,成为最后一位离开谷歌的核心作者。
这一"人才流失"现象折射出大公司创新机制的深层困境——谷歌虽然孵化出了 Transformer,却未能充分释放其潜能,反而由 OpenAI 等新兴企业率先将其转化为颠覆性产品。
结语
从 2017 年那篇只有 11 页的论文,到如今支撑起万亿参数大模型的基石,Transformer 的故事是 AI 时代最精彩的篇章之一。它证明了一个朴素的道理:
真正改变世界的技术突破,往往来自对既有范式的根本性颠覆——正如论文标题所宣告的那样,"注意力就是你所需要的一切"。
今天,Transformer 架构本身也面临着被超越的可能。有研究者认为,当前 AI 领域已陷入"架构僵化",下一个突破可能来自完全不同的方向。
但无论未来如何,2017 年那个春天,八位谷歌研究员在论文中播下的种子,已经长成了一棵改变世界的参天大树。