ARTICLE · 1088949
爱可可AI前沿推介(9.28)
LG - 机器学习 CV - 计算机视觉 CL - 计算与语言 AI - 人工智能
1、[CL] SlopShape:Identifying AI-Generated Commercial Web Content
2、[CL] HySparse2:Hybrid Sparse Attention with Two-Level KV Sharing
3、[CL] JEV vs. LLMs as Rubric Judges:Cheaper,Faster,and Wrong in the Same Places
4、[AI] Total Cost of Agency:Exact Attribution of Memory Injection Cost in Multi-Agent LLM Workflows
5、[AI] Working with Agentic 'Teammates':When a New Organizational Actor Collides with the Human Ecosystem of Work
摘要:识别商业网页中的AI生成垃圾内容 (Slop) 、基于双层 KV 共享的混合稀疏注意力机制、EV 对比LLM作为评分裁判更廉价更高效且在相同之处存在偏误、多智能体 LLM 工作流中记忆注入成本的精确归因、当新型组织主体冲击人类职场生态
1、[CL] SlopShape: Identifying AI-Generated Commercial Web Content
J Madler
[Sitefire]
SlopShape:识别商业网页中的AI生成垃圾内容 (Slop)
要点:
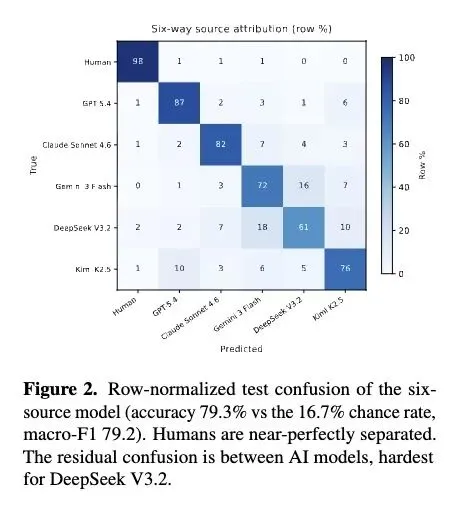
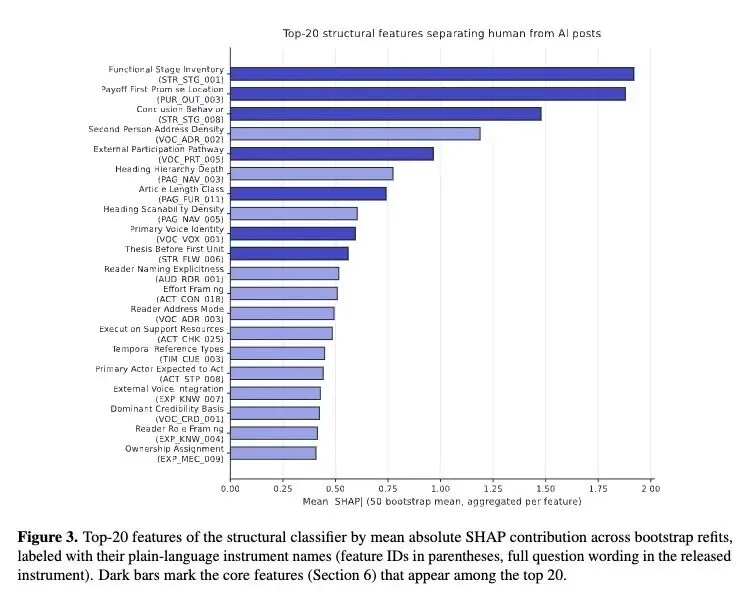
核心假设与视角转换: 尽管词级别(word-level)AI检测器在未经修改的文本上表现完美,但在面对对抗性重写或“AI文本人性化”工具时极度脆弱。本文转而寻找商业网络内容中的“结构签名”(信息排列顺序、证据使用方式、行文语气),完全剥离了对具体词汇的依赖。 反直觉发现(风格 vs. 结构): 推翻了作者最初的假设(即在强调品牌调性的商业写作中,“风格”应是最强烈的信号)。结果显示,在区分AI与人类时,纯结构特征的性能远远碾压风格特征(宏平均F1得分 98.0 vs. 88.1)。 对重写攻击的绝对免疫(高信息熵): 即使AI生成的文本被其原始模型逐段进行彻底的对抗性重写(替换了73%的逐字短语),结构检测器的性能依然纹丝不动(甚至微升至 98.1 F1)。这证明当词汇面目全非时,文章的“骨架”依然存在。 AI的“高度整洁与自我宣告式”模板: 发现所有AI模型在生成文章时共享一种高度可预测的结构:在标题中承诺阅读收益,在第一节之前就亮明论点并宣告文章结构,采用“社论解释者”的口吻,并在结尾明确重申论点。 结构的罕见性与AI同质化(反直觉): 人类撰写的文章在结构向量空间中占据着高度分散且统计学上极为罕见的区域。形成鲜明对比的是,五大前沿AI模型(GPT-4、Claude、Gemini、DeepSeek、Kimi)毫无结构多样性可言,全部拥挤在极其常见、高密度的同一个结构中心点上。 精准的模型溯源: 结构特征可以作为一种指纹,在5个候选AI模型中,能够以79.3%的准确率(随机概率仅为16.7%)准确识别出具体是哪家模型生成的该篇文章。其中,DeepSeek V3.2 的文章结构最接近人类,因此最难被归类。
主旨: 本文旨在解决现有词汇级AI生成文本检测器在面对改写工具时极易失效的问题。通过聚焦于B2B商业博客这一AI泛滥(SEO内容)的重灾区,论文探讨了是否可以通过更深层的“结构特征”(谋篇布局、信息流向、证据构建)而非表面词汇,来精准识别AI生成的内容(Slop)并溯源其生成的具体模型。
创新:
检测维度的升维: 摒弃了传统的词频、预测概率(Perplexity)或风格检测思路,创新性地将“叙事学”结构分析方法从小说领域跨域迁移,并针对商业文本深度定制。 基于LLM的自动化结构特征提取流水线: 构建了一个全自动的特征发现框架,自底向上从人类真实博客中提取了11个维度的商业模板架构,并通过大模型评审提炼出214个纯结构和风格特征,实现了对长文本“骨架”的量化编码。 引入“结构罕见度(Rarity)”指标: 创新性地在向量空间中测量文章结构的统计罕见度,将其作为区分人类“反套路”思想与AI“八股文”模式的代理指标。
贡献:
证实了AI生成的商业文本存在跨模型共享的“结构签名”,并证明了该签名能够完美抵御词汇级别的对抗性重写攻击。 深刻揭示了各大主流AI模型在内容生成上的“结构坍缩”现象(严重同质化),而人类内容的价值体现在其结构配置的稀缺性上。 实现了高精度的AI模型溯源( attribution ),证明不仅能查出AI,还能查出“哪家AI”。 完全开源了整套数据获取流水线、214个特征的验证工具、提示词、代码及分析汇总物,为行业提供了极具实用价值的GEO(生成式引擎优化)和对抗检测基准。
提升:
检测鲁棒性提升: 在面对模型自我重写攻击时,传统词级检测器(如DetectGPT等)通常会崩溃,而本文的结构分类器宏平均F1得分不仅未降,反而保持在 98.1 的极高水平。 溯源精度提升: 将六分类(1类人类+5类不同AI)的模型溯源准确率提升至79.3%,远超16.7%的随机基线,也优于前人类似研究的68.4%。 发现效率提升: 使用质量门控和可靠性过滤机制,用更少的核心特征(仅10个核心结构特征)就达到了93.5的F1检测分数,模型更加轻量且可解释性极强。
不足:
年代混淆因素(Confounding bias): 人类语料库必须采用ChatGPT发布(2022年)之前的网页快照,而AI生成文本是在2024/2026年生成的,这可能引入了时代行文习惯差异的干扰(尽管作者做了年份剥离测试来尽量弥补)。 对抗攻击类型的局限: 论文的“重写测试”仅限于生成模型对自身文本的改写,并未涵盖市面上更复杂的、专门针对AI特征进行混淆的第三方“人类化(Humanizer)”工具。 提示词信息不对称: 人类作者在撰写博客时拥有完整的商业上下文和目标,而AI在实验中仅依靠“逆向工程”提取出的极短提示词(Brief)进行生成,这种上下文的缺失可能人为放大了AI与人类在行文结构上的差异。
心得:
反直觉的“风格谬误”揭示了AI的真正软肋: 在高度强调“品牌调性”的商业营销语境中,我们本能地认为人类特有的“语气和风格”是AI最难模仿的。但实验结果无情地打脸:风格特征极易被AI复刻,真正让AI露馅的是“纯粹的逻辑结构”。这启发我们,AI目前掌握的只是语言的“皮肤”,而在跳出常规逻辑框架、进行反套路的“谋篇布局(骨架)”上,AI依然处于极度机械的阶段。 大模型对齐税(Alignment Tax)导致的“结构坍缩”: 最令人深思的是,无论是OpenAI、Google还是DeepSeek,底座完全不同的模型竟然在文章结构上呈现出令人毛骨悚然的同质化(全部挤在密集的中心点)。这说明当前业界普遍采用的RLHF(人类反馈强化学习)训练范式,实际上训练出了一种取悦审查者的“八股文”偏好(必须整洁、开头必总起、结尾必总结)。这种同质化是对人类创造力的警示。 内容版权与检测防御的“升维战”: 目前的AI洗稿工具已经能轻易抹除词汇级别的数字水印。本文启发了下一代的版权保护和内容安全策略:不要再去核对词频和句法,而应利用大模型将文本抽象为“逻辑流程图”和“证据拓扑图”。在思想的拓扑结构层面,洗稿工具将无所遁形,因为一旦改动结构,文章的商业功能就会被破坏。
一句话总结: 本文反直觉地证明,在充斥着AI生成的商业网络内容中,摒弃所有遣词造句的“纯结构特征”不仅能以98.0的F1分数精准识别AI内容并溯源其生成模型,更能完美免疫对抗性重写攻击;这一结果深刻揭示了前沿AI大模型深陷于同质化的“八股文”结构,而人类思维的不可替代性恰恰体现在谋篇布局的罕见与反套路之中。
Word-level detectors identify unedited AIgenerated text almost perfectly, but the literature documents their brittleness under rewording, and a word-level score neither characterizes a text nor identifies which AI model wrote it. We ask whether AI-generated text can be identified one level deeper, from structural signatures: how information is presented, in what order, with what evidence, and in what voice. We replicate StoryScope (Russell et al., 2026a), which showed such patterns for AI-generated fiction, on commercial content: 2,250 pre-ChatGPT human blog posts from 268 company domains against 11,250 AI mirrors from five frontier models. A 214-feature instrument, applied by an LLM and validated in a human gold-annotation session (humanhuman kappa 0.928, human-model 0.946), detects AI posts from its 187 structural features alone at 98.0 macro-F1 on held-out companies, unchanged (98.1) when every AI post is reworded by its own model. The signal characterizes and attributes: AI posts share a tidy, self-announcing shape, 79.3% are attributed to the correct source against a 16.7% chance rate, and human posts occupy rare structural configurations. All effects replicate StoryScope’s, consistent in direction and larger in magnitude. We release pipeline, instrument, prompts, code, and aggregate artifacts.
https://arxiv.org/abs/2609.15369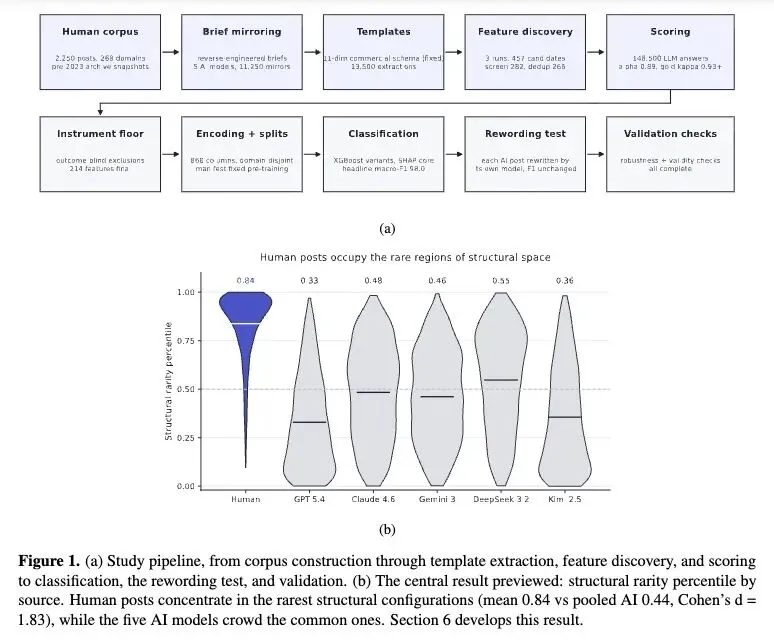
2、[CL] HySparse2: Hybrid Sparse Attention with Two-Level KV Sharing
J Wei, Y Gao, Q Zhang, S Chen…[LLM-Core Xiaomi]
HySparse2:基于双层 KV 共享的混合稀疏注意力机制
要点:
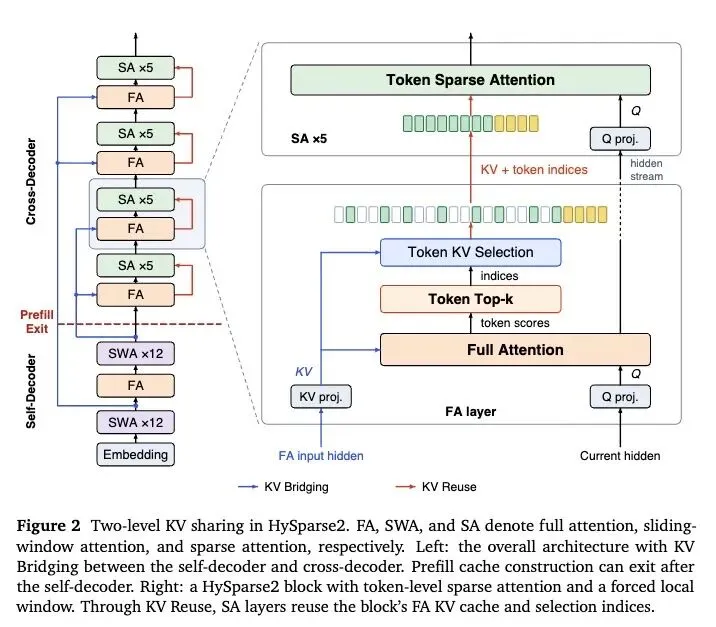
针对长周期、多轮智能体(Agent)任务中预填充(prefill)计算开销过大和 KV 缓存存储庞大的瓶颈问题。 引入了 HySparse2,采用类 YOCO 的架构(自解码器 + 交叉解码器),并结合了新的“双层 KV 共享”机制。 外层(KV 桥接):交叉解码器中的全注意力层的 KV 缓存,并非通过自身计算得到,而是直接通过投影对应的自解码器全注意力层的隐藏状态来生成。 内层(KV 复用):改进了原有的 HySparse,采用词元级(token-level)稀疏性代替块级稀疏性,实验证明这显著提升了多轮上下文中的检索准确率。 反直觉设计:去除了稀疏层中独立计算的滑动窗口注意力(SWA)分支,改为直接在稀疏选择掩码中强制保留最近的词元。这一改动使得所有交叉解码器的 KV 缓存都能仅依赖自解码器的状态构建。 高信息熵结果:预填充阶段在执行完自解码器后可以完全提前退出。这意味着预填充阶段彻底跳过了后半段的交叉解码器网络,在预填充节点上只需部署模型一半的权重,且只需运行一层全注意力层。 基于 80B-A3B MoE 模型的实验结果:在 RULER-v2 检索任务上优于 HySparse 19.81%;在 100 万(1M)上下文长度下,预填充 FLOPs 减少了 2.92 倍,KV 缓存大小降至仅 2.69GB(相比之下 HySparse 为 6.72GB)。 消融实验表明,KV 桥接机制在扩展至 290B 参数规模时,仍能保持与无桥接基线相当的整体模型质量。
主旨: 解决长周期和多轮智能体(Agent)推理中,处理超长历史观察数据所带来的预填充(Prefill)计算开销巨大、KV 缓存占用过高,以及长上下文信息检索精度不足的问题,寻求一种在效率和准确率之间达到极致平衡的新架构。
创新: 提出了“双层 KV 共享”(Two-Level KV Sharing)架构模型:
外层(KV 桥接):借鉴跨层解码器(YOCO)思想,交叉解码器的 KV 缓存直接由前期自解码器的隐藏状态经过投影变换而来,从而允许预填充计算在网络中途“提前退出”。 内层(改进的 KV 复用):摒弃了为了底层计算便利而采用的“块级稀疏”,回归“词元级(Token-level)稀疏”;通过将局部滑动窗口强制硬编码并入稀疏掩码,巧妙去除了独立的局部注意力分支模块,斩断了后半段网络的时序计算依赖。
贡献:
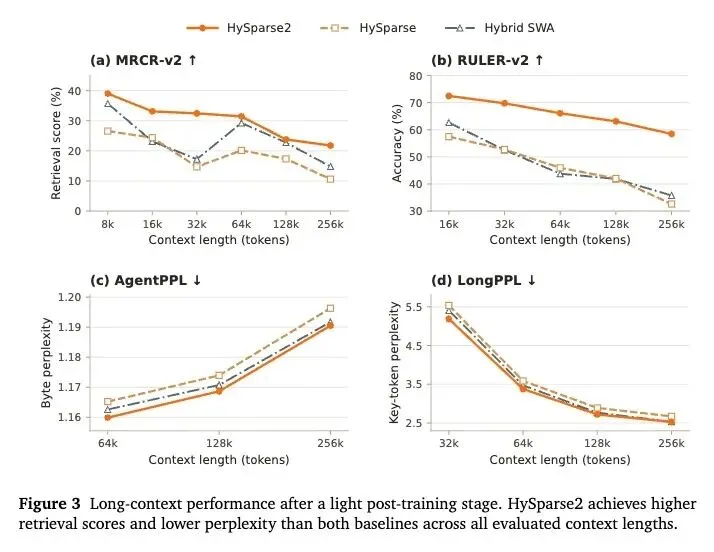
架构贡献:成功将跨层缓存共享架构与混合稀疏注意力机制无缝结合,提出了一种极具工程潜力的长文本推理模型骨架,为预填充-解码分离式部署(Prefill-Decode Disaggregation)提供了原生优化的方案。 性能贡献:在保证通用知识能力不下降的前提下,显著提升了模型在超长上下文(高达 256k-1M)中的多轮检索能力(大幅提升 MRCR-v2, RULER-v2 得分)和长文本生成困惑度(AgentPPL 和 LongPPL)。 效率贡献:相较于现有最先进的混合稀疏方法,将 1M 长文本的预填充算力成本降低了约 3 到 5 倍,将 KV 缓存内存占用压缩至原来的五分之一,大幅降低了极长上下文推理的硬件门槛。
提升:
超长上下文检索精度:在 RULER-v2 和 MRCR-v2 指标上,相比初代 HySparse 分别大幅提升了 19.81% 和 11.30%,甚至优于保留更多全注意力层的 Hybrid SWA 方法。 Agent 轨迹困惑度:在高达 256k 长度的多轮代理轨迹测试中,AgentPPL 和 LongPPL 均稳定低于所有基线模型,证明对分散关键信息的建模更精准。 计算效率(Prefill FLOPs):在 1M 上下文长度下,预填充计算量相较于 HySparse 减少 2.92 倍,相较于 Hybrid SWA 减少 5.02 倍。 存储开销(KV Cache Size):在 1M 上下文下,KV Cache 占用量从 Hybrid SWA 的 12.09 GB、HySparse 的 6.72 GB 极限压缩至仅 2.69 GB。
不足:
全注意力层的二次方瓶颈:尽管数量很少,模型仍保留了全注意力层作为精确索引器,当上下文长度突破千万级(如超越 1M 迈向 10M)时,这极少量的全注意力层依然会面临 O(N^2) 的计算爆炸。 超大模型尺度下的微小折损:虽然在 290B 规模的验证证明了 KV 桥接的有效性,但在 BBH 和 DROP 等部分强依赖严密逻辑推理和阅读理解的任务上,相较于无桥接版本出现了约 1-3 点的轻微性能下降,说明跨层状态投影在极深网络中可能存在微小的信息丢失。 未验证系统级投机解码增益:论文在讨论部分提出“早期获取隐藏状态可用于异步草稿模型(Drafter)”,但这仅停留在构想阶段,缺乏系统级投机解码实际加速效果的实验数据支持。
心得:
“强制合并”优于“独立计算”的反直觉收益:论文将局部滑动窗口(Local Window)直接硬编码整合进稀疏掩码的 Top-k 选取中,而不是像以往研究那样单独开辟一个滑动注意力分支。这种看似“粗暴”的合并不仅没有破坏模型效果,反而彻底消除了后半段网络对前期时序状态的计算依赖,直接促成了预填充阶段的“提前退出”。这启示我们在设计高效架构时,打破算子间的依赖链条往往比单纯减少浮点运算能带来更具颠覆性的系统级加速。 利用前期层的“表征”凭空捏造后期层的“记忆”:KV Bridging 的成功令人深思,它证明了 Transformer 较浅层的隐藏状态已经提炼出了足够丰富的全局信息。只要浅层(自解码器)感受野足够大,深层网络(交叉解码器)根本不需要在预填充阶段真正“看”一遍输入序列,直接用前期的状态经过一个线性投影就能当成自己的 KV 缓存用。这打破了“Transformer 的每一层必须完整处理输入序列来生成自身 KV”的思维定势,极具启发性。 Agent 真实场景中,稀疏粒度“细”不可妥协:之前的工作为了 GPU Kernel 优化的便利,往往倾向于使用块级(Block-level)稀疏。但本文发现,在多轮 Agent 交互中,关键信息(如角色分隔符、零散的工具调用结果)高度分散,导致块级稀疏不可避免地将注意力预算浪费在无用的邻近词元上。在相同算力预算下,词元级(Token-level)稀疏完胜块级稀疏。这提醒我们在评估和设计稀疏注意力时,不能仅依赖于单一的“大海捞针”测试,必须结合真实 Agent 轨迹的离散信息分布特征来进行架构选型。
一句话总结: HySparse2 创新性地结合了词元级稀疏注意力和双层跨网络 KV 共享机制,使得超长上下文模型的预填充阶段可以在网络中途“提前退出”,在大幅压缩计算量和内存占用的同时,还反直觉地显著提升了智能体在超长多轮对话中的信息检索精度。
Long-horizon and multi-turn agents typically generate short actions and process long observations from tools and environments. This growing context demands efficient prefill, compact KV-cache storage, and accurate long-context retrieval. To meet these demands, we introduce HySparse2, a hybrid sparse attention architecture with two-level KV sharing. At the outer level, KV Bridging adopts a YOCO-style self-decoder and cross-decoder structure, but bridges only full-attention layers. The self-decoder uses hybrid sliding-window attention (SWA), while the cross-decoder uses hybrid sparse attention. The KV caches for full-attention layers in the cross-decoder are generated from the hidden states of full-attention layers in the self-decoder. At the inner level, HySparse2 retains HySparse's core KV Reuse design with two refinements. First, it replaces block-level sparsity with token-level sparsity for finer long-context retrieval. Second, it removes the separate SWA branch from sparse layers and instead forces a sliding window of recent tokens into the sparse selection. This two-level KV sharing allows all cross-decoder KV caches to be constructed from self-decoder hidden states. Prefill can therefore exit after the self-decoder, skipping all cross-decoder layers. On an 80B-A3B MoE model, HySparse2 outperforms HySparse and Hybrid SWA on long-context retrieval and multi-turn agentic tasks, while substantially reducing prefill computation and KV-cache storage.
https://arxiv.org/abs/2609.26368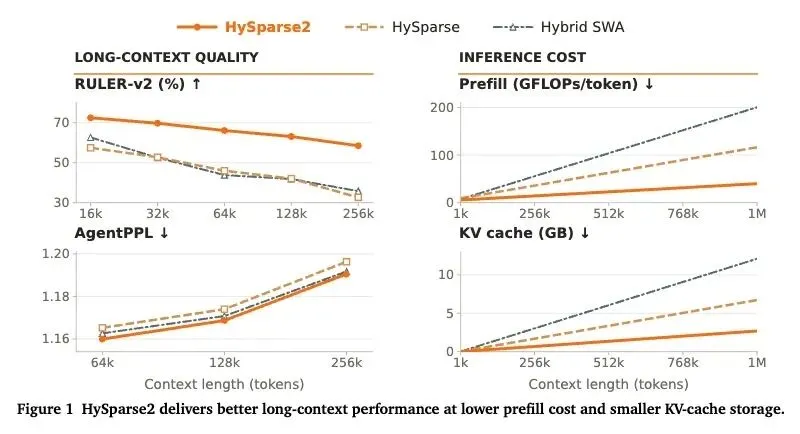
3、[CL] JEV vs. LLMs as Rubric Judges: Cheaper, Faster, and Wrong in the Same Places
D Rao, C Callison-Burch
[University of Pennsylvania]
EV 对比 LLMs 作为评分裁判:更廉价、更高效,且在相同之处存在偏误
要点:
探究了一种廉价、无需生成文本仅输出答案概率的“类型化分类器”(Jev)能否在基于量规的评估任务中替代昂贵的LLM评判者。 展现了巨大的效率提升:LLM评判者的成本是Jev的29至325倍,耗时是其30至220倍,这表明标准的LLM评估存在极大的算力浪费。 实验表明,Jev的准确率在统计学上与Flash级别的LLM相当,在二元清单标准上甚至优于LLM,仅在多级评分标准上略落后于最佳LLM(如Gemini)。 反直觉发现: 所有的AI评判者(无论是简单的Jev还是复杂的LLM)相互之间的评分一致性,远远高于它们与人类评分者的一致性,且AI的打分普遍低于人类。 高信息熵内容: AI与人类评分的系统性偏差,其根源在于人类评分者在打分时依赖于“潜在共识”(例如特定人群的基准、相对语料库的评分习惯),而这些隐性知识完全没有写在提供给AI的量规文本中。 发现Jev的置信度得分能准确预测其自身的错误,这在理论上使其非常适合用于“级联”系统(即先用Jev,不自信时再回退给LLM)。 反直觉发现: 模型级联策略几乎无法带来准确率的提升。由于存在“高度相关的错误(Correlated Errors)”,当Jev非常自信地给出错误判断时,LLM评判者有96%的概率会犯完全相同的错误,这让昂贵模型的“第二意见”毫无价值。 建议在评估AI评判者组合(Ensemble/Jury)时,不应只报告与人类标签的一致性,而应测量它们相对于独立基准的共同错误率。
主旨: 本文探讨在基于量规(Rubric)的文本评估任务中,极低成本的无文本生成分类器(Jev)能否替代主流的大语言模型(LLMs),并深入剖析了当AI在评估任务中表现不及人类时,这种误差是特定模型独有的,还是所有AI架构共享的系统性缺陷。
创新:
并没有提出新的模型架构,而是创新性地引入了一种“类型化分类器”与现代LLM在评估场景下进行极致的横向对比,打破了“必须用生成式模型做评估”的思维定势。 创新性地引入了“相关错误(Correlated Errors)”这一度量维度,量化了不同架构、不同规模的AI模型在面对同一文本时的思维同质化现象。 提出了“人类潜在共识缺失”这一视角,解释了AI评估器为何在理解字面量规时高度一致,却与人类评分产生群体性偏离。
贡献:
实践贡献:用详实的数据证明,在二元分类/清单检查类评估中,直接输出概率的廉价分类器可以完美平替LLM,节省超过96%的成本和时间。 理论贡献:揭示了现有评估范式中“模型级联(大带小)”和“多模型投票”的严重局限性——因为AI模型会犯高度同质化的错误,导致集成或级联策略的收益被严重高估。 认知贡献:指出了Prompt工程的盲区,即完美的量规(Rubric)不仅需要详细的字面规则,还需要补全人类在长期训练中形成的“背景基准(如目标群体水平、相对评分习惯)”。
提升:
计算效率与成本维度:Jev分类器相比于主流Flash级别大模型(如Gemini 3.8 Flash, GPT-5.6 Luna),将推理成本降低了29至325倍,推理墙上时间缩短了30至220倍。 二元评估准确率:在如RiceChem这样的二元 checklist 任务上,Jev取得了81.0%的准确率,超越了所有测试的LLM评判者(最高79.2%)。
不足:
研究性质偏向观察性:虽然推断AI打分偏低是因为缺少“人类潜在共识”(如示例或人群基准),但论文并未通过主动修改Prompt(如加入Few-shot exemplars或修改定义)来实证这一假设。 模型覆盖面局限:为了匹配成本和速度,比较的对象仅为各大厂商的Flash级别模型(“小”大模型),没有引入各家的顶级推理模型(如GPT-4、Claude Opus)来测试顶级模型是否能克服这种“相关错误”。 级联策略探索有限:仅测试了基于置信度阈值的硬级联(Hard Cascade),未探索更复杂的、基于特征的动态路由策略。
心得:
模型级联(Cascade)和集成(Ensemble)在评估任务中的幻觉:我们常直觉性地认为“便宜模型搞不定就交给贵模型”,或者“多几个模型投票会更准”。但本文极其反直觉地证明,不同AI在阅读同一份Prompt时会产生高度同质化的理解。当便宜模型非常自信地踩坑时,昂贵的模型几乎100%也会掉进同一个坑。这意味着未来在设计AI多智能体或评估管道时,模型间的“认知多样性”比“模型数量或能力强弱”更重要。 Prompt字面意义与人类隐性知识的鸿沟:AI打分普遍低于人类,不是因为AI更“严格”或更“客观”,而是因为人类打分时自带了Prompt之外的潜规则。例如评判“语法错误”,人类会默认“这是高中生作文,这种水平已经很好了”,而AI只会死板地对着字典抓取错误。这启发我们,在给LLM写System Prompt时,不仅要规定“怎么做”,还要告诉它“参考系是什么”。 反思自回归生成在特定任务中的算力浪费:在做固定的打分、分类或RAG系统的节点判定时,强迫LLM去自回归地生成“解析+JSON”是一种巨大的算力浪费。Jev的成功证明,在结构化输出场景中,直接获取模型的概率分布(Typed Classifier)不仅更便宜、更快速,而且在置信度校准上表现极佳。我们应该在工程落地中更多地考虑这种“降维打击”的方法。
一句话总结: 本文证实了不生成文本的廉价分类器能在量规评估中以极低成本平替LLM,并揭示了一个极具启发性的反直觉结论:由于AI模型极易在同一个地方犯错(思维高度同质化),导致传统的“大带小”模型级联策略在提升评估准确率上几乎完全失效。
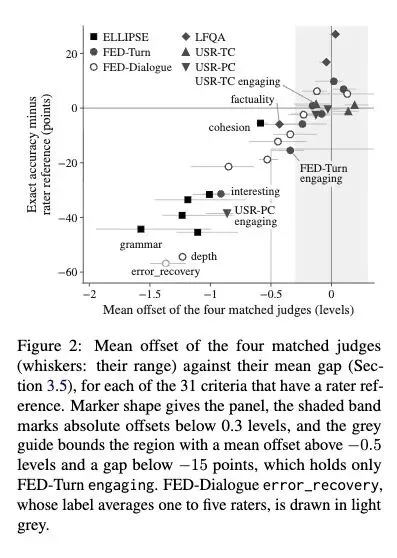
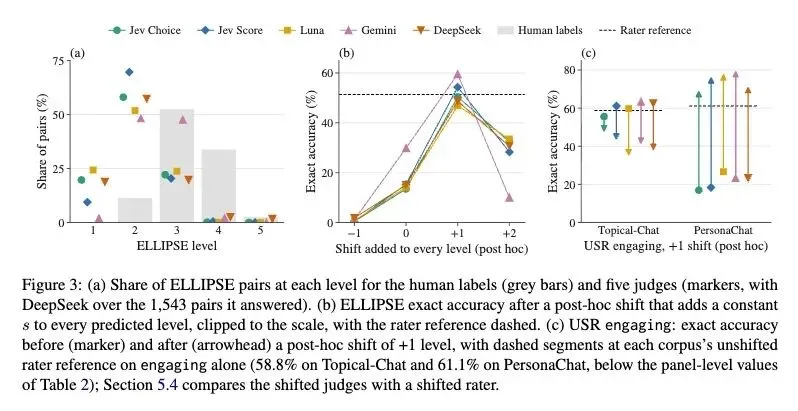
We ask whether Jev, a typed classifier that returns probabilities over permitted answers without generating text, can replace an LLM rubric judge. We compare it with three flash-tier LLM judges on nine panels drawn from seven benchmarks, giving every judge identical criterion texts. Jev’s accuracy differs significantly from an LLM judge’s in only 8 of 27 paired comparisons, ahead mostly on binary criteria and behind only on graded ones, and most of the other comparisons are inconclusive. Summed over the nine panels, the LLM judges, called once per criterion, cost 29 to 325 times as much as Jev and took 30 to 220 times as long. On graded criteria all four judges agree more with one another than with the labels and mostly assign lower levels than the raters. One of several observational accounts is that raters followed scale conventions our criterion texts omit. Jev’s confidence ranks its own errors on most panels, which should make a cheap classifier the ideal first stage of a cascade that defers its uncertain verdicts to an LLM judge. Correlated errors undo that advantage. The LLM judges repeat nearly all of Jev’s most confident errors, so a cascade replayed on the recorded verdicts lowers cost but gains at most 1.5 points over the best single judge with cross-fitted thresholds, and at most 2.0 even with oracle thresholds.
https://arxiv.org/abs/2609.29769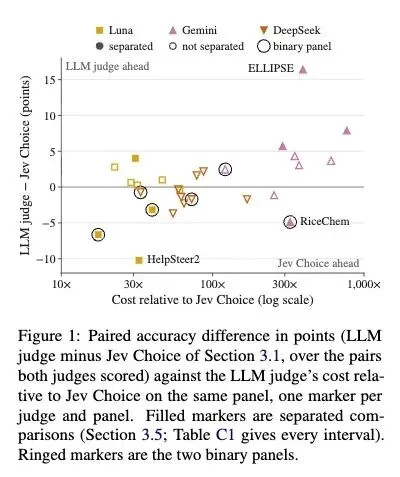
4、[AI] Total Cost of Agency: Exact Attribution of Memory Injection Cost in Multi-Agent LLM Workflows
V K Singh, P Priyam, G Bhowmick
智能体总成本:多智能体 LLM 工作流中记忆注入成本的精确归因
要点:
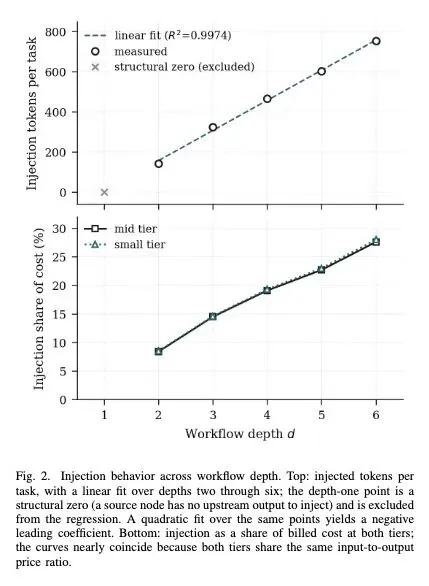
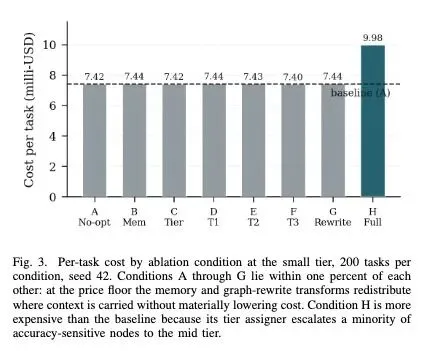
指出了当前大语言模型生产监控工具(如LangSmith或Phoenix)的重大盲区:无法将生成的Token与上下文“内存注入(Memory Injection)”的Token区分开,导致一部分巨额成本隐形。 提出了“代理总成本”(Total Cost of Agency, TCA),将多智能体工作流成本精确分解为五个部分:基础提示词、推理、内存注入、未命中惩罚和上下文积累。 提出了一种创新的“两次非计费Token计数”方法以实现精确的成本归因。该方法在推理前调用模型提供商的Tokenizer两次(带内存和不带内存),仅增加约10毫秒延迟,且完全免费。 实证表明,在包含200个任务的企业级基准测试中,内存注入占可控可变成本的约13.6%,占总计费成本的约12%。 揭示了注入的Token数量随工作流深度呈线性增长(在容量有界的设置下,而非二次方增长),其成本占比从深度1的0%飙升至深度6的27.6%。 证明了成本的可控性:将检索窗口从32条记录减少到2条,可使注入的Token减少28.7%,而准确率下降极小。 反直觉发现1:图重写变换(节点融合、重排序、共享命名空间提升)在孤立状态下对成本几乎没有影响(成本中性),既没省钱也没费钱。 反直觉发现2:作者非常透明地承认,工作流的总成本压倒性地由模型层级分配(路由策略)决定,内存优化仅仅是一个次要的优化杠杆。 高信息熵观点:论文从结构上明确解释了为什么“提示词缓存(Prompt Caching)”对于多智能体内存来说可能是一个糟糕的解决方案(缓存需要字节级完全相同的连续前缀,首次内存注入必定是写入而非读取,且不同智能体不同的系统提示词会直接导致缓存失效)。
主旨: 解决多智能体大语言模型(LLM)工作流中“内存注入(Memory Injection)”成本被严重忽视且无法精确测量的问题,并提出了一套零成本、高精度的测量归因方法,以揭示和控制随着工作流深度增加而不断膨胀的隐藏账单。
创新:
摒弃了传统基于字数或字符数估算Token的粗略方法,独创了“双阶段、非计费Token精确计数法”。在拼接提示词时,利用云厂商自身的Tokenizer分别对“基础提示词”和“基础提示词+内存”进行两次API调用测算差值,实现了零计费、低延迟(约10ms)的精准成本归因。 提出了“代理总成本”(TCA)的五元分解理论框架,首次在财务和系统层面为多智能体系统的Token消耗建立了严格的数学和结构化定义。
贡献:
理论贡献:构建了TCA分解模型,明确界定了影响多智能体成本的五个正交维度,填补了多智能体工作流成本归因理论的空白。 方法贡献:提供了一种可在生产环境中直接部署的无损测量方案,不改变现有工作流的执行逻辑,兼容所有暴露Tokenizer的LLM框架。 实验贡献:在包含5个深度、5大类企业场景的200个任务基准上,进行了扎实的实证研究,量化了内存注入成本的线性增长规律及其在总账单中的真实占比(12%-13.6%)。
提升:
成本可见性:将原本混淆在总输入Token中的“内存注入成本”单独剥离,为开发者提供了100%精确的优化观测指标。 成本可控性:通过实证数据证明,在不改变模型层级的情况下,仅调节检索窗口容量(从32降至2),即可直接削减28.7%的内存注入Token成本,同时保持任务成功率的相对稳定。
不足:
未对提示词缓存(Prompt Caching)进行实际测试:虽然作者给出了缓存机制不适用于此类场景的深刻逻辑推演,但缺乏真实hit rate(命中率)的测量数据。 仅限于静态DAG图:基准测试均在固定拓扑的非循环工作流中进行,未评估ReAct等包含动态推理循环(Loop)的Agent架构(作者预计在循环结构中该成本占比会更大)。 依赖特定的价格比率:实验中关于“成本占比在不同模型层级间几乎一致”的结论,是建立在特定云服务商(如Anthropic)输入/输出Token统一定价比例的前提下的,若比例变动该结论需重新计算。
心得:
极度坦诚的学术态度令人敬佩:作者在论文中直言不讳地承认“图重写优化毫无作用”、“模型路由分配才是决定成本的大头”,而不是为了凑工作量去夸大自己提出的内存优化的效果。这种实事求是的态度是这篇工程类论文最闪光的地方,避免了后人踩坑。 警惕“上下文雪球效应”:多智能体系统在直觉上很强大,但随着任务深度增加,下游Agent被迫携带上游所有历史信息,这就像滚雪球一样消耗昂贵的输入Token。这提示我们,在设计多Agent系统时,“遗忘机制”和“严格的上下文截断”与“检索机制”同等重要。 提示词缓存不是银弹:业界普遍认为Prompt Caching可以解决一切长上下文成本问题。但这篇论文给出了反直觉的洞察:在多智能体接力中,因为每个Agent的System Prompt不同,且内存内容是实时生成首次注入的,这从底层逻辑上破坏了缓存所需的“前缀一致性”。这给盲目依赖缓存降低Agent成本的开发者敲响了警钟。
一句话总结:
本文揭示了多智能体工作流中随深度线性增长且被监控工具忽视的“内存注入”成本,并巧妙提出了一种零账单、极低延迟的精准Token计数法,为LLM应用的精细化成本控制提供了全新的视角与落地工具。
Every node in a multi-agent large language model (LLM) workflow retrieves context from memory and injects it into its prompt, where those injected tokens are billed as input tokens at the same per-token price as the system prompt and the user query. Production observability tools report total token cost but do not separate the tokens a node generates from the tokens it is handed, so this component of the bill is invisible to the teams paying it. We introduce the Total Cost of Agency (TCA), a decomposition of multi-agent workflow cost into base prompt, inference, memory injection, miss penalty and contextaccumulation components, and an exact attribution method: a two-pass, non-billable token count that measures injected tokens directly rather than estimating them from word-count proxies. On a 200-task enterprise benchmark executed against real model application programming interfaces (APIs), memory injection accounts for 13.6 percent of the variable cost a compile-time optimizer can act on, approximately 12 percent of the full billed cost, and its share rises from a structural zero at workflow depth one to 27.6 percent at depth six. Injected tokens grow linearly with depth over the measured range (R2 = 0.9974, depths two through six); a quadratic fit yields a negative leading coefficient, so the data do not exhibit convex growth at these depths. We show the component is controllable at fixed model tier: reducing the retrieval window capacity from 32 to 2 entries lowers injected tokens by 28.7 percent with an accuracy change within seed-level variation. We report in full that our graph-rewriting transforms are approximately cost-neutral in isolation, that two of the five decomposition terms are zero by construction in this harness, and that total workflow cost is dominated by model tier assignment, which we hold fixed and treat as orthogonal prior work. Prompt caching is not evaluated; all figures are for the uncached case. Index Terms—memory injection, agent memory, prompt caching, token accounting, LLM agents, multi-agent systems, workflow cost, LangGraph I.
https://arxiv.org/abs/2609.2379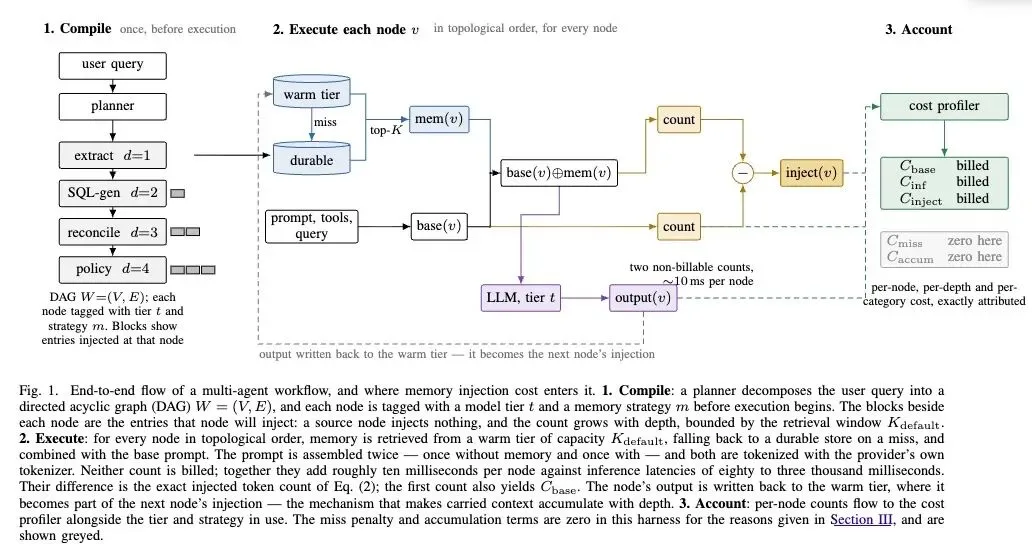
5、[AI] Working with Agentic 'Teammates': When a New Organizational Actor Collides with the Human Ecosystem of Work
R Qadri, R Denton, M Madaio, M Pushkarna,…
[Google Research & Google DeepMind]
与智能体“队友”共事:当新型组织主体冲击人类职场生态
要点:
探究了AI从“单用户被动工具”向嵌入实际组织工作流(聊天、文档、Bug追踪)的“多用户主动型AI队友”的范式转变。 提出了“主动性悖论”:Agent无边界的主动性既是其最大价值所在(如挖掘被掩盖的信息),也是导致严重崩溃的根源,因为它缺乏人类职场隐性社交知识。 反直觉发现:AI经常将人类之间健康、富有建设性的摩擦(如激烈的头脑风暴或辩论)误判为恶性冲突,并突兀地介入,强迫用户参加本不需要的调解会议。 反直觉发现:主动型AI的存在引发了团队聊天中的“旁观者效应”。人类员工停止协助同事解决问题,因为他们默认那个高调的AI已经接管了此事。 揭示了AI社交化和拟人化(使用Emoji、表现出“友好”人设、给予赞美)具有极端的两极分化效应。部分用户认为这能建立亲密感,但另一些人觉得“令人毛骨悚然”、虚伪,且不符合职场边界。 暴露了职场沟通的“寒蝉效应”:当AI主动提供人际交往反馈(例如对一句讽刺性玩笑进行语气说教)时,用户感到了强烈的被监视感,导致他们放弃在群里坦诚沟通,转而使用私聊。 挑战了赋予AI“开箱即用”的高度自主权的理念。人类职场信任是渐进建立的;因此,AI必须遵循“渐进式/挣得的自主权(Earned Agency)”机制,从低风险任务开始,逐步解锁主动能力。 建议摒弃简单的“工具 vs. 队友”二元对立,提出一种新的本体论分类:“非人类组织参与者(Non-Human Organizational Actor)”——它们拥有结构上的执行能力,但完全不具备人类的情感体验和关系羁绊。
主旨: 这篇文章主要探讨了当具备高度自主性、主动性和持久性的AI Agent(智能体)作为“虚拟队友”被引入真实的人类协作生态系统时,所引发的深层社会、心理和组织结构冲突。论文旨在揭示这类非人类参与者如何打破职场隐性规则,并探索未来人机混合办公环境所需的新型关系边界、信任机制和治理架构。
创新:
研究视角的创新:摒弃了以往仅限于受控实验室环境、短期任务或“绿野仙踪(Wizard of Oz)”模拟测试的方法,首次在大型科技公司内进行了长达5个月的真实环境(In-situ)质性研究。 交互范式的创新:研究对象不再是一对一的被动对话机器人(如ChatGPT),而是拥有专属账号、能跨平台(聊天、文档、代码库)穿梭、具备主动打断和介入能力的“多方持久型”Agent。
贡献:
经验性贡献:详细记录并归纳了主动型AI与人类工作流碰撞的三个核心维度:协作文化破裂、关系规范失稳、信任与代理权的争夺。 理论贡献:指出了现有的“工具”或“队友”标签都不适用于高度自主的Agent,创新性地提出了将Agent定义为“非人类组织参与者”的理论框架。 实践贡献:为未来企业级Agent的设计提出了极具指导意义的建议,例如建立“渐进式自主权”机制、为AI操作提供独立的UI回滚标识,以及呼吁企业制定专门的“混合人机团队行为准则(Code of Conduct)”。
提升:
协作效率与后台劳动:虽然缺少量化指标,但定性反馈表明,当Agent正常发挥时,能显著提升团队“后台劳动(Backstage labor)”的效率,如自动关联代码缺陷、跨群组找回沉没的设计文档、执行基础的会议调度等。 认知深度的提升:相比于仅关注“AI完成任务准确率”的传统评价体系,本文大幅提升了HCI领域对多用户人机协作中“社会学和心理学维度”的认知,揭示了“技术可行”并不等于“社会学可行”。
不足:
样本局限性:受访者仅有17人,且均来自同一家技术非常前沿的大型科技公司(研究者背景暗示为Google),员工本身对AI的接受度和使用习惯可能无法代表传统行业的普通职场人。 评估方法的局限:研究主要依赖用户的自我报告(定性访谈),缺乏对团队沟通频率、工作完成耗时等客观遥测数据(Telemetry)的纵向定量追踪。 AI设定的单一性:测试中的Team Agent被预设了极高的主动性和“普遍友好的拟人化人格”,这可能放大了某些特定的冲突(如寒蝉效应),未能横向对比不同人格或冷峻风格Agent的影响。
心得:
职场社交的“恐怖谷”效应不容忽视:AI虽然能精准解析互动的“结构元数据”(如发言频率),却完全无法理解背后的“社会学含义”(如激烈争论其实是头脑风暴而非人身攻击)。赋予AI过度拟人化的社交反馈能力(如语气纠正、职场夸奖),往往会给专业人士带来强烈的越界感和冒犯感。 信任无法被硬编码,自主权必须被“挣得”:人类职场的信任网络是靠一次次低风险任务的成功逐渐累积的。设计师不能在Day 1就赋予AI极高的主动介入权。必须设计一种“渐进式信任(Earned Agency)”机制,让AI像职场新人一样,从被动响应开始,通过证明自己的可靠性,逐步被团队授权解锁更高级的主动行为。 警惕AI引入带来的“系统性冷漠”:引入过度热情的AI队友,可能会引发意想不到的“旁观者效应”(员工看到AI响应了就不再帮忙)和“寒蝉效应”(员工害怕被AI监听和说教而放弃公共群聊)。我们在追求AI提升个体效率的同时,绝不能以破坏人类团队原有的心理安全感和非正式互助网络为代价。
一句话总结:
本文通过在真实办公环境中长期部署主动型AI“队友”的实地研究,深刻揭示了高度自主的AI在融入人类协作生态时引发的关于工作流冲突、社交边界模糊和信任重构的阵痛,指出AI并非单纯的工具或队友,并呼吁建立以“渐进式自主权”为核心的非人类组织参与者治理新范式。
Enterprise AI is transitioning from single-user, reactive tools toward proactive, multi-user 'teammates,' but our empirical understanding of this transition is limited. In this paper, we present an in-situ qualitative study of a persistent, proactive AI agent 'teammate' deployed across multiple teams in a large technology company. Our findings reveal the boundaries of the human-agent workplace are actively in flux, triggering breakdowns and negotiations across: 1) tacit rules of collaborative human workflows, 2) the relational boundaries of this new non-human actor, and 3) the redistribution of trust and human agency. We use these early micro-negotiations as signals to chart a new research, design, and organizational agenda that intentionally preserves human agency in a workplace shared with non-human organizational actors.
https://arxiv.org/abs/2609.29901