ARTICLE · 1090281
没集群没经费,我在自己电脑上把大模型微调跑通了|Unsloth桌面版全调研
一份写给学生党和科研人的本地大模型实操调研,全文约 4500 字,数据均来自官方文档与公开论文。
前段时间有个读研究生的朋友问我,说他想把实验室几年攒下来的领域文献喂给大模型,做一个「懂自己方向」的问答助手,顺便发篇方法类的论文。
我问他卡在哪。他说卡在三件事上,没 A100、不会写训练代码、不敢把没发表的数据传到云端。
这三堵墙,基本挡住了 90% 想认真玩大模型的普通人和独立研究者。
直到我把最近发布的 Unsloth Desktop(Unsloth 桌面版)完整调研了一遍,发现这三堵墙,它一个应用就想全拆了。
免费、开源、100% 本地运行,鼠标点几下就能微调大模型。
这不是又一个套壳聊天客户端。我把官方文档、benchmark、GitHub、arXiv 上实际用它做实验的论文都翻了一遍,这篇文章一次性给你讲透,它到底能干什么,尤其是对个人学习和科研,真实价值有多大。
01
先认识一下,这只「树懒」什么来头
Unsloth 这个名字你可能见过,logo 是一只树懒,名字慢,跑起来却飞快。它最早是一个开源的微调代码库,专门干一件事,让大模型训练又快又省显存。
团队是 Han 家兄弟俩,Daniel Han 和 Michael Han,2023 年从悉尼起步,YC 2024 夏季批次。Daniel 早年在 NVIDIA 做过机器学习工程师。据《麻省理工科技评论》中文站报道,项目 GitHub 星标已经超过 4.7 万,每月模型下载量超过 200 万次。
2026 年 8 月,他们把原来命令行和浏览器版的能力,打包成了一个真正的桌面应用 Unsloth Desktop,基于 Tauri,Windows、macOS、Linux 三端齐发,安装包只有 41MB 左右。
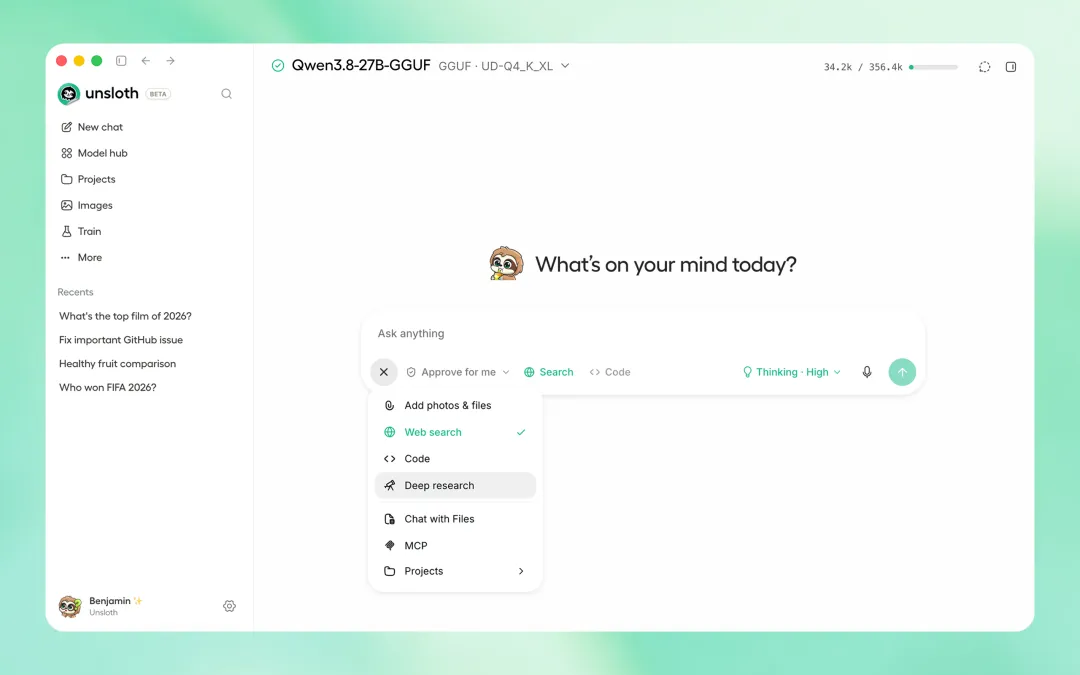
Unsloth Desktop 主界面,本地直接加载 Qwen3.8-27B 的 GGUF 量化版,聊天框里可以直接开关联网搜索、代码执行和 Deep Research(图片来源 unsloth.ai 官网)
我知道你想问什么,一个桌面应用而已,凭什么值得专门写一篇。
凭它把过去要凑齐「Linux 服务器 + CUDA 环境 + 一堆 Python 依赖 + 上百行训练脚本」才能干的事,压缩成了点鼠标。而且底层还是同一套被学术界广泛采用的内核,不是阉割版玩具。
核心代码库用 Apache 2.0 协议,桌面 UI 部分用 AGPL-3.0,都可以免费使用、自己用完全没有授权风险。官方明确说不收集使用遥测数据,应用可以完全断网运行。
「数据不出本机」这五个字,对要处理病历、访谈记录、未发表论文的科研人来说,分量很重。
02
装好到跑起来,到底有多简单
先说安装。Windows 用户在 PowerShell 里跑一行官方命令就行,Mac 和 Linux 也是一行 curl,全程一两分钟。
irm https://unsloth.ai/install.ps1 | iex
打开之后没有任何配置向导。它会自动识别你的显卡和已经下载过的模型(Ollama、Hugging Face 目录都能扫到),然后你要做的就是在 Model Hub 里挑一个模型、挑一个适合自己机器的量化版本,下载,开聊。
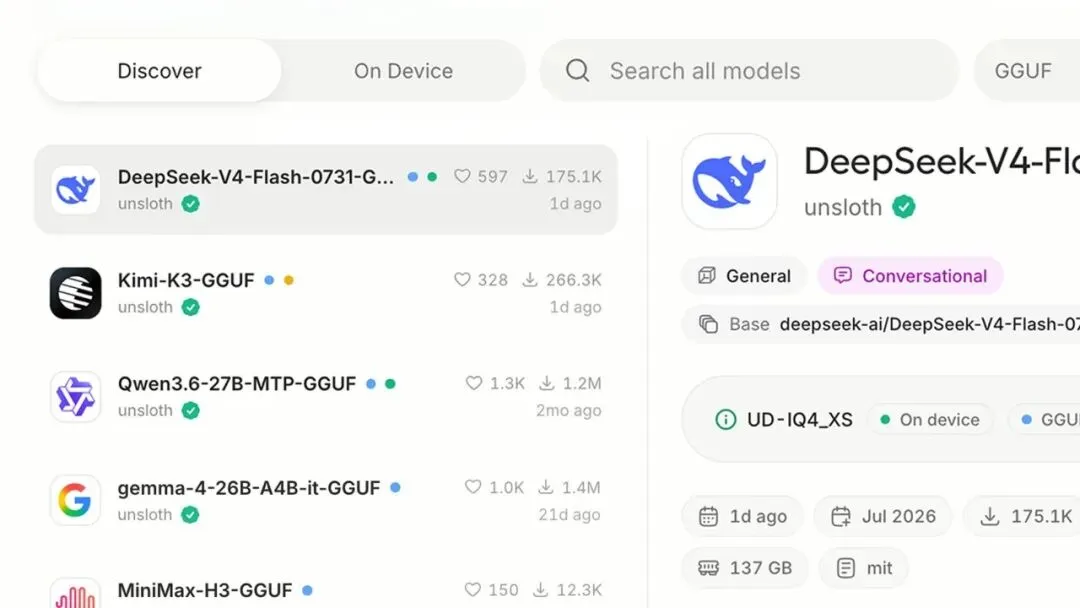
内置模型库,DeepSeek、Kimi、Qwen、Gemma、MiniMax 都在列,右侧直接标注量化格式、体积和许可证(图片来源 unsloth.ai 官网)
这里有个容易被忽略、但对学习者极其友好的细节。
主流新模型发布,Unsloth 基本是 Day Zero 支持,官方文档里现在已经挂着 Qwen3.8、GLM-5.3、Gemma 这些最新系列。也就是说,你不用再经历「模型出了,等适配,等教程,等大佬出整合包」的漫长链条,发布当天就能在自己电脑上跑、能训。
推理引擎底层是 llama.cpp,支持 GGUF 和苹果 MLX 格式,NVIDIA、AMD、Intel、Mac、纯 CPU 都能跑。聊天之外,还内置了联网搜索和 Deep Research,能自己规划检索、翻 20 多个网页、最后产出带引用的报告。
但聊天只是赠品。真正的重头戏,是训练。
03
无代码微调全流程,拖个 PDF 就能开训
传统微调大模型,新手最容易死在哪,死在数据准备。格式不对、字段不齐、指令对答没拆开,光清洗就能耗掉一周。
Unsloth Desktop 给的解法叫 Data Recipes,底层用的是 NVIDIA 的 NeMo Data Designer。说人话就是,你把 PDF、CSV、JSON 文档丢进去,用一张节点流程图,把「原始资料」一步步变成「训练用的指令数据集」。
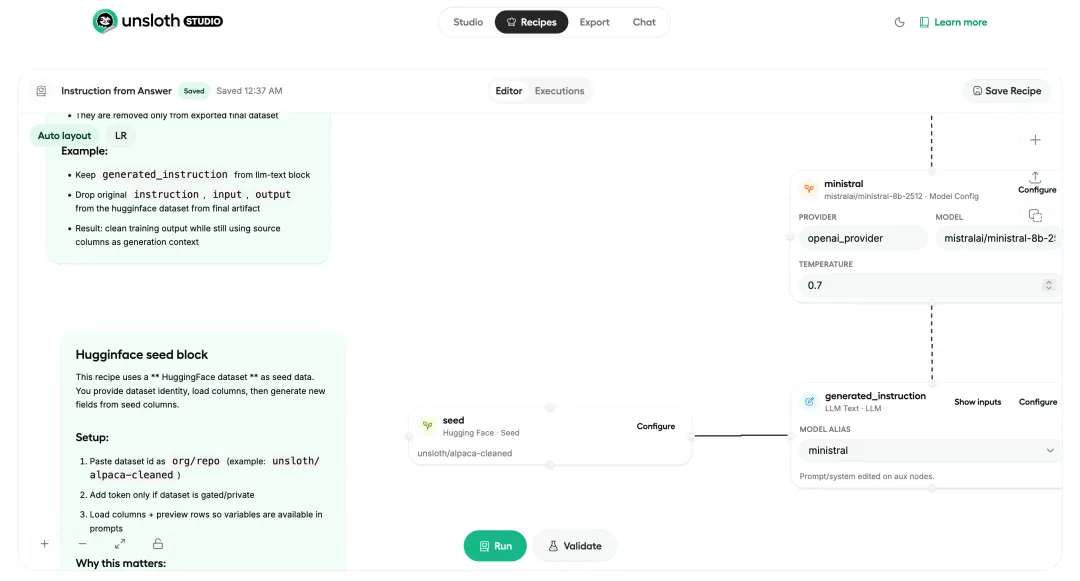
Data Recipes 的节点式工作流,种子数据、模型生成、校验过滤全在一张画布上(图片来源 Unsloth 官方文档)
它能做的事,比「格式转换」深得多。
节点类型里有普通文本生成、结构化 JSON 输出、代码生成,还有一个 LLM Judge,让模型给生成的数据打分,不合格的自动淘汰。代码类数据还能用内置的 Python、SQL、JavaScript linter 直接验语法。先小批量预览,看着没问题了再全量跑,跑完直接进本地数据集列表,一键喂给训练。
训练这一步,支持 LoRA、QLoRA、全参数微调甚至继续预训练,覆盖 500 多个模型,文本、视觉、TTS 语音、嵌入模型都能训。不想动参数就用官方预设,想深入就自己改,也支持导入 YAML 配置文件复现实验。
整个闭环长这样,五步,全程不碰命令行。
① 导入资料→② Recipes 造数据→③ 选模式开训
④ 对比基座效果→⑤ 导出部署
训练过程中,loss 曲线、梯度范数、GPU 利用率都是实时图表,还能通过 Cloudflare 隧道在手机上瞄一眼跑完没有。训完的模型可以导出成 safetensors,或者 GGUF,直接丢进 Ollama、LM Studio、llama.cpp、vLLM 用。每次训练的历史和配置都存着,回头能翻、能重新导出。
注意这个闭环的意义,数据、训练、评测、部署全在一台个人电脑上、全部可复现。这恰好就是科研方法学最看重的东西。
04
上硬菜,速度和显存的真实数字
「2 倍速度、省 70% 显存、不掉点」是 Unsloth 到处在说的三个数。我没打算只转述口号,去把官方 benchmark 和第三方实测都挖了出来。
先看最有冲击力的,同样显存下能喂多长的上下文。测试对象 Llama 3.1 8B,4bit QLoRA,rank 32,batch size 1。
数据来源 unsloth.ai 官方 benchmark 页,对照项为 Hugging Face + FlashAttention 2 标准实现。
8GB 显卡在标准方案下连第一步都跑不起来,Unsloth 能塞进去将近 3000 token。16GB 这个大多数游戏本和台式机的档位,差距是 4 万 token 对 2500 token,16 倍。
大模型那边更夸张。70B 的 Llama 3.3,48GB 显存标准方案 OOM,它能跑 12000 token 的微调;80GB A100 上,上下文长度从 6916 拉到 89389,长了约 13 倍,速度快 2 倍,显存占用少 75% 以上。
民间实测也对得上。有人在 RTX 4090 上跑 Llama 3 8B,每步从 1.8 秒降到 0.95 秒;Qwen2 7B 微调的显存占用从 26GB 压到 7.5GB。gpt-oss 20B 这种尺寸,12.8GB 显存就能微调。
NVIDIA 官方开发者博客还验证过,一张 32GB 显存的 RTX 5090,用 Unsloth 可以微调最高 400 亿参数的模型。
换句话说,「微调」这件事的硬件门槛,从实验室机柜被拉到了一张消费级显卡。
原理不玄学,无外乎手写 Tritron/CUDA 内核、手工推导反向传播里占显存的计算步骤、改进梯度检查点算法,把「算得快」和「记得少」同时做到。对使用者来说,你不需要懂这些,但它解释了为什么省这么多还不掉精度。
05
科研人最该看的部分,论文里已经有人在用了
判断一个工具在科研上靠不靠谱,别看宣传,去 arXiv 翻有多少论文真的拿它做实验。我翻到的结果让我有点意外,已经不少了。
2025 年的 REx86 论文,做了一个辅助 x86 汇编逆向工程的本地大模型,论文里写明全部微调用 Unsloth 完成,理由就是它在单卡上把显存和训练时间压下来了。
另一篇低资源语言的领域适配研究,用 QLoRA 做离线知识蒸馏,明确写借助 Unsloth 减少了 60% 显存占用。还有一篇孟加拉法律问答的工作,研究者在 Qwen3.5 的 0.8B、2B、4B 三个尺寸上做对照实验,统一数据和适配器设计,只让模型规模变化,这种消融实验在过去要排队等集群,现在一台机器一晚跑完。
还有篇论文标题就很有意思,《在免费 GPU 上微调一个 7B 顾问模型》,16GB 预算内做完整的 adapter 训练和交接方案。
把这些论文和它的功能拼起来,对个人研究者,至少有六个实打实的用法。
用法一,领域文献助手,这是最直接的
把课题组的论文、教材、讲义 PDF 丢进去,用 Data Recipes 生成问答对,LoRA 微调一个 7B 或 14B 模型。它学会的是你这个细分领域的表达习惯和知识关联,比通用模型加提示词稳定得多,而且全部推理离线,实验室断网也能用。
用法二,敏感数据的合规研究
临床病历、访谈录音、企业内部文档,这类数据传云端 API 在伦理审查上就是一道坎。本地训练加本地推理,数据不出实验室,配合权限控制和沙箱,合规压力小一大截。语音方向还能本地跑 Whisper 和 Qwen3-ASR 做转录,先转文字再分析。
用法三,低成本做对照实验和消融
想验证「数据量、rank 大小、基座尺寸哪个影响更大」,以前要申请好几次算力。现在同一台机器,YAML 配置一改,几组实验排队跑完,训练记录全留痕。这对硕士生凑论文里的实验章节,帮助是决定性的。
用法四,微调嵌入模型,给 RAG 打底
很多人做文献检索问答,通用 embedding 在专业术语上召回很差。Unsloth 支持嵌入模型微调,用你自己领域的语料把检索底座校准好,再接 RAG,效果提升往往比换更大的语言模型还明显。
用法五,多模态和视觉研究
图表识别、显微图像、遥感影像、UI 截图,可以微调多模态视觉模型;扩散模型这边,FLUX、Z-Image、Qwen-Image 都能在自己图片上训 LoRA,做风格化和特定主体生成,人文地理、设计、医学影像方向都用得上。
用法六,把模型变成能干活的 agent
这是我觉得最被低估的能力。它内置沙箱,模型可以真的执行 Bash 和 Python,跑挂了会自动检测、修复、重试,官方数据工具调用准确率提升 50%。你可以让微调后的模型直接处理数据、画图、验证结果,而不只是「建议你运行这段代码」。
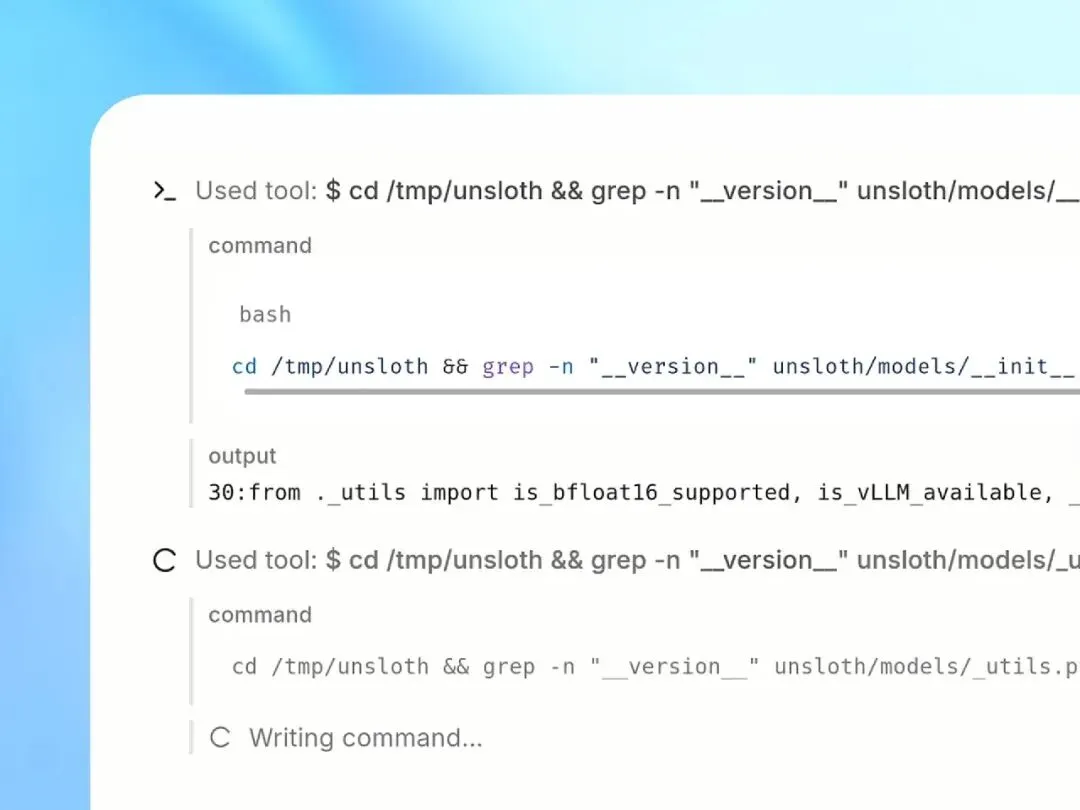
模型在安全沙箱里执行代码并以 HTML 预览结果,工具调用失败会自愈重试(图片来源 Unsloth 官方文档)
更狠的是一条命令的事。在项目目录里运行 unsloth start claude,就能把 Claude Code、Codex 这类编程 agent 的后端换成本地模型,一个命令切换,工作流不变。它同时暴露 OpenAI 兼容接口,你自己的脚本、评测框架可以原样接进来。
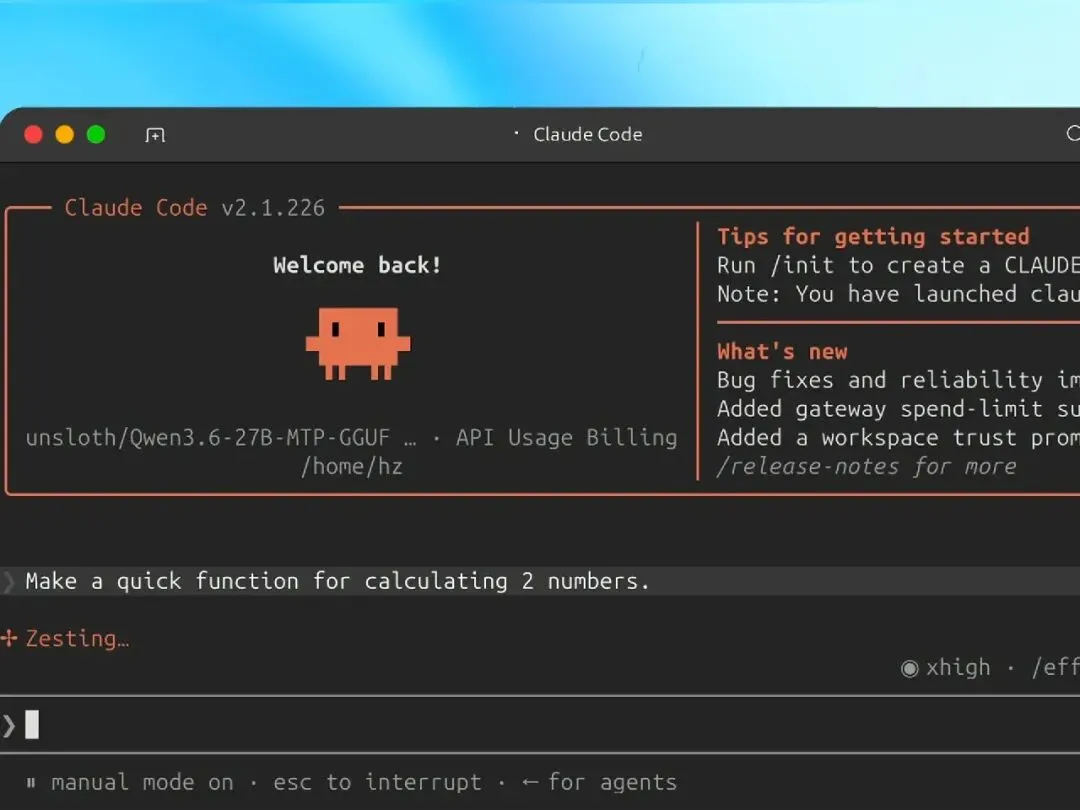
unsloth start 把本地模型接给 Claude Code、Codex 等 agent,也可以通过 Cloudflare 隧道在手机上访问(图片来源 unsloth.ai 官网)
做计算社科、生物信息这类要反复处理数据的方向,相当于有了一个「懂你领域、不收 token 费、数据不外泄」的研究助理。
06
学习路线和硬件怎么选,照这个来
如果你是从零开始,我建议按五个台阶走,每一级都有明确的能力目标,不会在环境配置里白白消耗热情。
第一级,装好桌面版,下一个 7B 量化模型,把聊天、联网、Deep Research、文件问答用熟,建立「本地模型能干什么」的直觉。
第二级,跑官方免费的 Colab notebook,T4 显卡零成本,把一次 LoRA 微调从头点到尾,看懂 loss 在怎么动。
第三级,回到桌面版,用自己的 PDF 或 CSV 走通 Data Recipes 到训练再到导出 GGUF 的完整闭环。
第四级,开始调参,rank、alpha、学习率、上下文长度,做对照实验,读训练曲线,建立「数据和参数如何影响效果」的经验。
第五级,把模型接进真实工作流,OpenAI 接口、Claude Code、多卡训练,有余力再去读 Unsloth 核心库的手写内核源码,那本身就是一份高质量的系统教材。
硬件方面,别盲目买卡,按需求对号入座。
07
几句清醒话,它不是万能的
调研越深入,我越觉得有必要把边界说在前面,免得你抱着不切实际的期待冲进去。
它还是 Beta。界面和功能迭代很快,偶尔会有小毛病,生产环境重度依赖前要有心理准备。
无代码训练的完整体验在 NVIDIA 显卡上最顺。Mac 支持 MLX 训练和 GGUF 推理,AMD 也能用,但追新特性和踩坑资料,N 卡仍然是第一梯队。老硬件官方直接说了可能支持不好。
它不创造算力。8GB 卡能微调不代表能舒服地微调 70B,省显存是让「不可能」变「能跑」,速度和规模仍然受物理限制。第一次 torch.compile 还要等几分钟预热,别看到开头慢就以为翻车。
工具抹平的是工程门槛,抹不平数据和问题意识。垃圾数据进去,垃圾模型出来,这一条不会因为界面变好看而改变。研究者真正的护城河,始终是提出好问题、构造好数据、设计好实验的能力。
说句我的判断。
过去三年,大模型领域最让人沮丧的一件事,是研究资源在加速向机构集中。算力、数据、工程团队,普通学生和独立研究者连入场券都摸不到,很多人只能在 API 外面做提示工程。
Unsloth 桌面版代表的是另一个方向。当一台游戏本就能完成「数据构造、模型训练、对照评测、部署使用」的完整科研闭环,而且全程免费、离线、可复现,被重新分配的不只是显存。
是「谁有资格做模型研究」这件事本身。
工具不会替你想出好课题,但它让「我有个想法」到「我验证了这个想法」之间的距离,从几个月的排队和配环境,缩短到一个晚上的点击。
这个时代对自学者的慷慨之处就在这里。知识是免费的,模型是开源的,现在连训练它们的工具都塞进了一个 41MB 的安装包。剩下的,就看你愿不愿意动手了。
参考资料
Unsloth 官网及官方文档 unsloth.ai(Desktop、Studio、Data Recipes、Benchmarks 页)
NVIDIA Developer Blog《Train an LLM on an NVIDIA Blackwell Desktop with Unsloth》
《麻省理工科技评论》中文站 Unsloth 团队报道
arXiv 2510.20975(REx86)、arXiv 2601.16219(低资源领域蒸馏)、arXiv 2607.23446(孟加拉法律 QA)、arXiv 2504.15610(免费 GPU 微调 7B)
本文界面截图均来自 Unsloth 官方公开文档,版权归原作者所有