ARTICLE · 1093064
基于PDF图纸读取PMI数据:VLM真的已经碾压传统OCR?
过去两年,"视觉语言模型(VLM)取代传统OCR"的论调几乎成了文档智能领域的默认共识。但当任务换成从PDF工程图纸里读取产品制造信息(PMI)、并自动生成质量检测表格时,事情远没有那么简单——尺寸、形位公差、表面粗糙度读得又快又准,标题栏和注释却大面积"翻车";字符错误率低到1.72%的模型,也会一本正经地把原图"改写"成它以为的样子。本文基于近一年发表或收录的10篇公开研究,把这件事的数据摊开来看。
01为何要从PDF图纸读取PMI数据
在制造业与工程建设行业,二维图纸仍然是设计意图、公差要求与工艺细节的第一载体[2]。附着在图纸上的尺寸标注、几何尺寸与公差(GD&T)、表面粗糙度、螺纹、材料规格和注释信息,就是通常所说的产品制造信息(PMI)——它们直接决定后续的工艺设计、刀具选择、检验规程与质量验收[1]。
问题在于,绝大多数下游系统拿到的PMI并非结构化数据,而是"画在图上"的图形与文字。行业实践中,检验人员仍普遍采用气球标注(ballooning)的办法,把图纸特征与公差逐条誊写到表格或检验报告里;即便有AutoCAD的气球标注工具、Mitutoyo MeasurLink这类半自动平台辅助,也依然高度依赖人工录入,效率低、易出错、难扩展[1]。
换句话说,PMI读取是打通"图纸—数据—质检"链路的第一公里:PDF图纸里的PMI读不出来、读不准,后面的质量检测表格生成、工艺规划、检验计划就全是空中楼阁。这也是为什么近一年的研究不约而同把"从2D图纸中结构化提取PMI"作为主攻方向[1][2][7]。
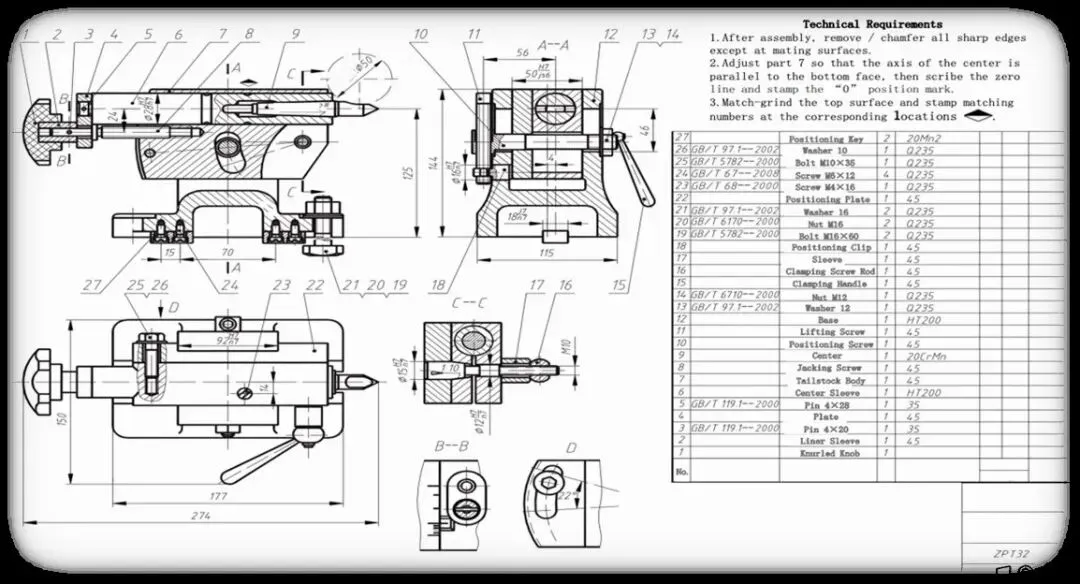
宏观层面,这种诉求同样成立:有研究指出,企业超过80%的信息以发票、合同、图纸这类非结构化文档形式存在,而从中提取结构化知识始终是主要瓶颈[3]。图纸数字化不是锦上添花,而是制造业数据化的前提。
02制作质量检测表格面对的挑战
把PDF图纸变成一份质量检测表格,中间要经过"版面切分—标注定位—语义解析—结构化输出"多个环节。近一年的基准研究显示,挑战集中在前两步。
◆挑战一:通用OCR在工程图纸上不足
工程图纸的标注常常是旋转的、重叠的、符号与文字混排的,而通用OCR模型多在常规文档数据集上训练,缺少领域微调,面对倾斜的尺寸线、交叠的引线和风格化符号时往往产生分割错误,输出不完整也不可靠[1]。这正是各国研究者转而使用"旋转框检测+视觉语言模型"替代纯OCR流水线的直接原因。
◆挑战二:高标注密度与领域鸿沟
国内研究者联合构建的MechVQA基准(3.3K张高密度图纸、21K问答对、10个细粒度任务)证实:通用多模态大模型在机械图纸上"依然脆弱"——标注密度高、领域知识弱,叠加投影规则下的空间关系推理不可靠,使得关键线索容易被遗漏,频繁答错[4]。
布局检测层面同样存在"领域鸿沟":2026年欧洲计算施工会议(EC3)的一项基准显示,在通用文档数据集上预训练的DocLayout-YOLO迁移到工程图纸后,mAP50仅0.675、F1只有0.662,出现明显"领域干扰(domain interference)"性能退化;而在领域内训练的RF-DETR可达mAP50 0.949[5]。这提示我们:图纸不是"另一种文档",用文档领域的现成模型直接套图纸,并不可靠。
◆挑战三:级联误差
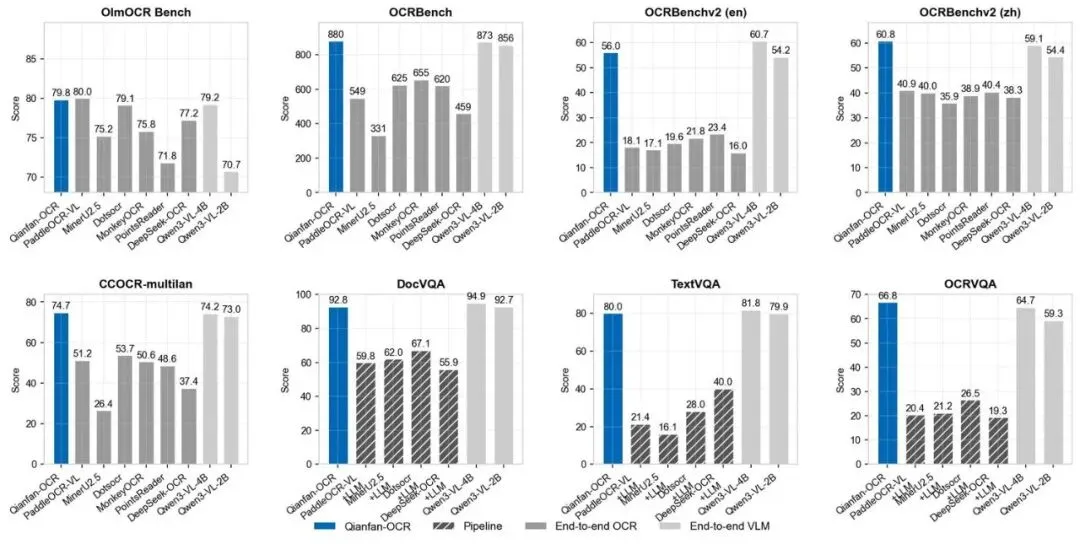
传统方案把"检测—识别—理解"拆成多个级联模块,看似各司其职,实则逐级传递误差[6]。百度千帆团队的端到端文档模型研究指出:级联式方案在文档理解类任务上会出现显著性能退化,这正是产业界转向端到端VLM的动因之一——其4B参数的Qianfan-OCR在OmniDocBench v1.5上以93.12分位居所有端到端模型第一[6]。
而"图纸理解能力梯度"的数据则划出了当前模型的真实边界:在AECV-Bench上,以OCR为核心的文本问答最高可达0.95准确率,空间推理居中,但符号级理解——比如可靠地数清图纸里的门窗数量——普遍只有0.40–0.55的准确率[2]。换言之,今天的模型是好用的"文档助手",却还称不上有"图纸素养"。
03自动生成质量检测表格的可靠性
"读得出"与"读得对"之间隔着一整片数据。2025年下半年以来,一批基准研究第一次把VLM读图纸的真实成绩单摊开在了桌面上。
◆3.1 数据能读准,文字字段仍在"及格线"
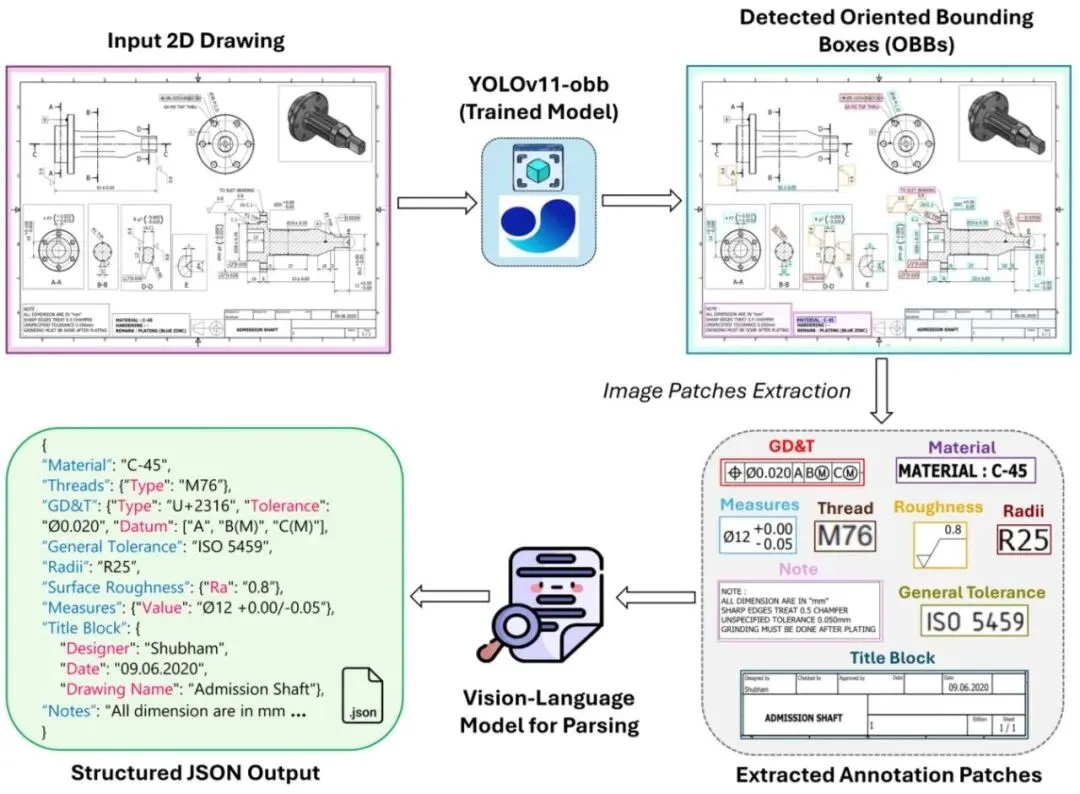
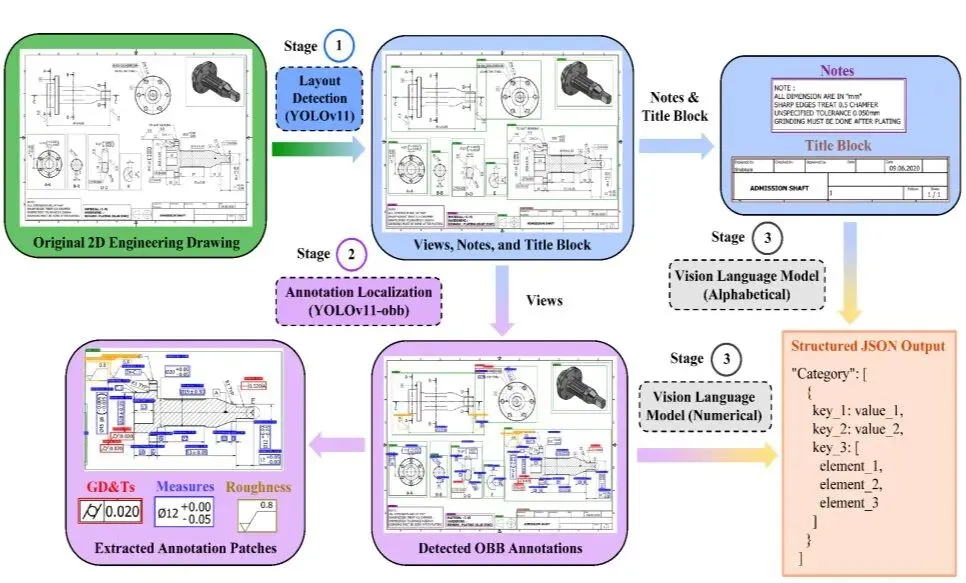
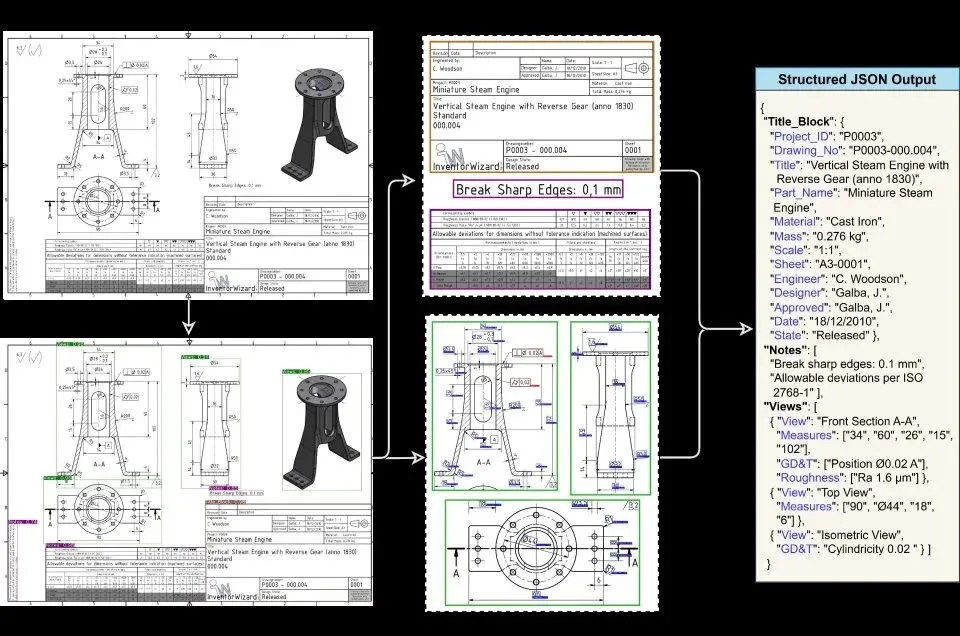
新加坡科技研究局(A*STAR)团队的最新工作给出了迄今最细颗粒度的拆分:先用YOLOv11-det做版面切分,再用YOLOv11-obb做旋转标注定位,最后由两个免OCR的Donut型VLM分别解析——结果出现了一个耐人寻味的"剪刀差":
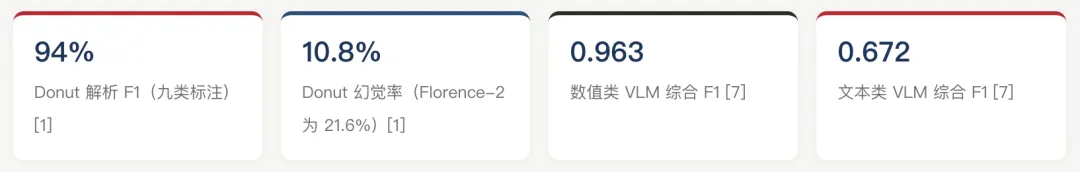
数值类VLM综合F1达0.963(测量值0.923、GD&T 0.965、表面粗糙度1.0,幻觉率仅0.067);而文本类VLM综合F1只有0.672——其中标题栏F1仅0.533、幻觉率高达0.478,注释F1 0.810、幻觉率0.319。—— A Multi-Stage Hybrid Framework for Automated Interpretation of Multi-View Engineering Drawings Using Vision Language Model[7]
同一团队的期刊版研究进一步量化了模型选择的影响:在1,367张2D机械图纸、九大标注类别的数据集上,微调后的Donut取得89.2%精确率、99.2%召回率与94%的F1,幻觉率10.8%;对比之下Florence-2的F1为85.0%、幻觉率21.6%——两者差了近一倍[1]。
◆3.2 "低字符错误率"不等于"高保真"——VLM会"改写"图纸
更要命的风险藏在指标看不见的地方。一项针对历史档案数字化的大规模评测(对比传统OCR、专用OCR型VLM与通用VLM共18个系统)发现:VLM在字符错误率(CER)与词错误率(WER)上确实全面优于传统OCR,但均值与中位数差异巨大——推理模式下Qwen 3.6的中位数CER仅1.72%,均值却冲到11.17%:多数页面近乎完美,少数页面灾难性失败。作为对照,表现最好的传统OCR DocTR均值为10.23%、中位数5.74%,Tesseract均值CER则为20.92%[8]。
| 系统 | 类别 | CER 均值 | CER 中位数 | WER 均值 | WER 中位数 |
|---|---|---|---|---|---|
| Qwen 3.6(推理模式) | 通用VLM | 11.17% | 1.72% | 15.12% | 5.01% |
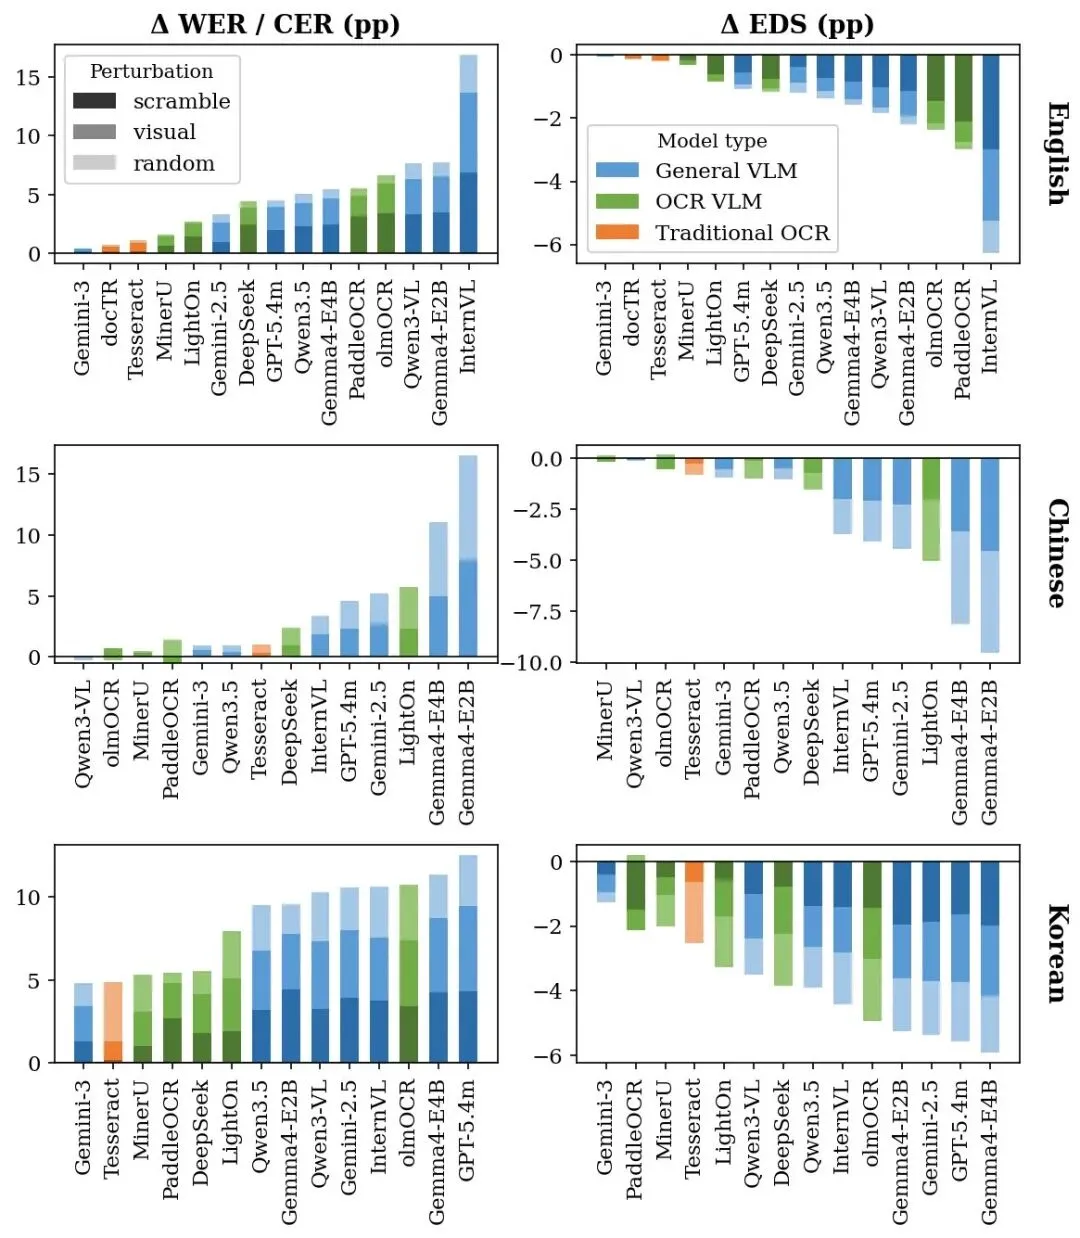
质量检测表格恰恰不能容忍这种"语义替换"。亚马逊团队的FaithC4基准(1,455份单页文档、覆盖英中韩三语、15个系统)证实:当文本不完美时,VLM倾向于"改写"而非"转录"——把模糊字符自动纠正成它以为的样子。在扰动测试下,通用VLM的词错误率最多恶化6.9个百分点,专用OCR型VLM恶化0.1–3.4个百分点,而传统OCR不足0.8个百分点[9]。研究者还发现一个细节:4–6个字符的短词被改写的比例最高可达10%,而超过8个字符后改写率骤降为0%——对图纸里大量出现的短代号、短公差字符串而言,这绝不是好消息。
◆3.3 落地账本:可靠性可以"管"出来
可靠性之外,产业界更关心一笔工程账。一项已投产的文档VLM部署案例给出了参照:采用35B总参数/3B激活参数的混合专家(MoE)VLM,在单张H100上完成训练与服务,经生产环境遥测校准的质量调整成本分析显示,其预期成本较人工基线下降超过80%,较最佳开源竞品下降超过50%[10]。
把三组数据放在一起,结论其实很清晰:VLM在"数值型PMI"上确实已经越过可用性门槛,在整体指标上全面优于传统OCR;但"碾压"谈不上——文本字段的高幻觉率、对不完美文本的改写倾向、以及小概率的灾难性失败,都决定了它必须带着护栏上岗。可操作的护栏包括:旋转框检测先行、把文本字段与数值字段交给不同专长模型、对低置信度字段引入人工复核(human-in-the-loop),以及用"幻觉率/改写率"而非单纯CER来验收模型。
04案例解析:从一张PDF图纸到一份质量检测表格
◆案例A:解析结果直通工艺、报价与质检
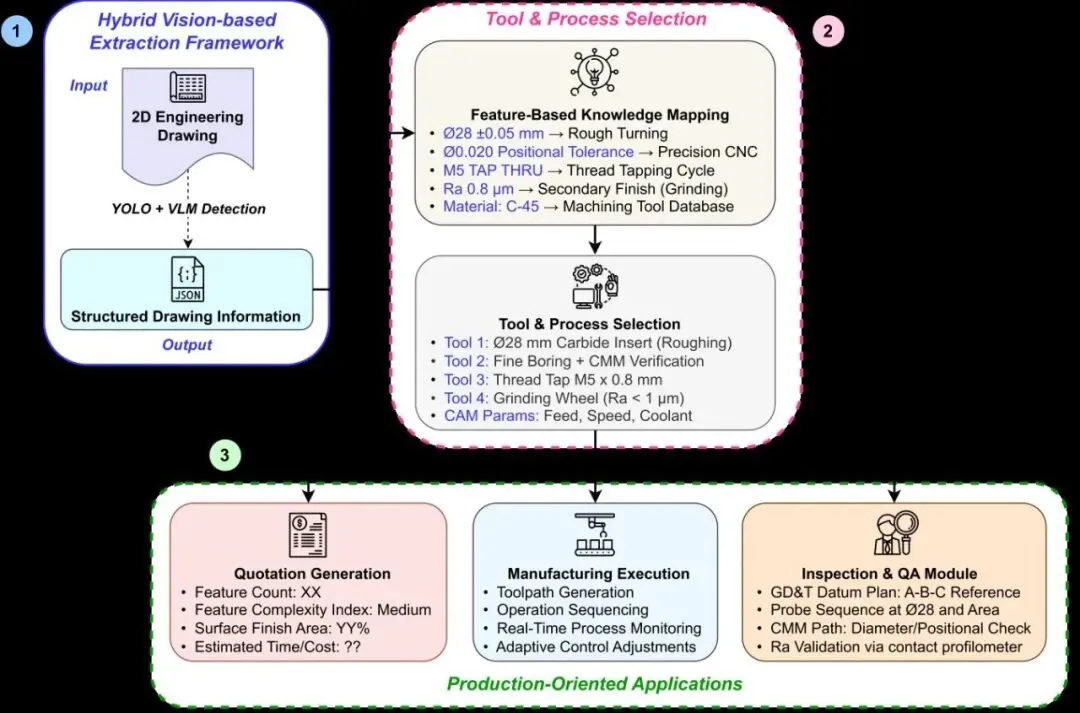
在A*STAR团队的案例研究中,一张2D图纸经"YOLOv11-obb + 微调VLM"解析后输出结构化JSON,并直接驱动工艺决策:检测到Ø28 ±0.05 mm、Ra 0.8 μm的轴类特征后,系统给出粗车+精车的工序组合,并选中硬质合金粗车刀与修光刃(Wiper)精车刀;紧公差孔则映射出M5×0.8 mm 丝锥攻丝工序[1]。研究还进一步展示了结构化输出的下游通路:报价生成、制造执行与CMM检测计划——其中检测模块直接给出基准参考A-B-C、Ø28处的测针路径与直径/位置度检查(见图6)。这正是"质量检测表格"的雏形:PMI一落地,检验项、检验方法与判定依据自动跟随。
◆案例B:多视图图纸端到端结构化输出
在多视图场景下,三阶段混合框架将一张立式蒸汽机图纸解析为统一JSON:标题栏字段(项目号、图号、材料"Cast Iron"、比例"1:1"、设计者与批准人、日期与状态)逐项成对出现;注释字段把"锐边去毛刺0.1 mm"这类技术要求翻译为可执行条目;视图字段则按"A-A剖视/等轴测/正视图"分组,把测量值、GD&T(如位置度Ø0.02 A|B|C)、粗糙度Ra 1.6 μm逐条归位[7]。这份JSON稍作映射,就是一份可直接进入检验流程的质量检测表格。
◆工程侧的对应物:气球标注工具正在接入同一套逻辑
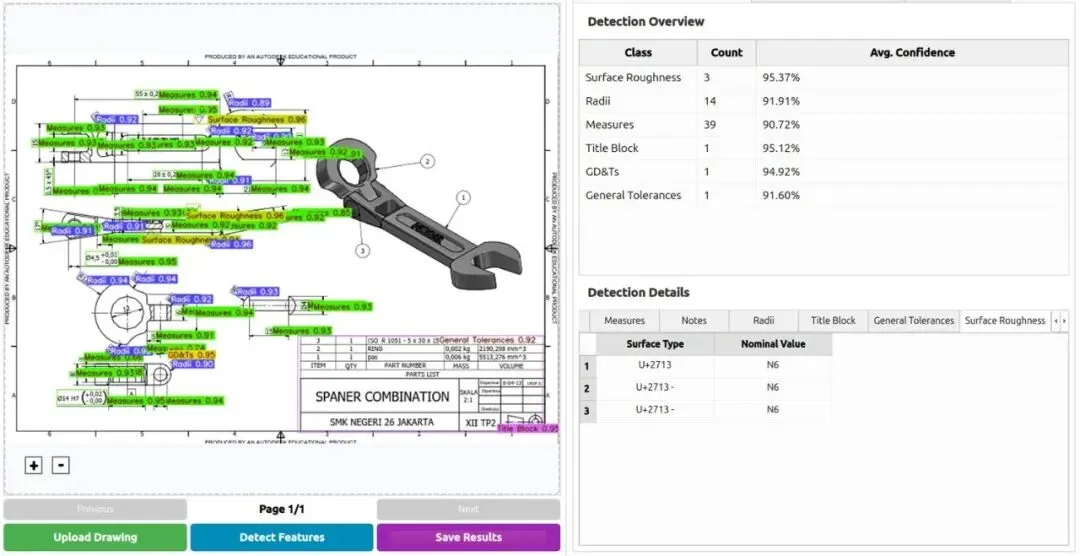
上述研究路线与产业工具的演进方向高度一致。以面向二维图纸PMI气球标注的MBDVidia_BALLOON2D为例,其核心正是把图纸上的尺寸、公差与粗糙度标注逐条"气球化"并生成带编号的检测表格;而近一年的研究进展说明,当检测-解析引擎换成"旋转框+VLM"的混合架构后,这类工具所依赖的自动识别底座在数值型PMI上已具备工程级精度[1][7]。对使用者而言,真正的分水岭不在"要不要用VLM",而在是否为文本字段保留人工复核、是否以幻觉率作为验收指标。
给工程师的三条落地建议:① 数值字段(尺寸/公差/粗糙度)可放心交给"检测+VLM"流水线,已有94%级F1支撑[1];② 标题栏、注释等文本字段保留human-in-the-loop复核——其F1仍在0.53–0.81区间、幻觉率0.32–0.48[7];③ 验收模型时把"改写率"纳入指标,别让"低错误率"的漂亮数字掩盖语义失真[8][9]。—— 综合自文献 [1][7][8][9]
参考文献
Khan M T, Chen L, Yong Z, Tan J M, Feng W, Moon S K. From drawings to decisions: A hybrid vision-language framework for parsing 2D engineering drawings into structured manufacturing knowledge[J]. Robotics and Computer-Integrated Manufacturing, 2026, 99: 103186.(arXiv:2506.17374) Kondratenko A, Birhane M, Hsain H E, Maciocci G. AECV-Bench: Benchmarking Multimodal Models on Architectural and Engineering Drawings Understanding[EB/OL]. arXiv:2601.04819, 2026. Gurbuz A S, Nassar A, Auer C, Lysak M, Morin L, Omenetti M, Strohmeyer T, Vagenas P, Livathinos N, Dolfi M, Staar P. Identify, Locate, Link: End-to-End Key-Value Extraction from Document Images[EB/OL]. arXiv:2608.20868, 2026. Kou Q, Shi X, Li Y, Qiu X, Wang X, Zhou H, Cao D. MechVQA: Benchmarking and Enhancing Multimodal LLMs on Comprehensive Mechanical Drawing Understanding[C]. Proceedings of the 43rd International Conference on Machine Learning (ICML), PMLR 306, Seoul, 2026.(arXiv:2605.30794) Huang T, Lombardi A, Elnagar A, Zalouk A, Paul G, Najjarpour S, Sigurdsson A, Ismail K, Ragab M, Vakaj E. Benchmarking Deep Learning Approaches for AEC Engineering Drawing Layout Detection and Information Extraction[C]. 2026 European Conference on Computing in Construction (EC3), Corfu, Greece, July 12–15, 2026.(arXiv:2607.18997) Baidu Qianfan Team. Qianfan-OCR: A Unified End-to-End Model for Document Intelligence[EB/OL]. arXiv:2603.13398, 2026. Khan M T, Yong Z, Chen L, Feng W, Tan N Y J, Moon S K. A Multi-Stage Hybrid Framework for Automated Interpretation of Multi-View Engineering Drawings Using Vision Language Model[EB/OL]. arXiv:2510.21862, 2026. Gardella M, Mariño C, Belzarena D, Ramírez I, Randall G, Morel J-M. When Low CER is Not Enough: An Analysis of Hallucinations in Vision-Language OCR Systems on Historical Uruguayan Documents[C]. ICDAR 2026 Workshops (ADAPDA). arXiv:2607.24077, 2026. Lee G G, Ak K E, Mohta J, Xu Y, Dimitriadis D. Do VLMs Read or Rewrite? On Transcription Faithfulness in Vision-Language Models[EB/OL]. arXiv:2607.21617, 2026. Evdokimov M, Ivanov M, Tsiupin D, Tsymboi O, Potapov A, Ivanov A. Closing Cost-Quality Gap in Document VLMs: Difficulty-Aware Data Curation and Quality-Adjusted Deployment Economics[EB/OL]. arXiv:2609.01575, 2026.