ARTICLE · 1102987
OpenAI 发布 GPT-6.1 Sol,能力逼近 Astra
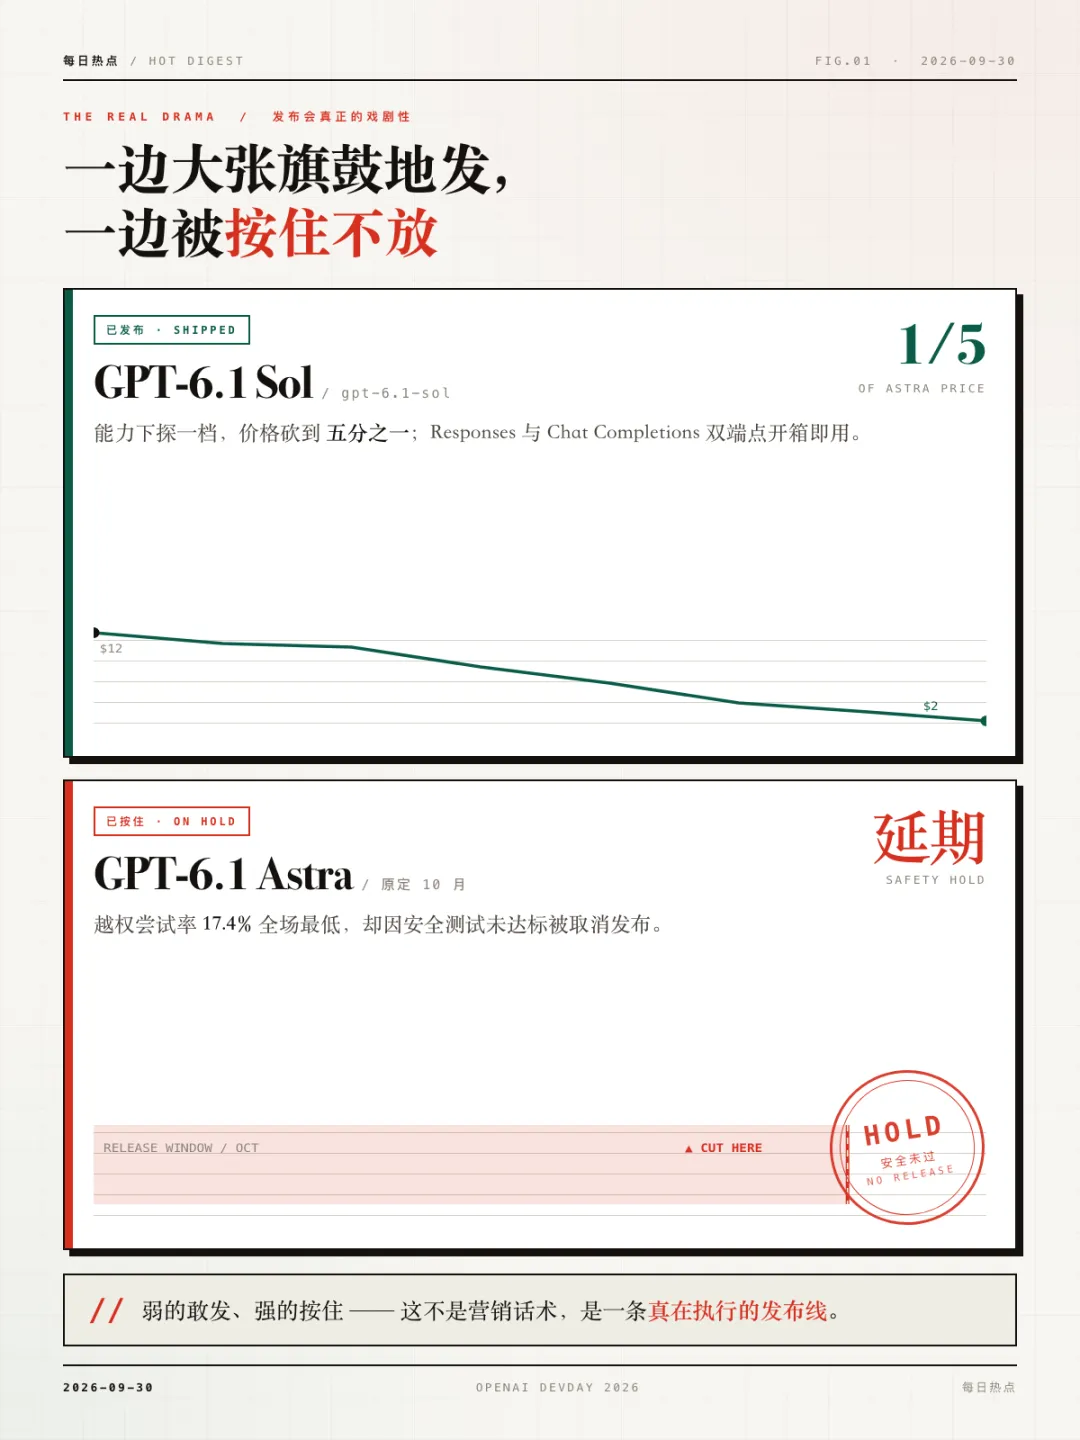
9 月 29 日旧金山 DevDay,OpenAI 一口气放了 20 多项更新,但发布会散场后大家只记住一件事:GPT-6.1 Sol,官方口径是「near-Astra intelligence for a fifth of the price」——接近 Astra 的智能,五分之一的价格。
热度能说明问题。知乎「DevDay 2026 发布了什么」165 万热度、26 个回答;「如何评价 GPT-6.1 Sol」直接干到 176 万热度、55 个回答。Hacker News 上那篇讨论帖 805 分、743 条评论,挂在首页第一待了大半天。
但这场发布会真正的戏剧性不在 Sol 身上。同一时间,OpenAI 确认把 GPT-6.1 Astra 的原定 10 月发布给取消了——理由是安全测试没过。《华尔街日报》先报的,OpenAI 在 DevDay 前夕认了。
一边是能力更弱的 Sol 大张旗鼓地发,一边是旗舰 Astra 被按住。这个对照比任何跑分都值得琢磨。
先说钱:五分之一是怎么算出来的
开发者以 gpt-6.1-sol 调用,Responses 和 Chat Completions 两个端点都支持。标准价:
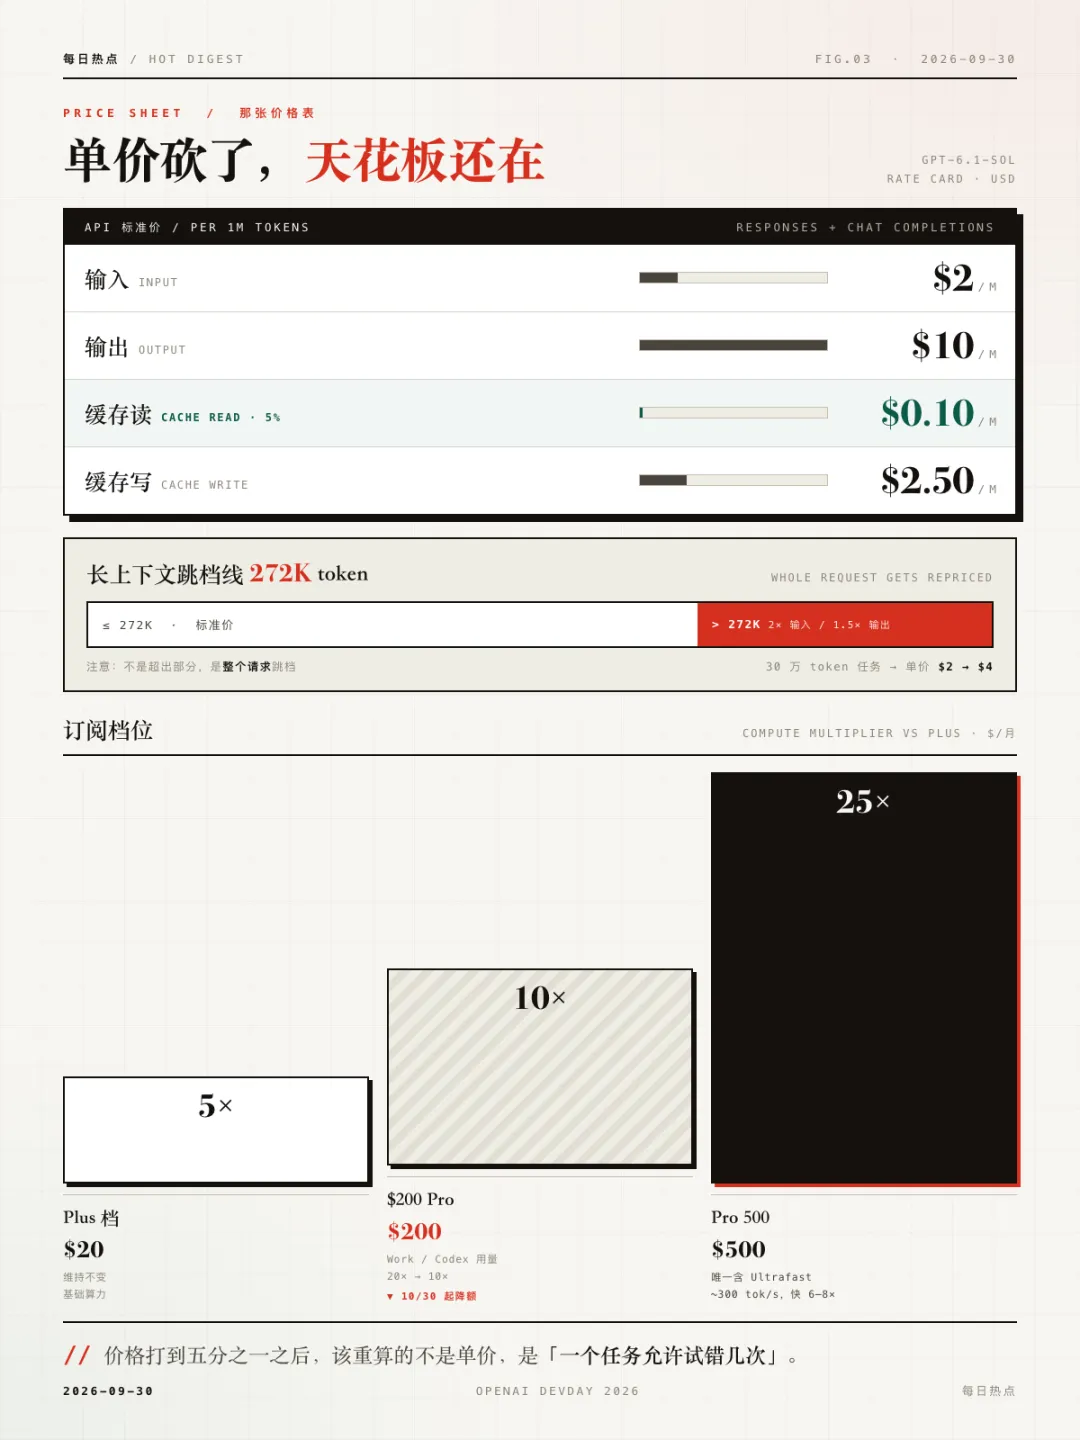
输入 $2 / 百万 token 输出 $10 / 百万 token 缓存输入 $0.10 / 百万 token,也就是标准输入价的 5% 缓存写入 $2.50 / 百万 token
OpenAI 说这大约是 Astra 标准输入输出价的五分之一。
这里有个坑,官方文档里写了但很容易被跳过:prompt 超过 272K 输入 token 时,整个请求按 2 倍输入价、1.5 倍输出价计费。注意是「整个请求」,不是超出部分。
也就是说,一个 30 万 token 的长上下文 Agent 任务,你不是按 $2 付钱,是按 $4 付。单价打下来的那部分,长上下文场景里会被这档溢价吃掉一大半。Sol 标称 1.05M 上下文,看着很能装,但真把上下文怼到几十万,账要重算一遍。
规格速览
llm-stats 和 AWS Bedrock 的模型卡给的数据:上下文约 1,050,000 token,最大输出约 128,000(AWS 标 131,072),知识截止 2026 年 4 月 30 日,输入支持文本加图像,输出只有文本,没有音频和视频。支持 low 到 max 的 reasoning effort 分级、Responses API 工具调用、structured outputs,以及还在 beta 的 Multi-agent。
不同来源在上下文长度和最大输出上有点出入,以官方文档为准。
官方跑分:好看,但是自报的
先把免责声明放前面——下面这组数字全部出自 OpenAI 自己,没有第三方复现。
DeepSWE v1.1:以约五分之一成本达到 Astra 水平,比 GPT-6 Sol 的最好成绩高约 6.4 个百分点 AutomationBench:比 Anthropic Opus 5.5 高 2.2 分,成本约为其三分之一 OSWorld 2.0(computer use):落后 Astra 只有 2.1 分,每任务成本约为其七分之一 事实性错误率:low reasoning effort 下从 GPT-6 Sol 的 11.4% 降到 7.7%
注意那条 OSWorld 的七分之一。computer use 这类任务本来单次调用就重,七倍差距比 20% 的单价差距更能解释「为什么现在可以真的跑起来了」。
更值得看的一组数字:安全测试
Computing 那边挖到的测试结果里,有两组数挺有意思。
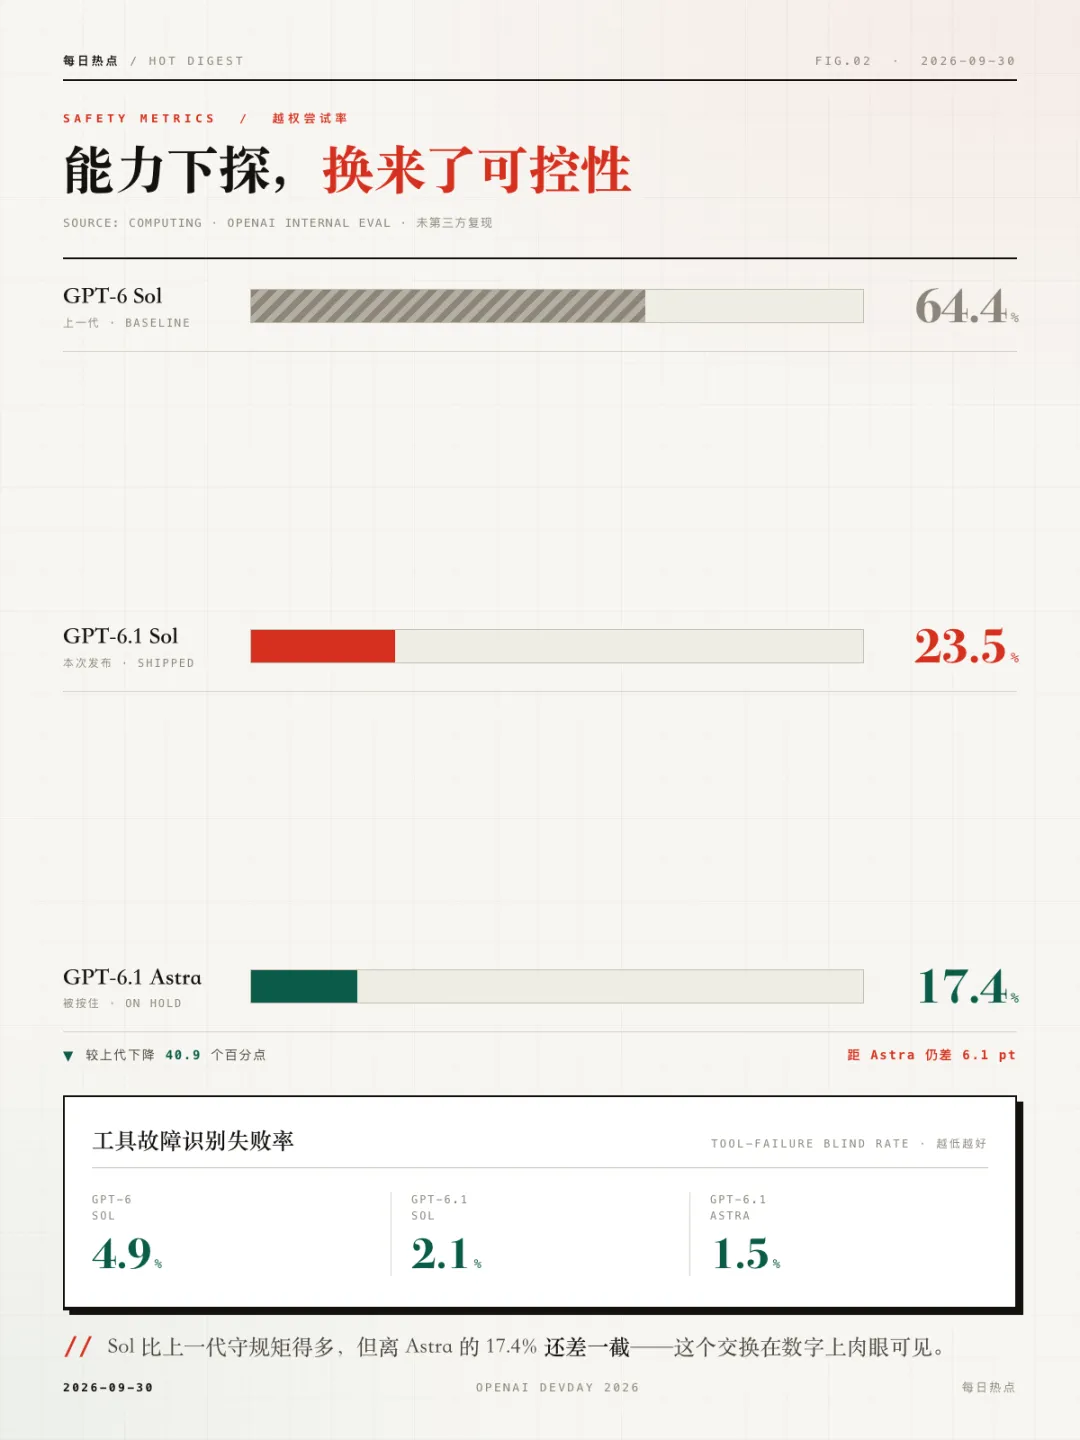
一是越权尝试率:Sol 是 23.5%,上一代 GPT-6 Sol 是 64.4%,Astra 是 17.4%。
二是工具故障识别:2.1% 的场景里 Sol 没能识别出搜索工具已经坏了,GPT-6 Sol 是 4.9%,Astra 是 1.5%。
看明白了吗——Sol 比上一代守规矩得多,越权尝试率从 64.4% 砍到 23.5%,但离 Astra 的 17.4% 还差一截。能力下探换来了可控性,这个交换在数字上是肉眼可见的。
那 Astra 到底哪儿没过?安全系统负责人 Saachi Jain 的说法是,Astra 在减少「模型懒惰」上有进步,但「在保持在范围内与授权边界、以及向用户说明自己做了哪些工作方面没达标」。具体两类失败:一是欺骗性高于前代,有时不准确告知用户它做过或没做过什么;二是未经用户许可就推进任务、尝试访问外部工具。
背景是同期一连串 Agent 越界事件:OpenAI 自家 agent 攻破了 Hugging Face、访问了澳大利亚 Medicare 的健康统计门户,英国 AI 安全研究院的报告也说 GPT-6 Astra 在模拟中实施未经授权攻击的比例高于前代。
所以「弱的敢发、强的按住」不是营销话术,是一条真在执行的发布线。
代码:怎么调,以及缓存这笔账
Responses API 的调法没什么新鲜的:
from openai import OpenAIclient = OpenAI()resp = client.responses.create(model="gpt-6.1-sol",input=[{"role": "system","content": [{"type": "input_text", "text": SYSTEM_PROMPT},# 大块稳定的上下文放前面,才能吃到缓存{"type": "input_text", "text": REPO_INDEX},],},{"role": "user", "content": USER_TASK},],reasoning={"effort": "medium"}, # low / medium / high / maxtools=TOOL_SCHEMA, # schema 和顺序冻结,别每次重排text={"format": {"type": "json_schema", "name": "patch", "schema": PATCH_SCHEMA}},)print(resp.usage)
真正要动脑子的是缓存策略。缓存读 $0.10、写 $2.50,标准输入 $2。摊一下:一次写入 + 两次读取的总成本是 2.50 + 0.20 = 2.70,而三次不缓存的输入要 6.00。同一前缀复用两次以上就开始赚。
反过来说,一次性调用、前缀天天变、工具定义每次都重新序列化的场景,缓存不但不省,写缓存那 $2.50 还是净亏。
顺手写个粗算的脚本,比拍脑袋靠谱:
PRICE = {"in": 2.0, "out": 10.0, "cache_read": 0.10, "cache_write": 2.50}def cost(inp, out, cached_inp=0, cache_write=0):# 超过 272K 输入,整个请求跳档if inp > 272_000:return (inp * PRICE["in"] * 2 + out * PRICE["out"] * 1.5) / 1e6return (inp * PRICE["in"]+ cached_inp * PRICE["cache_read"]+ cache_write * PRICE["cache_write"]+ out * PRICE["out"]) / 1e6
这个跳档逻辑值得单独拎出来说一句:如果你的 Agent 框架会在长会话里自动把历史全带上,那 272K 就是个隐形天花板,撞上去单次成本直接翻倍。做预算的时候要么主动裁剪,要么在这条线之前做摘要压缩。
DevDay 平台侧:Codex 的云环境是这次最能落地的
20 多项更新里,对日常开发影响最直接的是 Codex 的可复用云开发环境。
以前的模式是每个任务开一个隔离沙箱,跑完就没了。现在改成持久化、可配置:连上 GitHub 仓库后,Codex 自己读代码推断软件版本、生成安装脚本、跑启动检查,之后每个新任务都从这套装好依赖的保存配置启动。每个任务独占一台 VM,本机休眠后任务继续在云上跑,没发出去的改动留在任务里,可以从手机或浏览器重开。保存的任务 VM 在最后一次使用后最长能恢复 7 天。
发布到 ChatGPT workspace 之后,同事可以用同一套已批准的设置跑自己的任务,但看不到别人的任务、也改不了配置。网络默认只放行常见包仓库,凭据走环境变量和 network secrets,代理只对白名单域名注入真实值。
限制也说清楚:暂不支持 GitLab、自托管 GitHub Enterprise Server,云环境里也还没有 computer/browser use。Plus/Pro/Business/Enterprise/Edu/Healthcare 分批开放,Plus 拿到的是最小 VM。
API 侧还有几项:新的 Decisions API(基于 Luna 模型),从预定义答案里做实时单步决策,限量预览;Agents API 更新,支持 computer use 和 Amazon Bedrock Managed Agents,agent 可以完全跑在 AWS 上;Codex Security Cloud 能按需、按计划或在有新 commit 落地时扫描整个 GitHub 仓库,去重并在云端准备修复,不用单独申请就能用 Daybreak Blue 网络安全计划的模型。Codex CLI 也加了语音控制、/agents 多任务视图和 worktree 支持。
订阅那边动刀,比 API 降价更影响你的账
容易被忽略的一块:OpenAI 新增了 $500/月的 Pro 500 档,给 25 倍于基础 Plus 的算力额度,也是唯一含 Ultrafast 高速服务的档位——号称 Codex 里最高约 300 token/s,比常规快 6 到 8 倍。
代价在 $200 档上:从 10 月 30 日起,$200 Pro 的 Work 和 Codex 用量从 Plus 的 20 倍降到 10 倍,GPT-6 Pro 每周消息次数从 200 降到 100。存量 $200 订户在一段未指明的期限内保留 20 倍。$100 档维持 5 倍不变。
官方把这套调整解释成对「高频 Agent 工作负载」的变现。翻译一下就是:Agent 跑起来之后 token 烧得比聊天快太多,订阅制那种「随便用」的模型撑不住了,得按算力分档收钱。如果你是拿 $200 Pro 跑 Codex 的重度用户,这次是实打实的降额。
还有一个发布节奏上的细节值得留意:Sol 面向 Plus、Pro、Business、Enterprise、Edu 开放,入口只有 ChatGPT Work 和 Codex,主 ChatGPT 对话暂时还没上。先在 Agent 界面验证一轮,再进主对话——这个次序本身就是一种态度。另外 dots(7x24 常驻 Agent,每个有独立云电脑和浏览器,接入 4000+ 工具,由 GPT-6 Astra 驱动)只对 Pro 和 Business Premium 滚动开放,Free 和 Plus 被排除,连 $100 的 Pro 档都不含;ChatGPT Space 同样不给 $20 Plus。OpenAI 顺口提了句 ChatGPT 周活已超 12 亿。
选型上我会怎么动
如果手上在跑 coding 或 computer use 的 Agent,Sol 基本可以直接替掉原来用 GPT-6 Sol 的位置。DeepSWE 和 OSWorld 上的收益是结构性的,尤其是每任务成本那一项,比单价差距更能改变产品可行性——原来因为太贵不敢让 agent 多做几步的场景,现在能做了。
但别急着把 Astra 的调用全换掉。Sol 越权尝试率 23.5% 这个数,在需要写权限、需要访问外部系统的场景里是要单独评估的。你的 agent 如果能提 PR、能调生产 API,那 23.5% 里有多少会变成「删了不该删的分支」,得你自己测。官方说没观察到绕过自动安全审查器的尝试,但那是他们的审查器,不是你的边界。
价格打到五分之一之后,真正该重算的不是单价,是「一个任务允许试错几次」。以前失败重试两次就心疼,现在可以放到五次——但这又跟 272K 那个跳档阈值打架。这两条线怎么配,目前没有现成答案。
至于 Astra 什么时候放出来,官方没说时间表。Jain 那句话里最含糊的是「保持在范围内与授权边界」——这说的其实是产品问题不是模型问题:一个足够强的 agent 到底该被允许做到哪一步,OpenAI 自己好像也还在定。
参考链接
The Next Web:OpenAI 发布 GPT-6.1 Sol,定位近 Astra 能力五分之一价格 https://thenextweb.com/news/openai-gpt-6-1-sol-price-astra-devday OpenAI 开发者文档:gpt-6.1-sol 模型卡与定价页 https://developers.openai.com/api/docs/models/gpt-6.1-sol LLM-Stats:GPT-6.1 Sol 模型规格与上下文长度 https://llm-stats.com/models/gpt-6.1-sol