ARTICLE · 1102984
让 AI 连续工作半小时,难的不是多想一会儿
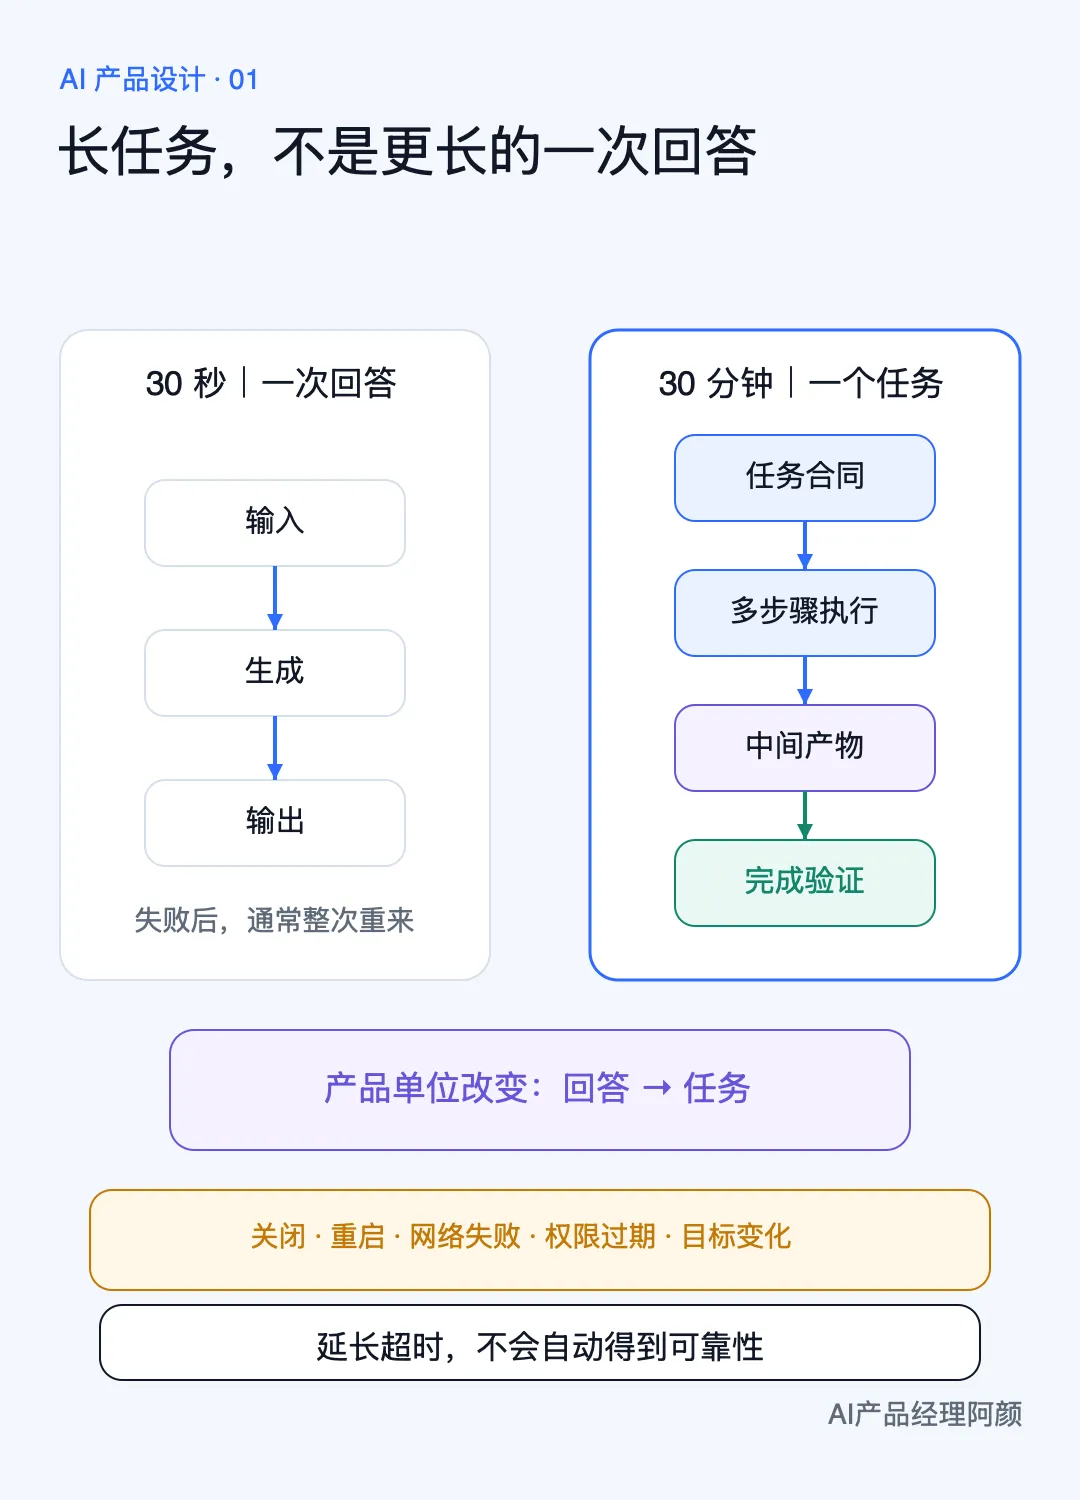
如果一次 AI 任务只需要 30 秒,失败之后重新点一次,通常还能接受。
但如果它要连续工作半小时呢?
它可能要搜索几十个页面、读取多份文件、调用多个工具、生成中间产物,再等待人确认后继续。此时浏览器可能被关掉,网络可能波动,工具可能超时,Worker 可能重启,权限可能过期,用户也可能中途改变目标。
这时,产品面对的已经不是“怎样让模型多想一会儿”,而是另一个问题:
怎样让一项工作在不连续的运行环境中,仍然保持连续?
答案不是把超时时间从 60 秒改成 30 分钟。
当任务进入半小时、数小时甚至跨天尺度,产品的基本单位必须从一次 请求,升级为一个可恢复、可观察、可停止的 任务。
一、长任务不是更长的一次回答
聊天产品最自然的交互单位是“一问一答”:用户发送输入,模型返回输出,任务结束。
长任务却不是这样。它更像一个会经历多种状态的工作对象:
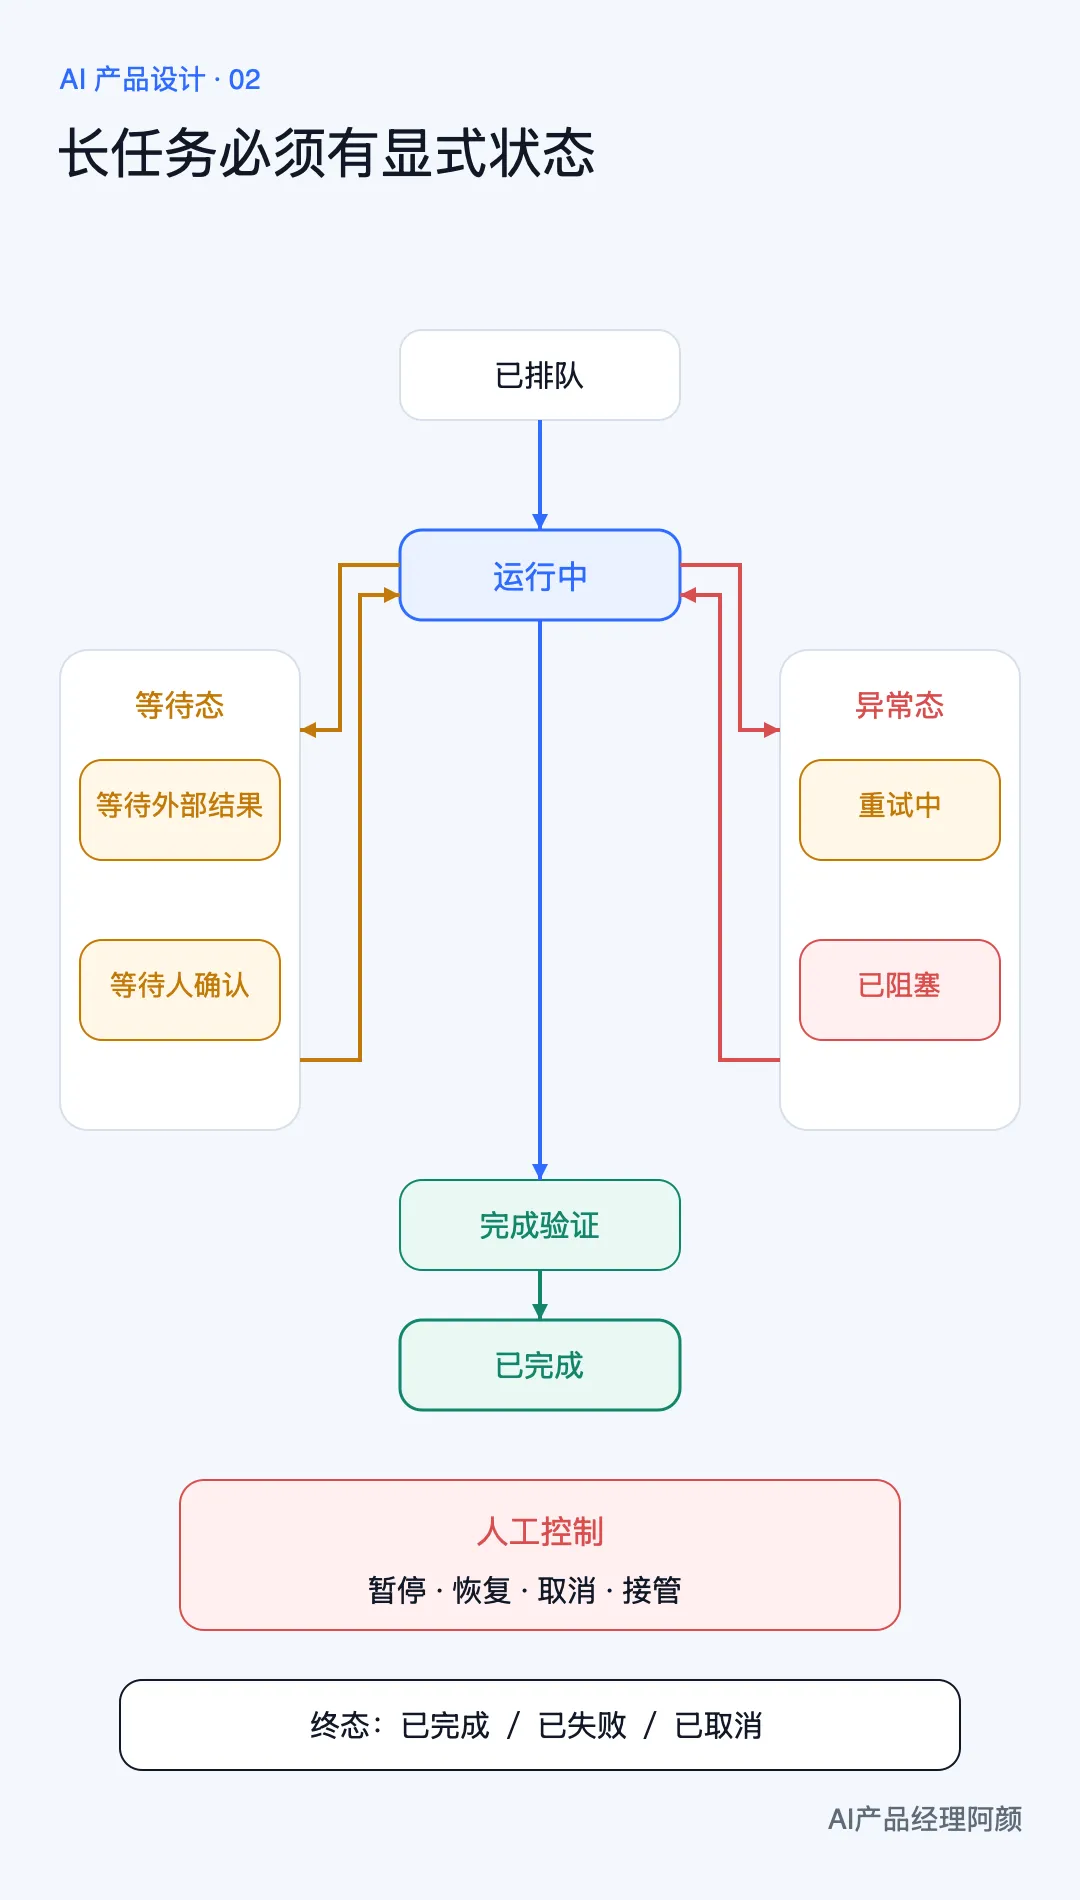
已排队 → 运行中 → 等待外部结果 → 等待人确认
↓
重试中
↓
已完成 / 已失败 / 已取消 / 已阻塞
这个差别很重要。
一次回答失败,用户关心的是“为什么没有答案”;一个长任务失败,用户还会追问:
已经完成了哪些步骤? 中间产物还在不在? 失败前最后一个可靠状态是什么? 可以从哪里恢复? 重试会不会把已经完成的动作再做一遍? 任务还会消耗多少时间和预算? 我现在能不能暂停、取消或接管?
如果产品回答不了这些问题,它只是一个运行时间更长的黑盒,不是一个可靠的长任务系统。
二、第一项新增设计:把任务状态做成产品对象
很多 AI 产品只显示两个状态:生成中 和 已完成。
这对长任务远远不够。
至少需要区分:
- Queued
:任务已接收,但还没有获得执行资源; - Running
:正在执行某个明确步骤; - Waiting
:等待外部系统、时间窗口或人类输入; - Retrying
:某个可重试步骤失败,正在按策略重试; - Blocked
:缺少权限、证据或必要输入,不能自行继续; - Completed
:完成条件已被验证,而不只是模型说“做完了”; - Failed
:达到失败条件,系统不会继续自动推进; - Cancelled
:用户或控制系统已要求停止。
状态和进度也不能混为一谈。
“运行中”是状态;“已检查 12 个来源,其中 8 个满足时间要求,下一步准备核对冲突证据”才是进度。
前者告诉用户系统还活着,后者才让用户判断它是否在接近目标。
因此一个长任务页面不应该只放旋转图标。它至少要显示:当前步骤、最近一次可靠更新、已生成产物、遇到的阻塞、下一步动作,以及剩余时间为什么仍然未知。
三、第二项新增设计:把上下文和持久状态分开
长任务最常见的误区,是把模型上下文当成任务内存。
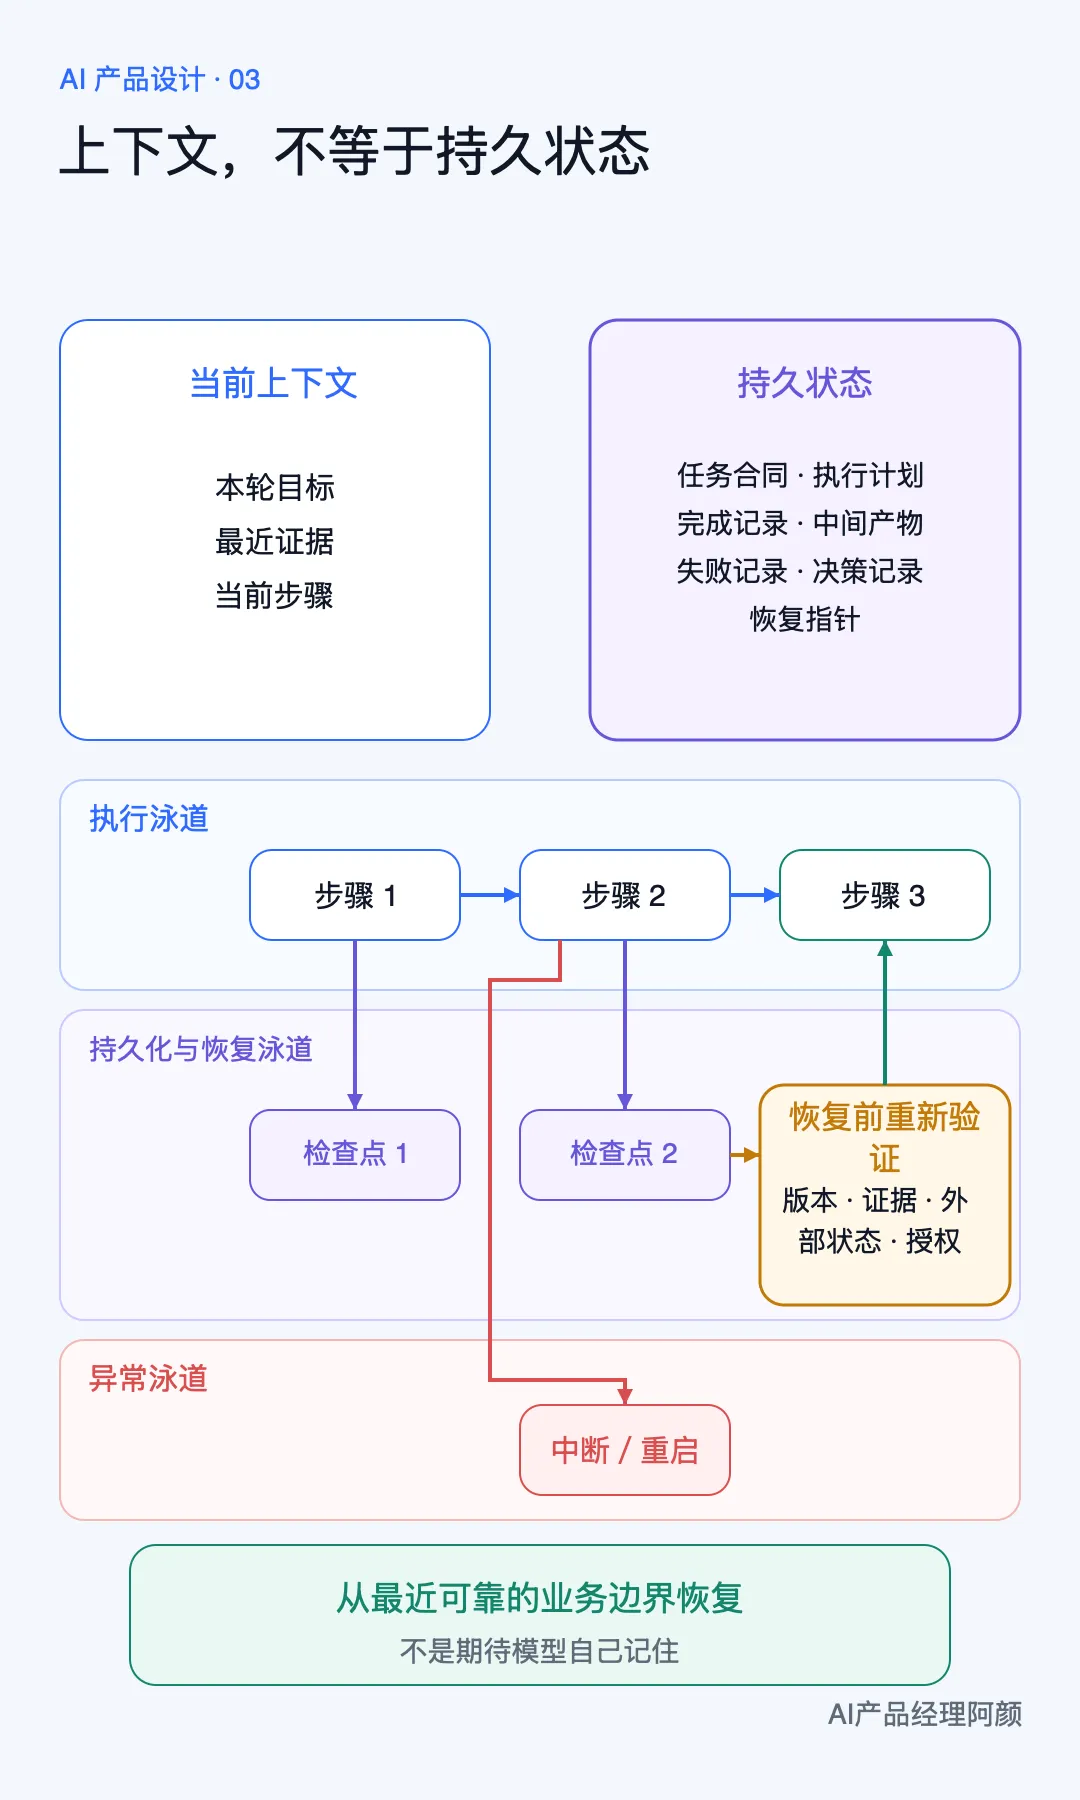
上下文适合承载“这一刻模型需要看到什么”,但它不应该成为任务唯一的事实来源。
进程会重启,会话会切换,上下文会压缩,模型也可能遗漏早先信息。Anthropic 在长时间 Agent 实验中记录过类似问题:新的会话并不会天然知道上一段工作发生了什么,因此需要进度文件、功能清单和版本记录,把工作状态留给下一次执行。
长任务至少应把以下内容外部化:
- 任务合同
:目标、范围、完成标准、禁止事项; - 执行计划
:当前步骤、依赖关系、下一步候选; - 已完成工作
:哪些步骤通过了验证; - 中间产物
:文件、数据、草稿、来源与版本; - 失败记录
:试过什么、为什么失败、是否允许再试; - 决策记录
:谁在何时接受、拒绝或修改了什么; - 恢复指针
:下一次从哪个检查点开始。
这就是检查点的意义。
检查点不是“每隔五分钟保存一段对话”,而是在一个具有业务意义的边界上,保存可验证的状态。例如:来源集合已经冻结、草稿已经生成但尚未审核、外部写入已经获得回执。
LangGraph 的文档把检查点放在节点边界;Anthropic 的长任务实践则使用进度文件和版本历史让下一段会话快速恢复。它们实现不同,但共同说明了一件事:
长任务需要可被下一次执行读取的外部事实,而不是期待模型自己记住。
四、第三项新增设计:重试必须和幂等一起设计
网络失败后自动重试,看起来是可靠性的基本功能。
但重试并不总是安全。
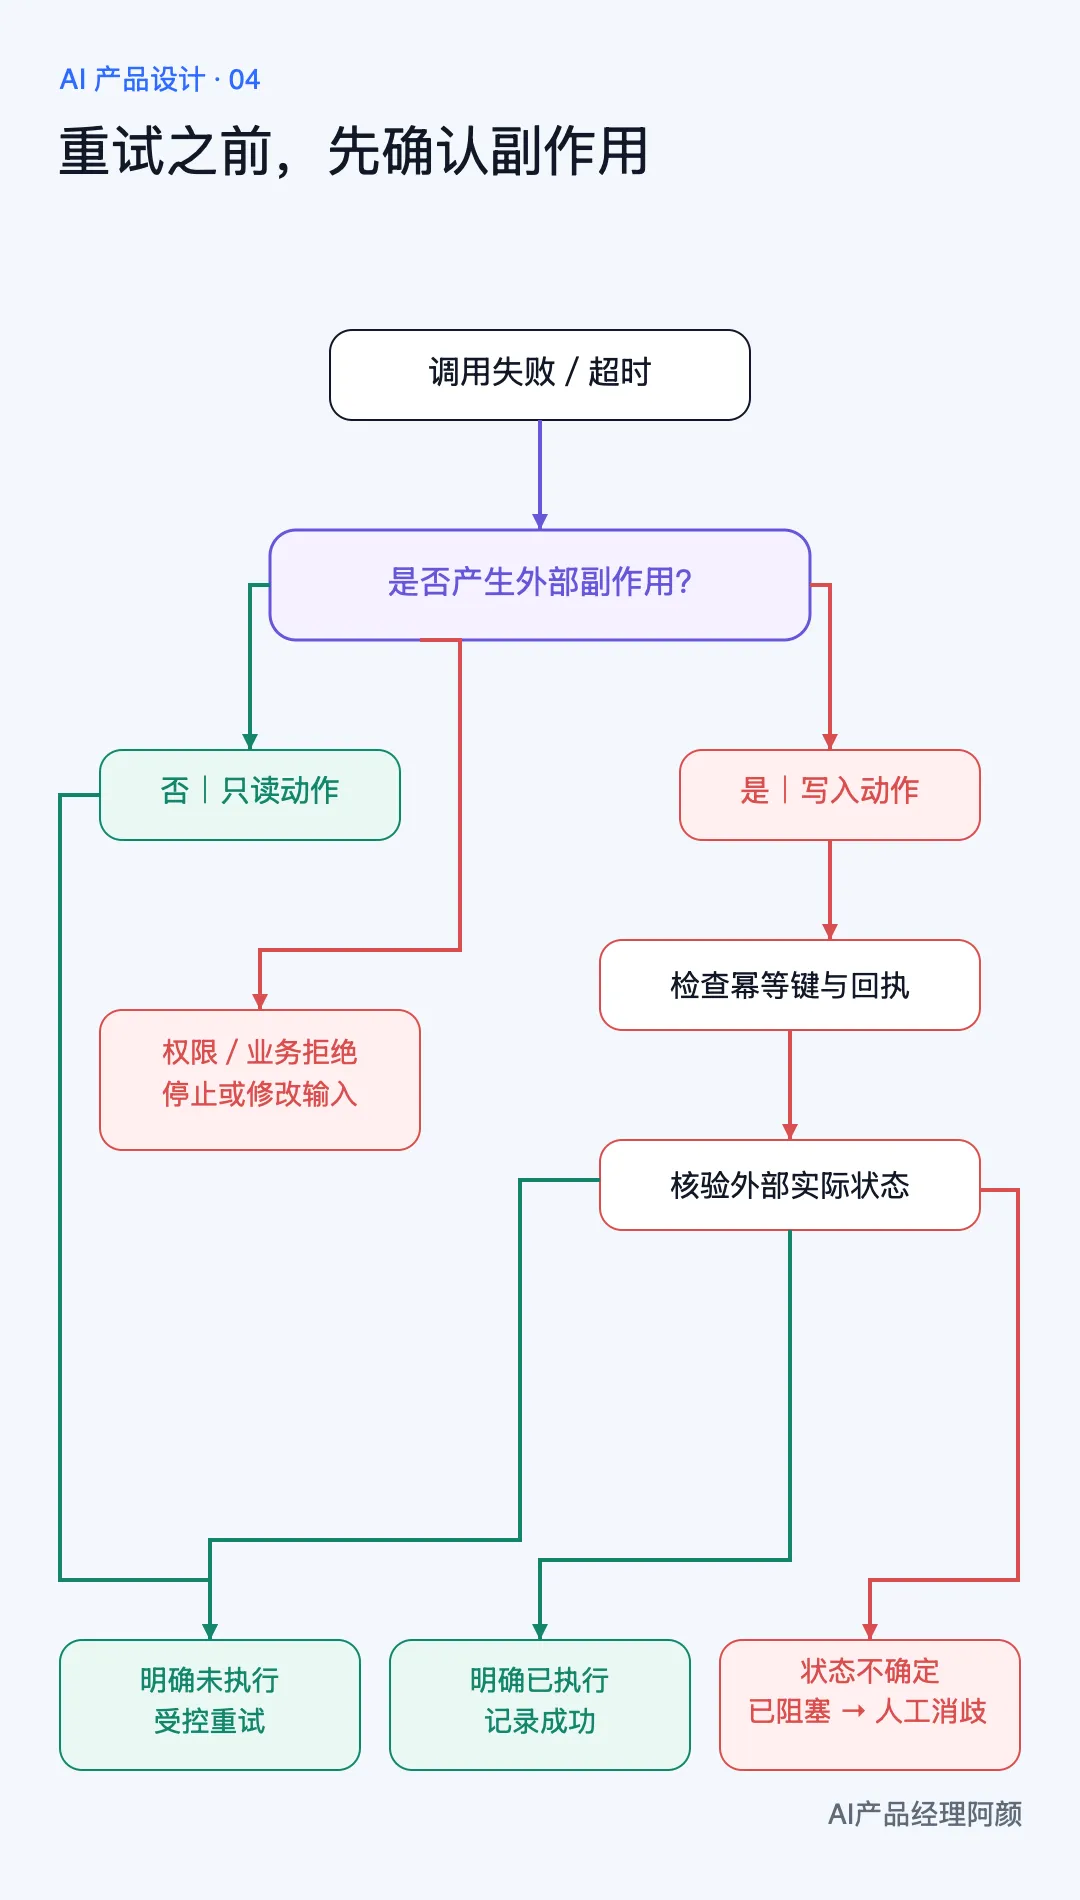
假设 Agent 调用工具发送了一封邮件。工具其实已经发送成功,但在返回结果前网络断开。如果系统只看到“超时”,然后再次调用发送工具,用户会收到两封邮件。
支付、下单、发布、创建工单、修改数据库,也有同样的问题。
所以产品不能只问“失败后要不要重试”,还要问:
如果这一步实际上已经成功,再执行一次会发生什么?
只读搜索通常可以重复;有外部副作用的动作则需要幂等设计。常见做法包括:
为一次业务动作分配稳定的幂等键; 保存工具调用请求、外部对象 ID 和成功回执; 重试前先查询外部系统的实际状态; 把“准备执行”和“已经执行”分成不同记录; 结果无法确认时进入 阻塞,交给人消歧,而不是盲目再做一次。
Temporal 的长流程示例也强调:工作流负责保存计划和状态,外部副作用由可超时、可重试的活动执行;系统恢复时,应识别已经完成的步骤,避免因为后续失败而重新支付前面的成本。
这意味着重试策略不是一个统一数字。搜索失败可以重试,写入超时可能要先核验,权限拒绝不应自动重试,业务规则拒绝则需要修改输入。
五、第四项新增设计:预算不只有 Token
任务运行越久,消耗越容易被隐藏。
很多产品只设置 最大token消耗数,但长任务至少有七种预算:
- 时间预算
:最多运行多久、等待多久; - 模型预算
:最多消耗多少输入、输出与推理 Token; - 工具预算
:最多搜索、抓取、运行或写入多少次; - 成本预算
:模型、数据、计算和第三方服务的总费用; - 重试预算
:同一步骤最多重试多少次; - 证据预算
:信息多旧之后必须重新验证; - 权限预算
:授权适用于什么对象、持续多久、何时过期。
预算不是为了让任务更早失败,而是为了让系统知道何时应该停下来重新判断。
一个成熟的长任务在触及预算时,不应该偷偷降低质量,也不应该无限继续。它应当输出:已完成什么、还缺什么、继续需要多少资源,以及是否需要 人为介入。
停止条件同样应在任务开始前定义。Anthropic 的 Agent 设计建议把最大迭代次数等停止条件放进系统控制,而不是等模型自己决定什么时候够了。
六、第五项新增设计:把人类控制放进运行时
很多产品只在任务开始前让用户点击一次“确认”。
但长任务执行期间,现实会变化:目标被修改,来源失效,成本上升,外部系统返回意外结果,或者用户已经不再需要这项工作。
因此长任务至少需要五个控制动作:
- Pause
:在安全边界暂停,不再启动新步骤; - Resume
:重新检查版本、权限和外部状态后继续; - Cancel
:停止后续步骤,并说明哪些副作用已经无法撤回; - Take over
:把当前上下文、产物和待决问题交给人处理; - Approve / Reject
:只对一个精确对象和下一步动作生效。
这里最容易被忽略的是:暂停和取消不是同一个动作。
暂停意味着未来可能恢复,所以要保存恢复条件;取消意味着终止目标,但仍要处理已经发出的请求、正在运行的工具和不可逆的外部副作用。
同样,恢复也不能只是把进程重新启动。恢复前要检查:输入版本有没有变、证据是否过期、外部对象是否已被修改、授权是否仍然有效。
否则系统虽然从技术检查点继续了,业务世界却已经不是原来的世界。
七、一个最小可行的长任务产品
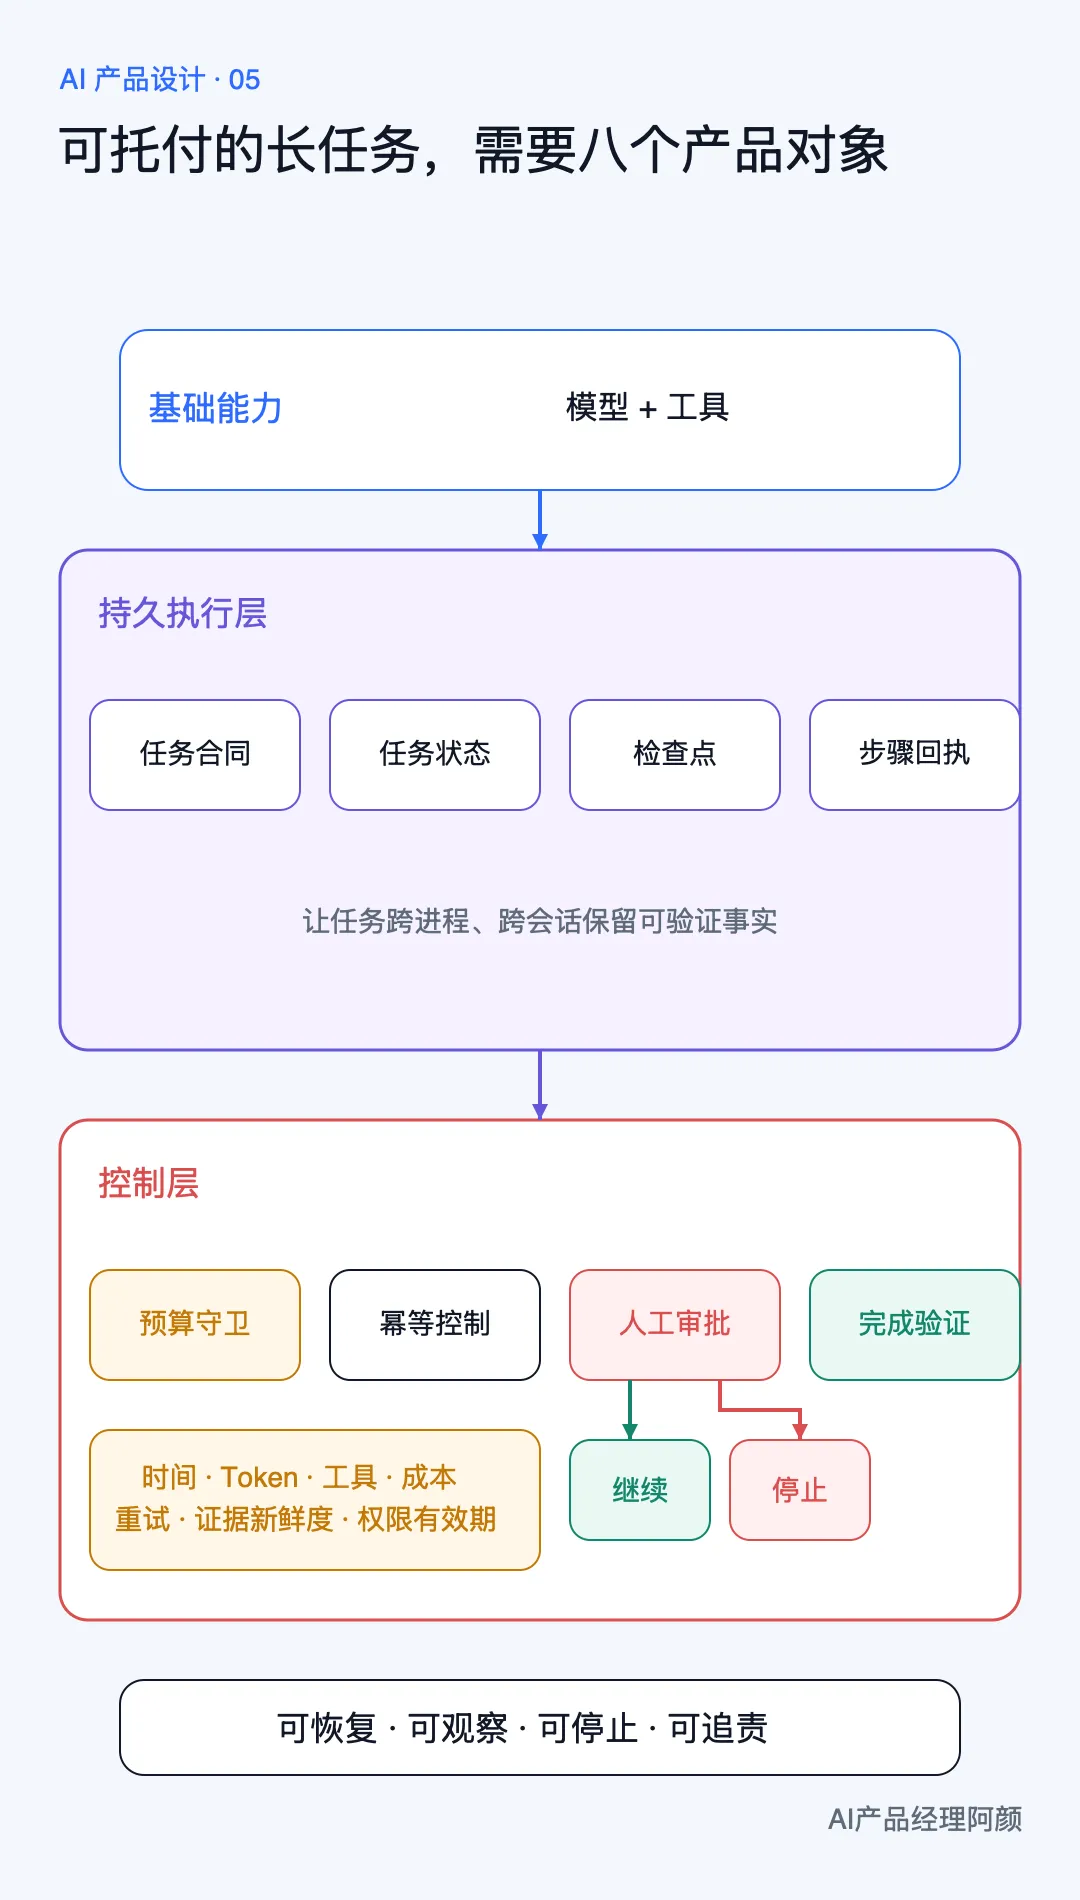
如果把上述原则收敛成最小版本,一个 支持长运行时间的 Agent 至少需要八个对象:
- Task Contract
:目标、范围、完成标准与禁止事项; - Job State
:排队、运行、等待、重试、阻塞、完成、失败、取消; - Checkpoint
:在业务边界保存状态、产物和恢复指针; - Step Receipt
:每一步的输入、输出、版本、时间和外部回执; - Budget Guard
:时间、成本、工具、重试、证据与权限预算; - Idempotency Control
:确保重试不会重复制造副作用; - Human Gate
:暂停、接管和精确授权高影响动作; - Completion Verifier
:依据完成标准验收,而不是接受模型的自我声明。
可以把它写成一条产品公式:
Long-running Agent = Model + Tools + Durable State + Checkpoints + Idempotent Execution + Budgets + Observability + Human Control
模型和工具决定系统能做什么;后面这些机制决定它能否可靠地做完,以及出了问题能否停下、恢复和追责。
八、产品经理要问的十个问题
当团队说“让 Agent 在后台跑半小时”时,可以先问:
用户提交的是一次请求,还是一个具有唯一 ID 的任务? 任务有哪些明确状态,等待中 和 阻塞中 怎样区分? 用户能看到真实进度,还是只看到一个不断旋转的图标? 进程或会话丢失后,哪些外部状态可以让任务恢复? 检查点位于哪些业务边界,恢复后会重复多少工作? 哪些步骤可安全重试,哪些步骤需要幂等键和回执? 时间、Token、工具、成本、重试和权限预算分别是多少? 哪些情况必须暂停并请求 Human Gate? 用户如何暂停、取消、接管和恢复? 谁验证任务真的完成,而不是模型宣布完成?
如果第 4、5、6 题答不清,任务还不可恢复;如果第 7、8、9 题答不清,任务还不可控制。
结尾
当 AI 只工作几十秒,我们容易把它当成一个更聪明的输入框。
当 AI 连续工作半小时,产品就必须开始像设计一个运行系统那样设计它:状态要持久,进度要可见,步骤要能恢复,重试要避免副作用,预算要有上限,人要能随时暂停和接管。
所以,长任务 Agent 的分水岭不是“能运行多久”,而是:
中断之后能否继续,重复执行是否安全,消耗是否有界,人是否始终拥有停止权。
把超时调长,只会得到一个更久的黑盒。
把任务、状态、证据、预算和授权做成产品对象,才会得到一个真正可以托付工作的 Agent。