ARTICLE · 1105459
OpenAI推出常驻助手Dots,微软开放Quine研究申请
OpenAI推出常驻助手Dots,微软开放Quine研究申请
早上好。读完今天几份公告,我最在意一个变化:越来越多的 AI 产品希望在人离开对话框以后继续工作。它们接下来能做什么、什么时候该停,开始和回答得好不好一样重要。 今天从常驻助手、编码模型和生物研究三个方向看这件事,再补上十二条产品与工程简讯。以下是公开资料观察,未将厂商演示写成亲测。 9 月 29 日,OpenAI 发布 Dots,由 GPT-6 Astra 驱动,拥有独立云端电脑。它被设计成可以持续跟进目标的助手,用户能够查看工作过程,也能在 ChatGPT、Slack 和 Teams 中与它交流。 让我停下来细读的是后台行为的限制。官方把未与用户主动协作时的后台探索称为主动研究,这一阶段使用只读工具,不能借此发送消息、修改应用内容或操控电脑。这和用户明确交办任务后的执行,需要分开理解。 用户可通过规则允许、拦截或要求审批特定动作;涉及账户或信息分享的动作还会经过自动审查。官网仍提醒,重要工作需要复核。所谓全天候,并不意味着每个动作都已经得到授权。 Dots 正向符合地区条件的 Pro 和 Business Premium 用户推出;Enterprise、Edu 与 Healthcare 的测试需要管理员开启。专业岗位用途的 specialist dots 另处于定向企业试点,不能把两种开放范围混为一谈。 从写程序的角度看,我会优先观察它如何留下记录:读过什么、改了什么、哪里等待决定。一个持续工作的助手,最好也让人随时能接回来。真正值得尝试的起点,可以只是盯住一个项目的变化,再交一份有依据的待办。 🔗 来源:OpenAI OpenAI 同日发布 GPT-6.1 Sol。标准 API 定价为每百万输入 token 2 美元、缓存输入 0.10 美元、输出 10 美元。官方所说的 Astra 五分之一价格,指标准输入和输出单价,不等于任何任务的最终账单都打两折。 此次开放范围是 API,以及 Plus、Pro、Business、Enterprise、Edu 用户的 ChatGPT Work 和 Codex。普通 Chat 暂未提供。公告中的 Sol Ultrafast 仍是即将推出,也不能直接算进今天的可用能力。 官方评测显示,它在部分编码、电脑操作和专业工作任务上接近 Astra;这些是厂商报告的特定测试结果。科研测试中,Astra 仍拿到所测模型的最高分,所以“接近”不适合改写成“全面替代”。 对日常工作,我更想核对每个完成任务的成本:重试了几次、有没有漏掉检查、最终还要人修多久。缓存价格对重复读取上下文的工作有吸引力,但能不能省钱,仍要把真实任务跑完再算。 🔗 来源:OpenAI 微软研究院 9 月 29 日介绍 Quine,并开放首批 Quine Fellows 申请。它把生物学世界模型与研究工具、文献和科学家的工作流程连接起来,尝试在实验之前提出和筛选值得验证的方向。 微软披露,与 Broad Institute 研究人员的合作涉及胰腺癌细胞状态研究。系统用于优先筛选化合物,部分排名靠前的候选在湿实验中得到了验证。这里验证的是特定实验现象,不能写成治愈癌症、药物上市或临床疗效。 Quine 目前是实验性研究技术,只面向研究,不用于临床或医疗。初期使用限于 Fellows 项目和选定的科研合作;输出可能不完整或不准确,需要合格研究人员审查与实验验证。 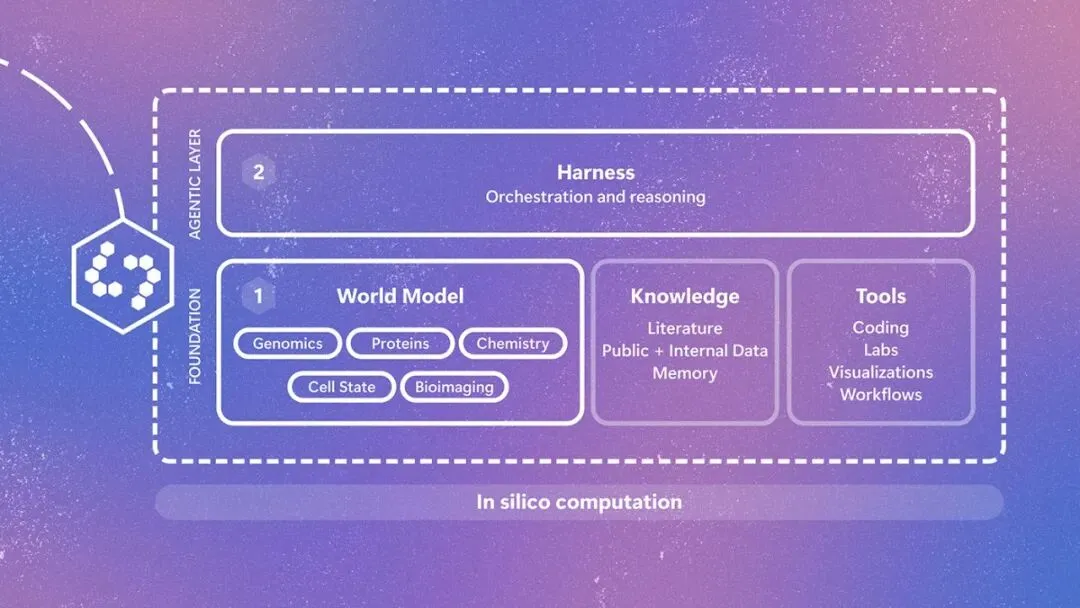
这条消息吸引我的地方,是实验结果仍然有权否定模型。建议再流畅,也要交回真实世界检查。把问题范围缩小、让有限的实验资源用在更值得测的地方,已经是一个足够具体、也更适合观察的目标。 🔗 来源:Microsoft Research 9 月 29 日,NVIDIA 发布 Kumo Tabular,提供三种规模的模型和开源运行库,用带标签的表格行作为上下文,对新行做分类或回归预测。商业使用适用 OpenMDW-1.1 许可。 官方说明,超出训练范围或新数据分布改变时,准确性可能下降。训练配方与人工数据生成器仍计划后续发布;开放权重和运行代码,不应写成全部训练材料已经开放。 🔗 来源:NVIDIA(Hugging Face) 9 月 29 日的 DevDay 更新包括新版云端工作流程:准备并发布项目环境后,可以复用仓库、依赖和工具配置,每个任务保有独立工作区,电脑休眠时任务也能继续。 官方文档把审阅改动、检查结果与提交代码留作后续步骤。对团队而言,环境准备也成为可复用的工作;任务在云端跑完,仍需要核对它交付了什么。 🔗 来源:OpenAI 同日推出的 ChatGPT Space 将共享知识与 Pages 放在一起,支持团队成员和 AI 围绕同一页面协作。可用套餐为 Pro、Business 与 Enterprise。 发布时,网页端和桌面端支持创建、编辑页面;手机端主要用于查找、阅读和分享。协作幻灯片、表格与移动编辑仍有待后续推出,已有文件存放能力不等于这些新协作功能都已就绪。 🔗 来源:OpenAI DevDay 宣布 Plugin Extensions,开发者可给插件增加侧栏入口、对话旁的操作面板和文件查看器。插件因此有了更完整的操作界面,不只在对话里返回结果。 细读开发文档还有范围差异:Free、Go 用户的网页插件扩展标为即将推出,输入框中的内容提及仅限桌面应用。采用功能时,应以具体端和套餐的说明为准。 🔗 来源:OpenAI Developers OpenAI 9 月 29 日宣布 Decisions API,针对预先定义、答案范围有限的问题,利用 Luna 处理分类、请求分流或智能体下一步选择。输入可包括文字或图片。当前是有限预览,官方计划随后扩大开放,尚不应按全面可用介绍。 🔗 来源:OpenAI 此次发布的 Meetings 插件可生成个性化摘要和行动项,保存到 ChatGPT Space。首发测试版面向 macOS 桌面应用上的 Pro 与 Business 用户。 帮助文档写明,Windows、iOS 和 Android 支持尚待推出,Enterprise 也未全面开放。它适合被理解为会议后的材料入口;摘要中的决定和待办,仍要由参会人确认。 🔗 来源:OpenAI Help Center GitHub 9 月 29 日更新 Dependabot:仓库管理员现在可以为版本更新和安全更新配置运行器类型,以及可选的自定义标签与运行器组。这是在组织级配置基础上的进一步细化,让不同仓库的依赖更新任务可以放在各自合适的执行环境中。范围限于 github.com 的私有和内部仓库,公开仓库及 Enterprise Server 不提供该入口。 🔗 来源:GitHub GitHub 9 月 29 日推出外部自定义属性公开预览,用于把外部系统管理的仓库元数据带进 GitHub。官方示例把部署频率、重要性和生命周期等属性展示为由外部系统管理的只读信息。 这种分工有助于辨认信息归谁维护:读代码的人能看到背景,数据的维护入口仍留在原系统,避免同一属性在不同工具里被随手改成不同版本。 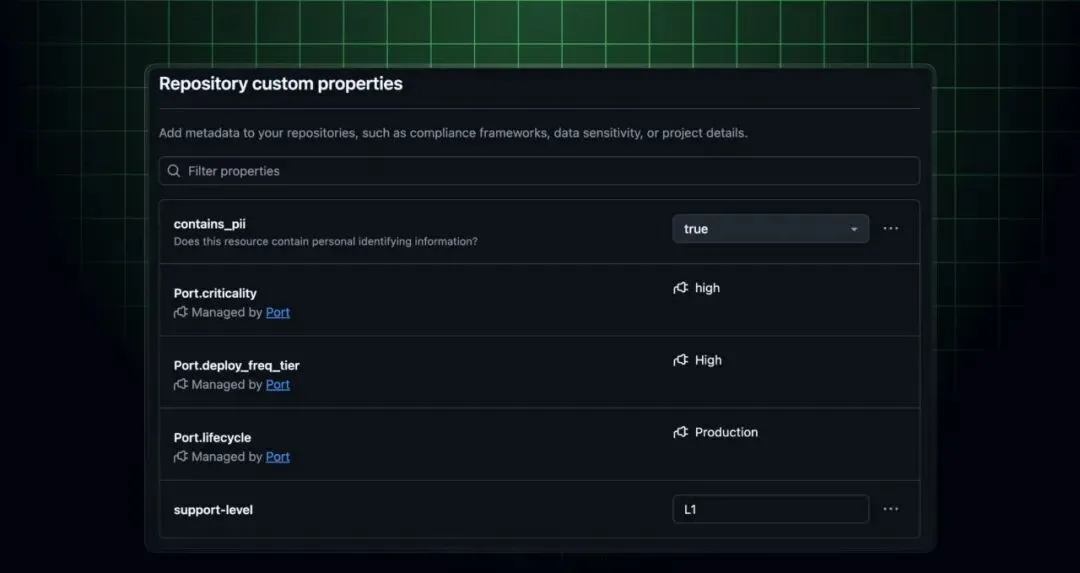
🔗 来源:GitHub Sarvam 9 月 29 日发布从基本原理讲解智能体的指南,用商店客服贯穿模型、工具和循环执行过程。它特别说明:模型提出工具请求,真正查询系统、执行函数的是外围代码。 这是一篇新发布的教学材料,不是新模型或新服务上线。对刚接触智能体的人,这个区分很实用:回答里说做了某件事,与程序实际完成了操作,要靠执行结果连接起来。 🔗 来源:Sarvam AI OpenRouter 9 月 30 日的工具调用测试教程,把选错工具和传错参数分开处理,介绍模型裁判、确定性参数检查及调用轨迹比较。 这里的价值是让错误更容易定位:工具名对了,并不代表订单号、金额或调用顺序也对。文章属于测试方法介绍,没有证明某个模型能在真实业务里免检运行。 🔗 来源:OpenRouter 同日发布的回归测试教程建议固定用例、具体模型版本与配置,检查行为是否仍符合约定。文章复盘了一次测试自身的问题:只看模型第一步查询订单,就误判它没有继续处理。 完整工具循环才能测到后续决策。文中运行结果属于 9 月 7 日的有限样例,不能当成今天的跨模型性能排行;今天的新内容是教程本身。 🔗 来源:OpenRouter OpenRouter 同日还发布了从生产流量构建评测集的指南:把实际输入和经过审阅的预期输出整理成可版本管理的集合,在改动前后重复运行。 它回答的是产品自己的问题:这次更新有没有改善正在服务的请求。通用榜单可以提供参考,但无法替代订单查询、退款边界或内部知识问答这些具体场景。 🔗 来源:OpenRouter 我接下来想做的小实验很简单:拿一件本来就会重复的工作,把输入、授权范围和完成标准写清楚。观察 AI 能否稳定做完,再看它是否知道什么时候停下来。新功能很多,先有一件日常工作因此变得省心,就值得继续记录。
📰 今天值得关注的新闻
🧠 Dots 开始推出:常驻助手先要有清楚的权限
💬 GPT-6.1 Sol 发布,先看价格,也看它出现在哪里
🖥️ 微软介绍 Quine,把模型建议带回实验室检验
📌 NVIDIA 开放 Kumo Tabular 表格预测模型
📌 Codex Cloud 支持复用项目环境
📌 Space 与 Pages:团队共同维护一份工作材料
📌 插件可以进入 ChatGPT 侧栏与文件查看界面
📌 Decisions API 进入有限预览
📌 Meetings 测试版先在 macOS 提供会议笔记
📌 Dependabot 运行器设置细化到单个仓库
📌 GitHub 外部自定义属性接入业务上下文
📌 Sarvam 发布智能体入门指南
📌 OpenRouter 教程拆开工具选择与参数错误
📌 换模型之后,回归测试要走完工具循环
📌 从真实请求整理评测集,再跨模型复测
Dots 开始推出:常驻助手先要有清楚的权限
GPT-6.1 Sol 发布,先看价格,也看它出现在哪里
微软介绍 Quine,把模型建议带回实验室检验
Quine 世界模型、知识工具与编排层示意。来源:Microsoft Research
NVIDIA 开放 Kumo Tabular 表格预测模型
Codex Cloud 支持复用项目环境
Space 与 Pages:团队共同维护一份工作材料
插件可以进入 ChatGPT 侧栏与文件查看界面
Decisions API 进入有限预览
Meetings 测试版先在 macOS 提供会议笔记
Dependabot 运行器设置细化到单个仓库
GitHub 外部自定义属性接入业务上下文
GitHub 外部属性在界面中显示为只读。来源:GitHub