ARTICLE · 1111970
Tomcat 9 源码剖析(一):架构总览
分析对象:Apache Tomcat 9.0.122 源码包(
apache-tomcat-9.0.122-src),1860 个 Java 文件、约 45.6 万行代码。
本篇包含:
目录结构:代码是怎么分层的 整体架构(组件树 / 一次请求的完整穿越 / 线程模型) 可以学到的架构知识(生命周期 / 责任链 / 状态枚举 / 三套 IO 抽象 / XML 装配)
0. 目录结构:代码是怎么分层的
打开源码包,java/org/apache/ 下只有四个顶层包,这四个包几乎就是 Tomcat 的骨架:
tomcat.util | NioEndpointSocketWrapperBase、LimitLatch、TaskQueue、SynchronizedStack、MessageBytes | |
coyote | 协议层Request/Response,不认识 Servlet | AbstractProtocolAbstractProcessorLight、Http11Processor、Http11InputBuffer |
catalina | 容器层 | StandardEngineStandardHost、StandardContext、StandardWrapper、StandardPipeline |
jasperjuli / naming / jdbc 等 |
这条分界线(coyote / catalina)是整个 Tomcat 最重要的一个架构决策。 coyote 不知道什么是 Servlet,catalina 不知道字节是怎么从 socket 里读出来的。两者只通过 CoyoteAdapter 和一对 Request/Response 接口对话。这带来一个直接好处:Tomcat 后来能同时支持 NIO、NIO2、APR 三种 IO 实现,还能接 AJP 协议,而容器层一行都不用改。
NIO、NIO2、APR 是 Tomcat 处理网络通信的三种 IO 模型实现,核心区别在于同步 vs 异步和Java 实现 vs 本地库实现。Tomcat 默认使用 NIO,NIO2 是升级版,APR 在 Tomcat 10 已被弃用。
工作流程差异:
NioSocketWrapper + Poller,Poller 负责把连接注册到 Selector 并阻塞监听。CompletionHandler),应用线程不用阻塞等待。接收连接用 Nio2Acceptor,完成回调里再触发下一次 accept,省去了轮询循环。1. 整体架构
1.1 组件树
server.xml 里嵌套的 XML 元素,在内存里就是一棵同构的组件树:
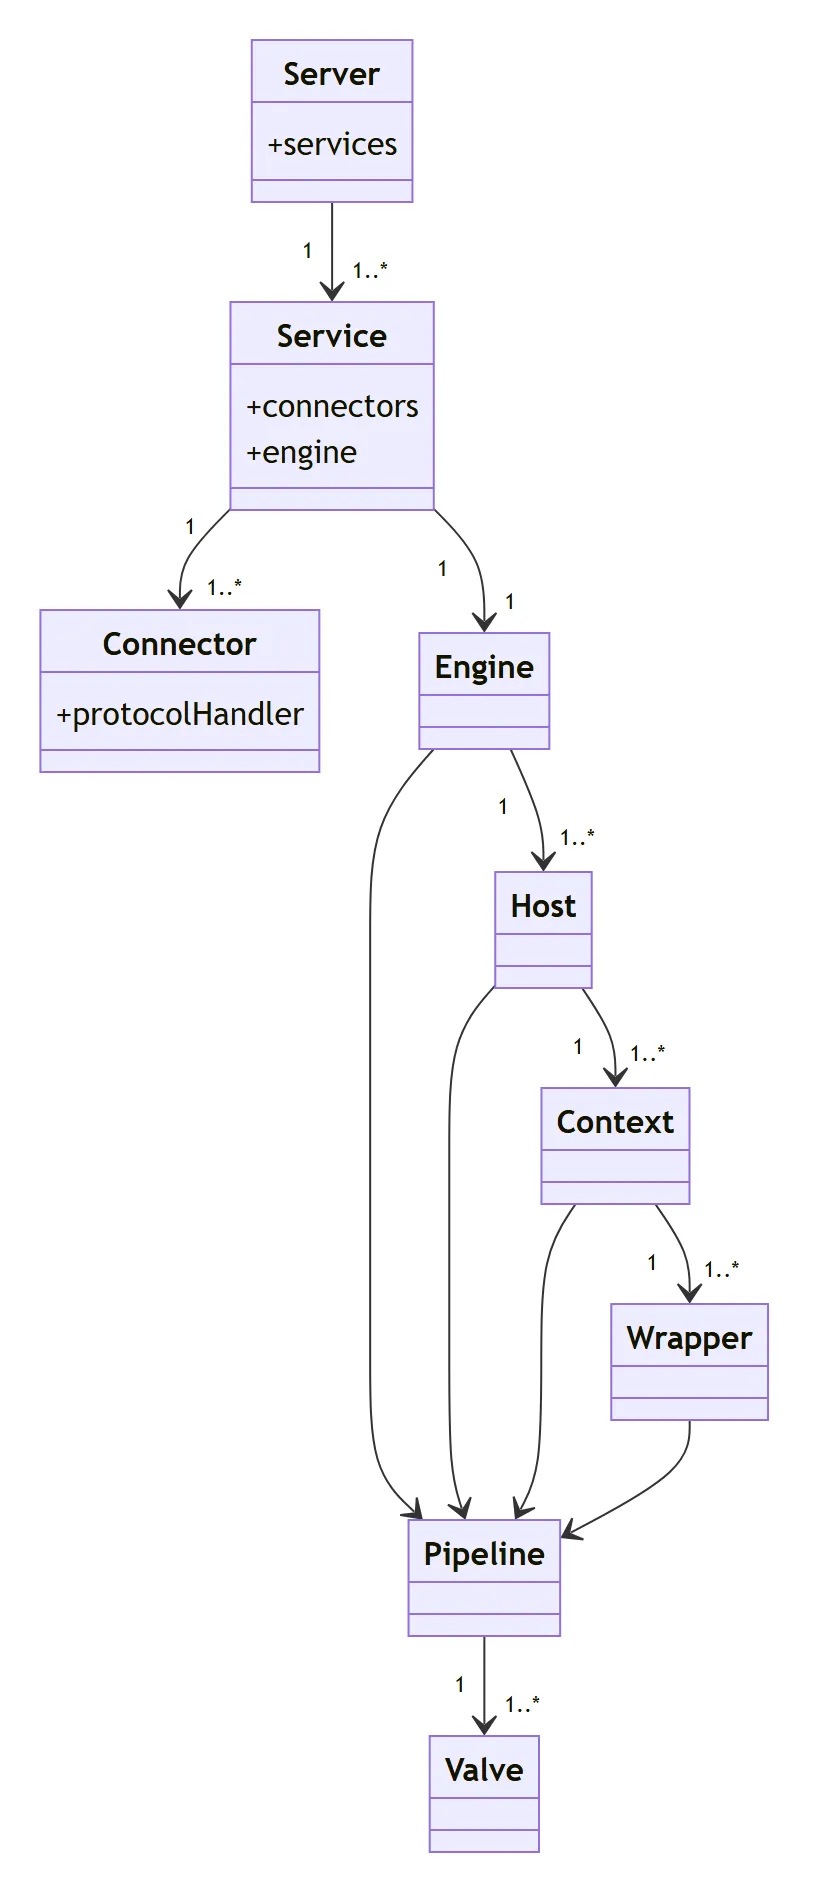
注意图中的收束处:Engine、Host、Context、Wrapper 每一层都各自挂了一条 Pipeline。这是 Tomcat 处理请求的方式——一层一层往下钻,每层在进入和离开时都有机会插手。
1.2 一次请求的完整穿越
Connector 是外交官,Engine 是内政部。下面是这两半边之间的接口:
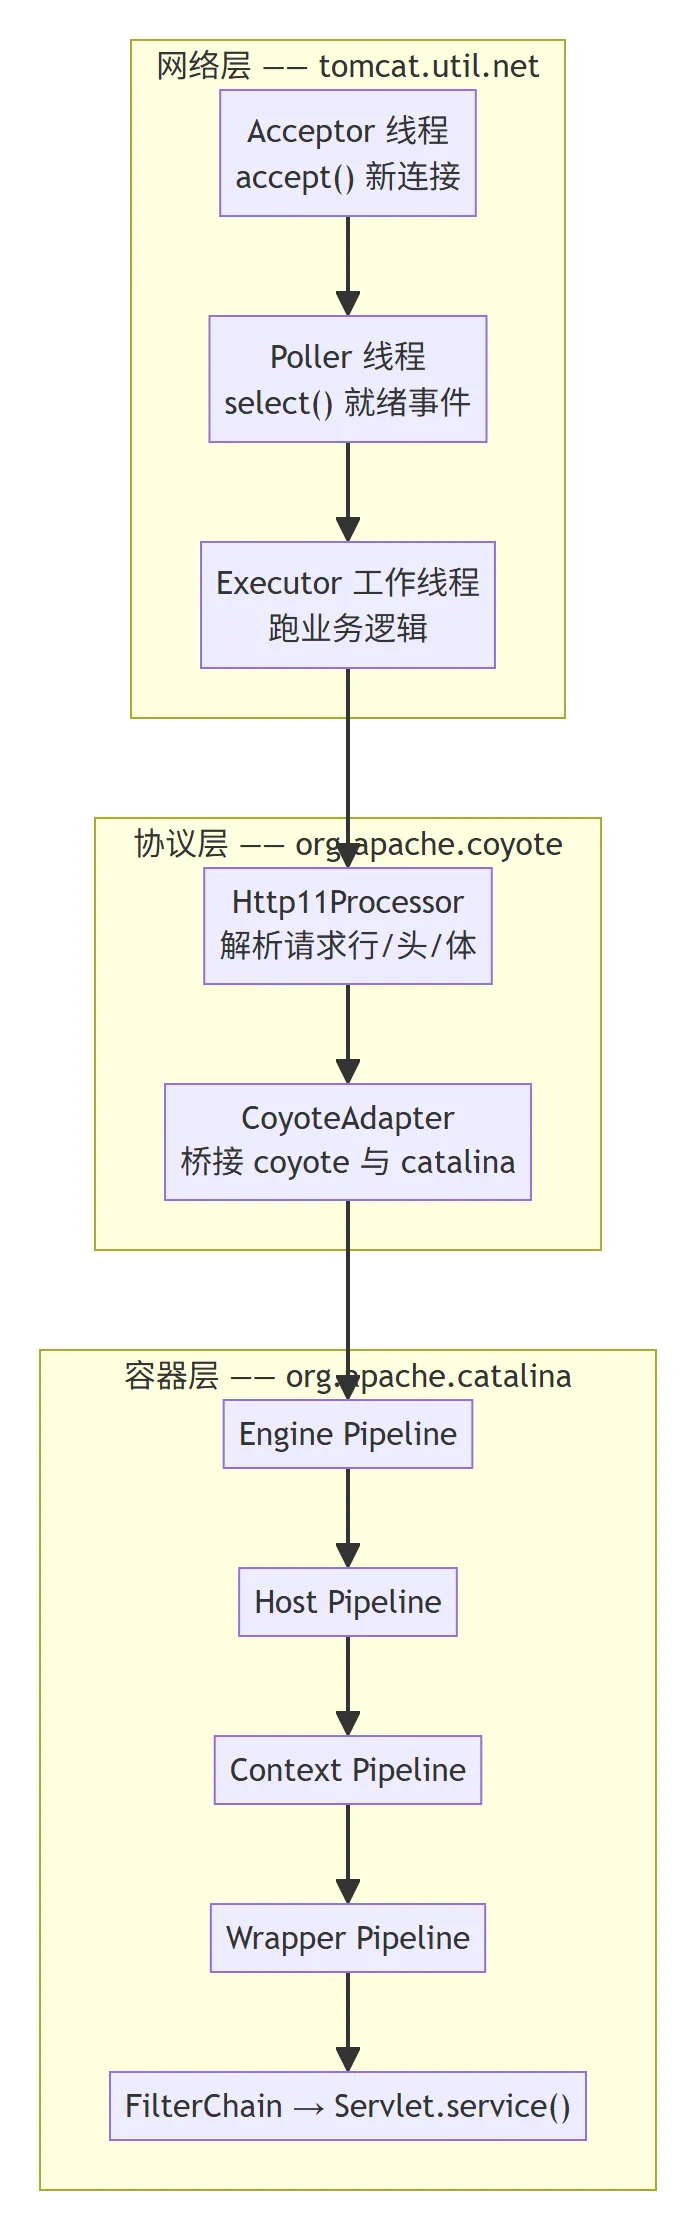
关键的一跳是 CoyoteAdapter.java 里的这一行:
// 约 350 行connector.getService().getContainer().getPipeline().getFirst().invoke(request, response);从这里开始,Request/Response 由 coyote 的轻量实现切换成了 catalina 的 org.apache.catalina.connector.Request/Response(Servlet 规范实现),请求正式进入容器。
1.3 线程模型
Tomcat 9 的 NIO 连接器一共只有三类线程,且职责划分得非常干净:
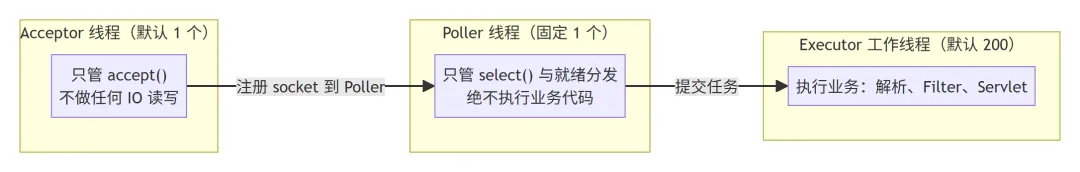
这个划分是 Tomcat 性能的根基。特别是 Poller 线程不执行业务这一条——它一旦被业务代码拖住,所有连接的读写事件都会延迟。源码里对此有明确的防御,见 NioEndpoint.java 的 processKey():它只是把 socket 包装成任务丢给线程池,自己立刻返回继续 select()。
一个值得记下的实现细节:Tomcat 9.0.122 的 NioEndpoint 只有一个 Poller 线程。setPollerThreadCount() 现在是空的 NO-OP,getPollerThreadCount() 永远返回 1(NioEndpoint.java),startInternal() 里也只 new 了一个 Poller(约 570 行)。早期版本支持多 Poller,后来因为 selector 分配与 key 归属问题被收敛回单线程——这说明"多线程未必更快",select 本身几乎不耗时,耗时的是后面的分发。
2. 可以学到的架构知识
2.1 生命周期:11 个状态而不是一个 boolean
org.apache.catalina.LifecycleState 定义了这些状态(去掉 FAILED 共 11 个):
NEW | |
INITIALIZINGINITIALIZED | |
STARTING_PREPSTARTING / STARTED | |
STOPPING_PREPSTOPPING / STOPPED | |
DESTROYINGDESTROYED | |
FAILED |
每种状态还带一个 available 布尔,表示"这一刻能不能对外提供服务"。比如 STARTING 是 false——组件正在启动,还没准备好接流量。
为什么不用 boolean started? 因为很多事情只在特定窗口内做才有意义:
关闭钩子要在 STOPPING_PREP时注册,太早太晚都不对;后台定时任务( StandardEngine的 session 过期清理)只在STARTED才该跑;STARTING期间如果被要求stop(),必须能正确回滚到STOPPED,而不是傻等。
这套模式的可迁移结论是:当一个对象的"生死"涉及多步、可中断、可回滚、可失败时,用状态机代替布尔量。LifecycleState 还配了一个 LifecycleSupport 做监听器分发,把"状态变更"这个事件广播出去,让依赖方自己响应。
2.2 管道与阀门:责任链的正确写法
Servlet 规范只用 Filter 链,Tomcat 内部则把责任链模式用到了骨头里 —— 这就是 Pipeline/Valve。
一个反直觉的细节:**StandardPipeline 里其实没有 invoke() 方法**。它只负责组装链条(getFirst() 返回第一个 Valve),真正的链式推进写在每个 Valve 自己的 invoke() 里:
// org.apache.catalina.Valve 接口,约 109 行voidinvoke(Request request, Response response)throws IOException, ServletException;每个 Valve 在 invoke() 里做完自己的事,再调用下一个:
// StandardHostValve.invoke() 中的两处关键调用(约 113 行、129 行)context.bind(Globals.IS_SECURITY_ENABLED, MY_CLASSLOADER); // 切换线程上下文类加载器context.getPipeline().getFirst().invoke(request, response); // 往下钻一层为什么把 invoke 放在 Valve 而不是 Pipeline?
需要"链中途插队"时(比如前面提到的 context.bind()必须在 Host 层做、但作用范围是 Context 层),Valve 自己就能控制时机;每个 Valve 天然是独立的可插拔单元, server.xml里<Valve>元素直接对应一个类;出错时 Valve 可以选择不往下传,直接终结请求(比如 StandardHostValve对 404 的处理)。
这套结构向上可以映射到 Filter,向下可以映射到 HandlerInterceptor,是"责任链"这一模式在工业代码里最完整的落地。
2.3 用枚举 + 状态返回值替代异常控制流
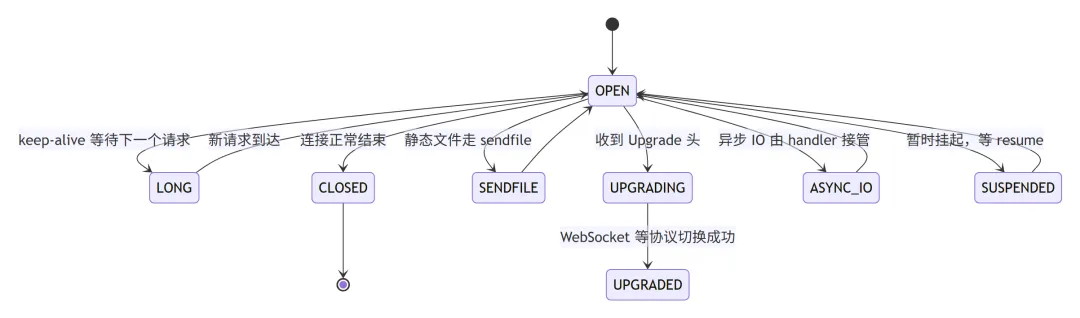
AbstractEndpoint.Handler.SocketState 是一个 9 值枚举(AbstractEndpoint.java):
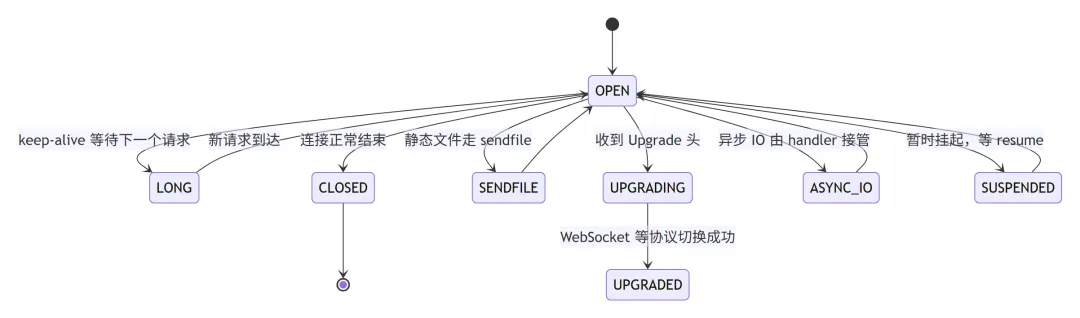
Processor.process() 不抛异常表示"我需要保持连接",而是返回状态。上层 AbstractProtocol.ConnectionHandler.process() 拿到状态后决定下一步:
// AbstractProtocol.java 约 1405-1452 行if (state == SocketState.LONG) { longPoll(wrapper, processor); // 保留 processor,socket 留在 pollerif (processor.isAsync()) { getProtocol().addWaitingProcessor(processor); }} elseif (state == SocketState.OPEN) { release(processor); // 回收 processor processor = null; wrapper.registerReadInterest(); // 重新注册读事件} elseif (state == SocketState.SENDFILE) { // 什么也不做,等 sendfile 完成} elseif (state == SocketState.UPGRADED) {if (status != SocketEvent.OPEN_WRITE) { longPoll(wrapper, processor); ... }} elseif (state == SocketState.ASYNC_IO) { // 不注册到 poller,handler 自己管} elseif (state == SocketState.SUSPENDED) { // 不注册,等 resume} else { // 关闭连接,回收 processor cleanUpIfUpgrade(processor); release(processor); processor = null;}这里 UPGRADED 分支的注释值得单独读一遍:
Don't add sockets back to the poller if this was a non-blocking write otherwise the poller may trigger multiple read events which may lead to thread starvation in the connector.
即:一次非阻塞写完成后如果顺手把 socket 重新注册回 poller,可能会让 poller 立刻再报一次读事件,反复触发导致单个连接把工作线程池吃干。所以这种情况下把注册动作交给 write() 方法自己决定。这是"状态转换的副作用必须显式管控"的教科书案例。
2.4 一套抽象覆盖三种 IO 实现
AbstractEndpoint → NioEndpoint / Nio2Endpoint / AprEndpoint,上层完全无感。秘密在于把差异全部收敛到两个抽象里:
SocketWrapperBase<E>:屏蔽"怎么读、怎么写、怎么注册事件";SocketEvent:把底层事件统一成 6 个枚举值(SocketEvent.java):OPEN_READ、OPEN_WRITE、STOP、TIMEOUT、DISCONNECT、ERROR。
更有意思的是 SocketWrapperBase 里的 OperationState<A> 抽象类(约 1223 行起),它把 NIO 的 read/write + CompletionHandler 和 NIO2 的 AsynchronousChannel 统一成同一种"向量化 IO 操作"模型,并用一个 Semaphore 保证同一时刻只有一个操作在跑:
protectedabstractclassOperationState<A> implementsRunnable{protectedfinalboolean read;protectedfinal ByteBuffer[] buffers;protectedfinal Semaphore semaphore; // 同一 socket 上的写操作串行化protectedfinal AtomicBoolean callHandler; // 保证 completion handler 只被调用一次protectedvolatilelong nBytes = 0;protectedvolatile CompletionState state = CompletionState.PENDING;protectedboolean completionDone = true;}注释里还专门说明了差异:hasOutboundRemaining() 默认返回 false,因为 "NIO2 and APR never have remaining outbound data when the completion handler is called. NIO needs to override this."
抽象要放在"行为差异"这一层,而不是"实现细节"那一层。 把三种 IO 的差异抽象成"读/写两个动作 + 6 个事件",而不是抽象成"三种 channel 类型",这是这套设计能成立的原因。
2.5 XML 驱动的组件装配
server.xml 是被 Digester 用"模式匹配 + 反射 setter 调用"解析的:<Connector port="8080"> 最终就是 connector.setPort(8080)。
好处:新增一个配置项只需要加一个 setter,不用改解析代码。代价:拼错属性名不会报错,只会静默忽略。自己写框架时如果照抄这个思路,一定要给 setter 调用做白名单校验。 Tomcat 后来在多个 CVE 里就是被这条路径打的(Digester 反射带来的可利用面)。