ARTICLE · 1111978
Kimi K3的线性注意力:从源码看懂KDA如何更新记忆
Kimi K3的线性注意力:从源码看懂KDA如何更新记忆
大家好,我是 Argat。
今天,我们换个姿势读源码:假如你是一个即将进入 Kimi K3 线性注意力层的向量,你会经历什么?
你刚刚走到门口,身后是长长的 token 队伍。有人刚来,有人已经在前文里待了几万字。你以为自己要挨个拜访这些前辈,问一遍:“你和我有没有关系?”
门里的工作人员却递过来一本固定大小的笔记:“历史已经写在这里了。轮到你,先参与修改,再从里面读取。”
等等。几万字的历史,只留一本固定大小的笔记?写满了怎么办?新消息和旧消息打架怎么办?我的信息又能留下多少?
这就是今天这场冒险的主线。我们要走进 Kimi Delta Attention,简称 KDA,亲自经历一次“遗忘、纠错、读取”的过程。
出发前,领好你的角色卡
这次,你扮演的是当前位置 t 上、送入 KDA 模块的隐藏向量 x_t。你承载着当前 token 到这一层时的表示;这份表示可能已经融合了前面各层的信息。
你有 7168 个数值坐标。它们共同描述你的状态,但没有谁事先规定“第一个数表示姓名、第二个数表示情绪”。这些坐标的用途是模型学习出来的。
真实程序会把很多这样的向量装进一个形如 [批次, 序列长度, 隐藏维度] 的张量。为了看清旅程,我们先跟随其中一个位置,再把镜头推近到一个注意力头。
你将遇到的那本“历史笔记”,是状态矩阵 S。你是当前输入,S 是沿序列传下来的记忆。 你可以参与改写它,却不会连同过去所有 token 一起原样住进去。
今天的地图来自官方模型代码 modeling_kimi_linear.py,入口类叫 KimiDeltaAttention。它调用 FLA 的 KDA 算子,数学定义则对应 K3 技术报告。下面会把关键代码直接放进正文,和我们的冒险逐站对照。
顺便看一眼楼层图:K3 的 93 层中有 69 层 KDA、24 层 Gated MLA。今天我们走进的是其中一层 KDA,全局注意力留在其他楼层。层数和维度依据官方模型配置。
先把这张冒险地图收好。上半部分是“我们怎样分身、怎样生成控制信号”,中间是记忆室,最下面是出口。往下读每一站时,都可以回到这里对照。
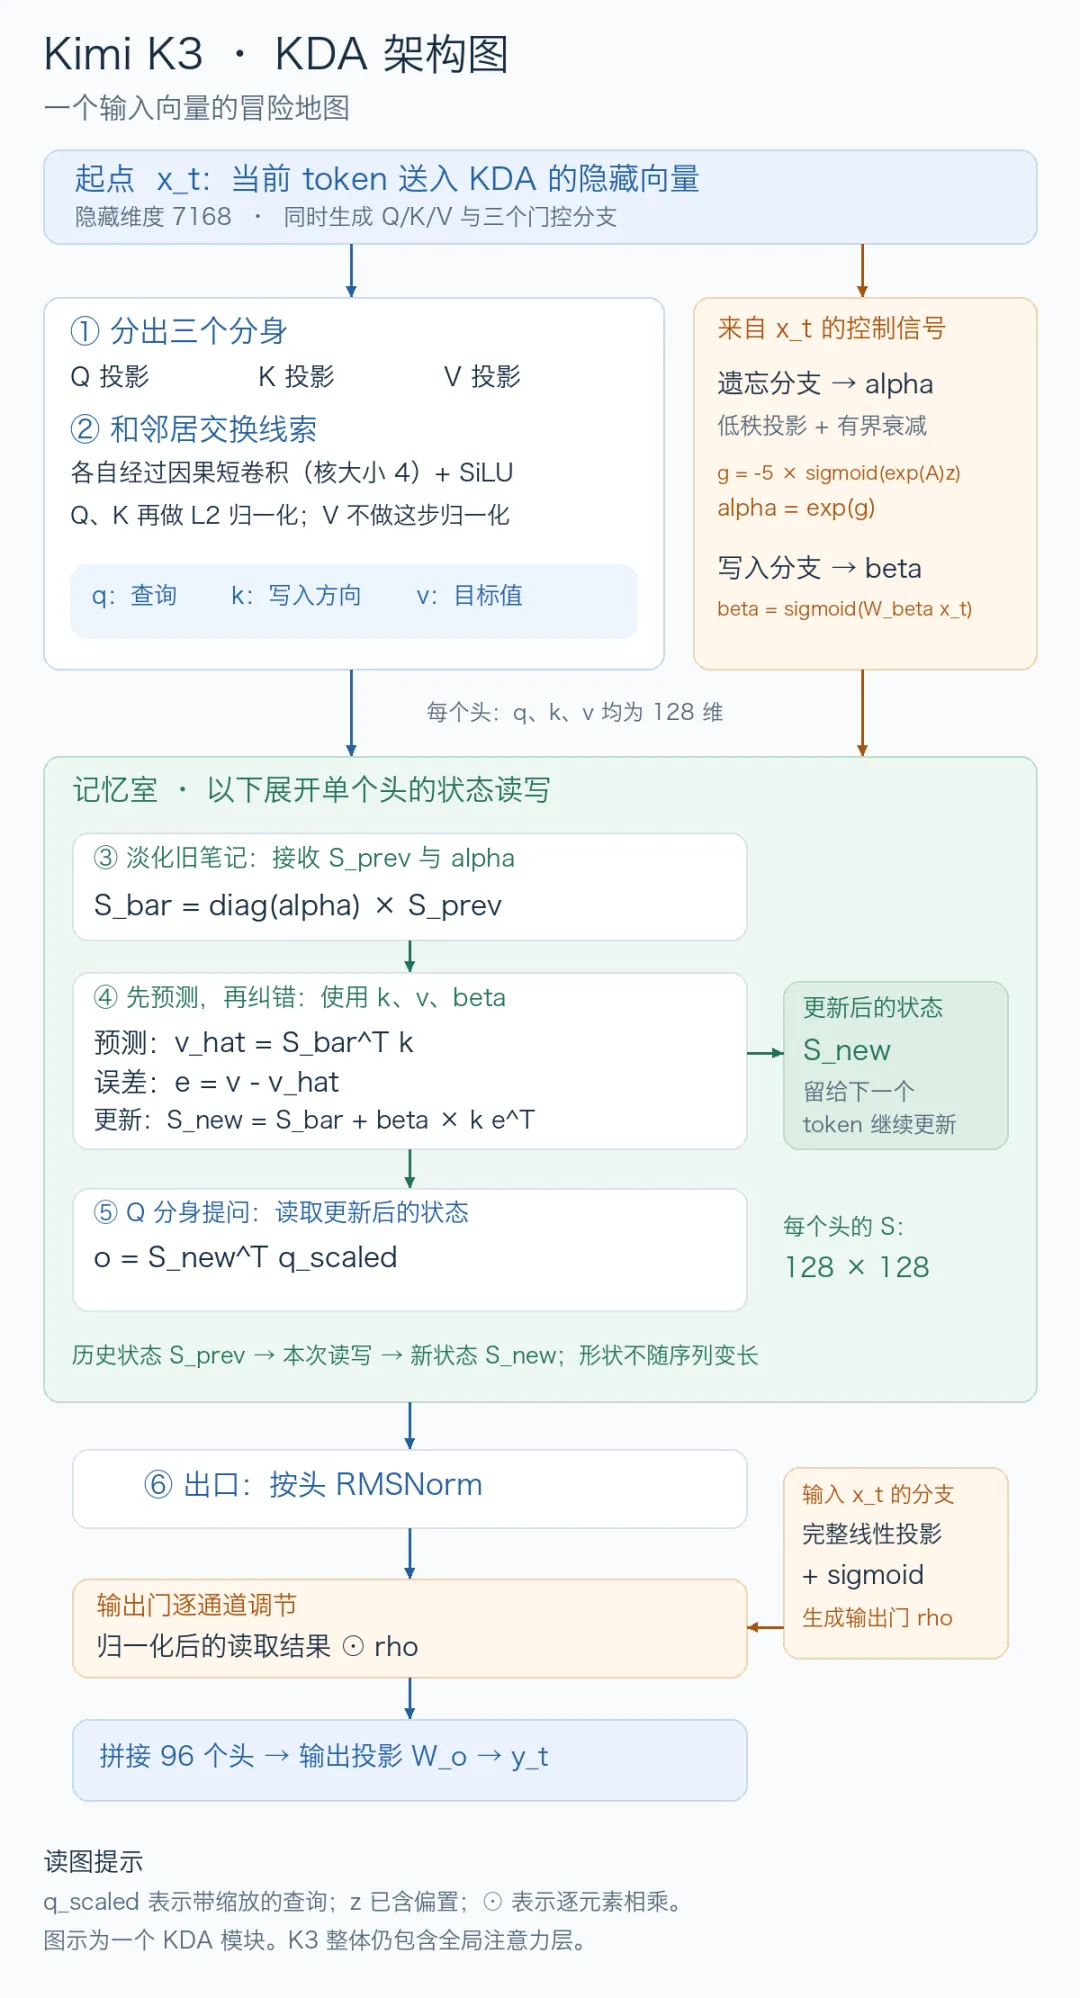
图中展示一个 KDA 模块;记忆室展开的是单个头。蓝色表示 Q/K/V 的加工与读取,橙色表示门控,绿色表示跨 token 传递的状态。输出门的信号也来自输入 x_t,图中为避免长线交叉,将这条输入分支画在出口旁。
第一站:刚进门,我就分出了三个分身
进入模块后,你并没有直接扑向历史笔记,而是先经过三组不同的线性投影。
用还没经过后续处理的初始分身表示,就是:

同一个你,经过不同的权重矩阵,变成了三个分工不同的表示:
- Q 分身带着查询:“这一步,我要从记忆中读出什么?”
- K 分身带着写入方向:“这次信息应该沿什么方向去查验和修正?”
- V 分身带着目标内容:“沿这个方向,我希望记忆能够给出什么?”
它们的名字与普通注意力里的 Q、K、V 相同,但稍后会参与不同的运算。
尤其要记住:K 不是一个精确的数据库地址。相似的 key 可能影响相近的记忆方向,这也意味着不同信息可能相互干扰。
除了这三个分身,你还会通过另外的投影分支生成遗忘、写入和输出的控制信号。它们都与当前输入有关,并非由一个懂人类语义的“管理员”临场决定。
第二站:先听听身边几位邻居,再整理装备
三个分身还没拿到正式通行证。它们先经过短卷积和 SiLU 激活,Q、K 随后还要做 L2 归一化。
K3 的短卷积核大小是 4。对当前这个位置而言,因果短卷积可以混合当前位置与前面最多三个位置的投影结果,不会偷看未来。序列刚开始、邻居还没到齐时,则按边界条件处理。
可以想象,你先和附近几位同伴交换了一下线索,再带着加工过的表示继续出发。
这里的“交换线索”对应的是可学习的局部卷积运算。SiLU 提供非线性变换,L2 归一化则把 Q、K 的长度规范到接近单位长度,让方向信息以受控的尺度参与后面的计算。
至此,我们把处理后的三个分身记作 q_t、k_t、v_t。
对应的模型源码先生成三个投影,再分别调用短卷积。下面原样摘录投影与 Q 分支的调用;K、V 的卷积调用结构相同:
1 2 3 4 5 6 7 8 9 q_proj_states = self.q_proj(hidden_states)k_proj_states = self.k_proj(hidden_states)v_proj_states = self.v_proj(hidden_states)q, conv_state_q = self.q_conv1d( x=q_proj_states, cache=conv_state_q, output_final_state=use_cache, cu_seqlens=cu_seqlens,) 这里的 conv_state_q 保存局部卷积需要的历史。SiLU 已配置在短卷积模块内;Q、K 的 L2 归一化则交给 KDA 算子执行,所以 Python 外层不一定出现单独的归一化语句。
第三站:到了记忆室,先别急着往上写
门终于打开了。眼前的 S,是前面所有位置不断更新后传到你手里的状态。
在我们跟随的这个头里,它可以写成一个 128×128 的矩阵。一个 KDA 层有 96 个这样的头,各自维护状态。为了讲清公式,下面统一采用“key 维度在前、value 维度在后”的矩阵写法;底层实现可以采用转置的存储布局。
你正准备把 V 分身带来的信息写进去,第一道门先亮了:旧记忆的各个通道,这一步分别保留多少?
控制它的是向量 alpha_t。运算为:
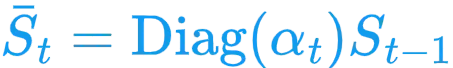
也就是沿 key 维度,用不同的比例缩放状态矩阵的不同行。
想象一本笔记的三行被分别调成 0.99、0.8、0.1 的保留比例:第一行几乎不动,第二行淡一些,第三行淡很多。
KDA 的细粒度遗忘就体现在这里:同一个头里的不同 key 通道,可以使用不同的保留比例。
这些行没有被人工标成“人物信息”“地点信息”或“无用信息”。淡化也不等于模型已经判断某条自然语言事实不重要。它执行的是学习得到的数值控制。
你可能会问:我还没写东西,为什么要先动旧笔记?
因为接下来的纠错,正是基于这份已经衰减过的记忆进行的。先后顺序会影响结果。
第四站:我要写入的,居然是一个差值
现在,K 分身先上前一步,试着从旧笔记里读出内容:
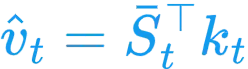
它相当于问:“沿着我这个 key,现在已经能读出什么?”
V 分身把自己带来的目标值拿出来,两者一比:
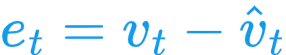
这个差值 e_t,就是此次需要纠正的误差。
接着,另一道门给出写入强度 beta_t,状态完成更新:
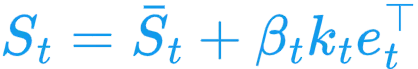
外积把误差沿着 k_t 的方向写回状态;beta_t 是当前头在当前位置上的一个标量,控制修正的力度。
你终于明白了这里的规矩:先查一遍已经记住了什么,再根据差距修改。 这就是 delta rule 的直观含义。
我们来演一段极简小剧场。暂时关闭遗忘,固定一个单位长度的 key,也不考虑其他 key 的干扰。笔记里沿这个方向读出的旧值是 10,而你带来的新值是 14。
假设 beta 为 0.5。如果直接把新值加进去,就会得到:

但纠错式写入先算差值 14−10,再更新:

如果之后一直带来同样的 14,沿这个方向读出的值会继续变成 13、13.5……逐步靠近目标。
所以,当旧记忆已经能够很好地预测当前 value 时,这一步就不需要大幅修正。这个机制能避免上述简单加法例子中“相同内容越写越大”的现象。
当然,真实世界没有这么整齐。不同 key 未必正交,你这次修改,可能同时改变其他 key 能读出的内容。固定大小的状态仍然有容量和干扰问题。
到这里,我们可以把刚才的冒险压缩成几行教学伪代码:
1 2 3 4 5 # 一个 token、一个头;q、k 已归一化,alpha、beta 已激活memory = alpha[:, None] * memory # 淡化旧笔记prediction = memory.T @ k # 检查已经记住什么error = v - prediction # 算出需要纠正的差值memory = memory + beta * outer(k, error) 上面是省略批次、多头维度的教学伪代码。FLA 的 naive_recurrent_kda 中,对应的两行源码如下,保留了原始张量运算写法:
1 2 S = S * g_i[..., None].exp()S = S + torch.einsum('b h k, b h v -> b h k v', b_i[..., None] * k_i, v_i - (k_i[..., None] * S).sum(-2)) 第一行的 g_i 是对数衰减,取指数后就是保留比例。第二行先算预测误差,再通过外积更新状态。b、h、k、v 分别标记批次、头、key 维度和 value 维度。
第五站:写完了,才轮到 Q 分身提问
一直拿着查询的 Q 分身终于走到台前,从更新后的状态读取结果:
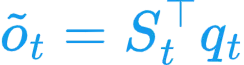
这里为了突出读写关系,省略了实现中的查询缩放因子;FLA 默认还会对查询施加与 key 维度有关的缩放。
为什么需要专门保留一个 Q 分身?因为“这一步沿哪个方向更新记忆”和“这一步想从记忆中读取什么”,可以是不同的需求。K 和 Q 经过不同的学习投影,承担不同职责。
而且,读取发生在本次写入之后。因此,你当前带来的信息,也有机会影响这一步的输出。
此时故事里已经出现了两个不同的去向:更新后的 S 留在记忆通路里,供后续 token 继续使用;读出的结果则沿输出通路继续前进。你并没有作为一个完整向量,被夹在 S 中等待日后原样取出。
第六站:出口还有一道门,我不能原样冲出去
读出结果先经过按头的 RMSNorm,然后接受输出门的逐通道调节,最后通过输出投影:

这扇输出门的控制信号,来自最初进入模块的你——x_t。可以理解为:根据当前输入,调节各个读取通道向外输出的比例。
到这里,三种门的职责就能分清了:
K3 在这里的一项改动,是启用 use_full_rank_gate,用完整的线性投影生成输出门,移除低秩参数化的瓶颈。官方实现中,这个分支直接定义为:
1 self.g_proj = nn.Linear(self.hidden_size, projection_size, bias=False) 这是启用完整输出门投影时的源码摘录。
这里的“全秩”描述的是参数化方式,并不保证训练后的权重矩阵一定数学满秩。它指的是输出门,也不意味着遗忘分支的投影都变成了相同形式。
经过输出投影,我们得到这个 KDA 模块的输出表示。属于这一层的旅程,到这里走完了。
回头看看:为什么这趟旅程叫“线性注意力”?
先别急着离开。我想请你回忆一下:刚才,我们有没有逐个访问前面的所有 token?
没有。我们操作的是固定形状的状态矩阵,以及短卷积需要保留的局部状态。
如果换成普通的因果 softmax 注意力,当前查询需要与越来越长的历史键集合计算相关性,再汇总对应的值。整段长度为 T 的序列,位置配对数量按 T² 增长;逐 token 生成时,即使已有 KV cache,访问历史的工作量仍会随历史长度增加。
KDA 的递归核心则在固定头数和维度下,每来一个 token,执行一次固定规模的状态更新与读取。因此,处理 T 个 token 的核心工作量随 T 线性增长。
按照 K3 的配置,96 个头各自维护 128×128 的状态,单层每条序列共需要 1,572,864 个状态元素。若以 FP32 存储,仅这些矩阵约为 6 MiB。这里是配置推算,不含短卷积状态、临时张量及其他层,更不是整模型显存测量。
这本笔记的大小不会因为前文变长而增加。但固定大小也意味着信息不断被压缩、改写,不能承诺无损保存每一段历史。
而且,K3 还有 24 层全局注意力。我们这一层的固定状态,并不等于整个模型的缓存都不随上下文增长。 训练也还需要激活、梯度等额外数据。
彩蛋:我是一位一位进门的,GPU 也要这样慢慢等吗?
刚才为了看懂运算,我们跟随一个 token,按照时间顺序走了一遍。
生成新 token 时,这样继续更新状态很自然。但训练和预填充时,一大段输入已经在门外排好队。如果 GPU 也严格照着我们的游记,用 Python 循环逐个接待,就很难发挥它的计算能力。
因此,实现提供了两种组织方式:fused_recurrent_kda 负责递归执行,chunk_kda 负责分块执行。
你可以想象,接待窗口把一批来访者编成一个小组:组与组之间传递状态,组内把多步计算组织成适合 GPU 的矩阵运算。改变的是执行安排,因果关系仍然保留,后面的人不能提前给前面的人递答案。
K3 对遗忘门的另一个关键改动,正是为这样的分块计算服务。
用 z 表示包含偏置的门控输入,A 表示每个头的可学习参数。早期 Kimi Linear 使用的对数衰减形式为:

K3 则使用:

FLA 的 gate.py 中,带下界门函数的核心源码如下:
1 2 3 4 5 6 7 8 H, _ = g.shape[-2:]g = g.float()if dt_bias is not None: g = g + dt_bias.view(H, -1)if A_log is not None: g = A_log.view(H, 1).float().exp() * gg = lower_bound * F.sigmoid(g)return g.to(output_dtype) 这里 lower_bound 在 K3 中设为 −5。注意这个函数输入的 g 是激活前的门控值,返回的 g 才是对数衰减;代码复用了变量名。
这相当于给笔记的“调淡旋钮”加了一个单步边界:数学上,对数衰减 g 被限制在 −5 和 0 之间,保留比例 alpha 位于 exp(−5) 和 1 之间。实际浮点计算可能在边界附近饱和。
为什么硬件会关心笔记调淡多少?因为分块公式涉及保留比例的连乘及相关倒数缩放。连乘结果太小,倒数就可能太大,超出浮点数能处理的范围。
K3 技术报告指出,在 16-token 的小块内,这个限制将累计对数衰减约束在 −80 到 0 之间,使相关倒数缩放保持在 BF16 动态范围内。于是,对角小块也能使用稠密 Tensor Core 矩阵乘法,减少原有逐位置配对计算的瓶颈。这一说明对应技术报告第 2.1.1 节。
所以,这个小旋钮同时连接着两件事:模型怎样遗忘,以及 GPU 怎样高效地算。
它也没有给我们发放“永不遗忘”的护身符。单步保留比例有下界,很多步连乘后仍然可能很小;后续的纠错写入,也会继续改变记忆。
这就是一个输入向量在 KDA 中的完整冒险:进门时分出 Q、K、V,带上邻近位置的线索,参与调节旧状态,写入需要修正的差值,再查询更新后的记忆,带着门控后的读取结果离开。
而我们留下的那本笔记,已经被交到了下一个 token 手里。
它翻开第一页,问出了和我们一样的问题:
“关于我这次带来的信息,你已经记住了多少?”
资料核对日期:2026 年 10 月 1 日。本文依据官方模型代码、配置、技术报告及其调用的 FLA 源码;人物、笔记和冒险情节是教学比喻,数值例子为简化演算,未进行 K3 整模型部署或性能实测。所据公开代码可能继续更新。源码摘录保留原始运算;“教学伪代码”段落经过简化。
资料来源(纯文字):Moonshot AI《Kimi K3: Open Frontier Intelligence》技术报告;Kimi K3 官方模型文件 modeling_kimi_linear.py 与 config.json;Flash Linear Attention 项目中 KDA 的 naive.py、gate.py、chunk.py 与 fused_recurrent.py。FLA 所引代码遵循 MIT 许可证。