ARTICLE · 1112508
决策树:让AI学会"层层提问"的智慧
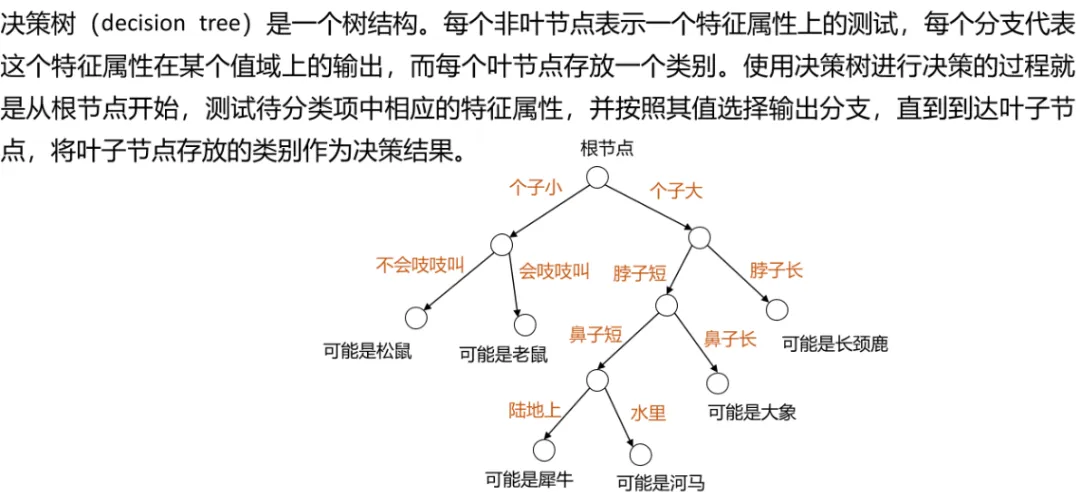
银行信贷审批员翻阅你的资料,先看年龄、再看收入、接着查征信,几步之内断定是否放贷;医院急诊医生面对发热患者,先问体温、再看血常规、接着查影像学,快速分流感染类型;电商运营面对新用户,先判地域、再看消费力、接着查浏览偏好,精准推送商品——这些决策过程有什么共同点?答案是它们都遵循同一种逻辑:通过一系列"层层提问",最终抵达一个结论。这种逻辑在机器学习中有个专属名字——决策树(Decision Tree,通过树状结构进行特征测试的机器学习模型)。它是一种有监督学习算法,每个非叶节点表示一个特征属性上的测试,每个分支代表这个特征属性在某个值域上的输出,而每个叶节点存放一个类别。今天咱们把这棵"AI智慧树"拆开讲,聊聊它如何用"层层提问"完成分类,靠什么选出"最佳问题",以及如何通过"修剪枝叶"防止死记硬背。
一、决策树的本体:一棵会"提问"的树
(1)官方定义:树状结构的分类模型
决策树是一个树结构(可以是二叉树或非二叉树)。其每个非叶节点表示一个特征属性上的测试,每个分支代表这个特征属性在某个值域上的输出,而每个叶节点存放一个类别。使用决策树进行决策的过程就是从根节点开始,测试待分类项中相应的特征属性,并按照其值选择输出分支,直到到达叶子节点,将叶子节点存放的类别作为决策结果。
(2)三种节点的分工
根据阿里云开发者社区对《数据挖掘导论》的解读,决策树包含三种类型的结点:
- 根结点
:没有传入连接,零个或多个传出连接,代表决策起点,包含样本全集 - 内部结点
:每个结点只有一个输入连接和两个或更多的传出连接,对应一个特征属性的测试 - 叶结点(终端结点)
:每个结点只有一个输入连接并且没有输出连接,与一个类别标签相关联
(3)生活化类比:从"二十个问题"到"动物分类游戏"
还记得童年玩的"猜动物"游戏吗?朋友心里想一个动物,你通过不断提问——"是生活在水里吗?""是哺乳动物吗?""会飞吗?"——用最少的问题锁定答案。决策树干的就是这件事:
- 根节点
= 第一个问题("是生活在水里吗?") - 内部节点
= 后续追问("是哺乳动物吗?") - 分支
= 每个问题的答案(是/否) - 叶节点
= 最终猜测的动物("海豚")
《数据挖掘导论》里给出的经典例子是哺乳动物分类:根结点使用属性"体温"定义测试条件,结果分为"恒温"和"冷血"两个分支,最终叶子节点关联到具体的动物类别。
(4)决策路径:从根到叶的"如果-那么"规则
从根节点到每个叶结点的路径,对应了一个判定测试序列。这条路径可以翻译成人类易读的"如果-那么"规则:
如果 体温=恒温且 胎生=是且 水生=否则 类别=猫科动物
这种强可解释性是决策树最迷人的特质——它的每一个决策都能被还原为一条清晰的规则,不像神经网络那样是"黑盒"。
💡 关键认知:决策树不是"分类器",而是"提问策略的生成器"。它学习的目标,是产生一棵泛化能力强、即处理未见示例能力强的树。
二、决策树怎么"长"出来:特征选择的艺术
(1)核心难题:在节点上问哪个问题?
构建决策树的过程中,最关键也最微妙的问题是:在某个节点上,应该按哪个特征进行测试?
直觉告诉我们:好的问题应该能"快速缩小范围"。在机器学习中,我们用"纯度"来量化这个目标——纯度(Purity,节点中样本属于同一类别的程度)越高,说明节点越"纯"。
(2)三把"尺子":信息增益、信息增益率、基尼指数
为了衡量一次分割的质量,学界提出了三种主流准则:
第一把尺子:信息增益(Information Gain)
基于香农熵的概念。熵表示数据集的不确定度,熵越大,类别分布越混乱。信息增益 = 父节点的熵 - 分割后各子节点熵的加权平均。ID3算法使用它来选择特征。
第二把尺子:信息增益率(Gain Ratio)
信息增益有个毛病:偏爱取值多的特征(比如"用户ID"这种唯一值特征)。C4.5算法引入"固有值"对信息增益进行惩罚,得到信息增益率,是ID3的改进版。
第三把尺子:基尼指数(Gini Index)
基尼不纯度(Gini Impurity,从节点随机抽取两样本类别不同的概率)越小,节点越纯。CART算法默认使用基尼系数,计算上比熵更高效。
(3)递归生长:自顶向下的"分而治之"
决策树的构建采用递归划分(Recursive Partitioning,自顶向下重复分割数据建树的方法):
从根节点(包含所有样本)开始 选择最优特征进行分割(用上述三把尺子之一) 为该特征的每个可能取值创建子节点 对每个子节点递归重复步骤2-3 直到满足停止条件,创建叶节点
(4)三种经典算法
算法 | 提出时间 | 划分标准 | 树结构 | 特点 |
|---|---|---|---|---|
ID3 | 1986年 | 信息增益 | 多叉树 | 只能处理离散特征,不支持剪枝 |
C4.5 | 1993年 | 信息增益率 | 多叉树 | 可处理连续特征和缺失值,支持后剪枝 |
CART | 1984年 | 基尼指数 | 二叉树 | 支持分类和回归,广泛用于随机森林 |
注:算法特性综合自多份技术文献。
💡 工程经验:在实际工程中,CART算法因其支持回归任务、可生成二叉树、易于集成(随机森林、GBDT都基于CART),成为最受欢迎的决策树算法。
三、决策树的"阿喀琉斯之踵":过拟合与剪枝
(1)过拟合:死记硬背的"学霸"
如果不加限制,决策树会一直生长,直到每个叶子节点都只包含一个样本,达到100%的训练集准确率。这就像学生死记硬背下了所有习题答案,但遇到新题就傻眼——这就是过拟合(Overfitting,模型在训练集表现完美但在新数据上表现糟糕)。
决策树容易过拟合的特性,主要来自三个原因:
- 不稳定性
:数据微小变动可能导致树结构剧烈变化 - 偏向多值特征
:信息增益标准倾向于选择取值多的特征 - 捕捉噪声
:复杂树结构易捕捉训练数据中的随机噪声
(2)进阶优化方案一:预剪枝(Pre-pruning)
预剪枝是在树生成过程中提前停止生长。常见的停止条件包括:
设定最大深度(如 max_depth=5)设定节点最小样本数(如 min_samples_split=10)设定不纯度下降阈值(如 min_impurity_decrease=0.01)节点纯度已达到较高水平
预剪枝计算开销小,但可能" prematurely stop"——有些看似无用的分割, deeper down 可能带来重要结构。
(3)进阶优化方案二:后剪枝(Post-pruning)
后剪枝是先让树完全生长,然后自底向上考察非叶节点:如果将该节点替换为叶节点(用该节点下样本的多数类代替)能在验证集上带来性能提升或不下降,就进行剪枝。
常见的后剪枝方法包括:
- 错误率降低剪枝(REP)
:删除以节点为根的子树,用最常见分类替代 - 悲观错误剪枝(PEP)
:基于统计检验判断是否剪枝 - 代价复杂度剪枝(CCP)
:通过复杂度参数α控制,scikit-learn采用此策略
💡 进阶优化建议:后剪枝通常比预剪枝保留更多的分支可能性,效果更好,但计算开销更大。在实践中,常用策略是"预剪枝+后剪枝"组合:先用
max_depth和min_samples_split做粗粒度控制,再用CCP做精粒度优化。某互联网金融机构(化名"智信金科")采用这种组合策略后,风控模型在新用户上的泛化能力达到行业领先水平。
四、决策树实战:Python代码示例
(1)使用scikit-learn快速构建
from sklearn.tree import DecisionTreeClassifierfrom sklearn.model_selection import train_test_splitfrom sklearn.datasets import load_iris# 加载数据iris = load_iris()X_train, X_test, y_train, y_test = train_test_split(iris.data, iris.target, test_size=0.2, random_state=42)# 构建决策树(CART算法,基尼指数)clf = DecisionTreeClassifier(criterion='gini', # 基尼指数max_depth=3, # 预剪枝:最大深度min_samples_split=5, # 预剪枝:最小样本分裂数random_state=42)clf.fit(X_train, y_train)# 预测与评估print(f"训练集准确率: {clf.score(X_train, y_train):.2%}")print(f"测试集准确率: {clf.score(X_test, y_test):.2%}")# 可视化树结构from sklearn.tree import export_textprint(export_text(clf, feature_names=iris.feature_names))
(2)可视化决策路径
决策树的一大优势是可解释性。通过上述代码,你可以直接打印出树的结构,看到每个节点上的"提问"和"分支",完全透明。
(3)参数调优建议
criterion:'gini'(默认,计算快)或 'entropy'(信息增益) max_depth:通常3-8层,控制树的复杂度 min_samples_split:建议10-100,防止过细划分 min_impurity_decrease:分裂需要的最小纯度提升(常用0.001-0.01) ccp_alpha:代价复杂度剪枝参数,通过交叉验证选择
五、决策树的应用版图
(1)金融风控
银行通过年龄、收入、负债等特征预测违约概率,构建信用卡申请审批模型;反欺诈检测识别异常交易模式(如突然大额转账)。
(2)医疗诊断
基于症状、检查结果预测疾病类型,或根据患者特征推荐最优治疗方案。
(3)客户细分与营销
通过行为数据划分客户群体,针对不同群体制定差异化推广策略,实现精准营销。
(4)工业质量控制
识别产品生产过程中的质量缺陷,或根据设备传感器数据预测故障发生,实现预测性维护。
(5)作为"基石"的集成学习
决策树最深远的影响,是作为集成学习(Ensemble Learning,组合多个弱模型形成强模型的技术)的基学习器:
- 随机森林(Random Forest)
:组合多棵决策树,通过Bagging策略降低方差 - 梯度提升树(GBDT/XGBoost/LightGBM)
:通过Boosting策略逐棵修正错误
这些基于决策树的集成算法,在Kaggle竞赛和工业级机器学习系统中占据了主导地位。
六、为什么这件事值得每个AI从业者关注
(1)机器学习的"可解释性标杆"
在深度学习大行其道的今天,决策树依然是不可替代的——尤其在金融、医疗、司法等需要模型决策透明的领域。它的"如果-那么"规则天然符合人类决策逻辑,监管机构和业务人员都能理解。
(2)通往集成学习的"敲门砖"
随机森林、XGBoost、LightGBM等顶级机器学习算法,本质都是决策树的集成。理解了单棵决策树的原理,才能真懂这些"冠军算法"的工作机制。
(3)职业发展的新命题
对AI工程师而言,决策树带来了最基础的技能维度:
- 核心技能
:信息增益/基尼指数计算、ID3/C4.5/CART算法、预剪枝/后剪枝 - 思维训练
:理解"特征选择→递归分割→剪枝优化"这一整套机器学习的核心范式 - 架构思维
:理解简单模型与复杂模型的权衡,明白何时用单棵决策树、何时升级到随机森林或深度学习
参考文献
[1] Pang-Ning Tan, Michael Steinbach, Vipin Kumar. 数据挖掘导论(原书第2版)[M]. 阿里云开发者社区读书笔记. (2019-11-18). https://developer.aliyun.com/article/727307.(决策树包含根结点、内部结点、叶结点三种类型;非终端结点包含使用单个属性定义的属性测试条件;从根结点开始应用属性测试条件,根据测试结果按照适当的分支进行操作,直到到达叶结点,将与该结点关联的类别标签分配给测试实例)
[2] 决策树算法全解析:从原理到实战,掌握机器学习经典模型[EB/OL]. CSDN. (2026-08-01). https://blog.csdn.net/weixin_29168153/article/details/163406027.(衡量不纯度降低幅度的指标包括信息增益、信息增益率、基尼不纯度;决策树容易过拟合,需通过预剪枝或后剪枝防止过拟合;常见停止条件包括设定最大深度、最小样本数、不纯度下降阈值)
[3] 机器学习笔记:决策树[EB/OL]. 腾讯云开发者社区. (2018-03-06). https://cloud.tencent.com/developer/article/1052884.(信息熵是度量样本集合纯度最常用的指标;ID3以信息增益为准则,C4.5使用增益率,CART使用基尼指数;剪枝的基本策略有预剪枝和后剪枝)
[4] 决策树(Decision Tree)详细解释(带示例)[EB/OL]. CSDN. (2025-02-27). https://nanhubrain.csdn.net/6a1d36eb662f9a54cb78a0e3.html.(决策树是一种基于树结构的分类和回归算法;树中每个内部节点表示一个属性上的测试,分支是测试输出,叶节点是类别或值;构建核心是选择合适的特征进行划分,使子节点数据纯度更高)
结束语
决策树不是"过时的老算法",而是通过树状结构进行特征测试的机器学习模型,是机器学习中最基础的有监督学习算法之一。它通过递归划分的方式,在每个节点选择最优特征进行测试,最终构建出一棵从根到叶对应"如果-那么"规则的决策树。尽管单棵决策树有过拟合的风险,但通过预剪枝和后剪枝等进阶优化方案,它能爆发出强大的泛化能力。更重要的是,决策树是随机森林、XGBoost等冠军算法的基石——理解了决策树,就掌握了机器学习"特征选择→递归分割→剪枝优化"的核心范式。
互动话题
据权威技术文献,决策树通过信息增益、信息增益率、基尼指数三种准则进行特征选择,ID3、C4.5、CART三大经典算法奠定了现代机器学习的基础;而基于决策树的随机森林和XGBoost,更是在Kaggle等数据科学竞赛中长期占据主导地位。想不想拿到一份决策树实战指南?后台回复"决策树",领取我整理的scikit-learn参数调优速查表+鸢尾花分类完整代码。下期聊"从决策树到随机森林:一棵树不够,我们就种一片森林",你更想了解Bagging集成策略还是随机森林的特征重要性?评论区告诉我👇
这篇文章是否满足你对"决策树"基础知识普及的期待?如果需要,我可以接着为你撰写下期内容"从决策树到随机森林:一棵树不够,我们就种一片森林",或者深入解析"ID3 vs C4.5 vs CART:三大决策树算法的本质区别"。