ARTICLE · 1112979
一切皆插件:DeepSeek Harness
DeepSeek Harness 四层结构
从一条命令,到插件级改造:一个 Agent 运行时到底由什么构成
🔧 第一层:先把 Harness 这个词拆开
我见过太多团队在这件事上走弯路:花三个月对比模型跑分,最后发现真正决定体验的,是模型外面那一圈"壳"。
这个壳就是 Harness。它的作用不是让模型变聪明,而是规定模型每一轮能看到什么、能碰什么、做完之后状态记在哪里。业界有个很直白的类比:套在马身上的挽具,马的力气没变,但力气往哪儿使、怎么使,由挽具决定。
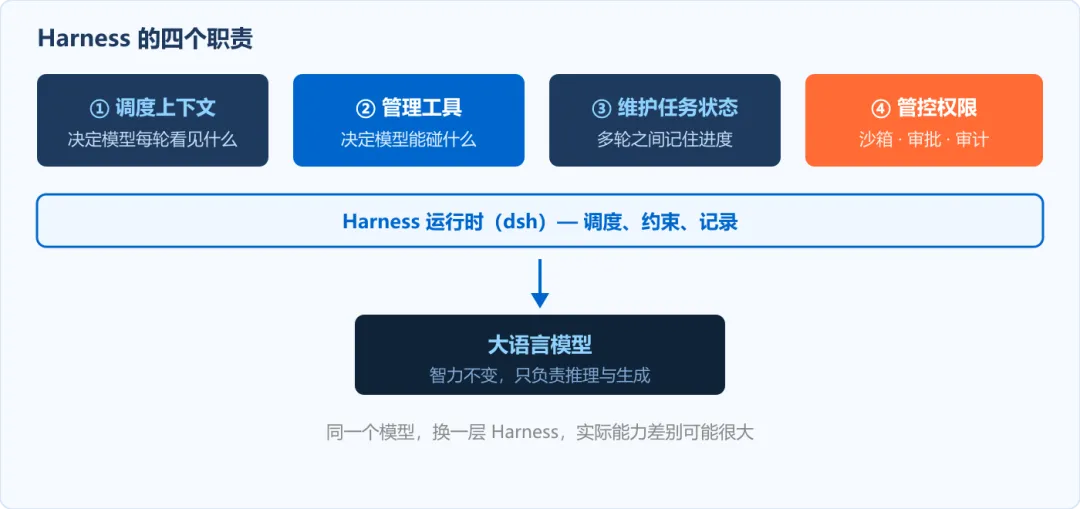
图 1 Harness 的四个职责:它不改模型,它改模型的输入、出口与边界
看一张对比表,同一个模型,有没有 Harness 的区别在哪里:
看一张对比表,同一个模型,有没有 Harness 的区别在哪里:
DeepSeek Harness(命令名 dsh)就是 DeepSeek 官方开源的这样一层运行时,MIT 许可,当前处在开发者预览阶段,我本机装到的版本是 0.2.0-rc.2。
它对外提供的入口不止一种形态:
| Web UI | dsh web | |
| Headless | dsh --profile headless "任务" | |
| SDK | dsh --profile sdk | |
| ACP | dsh --profile acp | |
| 自定义 profile | dsh --profile 你的名字 |
这里有个容易看漏的设计:SDK 和 ACP 不是两个独立可执行程序,它们本身就是 profile。同一个启动器,加载不同的插件组合,就变成不同的产品形态。这句话现在看只是个细节,到第三层会变成一个关键结论。
🚀 五分钟上手
只要机器上有 Node.js,一条命令就能起:
启动后按顺序做三件事:设置 → 模型里填 DeepSeek API Key(密钥写入即用,不用重启服务);选择工作区指向你的项目目录(不选工作区,输入框是灰的);然后让它跑一句
想从源码跑,则克隆仓库后 pnpm install,仓库根目录单独执行 pnpm run build,再用 pnpm dsh <参数> 运行 TypeScript 入口。源码路径的好处是:你改一行代码,HMR 会直接作用到正在运行的那个 Harness 上。
⚙️ 第二层:一切皆插件,这句话到底改变了什么
官方对 dsh 最核心的一句描述是:Everything is a plugin。它构建在 Cordis 这个插件框架之上。但"一切皆插件"如果只是营销词就没意思了,所以直接看它列出了哪些东西:
模型适配器、工具、技能、会话、沙箱、存储、调度、UI,以及 agent loop 本身,都是插件。
注意最后一项。连"调用模型、执行工具、循环往复"这个主循环都可替换。这跟"提供插件接口"是两件事:前者是在已有骨架上挂肉,后者是骨架本身也能拆下来换掉。
📦 一个插件有多小
官方文档里给出的"第一个插件"完整配置如下——真的就这么多:
框架在加载时调用 apply,把 ctx 交给你,你通过它注册能力。插件有函数、对象、类三种形态;需要的服务用 inject 声明,框架会等依赖就绪再加载你的插件。
还有一个机制值得单独拎出来:通过 ctx 注册的任何东西——事件监听、工具、定时器——在插件卸载时自动清理,不需要你手写 removeListener 或 clearInterval。如果确实有需要手动释放的资源(比如一条网络连接),用 ctx.effect() 把清理函数交回去。
我的判断:插件系统真正的分水岭不在"能不能加功能",而在卸载时干不干净。一个卸载会泄漏定时器和监听器的插件体系,用三个月就会变成一坨谁也不敢动的泥巴。dsh 把这件事做成了默认行为,而不是让每个插件作者自觉。
🧱 三种角色:能力怎么拆才不腐化
再加一个工具很简单,难的是让它可替换。官方对通用能力区分了三种角色,以 Bash 执行为例:
关键在于Provider 和 Consumer 互不依赖,它们只依赖 Service Definition。于是换执行后端(本机、远程、容器)时,定义和工具一行都不用动。文档里的建议也很克制:不要预防性拆分——只有当角色需要独立演进时才分不同的包。
🧩 Profile:配置不是一份文件,是一摞补丁
这一层是 dsh 相对特殊的地方,也是很多人第一次看配置文件会发懵的地方。
dsh.profile.bundles 顺序叠加)② profile 自己的 cordis.patch.yml③ home 级 $DSH_HOME/cordis.patch.yml④ --patch 指定的覆盖层配置树从空根开始,一摞层叠上去。--dump-default-config 和 --dump-config 可以在不启动的情况下把合成结果打出来看。
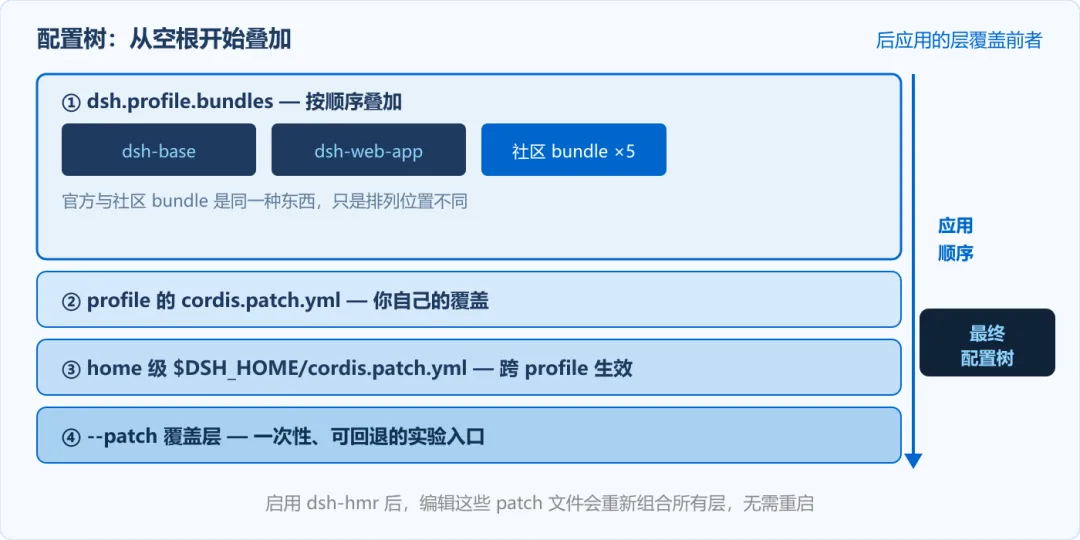
图 2 Profile 的补丁层栈:空根 + 四类层,越靠后优先级越高
我本机的 Web profile 实测就是这样叠的(~/.dsh/profiles/web/package.json):
官方 bundle 和社区 bundle 就是同一种东西,只是排列位置不同。这就是 profile 的威力:你不需要改官方代码,也能把界面、搜索、图像能力整条替换掉。
而且——启用了 dsh-hmr 时,它监视 profile manifest、profile 与 home 级 patch 文件,编辑后通过统一串行重载重新组合所有层,不用重启。我这次改配置就是改完直接生效的。
🚀 第三层:一个轮次里,运行时到底在做什么
前两层是"怎么看它",这一层开始是"它内部怎么运转"。这部分细节我建议你慢一点读,因为它解释了为什么长任务能不断、为什么崩溃后能接上、为什么模型有时"忘记"了你说过的话。
先看一次任务的整体数据流:
一个 Turn 与 Step 的完整闭环
▼
▼
▼
| 拒绝 / 首批为空 ▼ | 接纳 ▼ |
▼
▼
| 有 ▼ | 无 ▼ |
agent/turn-stopping 上执行取消。图 3 一个 Turn 与 Step 的完整闭环:橙色菱形为决策点,绿色为终态出口,蓝色回环表示工具执行后重新组装请求
这里有三个设计是"看得见的工程判断",不是随便定的:
第一,步骤的开启是有闸门的。组装完提示词与工具后,会先跑 agent/pre-step,被拒绝、或首批输入为空,就不打开步骤。重试时会复用同一份已渲染的组装结果,不会重复跑 pre-step、也不会重复放行用户消息。
第二,流的对外交付跟着持久化走。每次模型调用会发一个进程本地 start,但各个 chunk只在匹配的持久 assistant 帧结算之后才发出。这个顺序看着绕,但它保证了"你在屏幕上看到的"和"日志里记下的"不会不一致。
第三,取消不是删除。取消会保留已经流式交付给用户的文本;取消后未分发的工具调用会收到一对合成的 tool/call 加 ABORTED_BEFORE_DISPATCH 结果。目的是让后续请求拿到一份配对完整的工具历史。
💾 崩溃之后为什么能接上
这是我认为 dsh 最扎实的一块。dsh-session-checkpoint-policy 在三个位置强制刷新持久化:
策略很硬:持久写入成功之前,模型适配器或顶层工具正文不会运行。检查点失败按"失败即阻止"处理——宁可这一步不做,也不做一件没记录的事。
📉 上下文压缩:一套"有边界"的设计
长任务真正的敌人是上下文窗口。dsh-compaction-basic 提供四种行为:接近上限时自动压缩;提供方确认上下文溢出后先压缩再重试;/compact 按需压缩;挂载修剪器时,压缩前先修剪超大工具输出。
触发阈值不是拍脑袋的百分比,而是一个取小值的公式:
也就是说,它同时盯两件事:不能超过窗口的 80%,也要给模型输出和 65536 token 的余量留出空间。同一个后端服务不同上下文大小的模型时,可以用按模型覆盖各自设置阈值与保留量(例如 thresholdRatio: 0.7、retainTokens: 2048)。
压缩前还有一道更便宜的工序。工具结果超过阈值时会被改写为受限的头部+一段 "middle pruned" 标记+受限的尾部:
这套修剪有两个我非常欣赏的性质。一是它不发起模型调用,只是确定性切片,所以又快又免费,甚至能让后面的摘要压缩直接跳过。二是完整原始结果仍然保存在会话日志里,替换通过 sourceEventSeqs 引用原事件,因此可以安全回放、可以精确回收。给模型看的是压缩版,归档的是全量版——这个分离做得干净。
压缩用一次额外的模型请求,只保留返回的摘要文本。而它的边界是明确写在文档里的,这点比"我们支持超长上下文"诚实得多:
顺便说一个容易被忽略的精巧处:token 计量是回放持久会话日志算出来的,不调用模型,结果确定。所以压缩决策、占用显示、遥测三处读到的是同一份测量,不会出现"进度条说还有空间,压缩却已经触发"这种自相矛盾。
🔐 权限:三个独立机制,别混为一谈
模型能改你的文件,所以安全设计必须能讲清楚。dsh 把这件事拆成三层,各自独立:
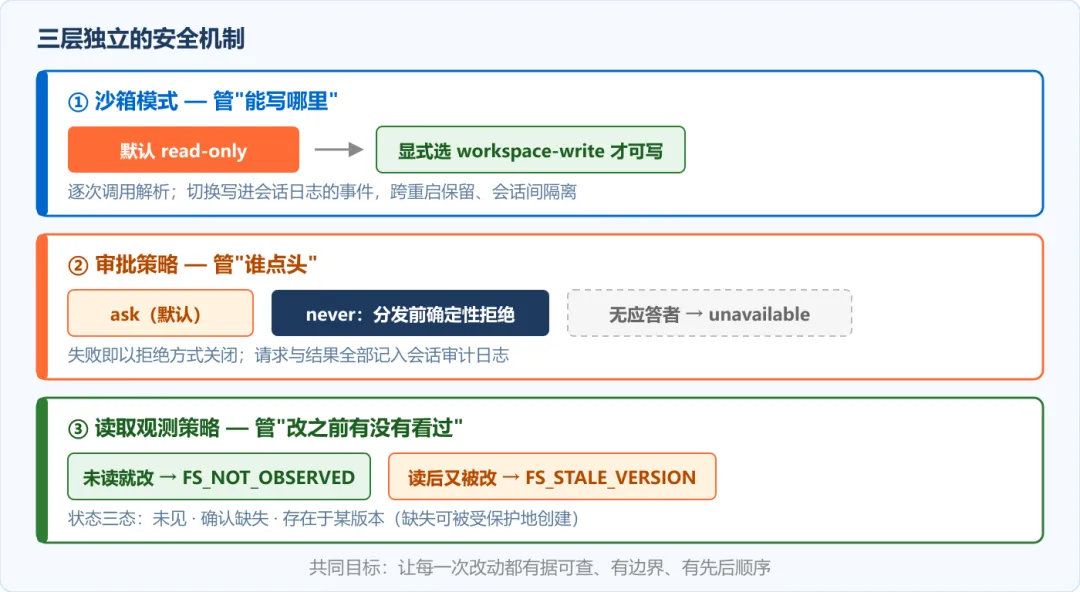
图 4 三层机制各管一件事:能写哪里、谁批准、改之前看没看过
① 沙箱模式(管"能写哪里")。默认是 read-only——这是故障安全默认值,需要写工作区必须显式选 workspace-write。它是逐次调用解析的,且模式切换是写进会话日志的一条事件,有效模式按 显式授权 → 事件折叠 → 部署默认 的优先级解析。两个后果很关键:切换能跨重启保留;两个会话绝不会看到彼此的模式。
② 审批策略(管"谁点头")。默认 ask,把每个请求交给应答者;never 则在分发之前确定性地拒绝每一个请求——文档明确点出这是 CI 与无人值守采用的严格无头模式。应答者缺失或失败时返回 unavailable,操作以拒绝方式关闭。每个请求与结果都记入发起会话的审计日志,但模型只看得到最终工具结果和当前策略,看不到人类权限 UI 与审计事件。
③ 读取观测策略(管"改之前有没有看过")。想覆盖或编辑一个文件,必须先读过它;读过之后文件又变了,编辑以 FS_STALE_VERSION 失败。没读过就改,报 FS_NOT_OBSERVED。它还维护三种状态——未见、确认缺失、存在于某版本:读取一个不存在的文件会把它标记为"确认缺失",所以后续 write 可以走受保护的创建流程建它,同时又不会覆盖并发创建者。
这三层合起来解决的是同一个问题:让"改动"这件事始终有据可查、有边界、有先后顺序。
👥 并行与后台:这些数字决定了它能扛多重的活
子代理有两种模式,用途完全不同:one-shot 默认等待子代理返回最终答案;continuable 默认在后台启动一个持久化子代理并返回 id,之后可以继续给它发消息。每个实例还能单独设置 persona、工具权限和深度限制,失败的运行返回错误,而不是部分成功。
后台任务有个细节值得说:任务属于所有者 agent,而不属于生产它的工具。所以重载工具或控制器不会杀掉任务;但拥有者被释放时,它的任务会被取消、快照移除。完成通知的投递也做了优化——繁忙的 agent 在下一步收到注入通知(inbox 还有内容时轮次无法结束,因此同时结算的多个任务只花掉一步),空闲的 agent 则由一个 follow-up 轮次唤醒。
💡 第四层:把它拆开改造
前三层你都在"用它"。这一层是把它当作一个可以改的运行时——也是 dsh 相对其他工具最大的区别。
🛠️ 最小可用的自定义工具
官方 defineTool 的写法如下。注意参数 schema 会自动推导并校验 args,而 execute 返回的是 output.schema 声明的规范值,再由 output.render 转成面向模型的内容:
用 --patch 挂上自己的覆盖层启动,模型立刻就能调用它:
三层组合已经通了:插件(能力注册)→ 工具(面向模型的接口)→ patch 层(配置装配)。这就是 dsh 的扩展模型,没有第四套概念要学。
🤖 更激进的一条路:让 agent 自己写插件
官方"创造模式"展示的能力是:用一句自然语言要求它写一个插件,它会加载 cordis-plugin-development 技能、读写插件文件、调用插件管理工具安装、再运行命令验证。官方示例里那个番茄时钟悬浮插件的完整闭环——写、装、验证——用时 5 分 24 秒。
我第一次看到这个例子时的反应是:"这不就是 agent 改自己的配置吗?" 对,但值得较真的是边界在哪:它能改的是插件层与配置层,而这些层本来就是设计给外部覆盖的。它不是在给自己打补丁绕过机制,它是在走公开的扩展路径。这个区别决定了这件事是能力还是隐患。
📚 技能(Skill)是怎么被找到的
技能有两种形态:目录 bundle(内含 SKILL.md)或平铺的 <name>.md 文件,以 YAML frontmatter 开头。两个细节值得注意:
一是它刻意不支持发现嵌套的 **/SKILL.md——这个"不做"减少了大量歧义与意外加载;二是扫描根目录有 rank 优先级,项目级(<projectRoot>/.dsh/skills 排 100、<projectRoot>/.agents/skills 排 200)会优先于用户级。并且它监视这些根目录——新增、改名或删除技能无需重启即可进入下一次目录。
控制粒度也做到了接口级:disable-model-invocation: true 把技能排除出模型目录,user-invocable: false 把它排除出用户命令。而且——如果拼写错了或写了非布尔值,整个技能会带着警告被丢弃,而不是静默允许某个接口。这种"配置错误就大声报错"的取向,在企业环境里比宽容更有价值。
🌐 编排:workflow 与 goal 的分工
当单个 agent 不够用时,dsh 给了一个很特别的能力:让模型自己写一段 JavaScript 来编排一批子代理。脚本里可用的钩子是:
三个约束让这个机制不至于失控:脚本没有文件系统、网络、定时器和 Node API——干活的是子代理,脚本只做编排;模型只看得到最终结果,永远看不到中间子代理消息,子代理的工作不会污染父级对话;前台运行会等待并始终 dispose,取消与失败返回错误而绝不把部分输出报告成成功。
而 dsh-goal 管的是另一种东西:一个长期完成目标,跨多轮、会话恢复、fork 与进程重启持续存在。它能 create、edit、pause、resume、complete、block 或 clear,比较并设置的更新会拒绝陈旧视图。官方对它用法的建议非常克制,值得原样引用:"常规单轮工作不应创建 goal"——而且每个会话最多保留一个当前目标。
⚠️ 说点不好的:当前的真实局限
官方文档在这一块写得比多数项目诚实,我逐条列出来并加上自己的判断:
1. 压缩不是万能的,超大工具调用仍可能撑爆上下文。系统提示词、工具定义、会话前缀都压不动,单个不可分单元也不能拆。这意味着工具设计得好不好,直接决定长任务能不能活下来——一个每次返回十万字日志的 bash 封装,会把整个自适应机制拖垮。配套的 pruner 能救一部分,但救不了结构性问题。
2. 没有内置轮次预算。这一点很关键:工具调用或 steering 会让当前轮次继续下去。文档明说限制失控轮次的策略必须从既有的生命周期扩展点(如 agent/turn-stopping)执行取消。"能跑很久"和"会一直跑下去"之间只隔一个策略插件——如果你要放它无人值守跑,这是必须自己补的一课。
3. 仍是开发者预览。当前 0.2.0-rc.2,官方明确说核心插件和基础 API 会持续迭代。把生产流水线压在 rc 版本上,要有跟着升级的心理准备和回归测试。
4. Windows 上的沙箱边界更复杂。我的实际体验是,Windows 下的受限模式会带来额外的执行约束(进程间管道、语言模式、路径 ACL 等),某些在 Linux 上顺手的操作需要换写法。跨平台团队应先在目标平台上验证,而不是假定行为一致。
5. 插件生态还年轻。装是能装,但质量参差。这也是为什么 profile 的分层设计在这里价值最大——每个社区 bundle 都是独立一层,出问题可以单独摘掉,不会牵动全局。
🔬 我的结论
如果你的期待是"一个更好的编程助手",dsh 可能显得复杂:它要你先理解 profile、patch 层和插件角色。但如果你的期待是"一套我能长期改造、并且在我机器上行为可预测的 Agent 运行时",那它当前的取舍是合理的——
它把几乎所有"要不要加个开关"的决策,都推给了插件层。代价是首次上手的心智成本,收益是:模型、工具、界面、主循环、权限策略,你都能换。
而它最值得学的一点,其实与插件无关:把"不确定的操作绝不重放"和"任何改动先落盘再执行"当作默认规则,而不是可选项。这两条,任何自建 Agent 系统都该抄。
下一步的具体建议,按投入排序:① 先用 npx @deepseek-ai/dsh web 跑通一个真实小任务;② 读 --dump-config 的输出,看清你自己的配置树到底叠了什么;③ 写一个只读的自定义工具(比如查你的内部工单接口),感受完整扩展链路;④ 最后才考虑补轮次预算与审批策略,再谈无人值守。
如果你的团队要把它接进生产,第一件必须自己动手补的能力是什么——是 轮次预算、审批策略,还是审计日志的落库?为什么?欢迎在评论区说说你的判断和踩过的坑。
📊 资料与引用
文中所有参数与默认值均来自 dsh 0.2.0-rc.2安装包内的插件文档与本机配置实测。预览版迭代较快,升级后请以--dump-default-config与官方文档为准。
如果这篇文章帮你省下了自己啃源码的几个晚上,点个「在看」让更多同行看到。关注我们,获取更多 Agent 运行时与工业 AI 前沿技术 🔧