ARTICLE · 1123545
AI应用的技术架构:从你到算力服务器的五层楼
你每天用的AI助手、智能客服、豆包、自主编程,背后并不是“一个程序直接算出答案”。你随口的一句话,要先穿过好几层“楼层”,一路下沉到最底层的算力服务器,再被一层层把答案托举回来。这是“算力+AI应用”技术架构系列的第一期。今天先不抠技术细节,只干一件事:给你一张全局架构图,把每一层“是干什么的”讲清楚。
一、先看全景:一栋五层的大楼,各司其职
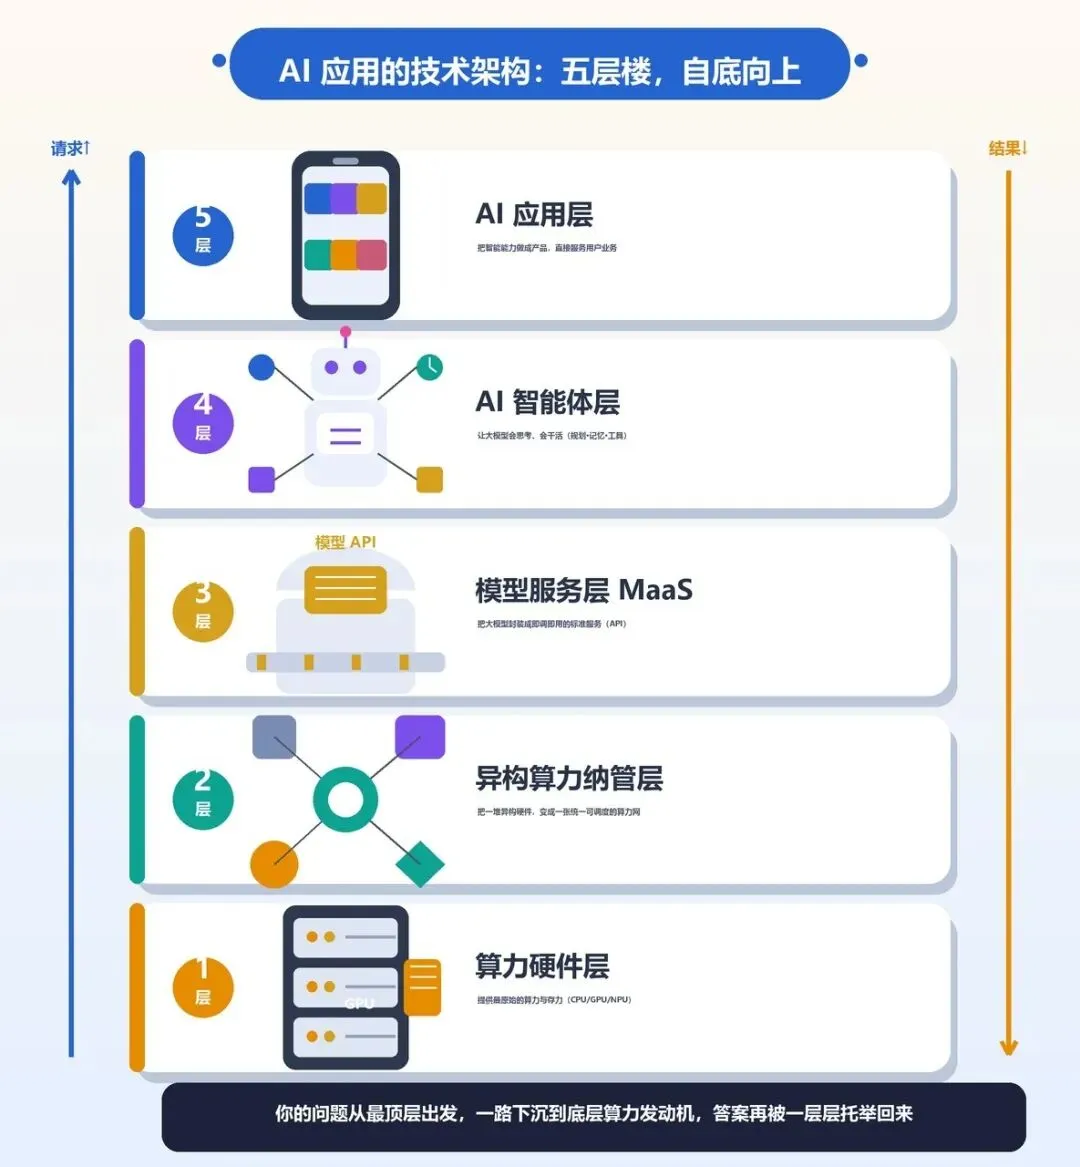
打个比方,这套架构就像一栋五层的大楼(图中自下而上):
1. 第1层(最底层)是“发电车间”——算力硬件;
2. 第2层是“配电调度室”——异构算力纳管;
3. 第3层是“能力营业厅”——模型服务;
4. 第4层是“智能管家”——AI智能体;
5. 第5层(最顶层)是你看得见的“店面”——AI应用。
你的问题从顶楼出发往下走,算力从底楼往上供,一来一回,答案就出来了。下面自底向上,一层层说。
二、第1层(最底层):算力硬件层——发动机房
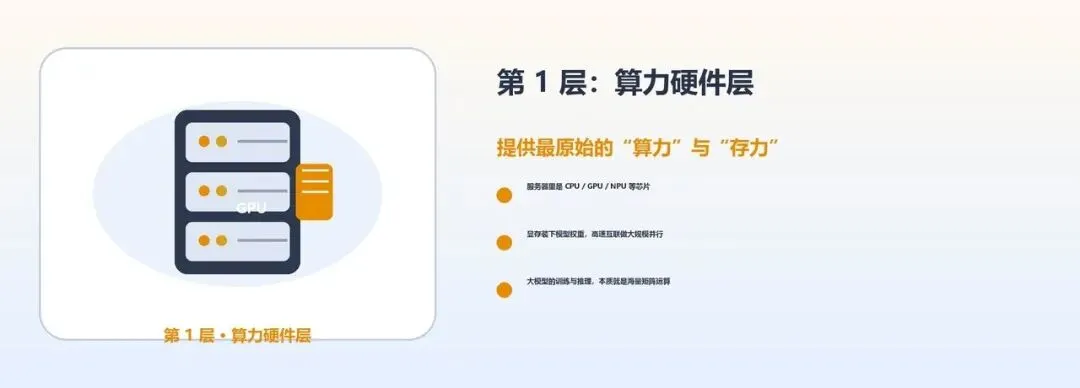
这一层是谁:一台台算力服务器。核心能力:提供最原始的“算力”与“存力”。
拆开看,里面是CPU、GPU、NPU这些芯片,加上大容量显存、高速互联网络(NVLink、InfiniBand这类)和大规模分布式存储。大模型的训练和推理,本质上就是海量矩阵运算——而这正是GPU这类加速芯片的主场。
一句话:没有这层,上面的一切都是空中楼阁。
三、第2层:异构算力纳管层——调度中枢
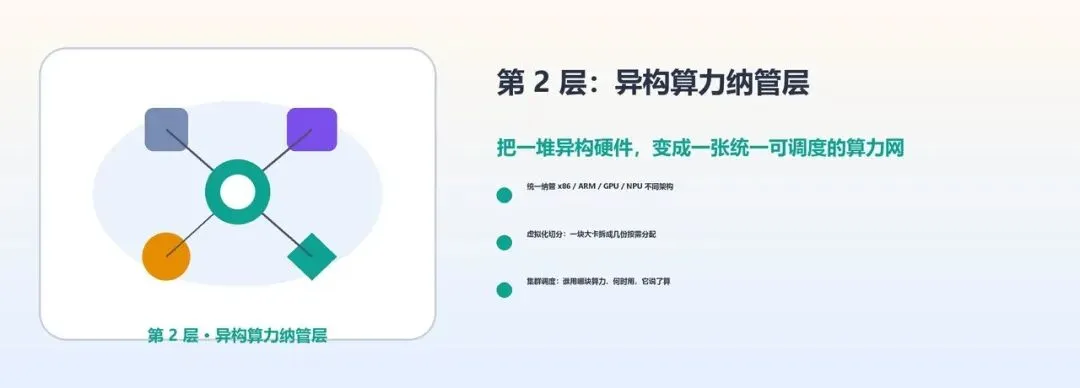
这一层是谁:算力池化与调度平台。核心能力:把一堆五花八门的硬件,变成一张统一可调度的算力网。
现实中的算力中心,芯片品牌和架构五花八门:x86、ARM的CPU,各家GPU、NPU……如果让每个应用自己去适配每一种硬件,成本高到没法做。这层做的事就是“统一收编”:
1. 统一纳管:不同品牌、不同架构的算力卡,全部纳进一个资源池;
2. 虚拟化与切分:把一块大算力卡切成几份,按需分配给不同任务;
3. 统一调度:哪个任务用哪块算力、什么时候用,它说了算。
一句话:上层完全不用关心“算力长什么样”,只管申请使用。
四、第3层:模型服务层(MaaS)——能力营业厅
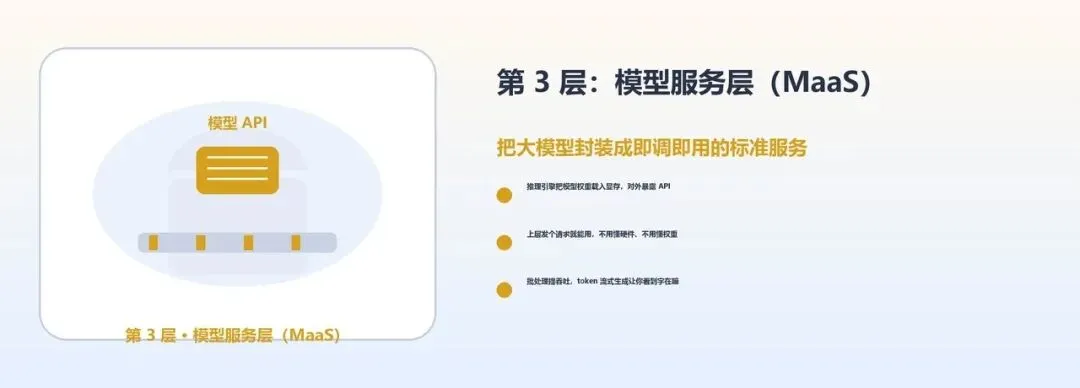
这一层是谁:部署在算力上的大模型+推理引擎。核心能力:把大模型封装成“即调即用”的标准服务。
工程师用推理引擎(vLLM、Triton、TensorRT-LLM这类)把模型权重载入显存,对外暴露一个标准API。从此,上层想用模型,不用懂硬件、不用懂权重,发一个请求过去就行。
这层还要让模型“跑得又快又稳”:批处理提升吞吐,并发调度支撑很多人同时用,token流式生成让你看到字一个个“蹦”出来。
一句话:它把“算力”变成了“模型能力”,是承上启下的关键一层。
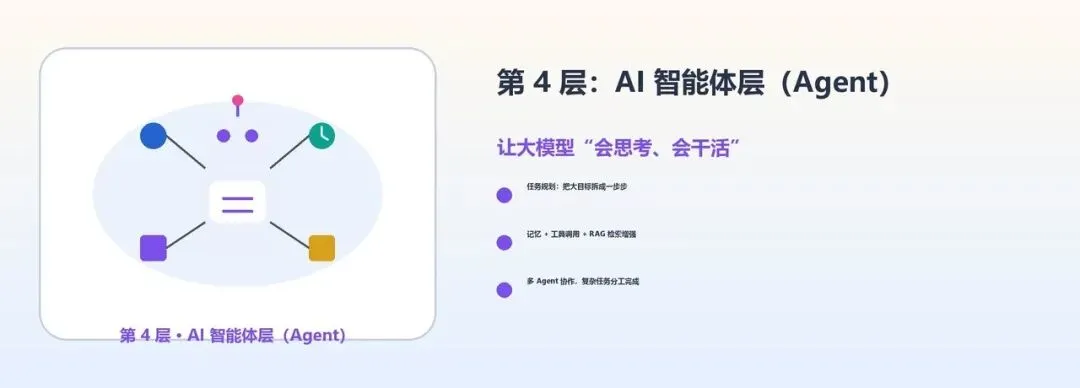
五、第4层:AI智能体层(Agent)——智能管家
这一层是谁:Agent框架与编排系统。核心能力:让大模型“会思考、会干活”。
大模型本身只会“接着你的话说下去”,并不会主动做事。Agent层给它装上“手脚”和“记性”:
1. 任务规划:把“帮我汇总数据写汇报”拆成取数→分析→成文几步;
2. 记忆:记住你前面聊过什么,上下文不断片;
3. 工具调用:需要查数据库、发邮件时,去调对应的工具;
4. RAG检索增强:回答前先去知识库里“翻资料”,答得更准;
5. 多Agent协作:复杂任务拆给多个“虚拟员工”分工完成。
一句话:这层把“模型能力”编排成“能完成任务的智能体”。
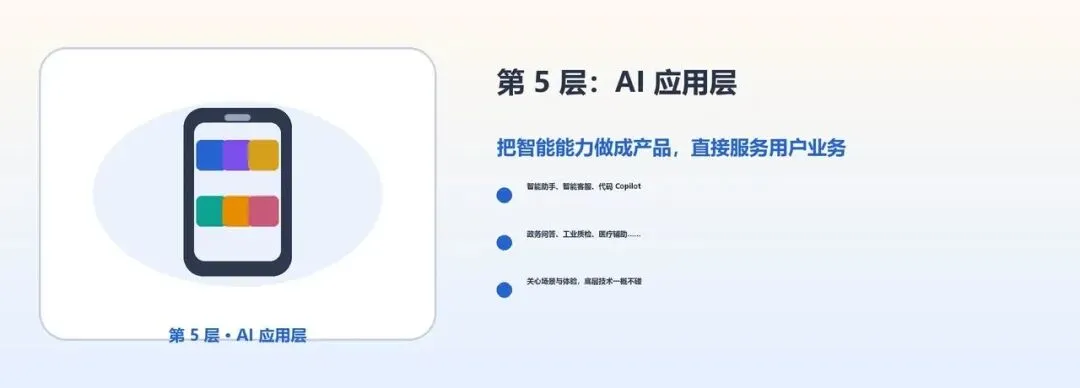
六、第5层(最顶层):AI应用层——你看得见的店面
这一层是谁:各类AI产品与行业应用。核心能力:把智能能力做成产品,直接服务用户业务。
智能助手、智能客服、代码Copilot、政务问答、工业质检、医疗辅助……都是这层的产物。它关心的是场景和体验,底下的技术细节一概不碰。
一句话:用户只跟这层打交道,其余四层都在幕后默默发力。
七、它们怎么串起来:一次调用的往返
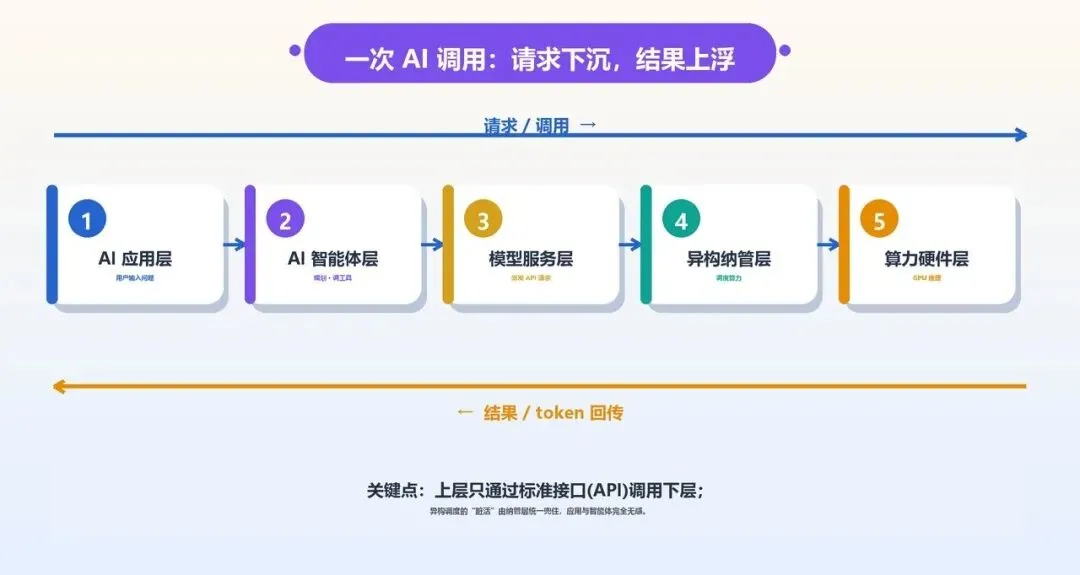
结合下面这张链路图,走一遍完整流程:
1. 你在应用层输入:“帮我汇总本周销售数据并写成汇报。”
2. 应用层把任务交给智能体层;
3. 智能体做规划,通过标准API调用模型服务层;
4. 模型服务把请求派发到异构纳管层调度的算力上;
5. 算力硬件层的GPU完成推理,逐token生成结果;
6. 结果沿原路逐层回传,答案回到你眼前。
注意两个关键点:
一是上层只通过标准接口调用下层——所以换芯片、换模型,上层几乎无感;
二是异构调度的“脏活”由纳管层统一兜住——这正是“算力像水电一样即取即用”能成立的原因。
八、下期预告
第一期先搭好这栋“五层楼”的全局框架。从下期开始,我们从最底层的算力硬件层往上,一层一层往深里拆:每层的关键技术要点是什么、业界主流方案有哪些、选型时怎么权衡。想先听哪一层,欢迎留言告诉我。
THE END