ARTICLE · 1125274
清华NeurIPS亚军作震动AI圈:我们全被骗了?强化学习根本没让大模型学会推理
一记重锤,狠狠砸向了过去一年全球AI界最狂热的造神运动。
2026年9月,一条推文在技术圈掀起风浪:“清华证明了,强化学习根本没有让大模型学会推理!”
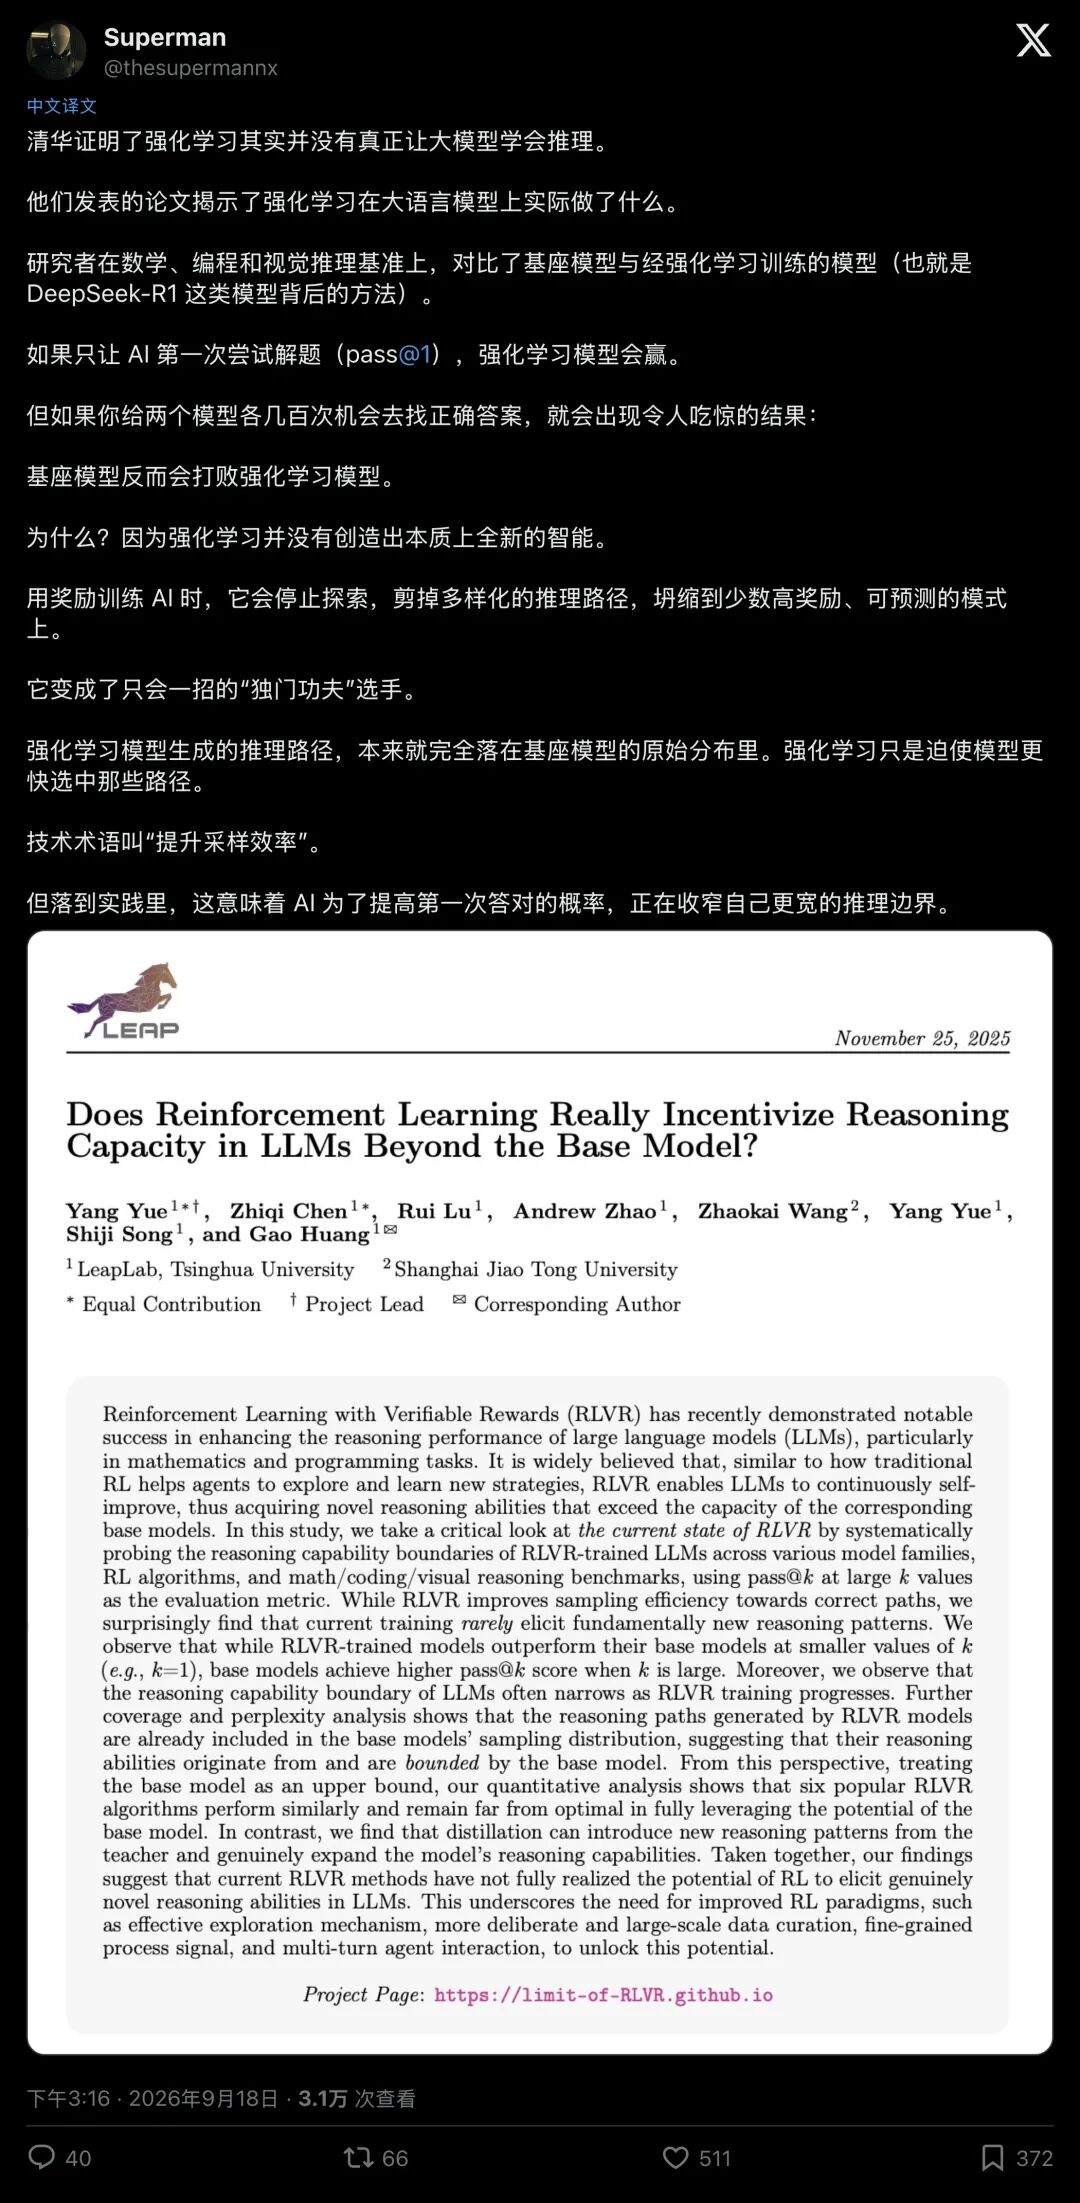
▲ 社交媒体上引发全网热议的传播帖,直指强化学习的神话破灭
配图里那张看似枯燥的技术架构图,瞬间被转发数千次。评论区里,研究员和工程师们吵得不可开交。
要知道,过去一年多里,无论是OpenAI的o1,还是国内外的各种“深度思考”模型,都把数学竞赛和代码评测的分数刷到了人类难以企及的新高度。所有人都在传颂一个几乎成为公理的神话:给模型套上可验证奖励的强化学习(RLVR),大模型就会像当年的AlphaGo一样,在黑盒里自己左右互搏,无中生有地顿悟出人类从未教过的全新推理逻辑。
难道,我们奉为圭臬的“AI自主进化之路”,从头到尾只是一场被算力包装出来的幻觉?
这篇震撼业界的论文,究竟揭开了什么残酷的真相?
01幻灭的起点:给模型256次机会,神话瞬间穿帮了
把这层窗户纸捅破的,是来自清华大学LeapLab黄高团队与上海交通大学的研究者。
这篇题为《Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?》的论文,不仅斩获了顶会 NeurIPS 2025最佳论文亚军(Best Paper Runner-Up),还拿下了 ICML 2025 AI4Math最佳论文。
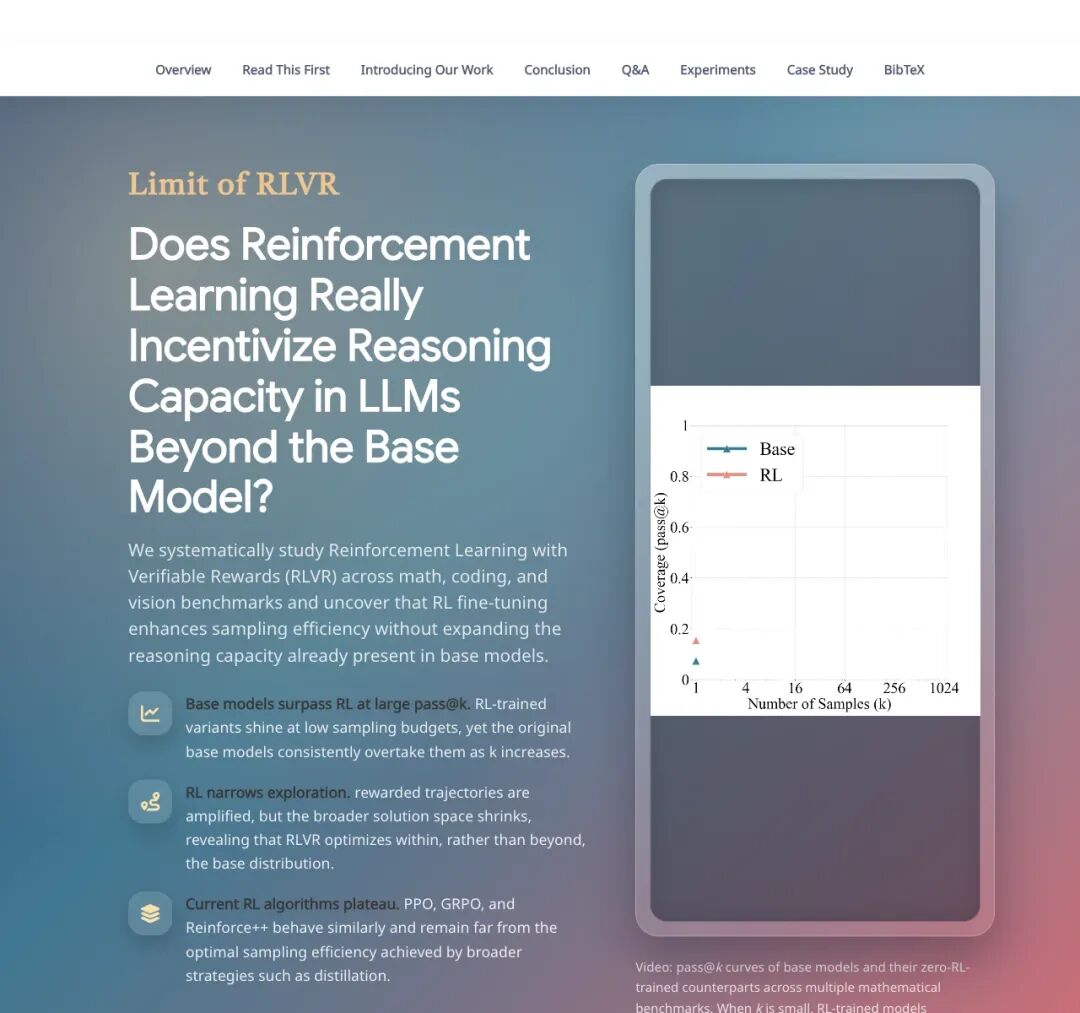
▲ 论文项目主页直截了当地点出核心发现:基座模型在大样本下全面反超
他们做了一件极其聪明、却又极其残忍的实验。
以往大家评测大模型,通常只看它“回答一次能不能做对”,学术上叫 pass@1。在这个指标下,强化学习训练后的模型确实战力惊人,往往能把准确率翻倍,把未调优的“毛坯”基座模型打得落花流水。
清华团队提出了关键质疑:模型第一次就做对,到底是因为它变聪明了,还是仅仅因为它更擅长猜你想要的答案?
为了测定模型能力的边界,他们引入了 pass@k,简单说,就是给模型 $k$ 次作答机会,只要这 $k$ 次尝试里有任意一次做对了,就算这道题属于模型能够解决的“能力范围”。
如果强化学习真的拓宽了模型的思维边界,赋予了它全新的解题智慧,那么不管给它1次机会还是256次机会,强化学习模型都应该全方位碾压基座模型。
可实验结果,却让所有人倒吸一口凉气:
在 $k=1$ 的时候,强化学习模型确实一骑绝尘;但随着给的尝试机会越来越多,$k$ 放大到几十、上百时,没有经过任何强化学习的原始基座模型一路狂飙,最终竟然反超了强化学习模型!
实验还暴露了一个矛盾现象:随着强化学习训练的深入,模型的单次命中率(pass@1)虽然一直在涨,但它在海量尝试下能覆盖的题量总数(pass@256),不仅没有扩大,反而在剧烈收缩。
也就是说,模型刷题越多,它能够解决的问题总范围,反而变窄了。
02残酷的真相:它根本没长新脑子,只是被训成了流水线做题家
为什么会发生这种不可思议的反转?
清华团队的深入分析揭开了一个冰冷的事实:当前的强化学习,根本没有让大模型产生任何根本性的新能力,它所做的一切,不过是一场极其高明的“概率锐化”(Sharpening)。
我们可以用一个通俗的类比来理解:
未经过强化学习的基座模型,就像一个思维天马行空、但极其粗心的大脑。它的脑子里其实塞满了人类文明的所有知识,给它一道极难的奥数题,它第一次动笔可能会胡思乱想写跑偏;但如果你给它256张草稿纸,让它不受约束地发散思维,它大概率能在某一张草稿纸的角落里,灵光一现撞出极其精妙的正确解法。
当前的可验证奖励强化学习(RLVR),充当着严酷的应试流水线教头。
这个教头拿着小皮鞭站在一旁:只要答案对,就给奖励;只要答案错,就严厉惩罚
模型为了在单次考试中拿到高分,迅速找到了生存策略:它开始疯狂修剪自己的思考路径。它把自己记忆库里最稳妥、最容易蒙对、最模式化的那一两条套路死记硬背,反复强化;而那些冷门、罕见、但可能通往更难问题探索的灵感枝桠,全都被它无情地抛弃了。
论文中的困惑度和覆盖率分析给出了实锤证据:强化学习模型吐出的所有正确解法,百分之百都已经存在于基座模型原本的长尾采样分布里。
它没有走出过围墙一步它只是把你原本藏在抽屉最深处的那张正确答卷,挪到了最上面;代价则是把整个抽屉里其他五彩斑斓的解题可能性,全给烧掉了。
基座模型本身,才是决定能力上限的绝对天花板。
03舆论撕裂:这是学术打脸,还是虚惊一场?
论文一出,整个技术圈瞬间被撕裂成两大阵营。
激进的悲观派立刻举起大旗,有人甚至发推高呼:“又多了一个停止盲目硬堆强化学习的理由!”
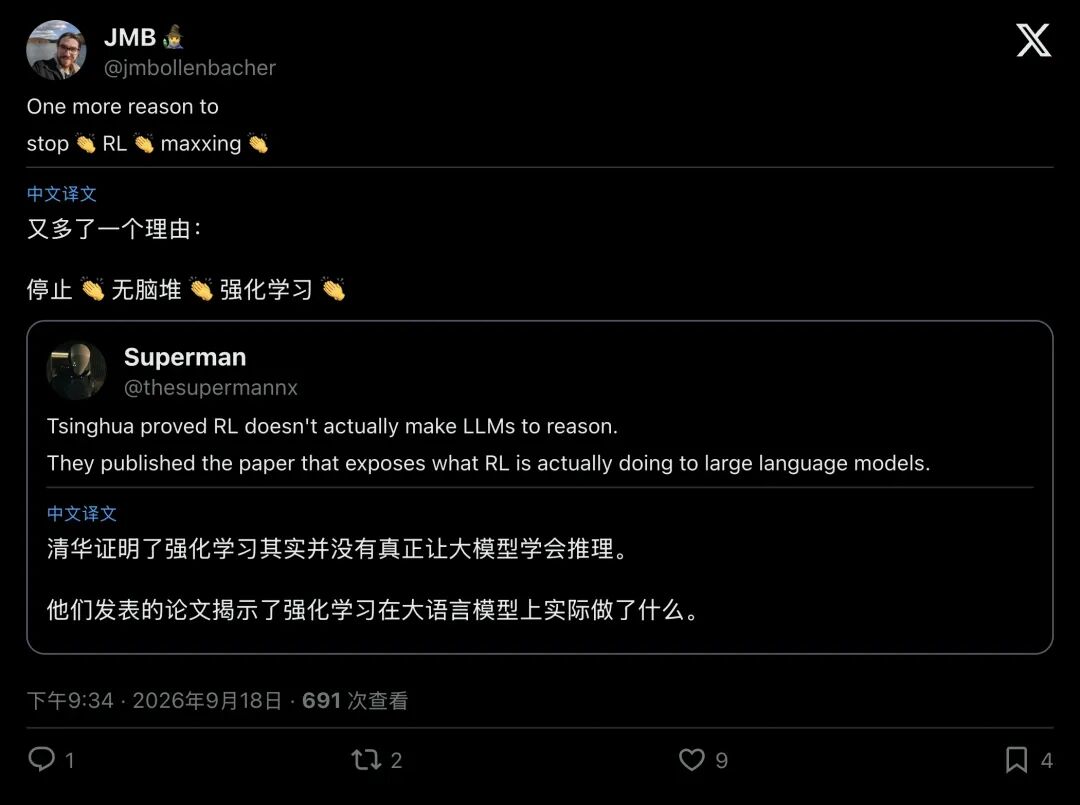
▲ 社区中出现的简化行动口号:“又多了一个停止无脑硬堆RL的理由”
他们认为,既然强化学习不能带来智能跃迁,那么过去一年各大巨头疯狂比拼算力、试图用强化学习堆出AGI(通用人工智能)的狂欢,完全是一场南辕北辙的资源浪费。
但反对和质疑的声音同样极其敏锐
有学者直接搬出硬核反例:OpenAI在国际信息学奥林匹克竞赛(IOI)的评测中,推理模型在采样成千上万次($k$ 极大)的情况下,依然保持着无解的超高得分。如果高样本下必然被基座反超,OpenAI的这一现象又该如何解释?
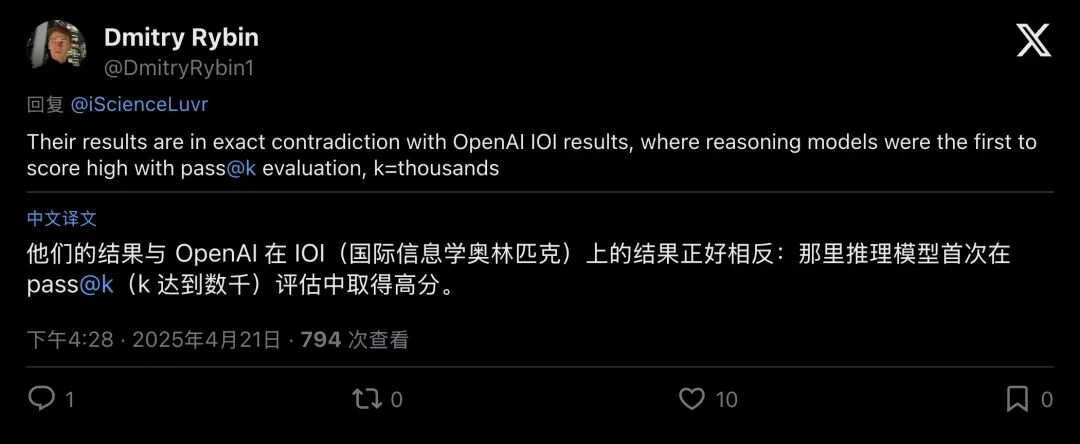
▲ 评论区学者针锋相对:这是否与OpenAI在竞赛级代码任务上的大样本结果相悖?
紧接着,后续的反驳论文也迅速跟进例如arXiv:2506.14245的研究就直指核心痛点:清华这篇论文只看“最终答案对不对”,这本身就存在漏洞。基座模型在大样本下试了256次,中间过程可能全在胡说八道,最后只是瞎猫碰上死耗子蒙对了答案;而强化学习模型哪怕答错,步骤往往也是严密的。如果换用要求过程完全正确的 CoT-Pass@K 指标来衡量,强化学习依然在拓展真实的逻辑边界。
更有工业界的工程师在讨论中留下一句直击本质的反问:“一个专家做判断,95%的时间都是对的;一个门外汉胡言乱语预测了所有可能性,恰好覆盖了正确答案。难道我们会说门外汉比专家更聪明吗?”
这场争论不仅没有停歇,反而把整个AI界逼到了一个必须直面现实的十字路口:既然强化学习可能只是在“炒冷饭”,为什么全球顶级科技公司依然在不计成本地疯狂死磕它?
04算力账本的毒打:学术界的理智,扛不住商业街的账单
答案很简单,也很残酷:因为真实世界根本买不起基座模型的“大器晚成”。
学术研究可以在实验室里不计成本地让模型跑256次,然后挑出一个正确的写进论文。但在商业落地的战场上,这是足以让任何一家公司当场破产的自杀行为。
让我们翻开大模型部署的底层账本,看看大样本采样在现实中有多昂贵:
根据高性能推理系统 vLLM 的架构机制,大模型每生成一个字,都要反复读取显存中的自回归缓存(KV Cache)。这是一种极度受限于显存带宽(Memory-Bound)的计算过程。
此时,算力开销呈绝对线性增长如果你为了保证回答正确,让基座模型并发采样256次:
你的GPU显存开销会瞬间被放大256倍; 你的服务器电费和算力账单会直接飙升256倍; - 系统延迟急剧恶化
。原本用户等1秒就能拿到答案,现在并发阻塞让系统陷入瘫痪,首字吐出延迟被拉长到几分钟。
在商业竞争中,没有任何一个真实用户会愿意坐在屏幕前等几分钟,只为了让你在256个胡言乱语的草稿里“摇号”摇出一个真理。
在工业界眼里,Pass@1是唯一的生死线。
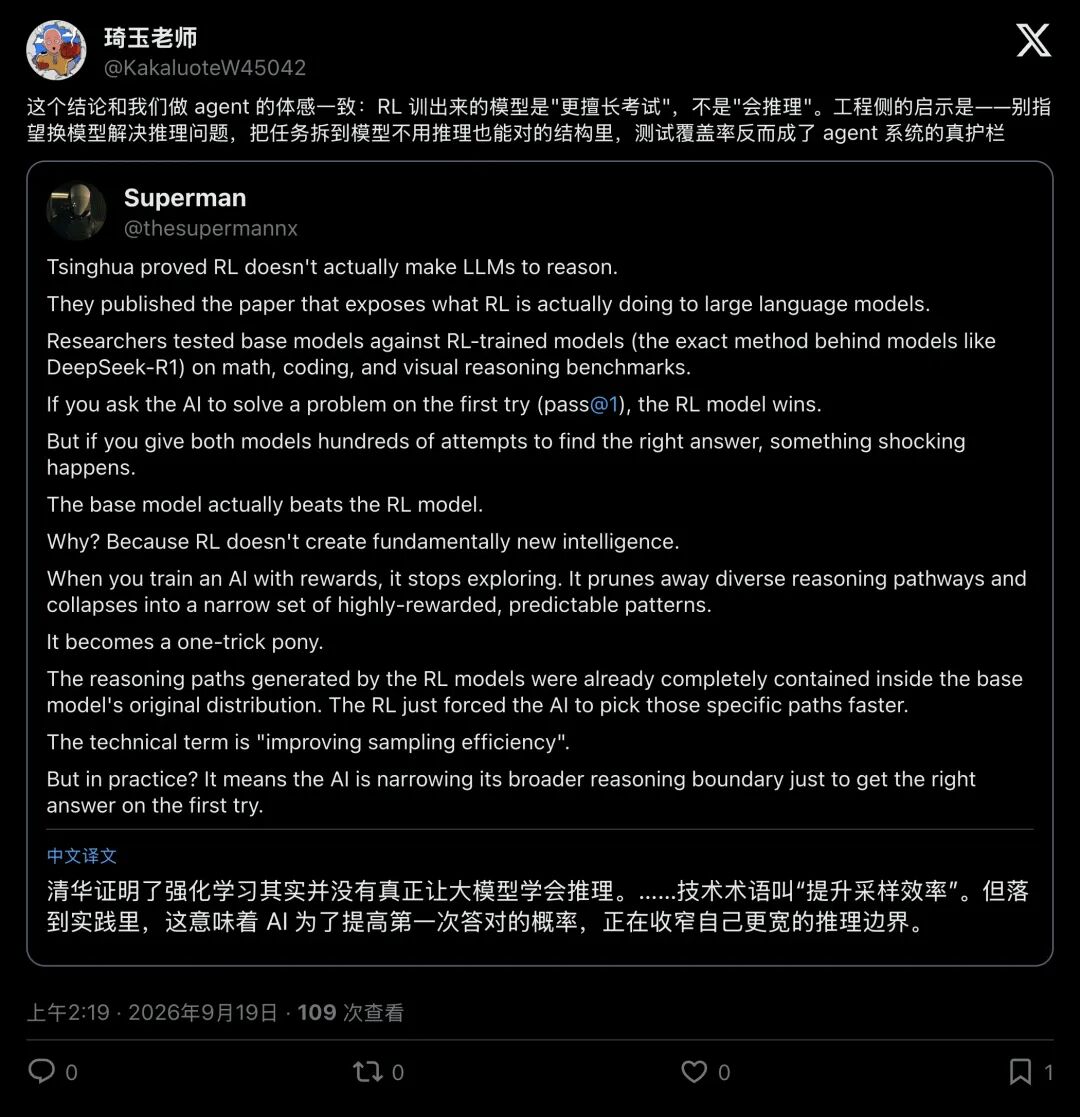
▲ 一线从业者的共鸣:做Agent的体感完全一致,工程落地关键在确定性,不必空等单模型顿悟
强化学习哪怕没有拓展一寸新的思维领地,但只要它能把基座模型原本需要采样256次才能碰巧撞对的奇迹,压缩到第1次尝试就以99%的置信度稳稳吐出来,它就拥有无可替代的商业统治力。
这项技术构成了百亿美元真金白银换来的坚固工程护城河。
05突围之路:既然单脑有极限,下一代智能体往哪走?
看清了强化学习的“锐化”本质,工程师们反而从盲目的算力迷信中彻底清醒了过来。
如果单靠给模型喂奖励、搞死磕式强化学习无法突破基座的宿命,未来的AI该怎么走?
业界正在经历一场深刻的范式转移:放弃把大模型训练成全知全能的单体神明,转向系统化的智能体(Agent)工程架构。
结合顶尖AI智能体架构的设计思想,破局的战役正在三个维度全面打响:
第一,用工作流解耦超长推理既然单模型在长链条下容易崩溃,成熟的企业级架构就不再让模型“一步登天”。工程师用有限状态机(FSM)或有向无环图(DAG),把一个极其复杂的系统工程拆解成几十个环环相扣的微型任务。模型在每一步里只需要调用它被强化学习锐化过的极高pass@1精度,输出确定性极强的结构化指令。
第二,用外部沙箱打破“验证器困境”强化学习之所以在数学和代码上好使,是因为这两者有绝对客观的编译器和答案;但在法律、医疗、商业决策等开放场景中,根本不存在确定性的打分器。工业界的解法是引入沙箱闭环(Tool-in-the-Loop):让大模型负责意图识别,把复杂的数值计算交给外部的Python环境,把数据检索交给数据库SQL,把规则审计交给确定性代码。
模型负责充当高爆发的火花塞,而精密的工程机械骨架负责传动与兜底。
06神话破灭之后,AI走向成熟
清华大学这篇拿下NeurIPS亚军的论文,之所以在发表一年后依然能掀起滔天骇浪,恰恰是因为它在全行业最狂热、最盲目的时刻,递上了一把冰冷而精确的手术刀。
它刺痛了那些沉迷于“AI马上就要自我迭代、超越人类智力极限”的科幻狂想,却给脚踏实地的工程师和科研人员照亮了前路。
大模型并没有像某些预言家吹捧的那样,在神秘的算法黑盒里诞生出自主的灵魂;当前的强化学习,也绝非点石成金的造神法术。
但这丝毫不妨碍它成为人类历史上最强大的生产力工具之一。
当一个行业不再盲目等待虚无缥缈的奇迹,开始老老实实算清楚每一笔算力开销、打磨好每一个工程部件时,属于AI的工业革命,才算正式拉开序幕。