ARTICLE · 1125878
AI不引用你的网站?问题出在「结构」,不是字数
AI不引用你的网站?问题出在「结构」,不是字数认知:大模型读网站的方式已经变了 做 GEO(生成式引擎优化)的企业正面对一个新局面——大模型理解网站的方式,与搜索引擎完全不同。搜索引擎靠爬虫做全文索引,收录单位是「页面」;大模型依靠检索增强生成(RAG)抓取内容,理解的是「实体与关系」。这意味着过去「内容堆量、关键词铺密」的 SEO 打法,在 AI 场景下正在失效。 取而代之的是一套新的地基:结构化语义资产,由三块组成——Schema.org 结构化数据、llms.txt 站点摘要、高信息密度正文。三者叠加,决定大模型是否「信任」你的内容并把它纳入回答。这不是锦上添花,而是地基层面的更换。 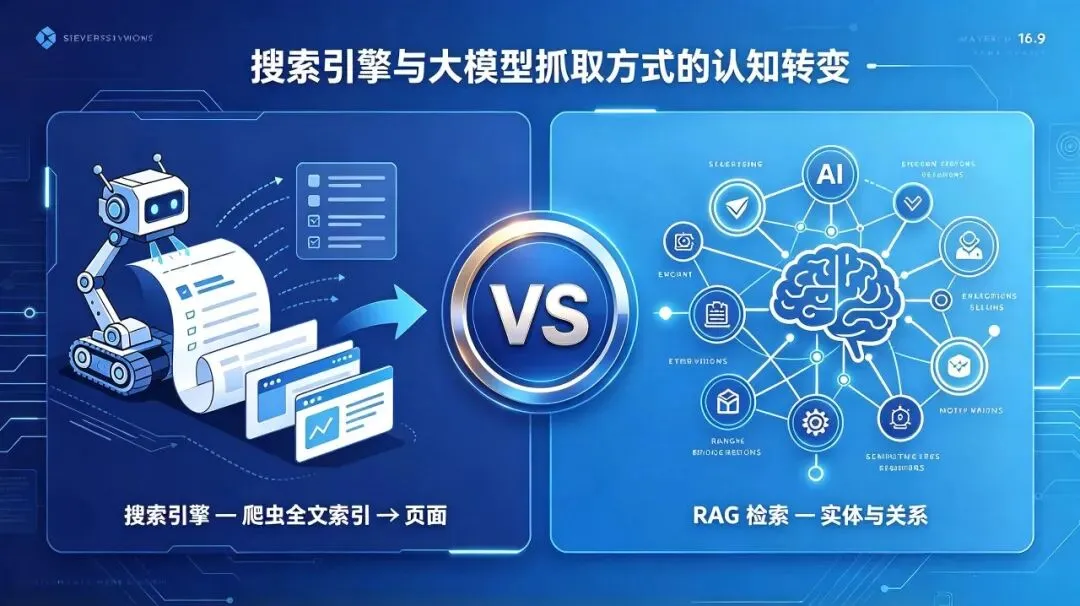
分析:为什么「内容多」不再等于「被引用」 很多企业困惑:网站几百篇文章,为什么 AI 回答里没有我?可以从大模型的工作机制找到答案。 第一,LLM 有「引用预算」。模型生成回答时不会塞入所有检索结果,只有一个有限的 grounding budget,只能挑选最相关的少量片段。内容越多、信息越稀,被挑中的概率反而越低——注水长文在 AI 场景里是有害的。 第二,模型偏爱「自包含片段」。搜索引擎可以容忍上下文依赖,读者会翻页;大模型抽走的是一个个独立片段,每段都必须自洽。铺垫型、依赖上下文的文字无法被单独引用。 第三,格式决定可抽取性。直接问答、专有统计、结构化对比这类格式边界清晰、语义完整,更容易被 AI 抽取引用,也就是常说的「Citation Bait(引用诱饵)」。 第四,结构能抑制 AI 幻觉。信息模糊时模型会「脑补」,这是幻觉的主要来源。结构化语义资产提供了唯一、明确、可验证的表述——口径越统一,模型越不需要猜。 结论很直接:AI 引用争夺战,打的是结构,不是字数。
原理:三块地基各解决什么问题 地基一:Schema.org——建立实体关系图谱。基础用法只是「单页标注」,要让大模型真正理解,需要用到高级写法 @id 与 @graph:@id 给实体一个全局唯一标识(如公司、产品、人的 URL),避免同名混淆;@graph 把页面上的多个实体放进一张关系图,显式声明「公司 A 生产产品 B」这类关系。这才能构成大模型能读懂的「全域知识图谱」。 地基二:llms.txt——站点级结构化摘要。这是新兴的站点根目录文件,作用是给大模型提供「整站速览」:站点是谁、提供什么、核心页面在哪。它与 Schema 互补——Schema 让模型读懂单页,llms.txt 让模型读懂整站,配合起来模型才能在几毫秒内判断「这个站点值不值得信」。 地基三:信息密度——正文的「自包含」改造。前两块解决「机器读得懂」,这一块解决「读了愿意信」。普林斯顿大学 KDD 2023 的研究显示:引用权威信源、提供具体数据、包含专家引语的内容,可将 AI 回答中的可见性提升 30–40%。落地为三个写作动作:结论前置、数据具体、句式自包含。 三块地基共同争夺的,是AI 模型采信权——品牌能否被元宝、豆包、DeepSeek 等模型引用,决定了 AI 场景下的可见度。 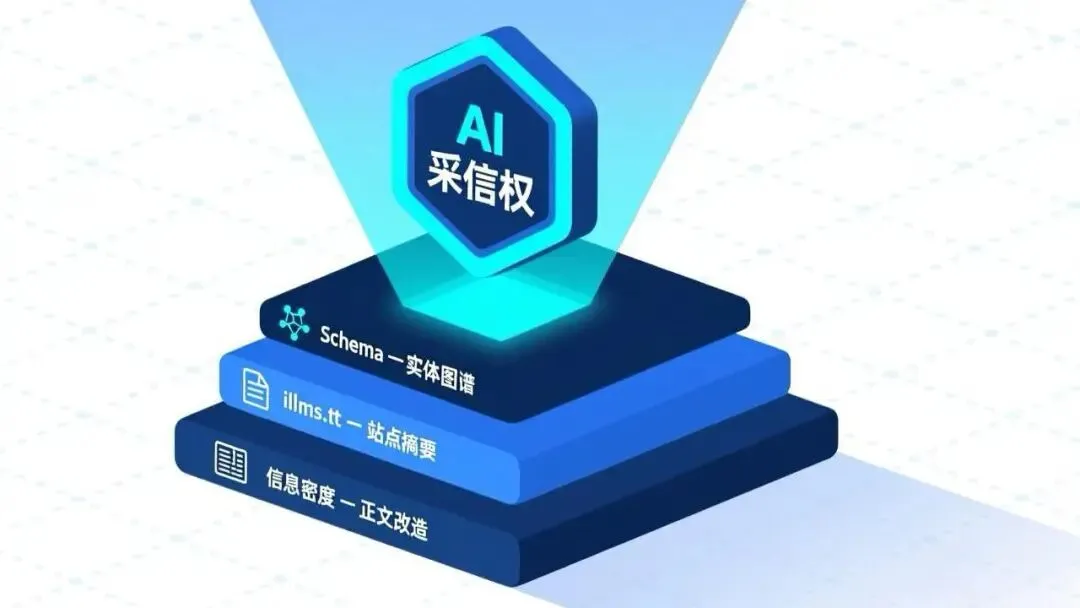
方法:四步部署实操 第一步:部署 Schema 高级用法。在首页、产品页、关于页加入 JSON-LD 结构化数据,用 @graph组织 Organization 与 Product 等实体,每个实体给 @id(用固定 URL 作为全局唯一标识),实体间关系用 {"@id": "..."} 引用表达,而不是重复贴信息。注意:Schema 是地基不是银弹,它让模型「读得懂」,但「信不信」取决于内容质量与权威数据源建设。 第二步:部署 llms.txt。在站点根目录创建该文件,用纯文本 Markdown 书写。要点:首行放一句话定位,让模型 3 秒内判断站点价值;每个链接配一句话描述,不放裸链接;只保留最有价值的 10–20 个链接,宁缺毋滥。 第三步:正文信息密度改造。三原则——①结论前置:每段第一句给结论,模型抽走第一句即可用;②数据具体:把「行业领先」换成「服务 200+ 企业,续约率 85%」这类可验证表述;③句式自包含:避免「如上所述」「前文提到」这类依赖性连接词。改造前后对比: ❌ 我们的产品在行业内拥有广泛的应用场景和良好的用户口碑,能够帮助企业实现数字化转型。 ✅ 我们的 GEO 套件已服务 200+ 企业,平均续约率 85%,覆盖制造、零售、金融三大行业。 第四步:设计 Citation Bait 内容。刻意生产易被 AI 抽取的格式:①直接问答页(FAQ),一个问题一段答案,答案自包含;②专有统计数据页,发布行业调研、白皮书数据并标注口径来源;③结构化对比页,用表格呈现产品或方案对比。同时要兼顾「人」的可读性——Citation Bait 是在好内容之上做结构优化,不是替代。 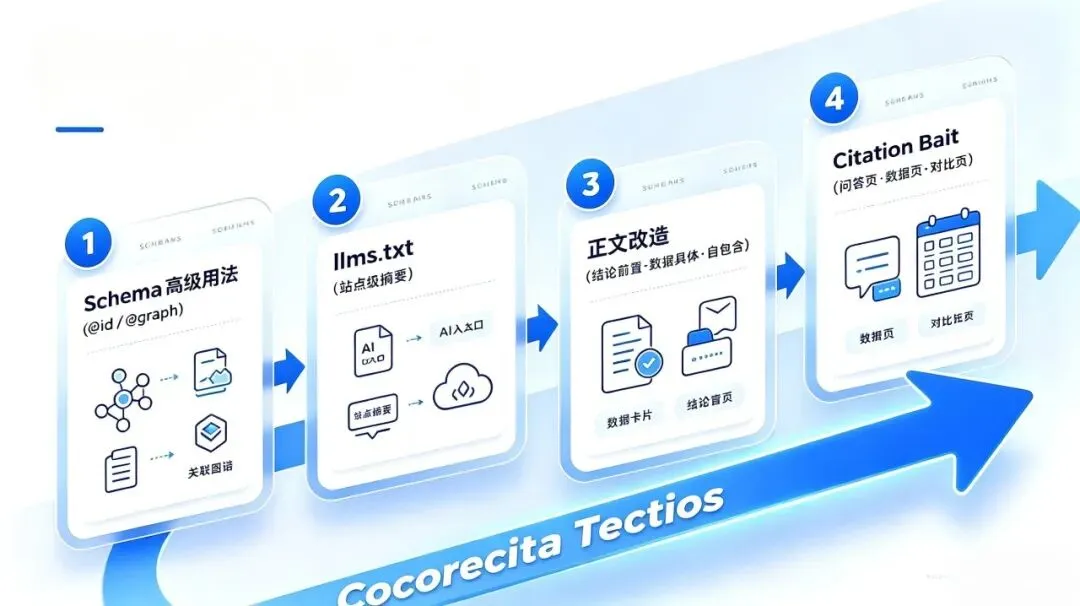
避坑:四类「伪结构化」 Schema 只标不联:只加基础类型不用 @id/@graph,实体之间没有关系,等于白标; llms.txt 塞满全站:几百个链接全塞进去,模型抓不到重点,要克制; 改造只做首页:模型引用的往往是产品页、FAQ 页,核心页不做等于没做; 为 AI 注水:堆砌术语和数据反而破坏可读性——密度是筛选,不是堆砌。 结语 Schema @id/@graph 让模型读懂实体关系,llms.txt 让模型读懂整站,信息密度改造与 Citation Bait 让内容更容易被抽取引用——三层合力才构成真正可用的结构化语义资产,缺一不可。人工逐页维护的工作量会随站点规模快速膨胀,这也是企业逐步转向一体化 GEO 基础设施、用权威数据源节点统一管理语义资产的原因。地基打牢,AI 采信水到渠成;结构化语义资产,是当前 ROI 最确定的 GEO 投入。 如果你想定制本地专属GEO获客方案,欢迎和知世AI增长运营团队深度沟通。
01
—
02
—
03
—
04
—
05
—