ARTICLE · 1125950
当企业有 5000 个 AI 工具,MCP 该怎么管?Uber 给出了一个生产级答案
当企业有 5000 个 AI 工具,MCP 该怎么管?Uber 给出了一个生产级答案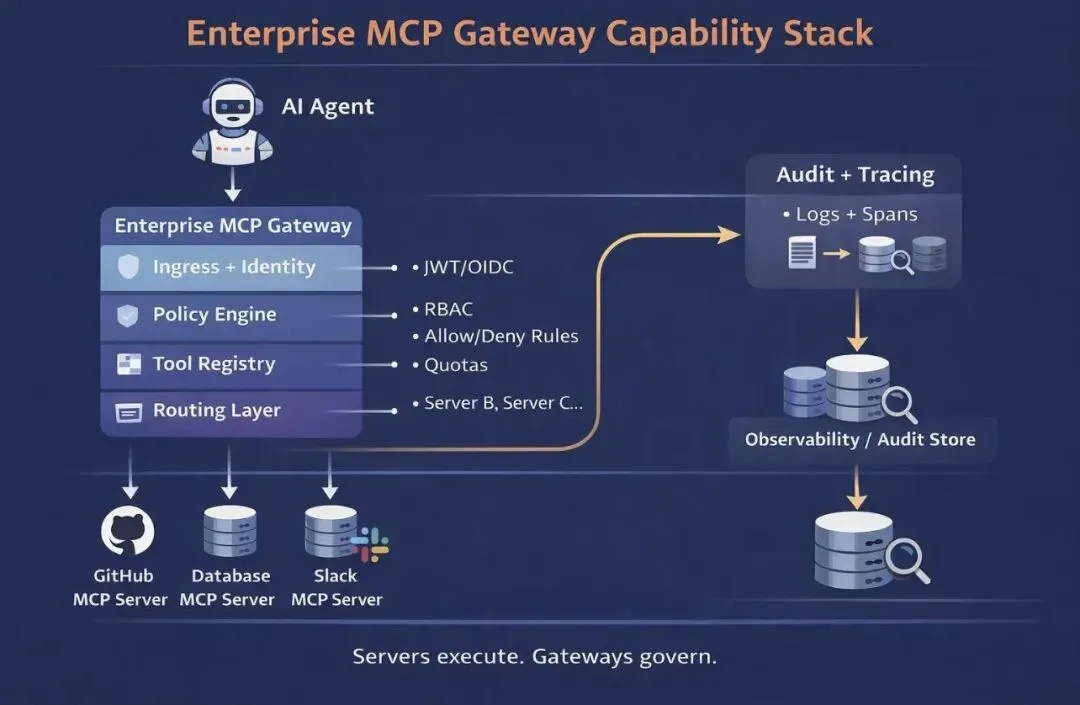
过去一年,MCP 几乎成了 Agent 世界的“通用插座”。给 Claude、ChatGPT 或自己的 Agent 接上 MCP Server,再挂几个工具,模型就能查数据库、读文件、调用 API。Demo 做起来并不复杂。 但 Uber 最近公布了两个数字:800+ MCP Server,5000+ Tools。 到了这个规模,问题就完全变了。你不可能把 5000 个工具的定义全部塞给大模型,也不能让几百个 MCP Server 各自管理认证、权限、审计和敏感数据。Uber 内部本来就已经存在大量 HTTP、gRPC、TChannel 服务,难道为了 AI,还要重新开发几百套 MCP Server? Uber 给出的答案很直接:在 Agent 和企业现有系统之间增加一层 MCP Gateway。 小规模 MCP 很简单: AI Agent → MCP Server → Database / API 三五个 MCP Server、十几个 Tool,基本不需要复杂治理。但大型企业完全不是这个数量级。内部可能已经存在几百甚至几千个微服务,以及数据库、ERP、CRM、Git、Kubernetes、监控平台和大量内部 API。 如果每个团队都独立建设 MCP Server,很快就会出现过去 API 时代非常熟悉的问题:有人用 OAuth,有人用 API Key;有人有审计,有人没有;有人只开放几个安全 Tool,有人恨不得把整个后台 API 全部交给 Agent。最终甚至没人能准确回答:公司到底有多少 MCP Server?哪些 Agent 正在使用它们? Uber 没有选择重新改造所有后端服务,而是在现有服务前面增加 MCP Gateway: AI Agent → MCP Gateway → HTTP / gRPC / TChannel / MCP → Existing Enterprise Services Gateway 负责协议转换、服务发现和统一治理。原来的企业 API 继续运行,不需要因为 Agent 的出现全部重写。 这其实给大型企业采用 MCP 提供了一条很现实的路线: MCP 不一定要替代 API,更可能成为 Agent 访问现有 API 的统一入口。 这和二十年前 API Gateway 出现时的逻辑非常相似。企业并没有因为 API Gateway 出现就重写所有业务系统,而是在既有系统之上建立统一的访问、认证和治理层。现在,只不过访问这些系统的主体开始从 Application 变成 AI Agent。 MCP 规模扩大以后,Uber 遇到的另一个问题:模型根本不应该知道所有工具。 一个 MCP Tool 通常包含名称、Description、Parameters 和 JSON Schema。十几个工具问题不大,但如果有 5000 个 Tool,把所有定义全部注入 Prompt,不仅会大量消耗 Token,还会挤占真正用于业务数据和推理的 Context。 于是问题从“模型会不会调用工具”,变成了“模型如何从几千个工具中找到正确的那个”。 Uber 的 Omni MCP 没有简单地扩大 Context Window,而是引入了逐级发现机制: discover_server → discover_tools → get_tool_schema → invoke_tool Agent 先寻找可能相关的 Server,再发现其中的 Tool;确定真正需要使用哪个工具后,才获取完整 Schema 并执行。 这个设计看似只是工程优化,背后其实有一个很重要的思路变化: 过去:Load Everything → LLM Choose 现在:Understand Intent → Discover → Retrieve → Execute 这和搜索引擎、RAG 的逻辑非常相似。我们不会把整个互联网塞进模型,而是先搜索,再把相关内容送进 Context。同样,企业也没有必要把 5000 个 Tool 全部告诉 Agent,而应该让 Agent 先找到需要的工具。 这对本地 Qwen、DeepSeek 等模型尤其有价值。解决 Context 不够,并不一定意味着不断从 32K 升到 128K、256K。另一个更经济的办法是: 不要把当前任务根本用不到的信息放进 Context。 未来企业级 MCP 很可能因此形成自己的Tool Search / Tool Retrieval体系。某种意义上,Tool 也开始需要“检索增强”。 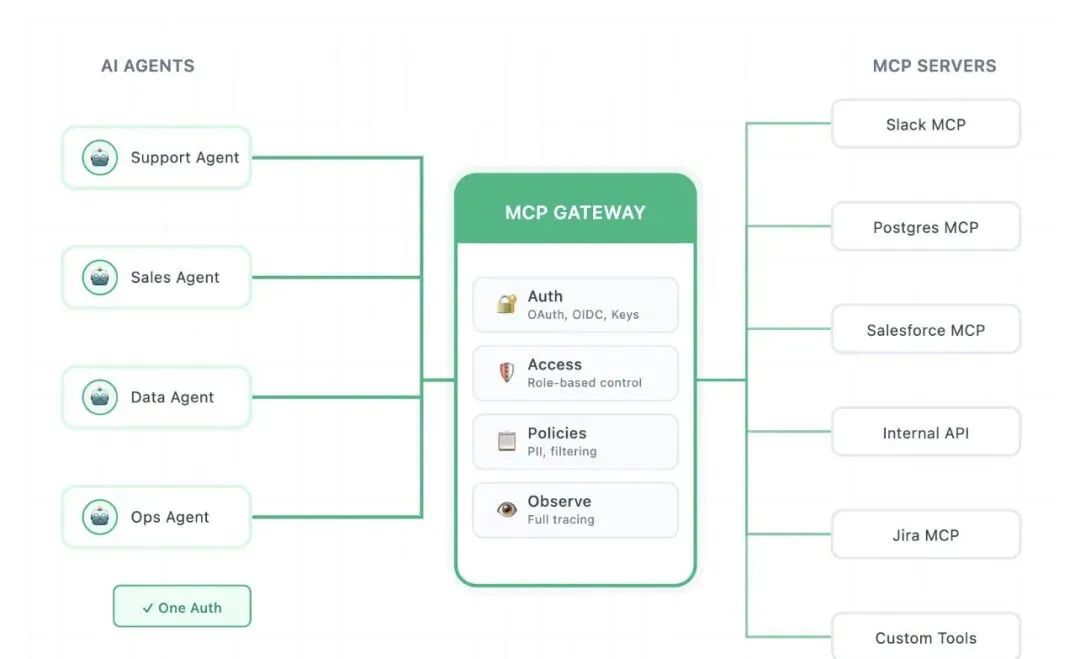
Uber 架构中还有一个很容易被忽略、但我认为非常重要的设计: Discovery doesn’t imply exposure。 系统可以自动发现企业内部的 API,也可以自动生成相应的 MCP Tool,但新发现的 Tool 默认处于Disabled状态,必须经过服务 Owner 审核之后才能真正暴露给 Agent。 这个设计非常关键。 想象一下另一种模式:系统自动扫描企业内部 API,今天发现 300 个接口,马上生成 300 个 MCP Tool,明天所有 Agent 就可以直接调用。技术上很自动化,安全上却可能是一场灾难。 所以真正合理的企业 MCP 应该遵循: Auto Discovery ≠ Auto Authorization 发现可以自动化,授权必须独立治理。 甚至连 Tool Description 都不能再被简单看成一段说明文字。对于传统 API,Description 主要是给开发人员阅读;但在 Agent 世界里,它会影响模型什么时候选择这个 Tool、如何理解这个 Tool,以及用什么参数调用它。 换句话说,Tool Description 已经从“文档”变成了影响运行行为的配置。 因此 Uber 对这类配置同样引入变更、审批和回滚机制。这也是 MCP 从开发者工具走向企业基础设施之后,一个很典型的变化:过去没人关心的一段描述文字,现在可能直接影响生产系统的执行路径。 继续看 Uber 的架构,会发现 MCP Gateway 已经不只是负责协议转换,它开始承担越来越多企业基础设施能力: Authentication、Authorization、Tool Discovery、Rate Limiting、PII Redaction、Ownership、Observability。 这些词听起来非常熟悉,因为 API Gateway 几乎走过同样的道路。 最早的 API 解决“系统之间怎么调用”,后来随着 API 数量增加,企业开始需要 Registry、Gateway、IAM、Rate Limit、Developer Portal、Observability 和 Governance。 MCP 很可能也会经历类似的演进: MCP Protocol → MCP Registry → MCP Gateway → MCP IAM → MCP Observability → MCP Governance 到了这里,MCP 就不再只是一个让模型调用工具的协议,而开始形成一套真正的Agent Integration Infrastructure。 未来企业 Agent 架构可能越来越像这样: AI Agent→MCP Gateway / Agent Control Plane→ Identity · Policy · Tool Discovery · Approval · Audit · Observability→ MCP / HTTP / gRPC / Database / SaaS→Enterprise Systems Agent 可以提出“我要调用这个工具”,但真正决定它能不能调用的,不应该是模型本身,而是模型之外的控制层。 这也是企业 MCP 和个人 MCP 最大的区别。 个人环境里,我们关心的是“能不能调用”;企业环境里,更重要的是“谁在什么条件下,可以调用什么,而且出了问题能不能追溯”。 还有一个容易被低估的问题:如果 Agent 每天通过 MCP Gateway 发起几百万次 Tool Call,出了问题怎么查? 传统应用我们看 Log、Metric、Trace。Agent 同样需要 Telemetry,只是调用链会变得更长: User Request → Agent → LLM → Tool Discovery → MCP Gateway → Tool Call → Enterprise API → Database / Service 一次完整的 Agent Trace,未来至少应该回答几个问题:哪个 Agent 发起了请求?使用了哪个模型?为什么选择这个 Tool?谁允许它调用?参数是什么?访问了哪个后端系统?耗时多少?结果是否成功?有没有访问敏感数据? 当企业只有 5 个 Tool 时,日志不完整也许还能人工排查;当企业拥有 5000 个 Tool、几百个 Agent 时,没有完整 Telemetry,系统实际上已经无法治理。 传统 APM 关注的是: Service → Service Agent 时代则增加了一条新的链路: Intent → Model → Tool → Service 未来 Observability 平台需要理解的不只是“哪个 API 慢了”,还要理解“为什么 Agent 会调用这个 API”。 这可能是 Agent Observability 与传统 APM 真正的区别。 把 Uber 的实践压缩下来,其实就是三件事。 第一,不要为了 MCP 重写所有 API。企业过去十几年积累的 HTTP、REST、gRPC 服务依然有价值。MCP 更适合作为 Agent 与现有系统之间的新接口层,而不是重新发明企业 IT。 第二,不要把所有 Tool 都塞给模型。当工具数量达到几百、几千之后,Tool Discovery 会成为基础能力。Context Management 最终是架构问题,而不仅仅是模型 Context Window 大小的问题。 第三,发现不等于授权。Agent 能发现什么,和 Agent 能调用什么,必须分开。自动发现、人工或策略授权、统一审计,才是生产级 MCP 应有的治理方式。 一项技术真正进入企业的标志,往往不是 Demo 做得越来越炫,而是开始认真解决那些“不好看”的问题:权限、成本、审计、变更、容量、故障和治理。 过去一年讨论 MCP,大家最关心的是:谁支持 MCP?有多少 MCP Server?能接多少工具? 这些问题很快会变得不那么重要。 当 MCP 真正进入企业以后,客户最终会问的是另一组问题: 公司到底有多少 MCP Server?5000 个 Tool 怎么搜索?谁可以调用哪个 Tool?敏感数据怎么控制?Tool 修改谁审批?Agent 调用了什么怎么审计?出现异常之后,整条调用链怎么追踪? 到了这个阶段,真正重要的已经不是: “支不支持 MCP?” 而是: “能不能把 MCP 管起来?” Uber 的800+ MCP Server、5000+ Tools,真正值得关注的并不是数字有多大,而是它让我们提前看到了 MCP 规模化之后的样子。 MCP 的上半场解决的是: 让 AI 连接工具。 它进入企业之后的下半场,解决的则是: 让成千上万个工具,被 AI 安全、低成本、可观察、可治理地使用。 如果这个判断成立,那么未来真正重要的产品形态,可能不再只是一个个 MCP Server。 而是位于所有 Agent 与企业系统之间的那一层: MCP Gateway。 它很可能会像当年的 API Gateway 一样,从一个不起眼的基础组件,逐渐成为企业 AI 架构中的关键控制点。
从“接一个工具”到“管理 5000 个工具”
5000 个 Tool,首先撑爆的可能不是系统,而是 Context
一个比 5000 个 Tool 更重要的原则:发现,不等于授权