ARTICLE · 1126043
AI4PDEs 96「International Journal of Mechanical Sciences」一种通过场映射构建的新型物理信息神经网络
AI FOR SCIENCE · 第 96 期
不再逐点问网络:PFNN 如何把整组坐标一次映射成整片物理场
场输入、宽输出与数值差分,换一种方式学习高频、多尺度、应力集中和电热耦合
论文档案 · PAPER PROFILE
论文原标题A novel physics-informed neural network via field mapping
中文标题一种通过场映射构建的新型物理信息神经网络
作者:Bo-Xun Sun、Chen-Xu Liu✉、Gui-Lan Yu✉、Jiang Li、Zhanli Liu
第一署名单位:北京交通大学土木建筑工程学院(School of Civil Engineering, Beijing Jiaotong University)
发表期刊:International Journal of Mechanical Sciences2025 年 8 月 2 日收稿 · 2026 年 2 月 22 日修订 · 2026 年 2 月 28 日接收 · 2026 年 3 月 2 日在线发表 · 第 316 卷 · 文章编号 111462
开源代码:作者公开了论文四组主算例的代码目录,覆盖 Helmholtz、热传导、弹性平衡和电热耦合;仓库当前未提供正式发布版本或独立归档版本。
作者 GitHub 代码仓库(四组主算例):https://github.com/BoXun-Sun/Physical-field-neural-network-PFNN
01 如果一次把整片场都交给网络,会发生什么
普通物理信息神经网络的基本问法很直观:给定一个空间或时间坐标,网络返回这个位置的位移、温度或速度。为了覆盖整个区域,同一个小网络要在成千上万个配点上重复前向传播,再通过自动微分计算每一点的偏导。问题越高频、尺度差越大、局部尖峰越陡,这种逐点问答越容易同时遇到表达和计算瓶颈。
这篇论文提出的物理场神经网络 PFNN,换了一个看似激进的接口:不再把一个坐标点当成一个样本,而是把全部配点的坐标信息编码成一个场输入;输出端也不再用少数神经元代表整类物理量,而是铺开一个超宽层,让每个输出神经元对应一个离散位置上的物理量。一次前向传播,直接生成整片场。
先分清:这不是网格无关的神经算子
PFNN 的输入长度、输出长度和差分邻接都绑定当前离散网格。它学习的是一个固定配点集合上的场求解器,不是训练一次后可任意更换网格、几何和参数的 DeepONet 或 FNO。
02 场输入与宽输出,怎样把全局难题拆成局部职责
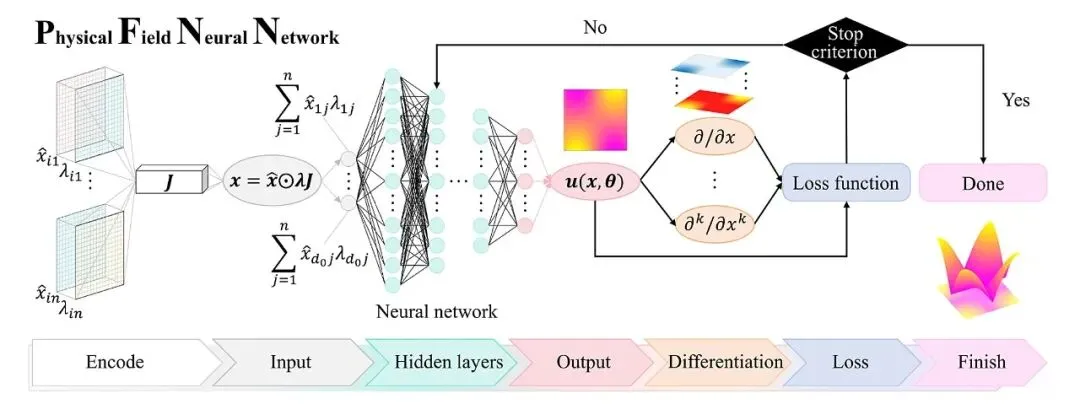
图 1|物理场神经网络(PFNN)的架构
PFNN 架构图最值得看的是两端。输入侧把每个配点的多维坐标乘上可训练编码系数,再沿坐标维求和,形成一个长度等于配点数的向量;输出侧则为每个位置分配独立神经元。中间隐藏层只处理一个携带整场信息的样本,不再随配点数重复执行。作者据此解释了为何隐藏层运算量能够大幅下降,而宽输出又保留了逐点刻画尖峰的自由度。
从坐标矩阵到离散物理场
坐标矩阵 X̂ × 可训练编码 Λ → 场输入 x
x → 隐藏层 → 超宽输出 ur
u = P + D ⊙ ur
P 是满足初值或 Dirichlet 边界的特解,D 是距离或指示函数;这个变换让相应边界条件在训练前就成立。
不是凭空消掉自由度这种设计可以理解成一次职责重排。传统 PINN 用同一个输出神经元在全域拟合一种物理量,所有位置共享同一条表达通道;PFNN 让每个输出单元只负责一个位置,等于把复杂全局曲面拆成许多相对局部的学习任务。它并没有消灭自由度,而是把计算从“很多样本反复穿过隐藏层”转移到“一个样本配上很宽的输入和输出层”。
坐标究竟怎样变成一个输入设离散区域有 N 个配点,每点有 x、y 或时间等坐标。PFNN 先给每个“点—坐标分量”配一个可训练系数,再在同一点的坐标分量上求和,于是得到长度为 N 的编码向量。这个向量保留了每个位置的身份,却把原本 N 个逐点训练样本改成一个包含整场坐标的样本。编码系数不是装饰:附录 B.2 比较了可训练、固定常数和高斯随机版本,其中某些固定或随机设置的误差明显放大;作者因此在主实验采用初值为 1 的可训练编码。不能把“任何场输入都有效”当成本文结论。
速度从哪里来,又转移到哪里去传统 PINN 每次迭代让许多坐标样本穿过同一组隐藏层;PFNN 的隐藏层只处理一条场样本,因此隐藏层矩阵乘法不再随配点数重复。代价是第一层要读入 N 维编码,最后一层还要输出每个配点的物理值;配点加密或物理场增多时,两端宽度、参数和内存不会保持常数。Table 3 给出了最小函数拟合实验的逐层运算量:两法输出层同为 8.0×10^5 次,而第二隐藏层从 3.2×10^7 降到 3.2×10^3 次;这比只引用总耗时更清楚地定位了加速环节。
生成场之后,物理约束如何进入训练网络先产出未经约束的整场向量,再用“满足给定值的特解 P,加上边界距离或指示函数 D 乘原始输出”的形式,令部分初值和 Dirichlet 边界先天成立。随后在所有配点上计算控制方程残差;遇到 Neumann 边界或观测数据,再加入相应损失。损失中的权重依问题调整,最后仍通过 Adam 与反向传播更新网络参数和坐标编码。这里取消的是对每个样本反复进行高阶链式空间求导,不是取消梯度训练。
03 为什么自动微分在这里反而不再合适
网络偏导不等于 PDE 要的局部导数如果直接对 PFNN 做链式自动微分,一个输出位置会对所有输入坐标产生偏导,得到稠密 Jacobian。可在离散 PDE 里,某个位置的空间导数应由它与相邻位置的场值决定,而不是把远处所有坐标都混进同一个偏导。论文因此没有把自动微分硬套在新架构上,而是回到有限差分:边界点使用前向或后向差分,内部点使用中心差分。
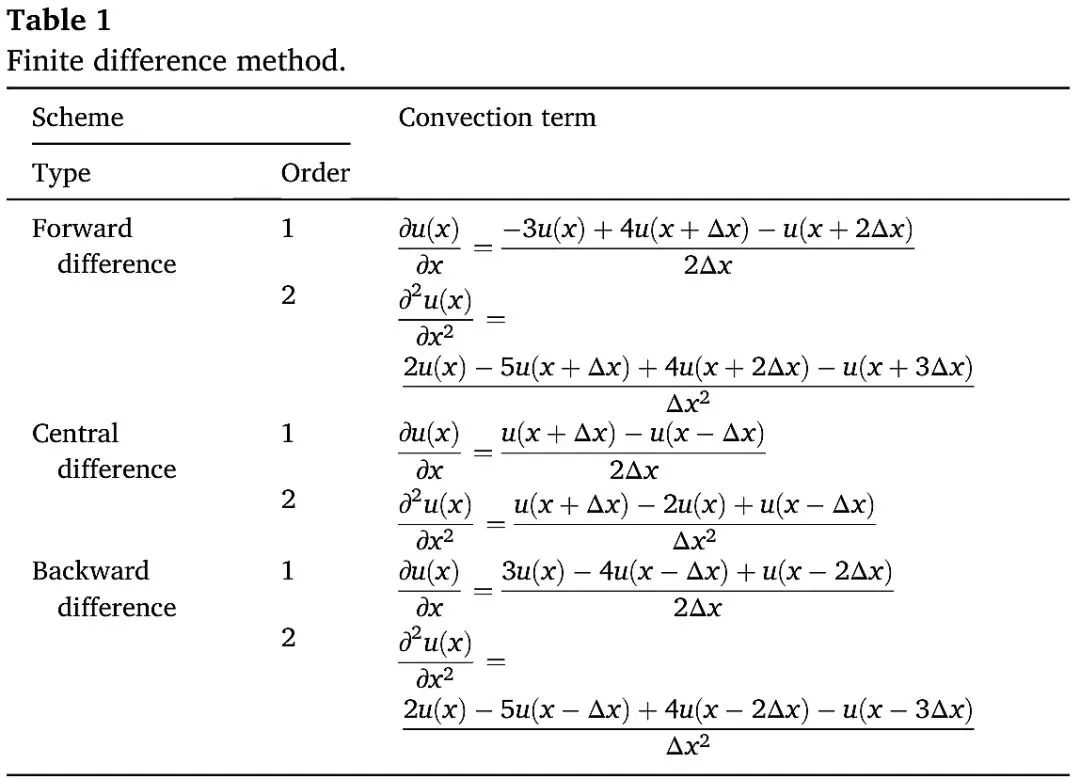
表 1|有限差分方法
Table 1 给出一阶、二阶导数的单侧与中心差分模板。比如内部点的一阶空间导数由左右两个邻点的场值之差除以两倍步长估计;边界缺少一侧邻点,就改用同侧多个点。这样得到的是离散场沿网格方向的变化率,可以逐点放进 PDE 残差。模板本身有截断误差,也要求网格邻接与物理坐标的对应关系可靠。
步长是一项需要验证的数值选择这一步既是 PFNN 能成立的关键,也是它与网格绑定的根源。有限差分避免了把稠密网络 Jacobian 当作局部 PDE 导数,却要求配点足够稠密、邻接关系明确、步长合适。附录 B.1 的函数拟合试验中,步长从 1/20 缩小到 1/30 后误差才接近平台;继续细化并未持续带来同幅收益。这个观察只在该函数和网络设置下成立,不意味着所有方程都选 1/30。速度收益不是免费获得,而是用离散结构、网格构造和误差控制换来的。
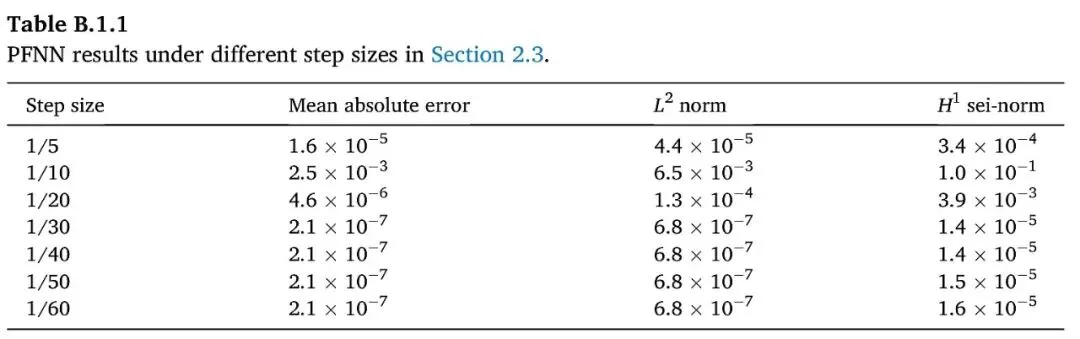
表 B.1.1|不同步长下 PFNN 的求解结果
Table B.1.1 的异常点也值得注意:步长 1/10 的误差反而比 1/5 更大,说明这并非一条简单单调曲线。作者报告在 1/30 至 1/60 区间平均绝对误差约稳定在 2.1×10^-7;实际迁移到新 PDE 时仍应做网格收敛与差分阶数检查。
硬边界减少损失项,软边界仍可能失衡边界条件同样影响结论。正文多数算例用特解与距离函数把初值或 Dirichlet 条件硬编码进输出;附录的软边界版本若不做损失平衡,会在边界明显失真,加入学习率退火后才接近硬约束版本。换句话说,PFNN 减少了逐点自动微分,但没有自动消除多损失优化的困难。
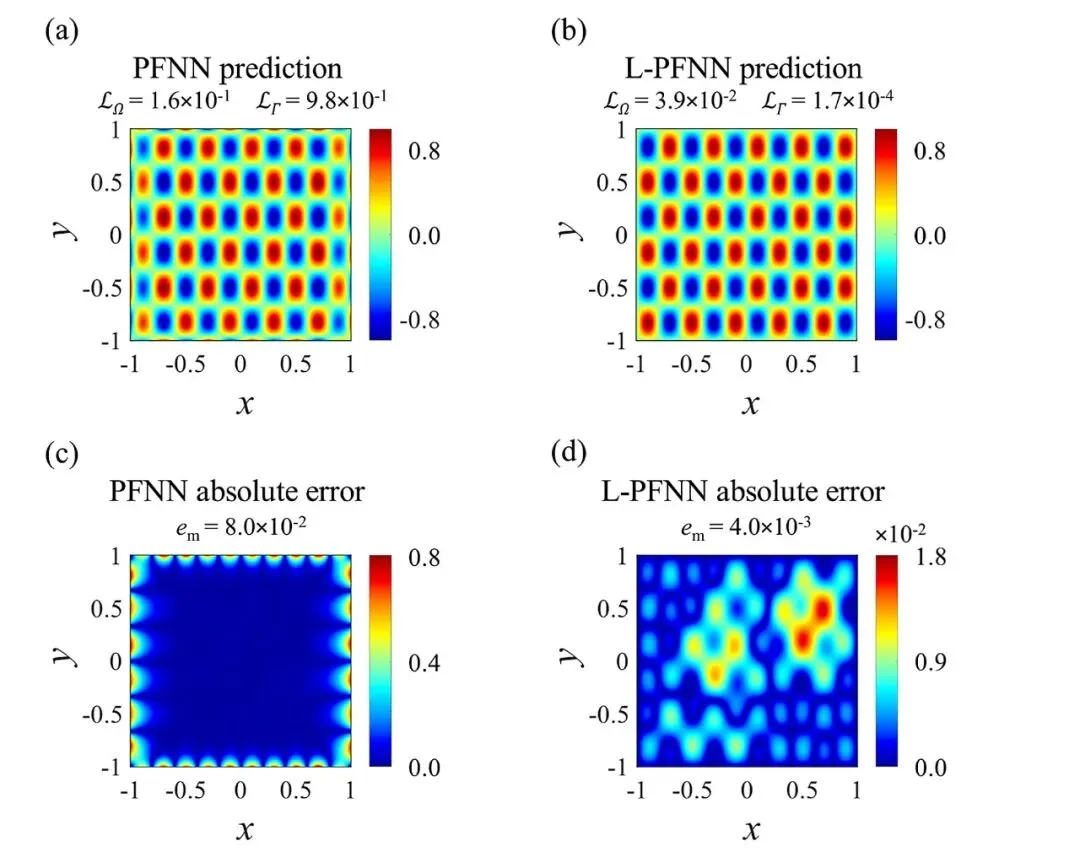
图 D.1|Helmholtz 方程中 PFNN 与 L-PFNN 的结果
附录 Fig. D.1 把这个边界展示得很具体:不用退火的软约束 PFNN 在边缘留下亮色误差带,平均绝对误差为 8.0×10^-2;加入学习率退火后边缘误差收敛,误差降到 4.0×10^-3,接近主文硬约束 PFNN 的 3.6×10^-3。由此可见,架构改变并未免除 PDE 项与边界项的梯度竞争;主文较好的结果也与边界处理策略相连。
04 从高频波到多尺度热场:速度与精度怎样取舍
先用纯函数拟合检验表达能力在最基础的二维高频函数拟合中,PFNN 的平均绝对误差从普通 PINN 的 1.6×10^-1 降到 1.6×10^-8,3000 轮训练时间从 7.7 秒降到 3.5 秒。这个结果说明宽输出确实能在固定网格上快速记住强振荡场,但它还是纯函数拟合,不能单独证明 PDE 残差、边界和多物理耦合都同样受益。
真正的 PDE 测试:高频 Helmholtz 场作者随后把解析解 sin(5πx)sin(3πy) 放进二维 Helmholtz 方程,用控制方程、零值边界和 120×120 配点训练 15000 轮。它比前面的纯函数拟合多了微分残差与边界约束,因此更能检验“整场输出+差分”是否真的构成物理求解器。对照包括普通 PINN、学习率退火版本、傅里叶特征版本及深度能量法;作者为这些模型设置相同的四层、每层 32 神经元主体,但目标函数与边界处理并不完全相同。
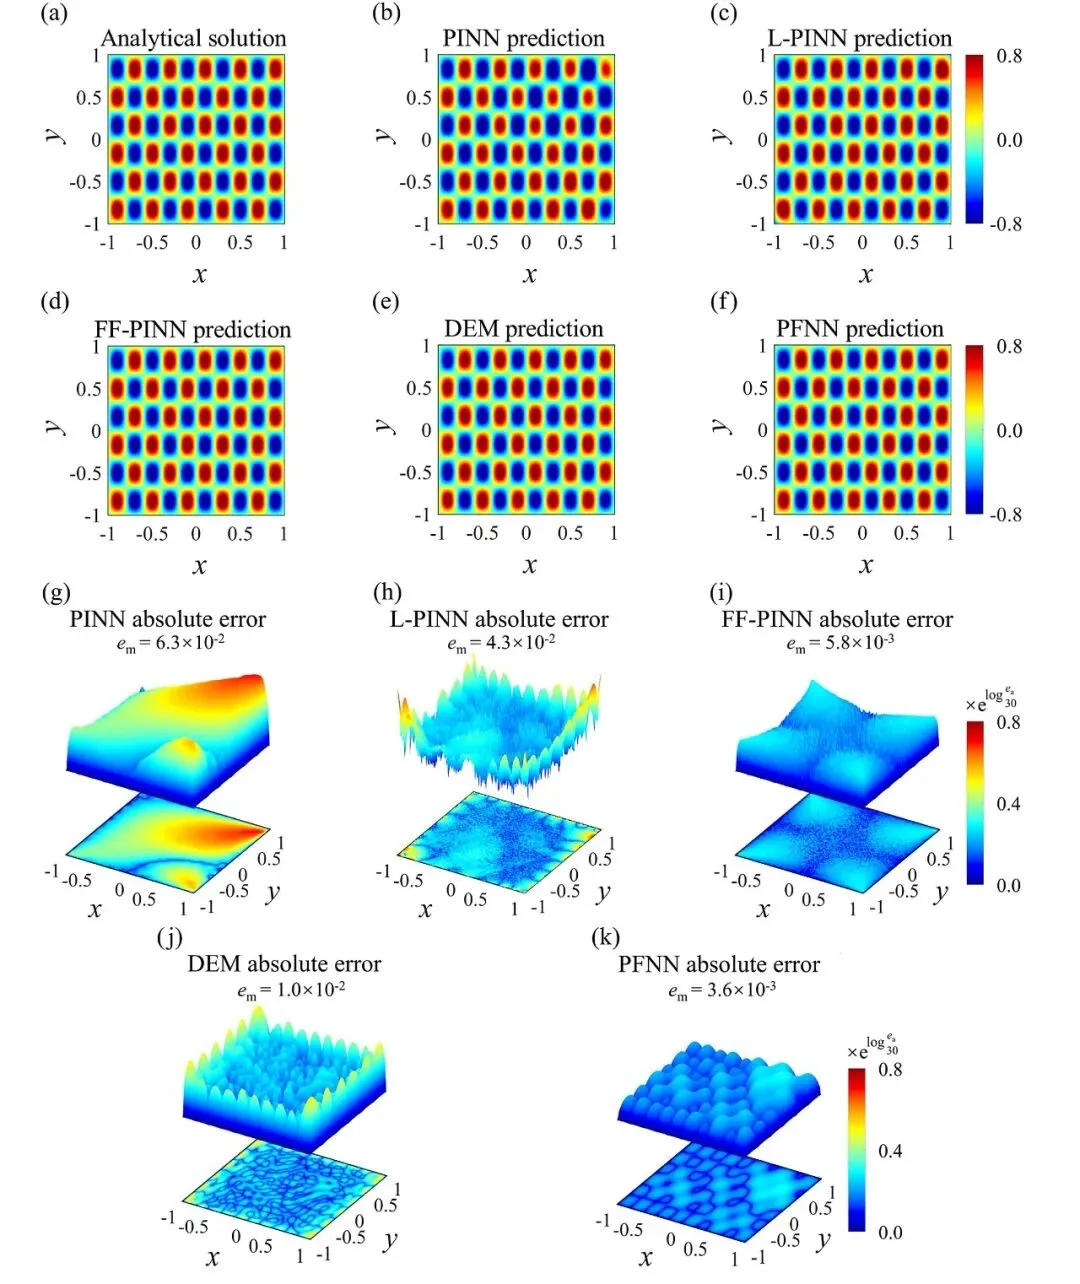
图 3|高频 Helmholtz 方程中五种方法的求解结果
Fig. 3 的上半部分比较五种方法恢复的高频条纹,下半部分比较各自绝对误差。普通 PINN 与退火版的场形状看似接近真值,但误差仍在大区域抬高;PFNN 的误差图整体更低。仅看预测彩图很容易低估这种差异,需同时核对误差面以及 Table 4 的不同误差范数。
高频场的精度与时间证据Helmholtz 的 PFNN 平均绝对误差为 3.6×10^-3,低于四个对照;总耗时 29.6 秒,最接近的深度能量法也需 370.2 秒。这些数字说明场输入显著减少了这组固定代码的重复计算,但不自动代表所有实现都有相同比例的收益。
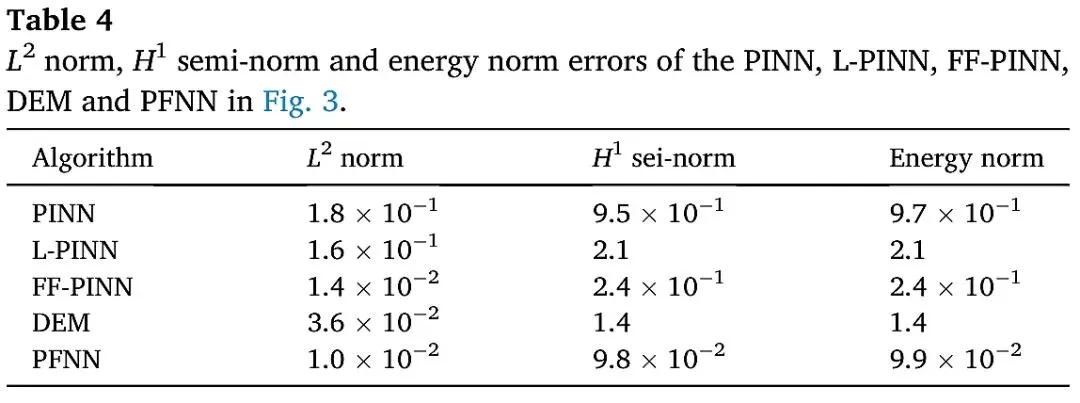
表 4|图 3 中五种方法的 L2、H1 半范数与能量范数误差
Table 4 不只列平均绝对误差,还同时列二范数、H1 半范数与能量范数。PFNN 的二范数误差为 1.0×10^-2,H1 半范数为 9.8×10^-2;这比只说“彩图更像”更有说服力。不过各范数评价的对象不同,不能把一列的倍率直接套到另一列。
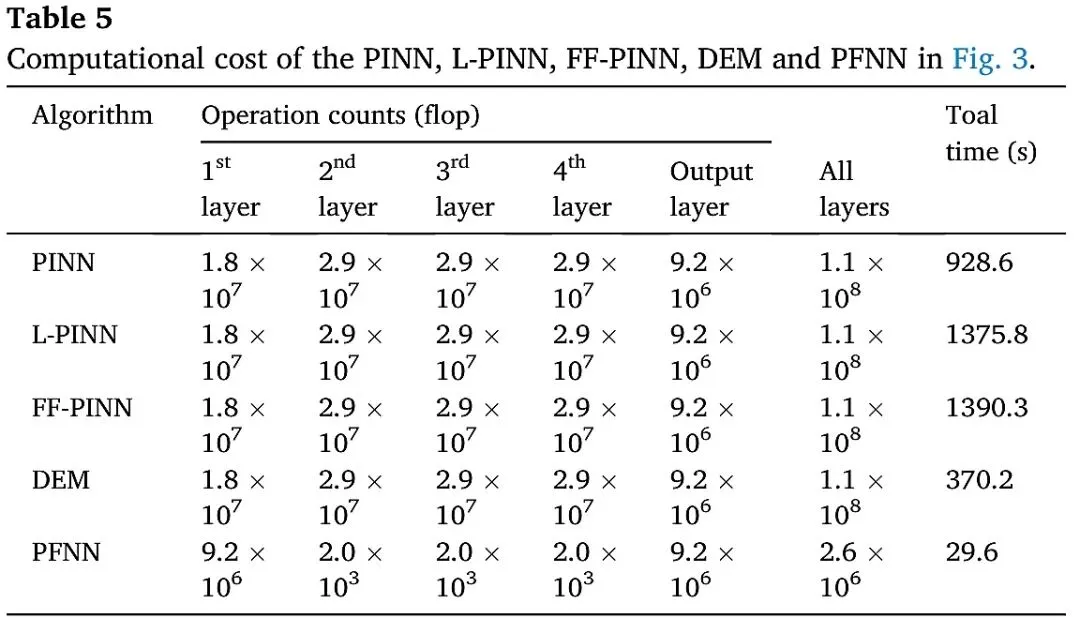
表 5|图 3 中五种方法的计算成本
Table 5 将逐层浮点运算估算与实测总耗时并列。PFNN 全层约 2.6×10^6 次,普通 PINN 约 1.1×10^8 次;对应总时间分别是 29.6 秒和 928.6 秒。读表时要把“理论运算量较少”和“这组实现运行更快”视为相关但不同的证据,不能把耗时差全部归功于网络结构。
再换成空间快变、时间慢变的热方程热传导算例的初温沿 x 方向是 sin(50πx),随时间按扩散规律迅速衰减;同一个解既有密集空间振荡,也有时间方向的慢变化。作者在 250×250 配点上训练 5000 轮,选择五层、每层 32 神经元的 PFNN,并与普通 PINN、傅里叶特征 PINN 及 KINN 比较。这里 KINN 的网络结构和采样策略另有专门设置,因此跨方法时间与精度都应放在作者的具体协议内理解。
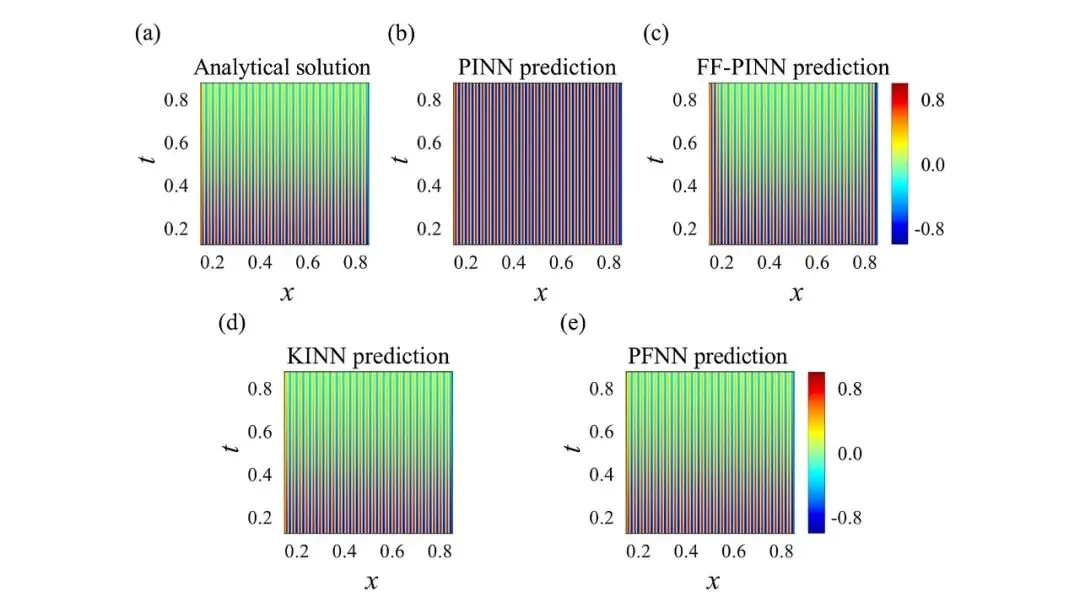
图 4|多尺度热传导方程中四种方法的求解结果
Fig. 4 按解析温度、三种对照和 PFNN 排列。普通 PINN 的高频竖纹明显失真;KINN 与 PFNN 更接近解析图,但局部偏差不能靠缩小后的彩图排序。接下来的 Table 6 给出误差,Table 7 给出耗时:把两张表合起来才是这项实验的结论。
PFNN 更快,但 KINN 在这组设置下更准热传导提醒我们不要把速度优势写成全面精度优势。PFNN 平均绝对误差 5.6×10^-3,KINN 更低,为 3.7×10^-3;但耗时分别为 42.3 与 342.3 秒。这组实验体现的是精度与速度的取舍,完整指标见相邻两张原表。
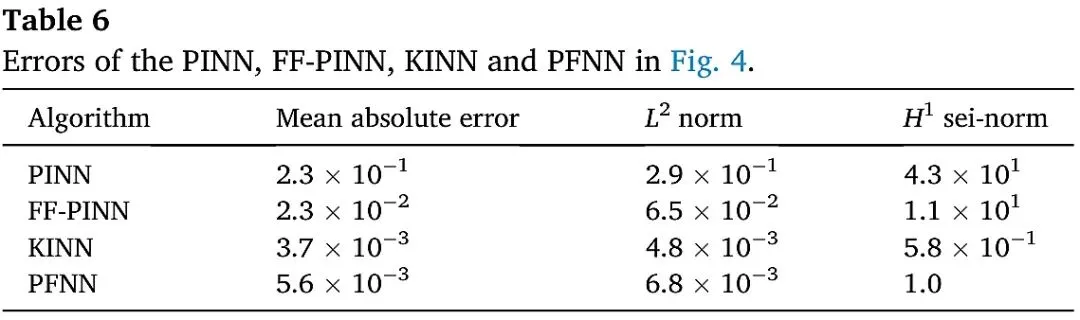
表 6|图 4 中四种方法的求解误差
Table 6 的三列误差都应看:KINN 的平均绝对误差 3.7×10^-3、二范数误差 4.8×10^-3、H1 半范数 5.8×10^-1;PFNN 对应为 5.6×10^-3、6.8×10^-3 和 1.0。也就是说,这里 PFNN 并非精度第一。原文摘要式加速百分比若不同时说明这个精度差,会误导读者以为是无代价的全面胜出。
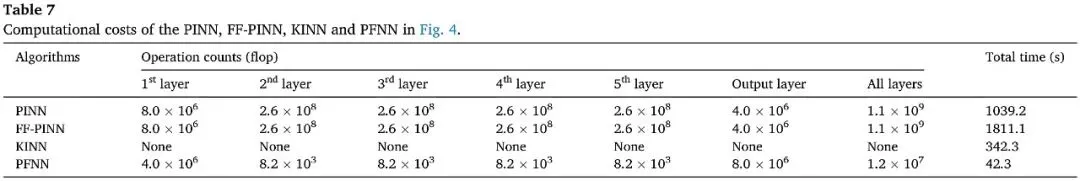
表 7|图 4 中四种方法的计算成本
Table 7 显示 PFNN 全层估算运算量为 1.2×10^7,普通 PINN 与傅里叶特征 PINN 均约 1.1×10^9;实测总时间为 42.3、1039.2 与 1811.1 秒,KINN 为 342.3 秒。KINN 这一行未给同口径逐层运算量,所以表格能支持时间对照,却不能据此给出两者逐层成本的严格归因。
05 孔边应力集中:宽输出能否守住最陡的位置
为何带孔板比平滑位移更难外缘受不均匀径向拉力的圆板中央有一个孔,孔边会形成局部应力集中。作者利用对称性只计算右上四分之一圆环:两条直边施加对称支承,内孔与外缘分别承受边界条件。这不是简单的规则矩形,有限差分也不能直接按 x、y 方向在孔边取邻点。论文先建立参考方形域,再通过坐标变换及其 Jacobian 把参考域上的差分换回物理域导数;若这种变换不可构造,本文方法不能原样搬用。
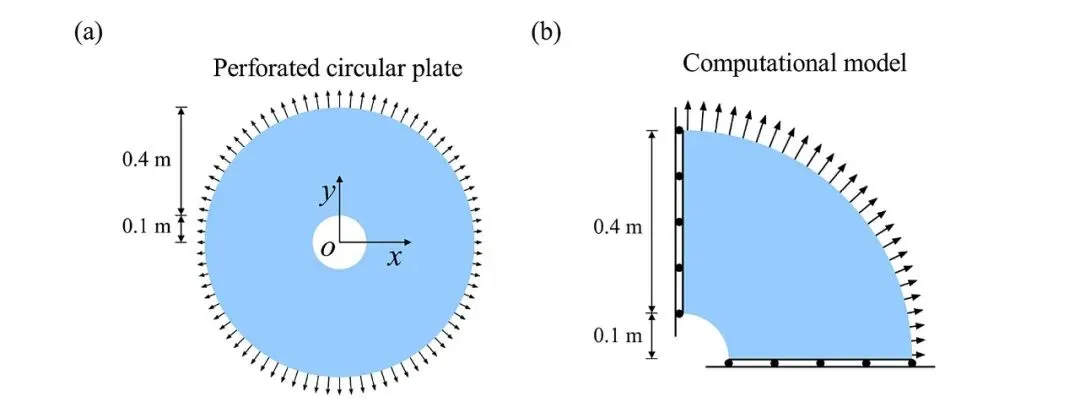
图 5|内外半径分别为 0.1 米与 0.5 米的穿孔圆板
Fig. 5 把完整圆板和实际计算的四分之一模型并排放置。读图时先辨认内孔、外缘载荷方向与两条对称边,再看后面的 Fig. 6:亮色应力区应出现在内孔邻近位置,而非整块板均匀变亮。这个几何说明为什么该实验同时考验局部尖峰和坐标映射。
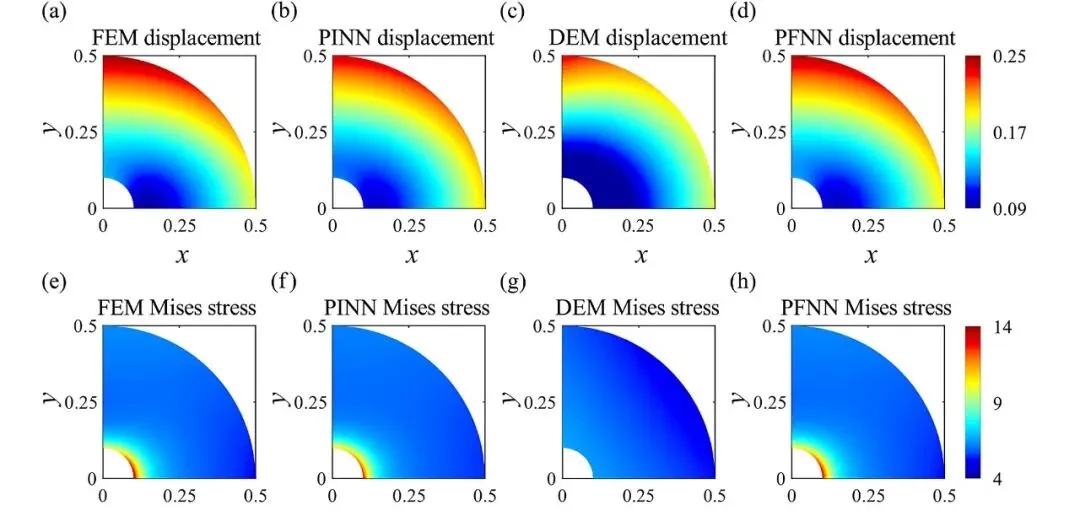
图 6|应力集中弹性平衡方程中 PINN、DEM 与 PFNN 的结果
位移接近,不代表应力峰值也接近带孔板对照图的上排是位移,下排是 Mises 应力。位移场相对平滑,三种学习方法看起来都不差;真正拉开差距的是孔边亮色尖峰。深度能量法明显抹平峰值,普通 PINN 能定位却更扩散,PFNN 与有限元参考最接近。它的位移平均绝对误差为 3.2×10^-3,应力误差为 4.7×10^-2,大约是普通 PINN 对应误差的一半。
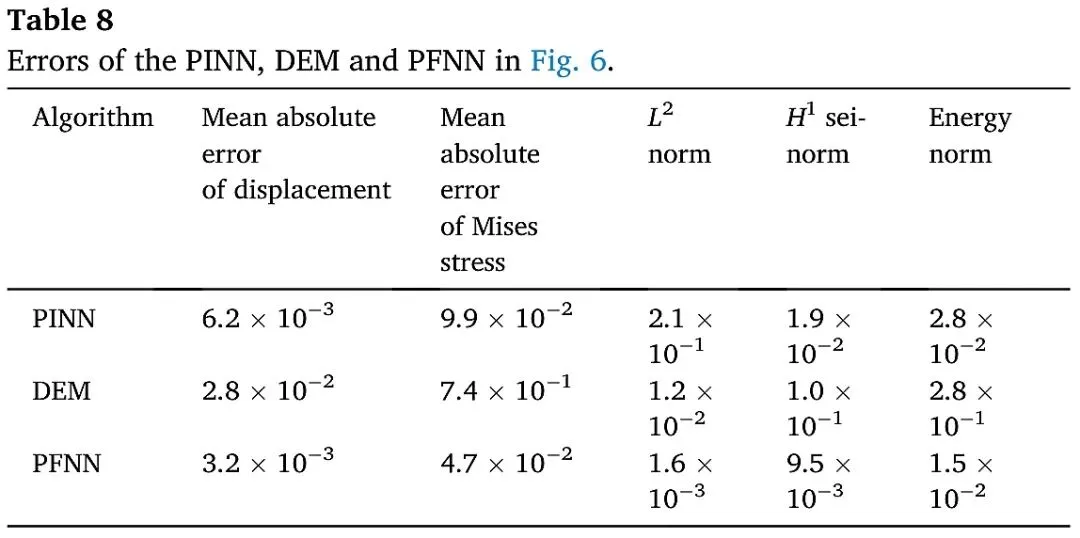
表 8|图 6 中 PINN、DEM 与 PFNN 的误差
Table 8 将位移平均绝对误差与 Mises 应力平均绝对误差分列,不能混为同一指标。PFNN 分别为 3.2×10^-3 与 4.7×10^-2;PINN 为 6.2×10^-3 与 9.9×10^-2,深度能量法的应力误差则达到 7.4×10^-1。正是应力列支撑“孔边峰值恢复更好”的判断。表格以有限元场为参考,不能把这个对照表述为已证明解析真解误差。
时间优势成立,但几何前处理不可省略这个算例只在规则计算域上使用 30×30 个配点,再通过坐标变换映回四分之一圆环。PFNN 耗时 83.3 秒,普通 PINN 为 1691.0 秒。不过,坐标变换本身需要可构造的规则参数域;对孔洞众多、三维拓扑复杂或网格高度非结构化的问题,论文还没有展示同样路径。
06 电势驱动温度:两张物理场如何一起求解
先有电流,再有焦耳热电热耦合算例在方形区域设置上边界电压 1 V、下边界接地,电势梯度决定电场,电流与电场的乘积形成焦耳热 Q;热方程再以 Q 为源项计算温度。于是电势哪怕只在梯度上出现偏差,温度的内部峰值也可能被放大或抹平。作者为电势、温度分别建一个子网络,在 50×50 配点上共同训练 20000 轮;由于还存在 Neumann 边界,两种网络都保留相应损失项,不能把这组实验理解成所有边界均已硬编码。
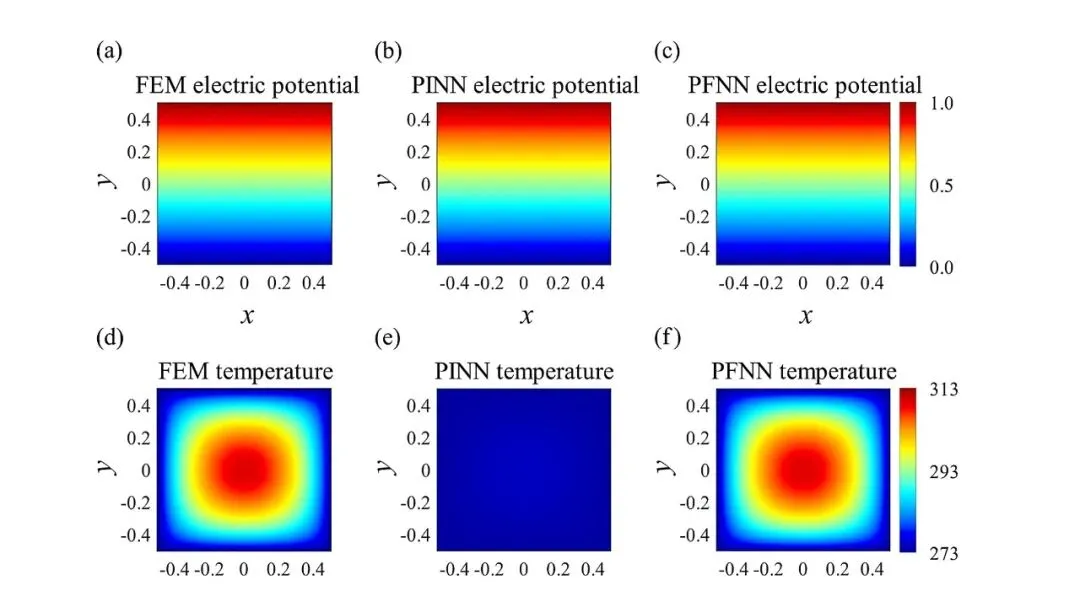
图 7|电热耦合方程中 PINN 与 PFNN 的结果
关键不是电势色块,而是内部温升电热耦合先由电势梯度产生焦耳热,再由热方程形成中心高温区。对照图中,两种网络都恢复了近似线性的电势梯度;差别集中在温度场:普通 PINN 几乎把内部温升压成一片低值,PFNN 则保留了与有限元相似的红色中心峰。温度平均绝对误差从 1.6×10^1 降到 1.5×10^-2。
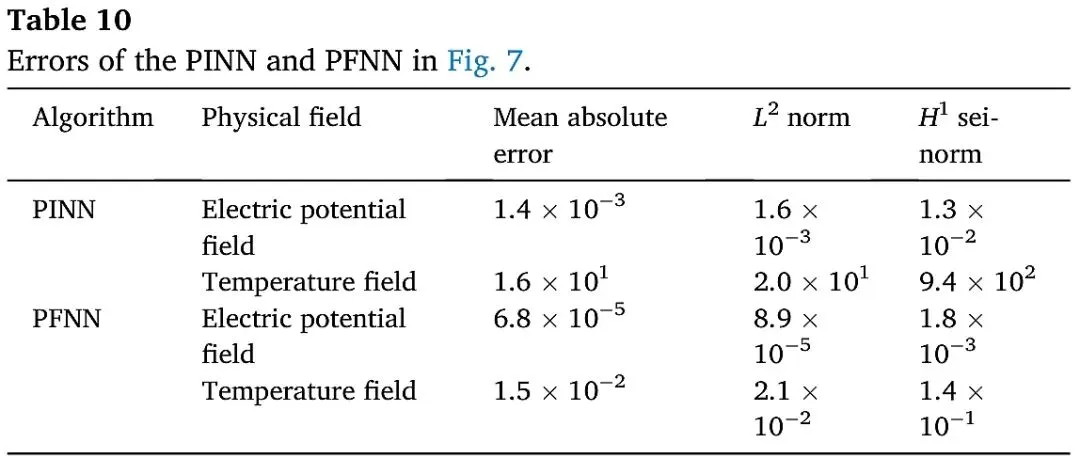
表 10|图 7 中 PINN 与 PFNN 的误差
Table 10 将电势和温度分别计分。电势平均绝对误差,PFNN 为 6.8×10^-5、PINN 为 1.4×10^-3;温度一列的差距更大,分别为 1.5×10^-2 与 1.6×10^1。表内 H1 半范数也显示温度梯度差异,因此图上的红色中心峰并非只是一种配色观感。这仍是作者设定的导热系数与边界工况,尚不能保证更强耦合或其它材料参数时维持相同误差倍率。
与传统数值法比较,需要对齐总成本两个子网络在 50×50 配点上联合训练。作者报告 PFNN 单网络耗时 13.9 秒、PINN 为 131.7 秒、有限元为 6.1 秒;这支持学习法成本下降,不支持“神经网络已比有限元更快”的结论。
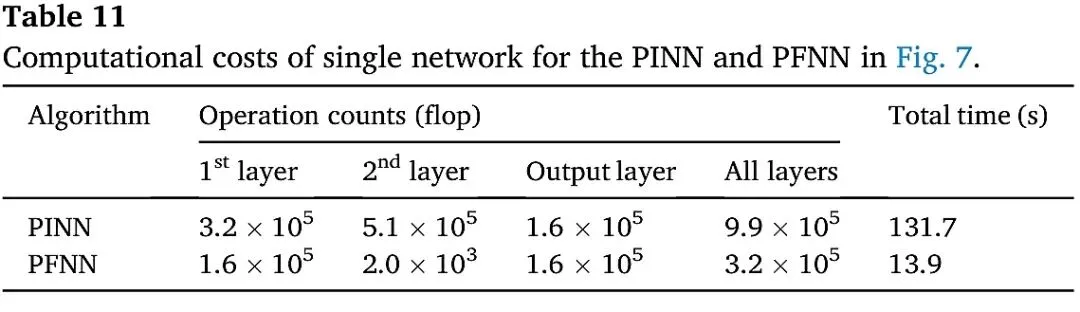
表 11|图 7 中 PINN 与 PFNN 单个网络的计算成本
Table 11 的标题明确写的是“单网络”成本。PFNN 为 13.9 秒、PINN 为 131.7 秒;但正问题同时用了电势和温度两个子网络。因此不能把 13.9 秒不加说明地当作完整耦合系统的总时间,更不能拿它直接与有限元 6.1 秒当作严格同口径排名。它确实说明作者的 PFNN 子网络在这组实现中显著更快。
07 500 个带噪温度点,能否识别真实热导率
观测怎样进入损失逆问题把真实热导率设为 2×10^-3 W/(m·K),从 50×50 配点中抽取 500 个温度观测,再分别叠加三档高斯噪声与三档脉冲噪声。参数 k 与网络权重一起优化;为避免带噪数据牵着模型跑,观测损失权重设为 0.1,其余项为 1,训练 50000 轮。因而这里检验的是“物理残差与少量带噪数据共同约束参数”的设置,不是完全无监督识别。
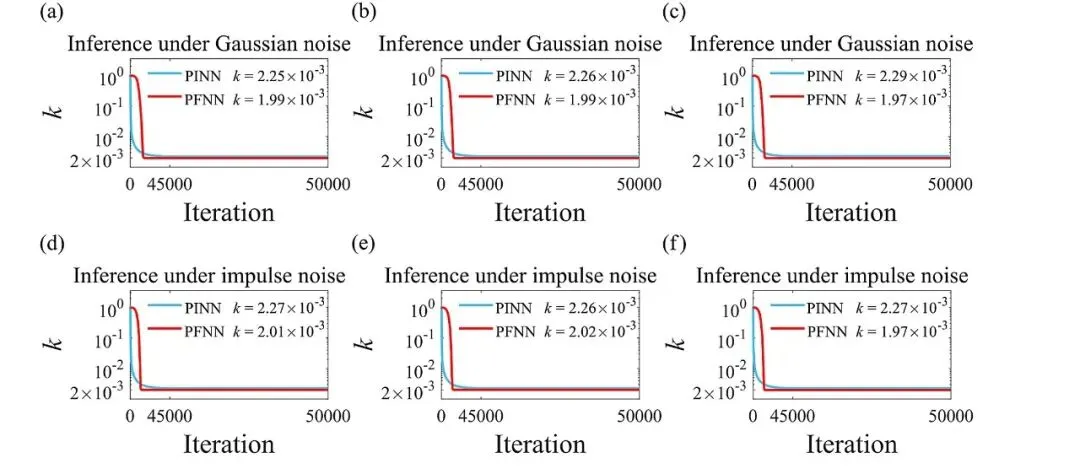
图 8|高斯噪声与脉冲噪声下热导率反演的演化曲线
先看终值,再看噪声范围Fig. 8 的红线为 PFNN,蓝线为 PINN。六档噪声下,红线终值为 1.97×10^-3 至 2.02×10^-3,蓝线为 2.25×10^-3 至 2.29×10^-3;真值是 2×10^-3 W/(m·K)。PFNN 在作者设置下更接近真值。
稳健性只在这六档扰动下成立高斯噪声的标准差按 5、10、15 递增;脉冲噪声设置为 5%、10%、15% 三档,并只扰动论文指定的一部分随机观测。Fig. 8 中 PFNN 的参数终值保持在真值附近,但最高噪声下有轻微偏移。更稳妥的读法是:在这套观测数量、噪声注入、数据权重和迭代次数下,PFNN 比本文 PINN 对照更稳;它尚未检验系统性传感器偏差、不同采样布局或材料参数同时未知的可辨识性。
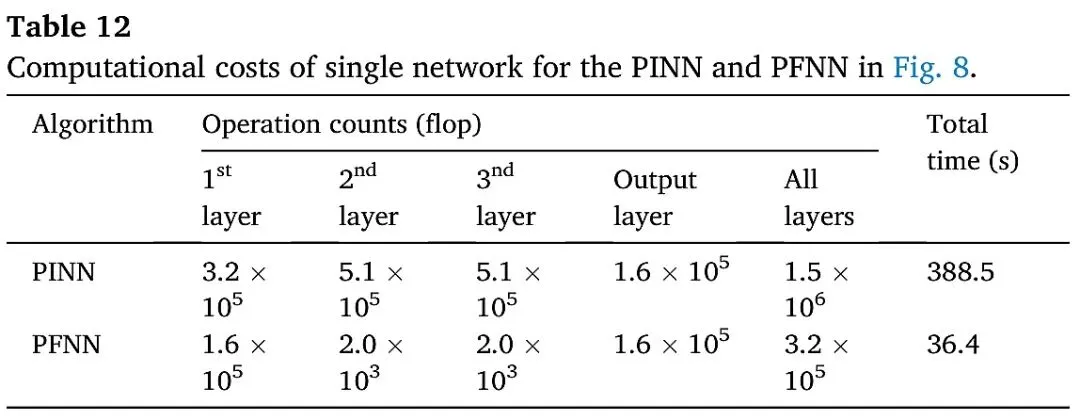
表 12|图 8 中 PINN 与 PFNN 单个网络的计算成本
Table 12 同样按“单网络”统计反演运算:PFNN 为 36.4 秒,PINN 为 388.5 秒。它支持本实验的效率对照,但不能单独证明反演参数一定可识别;参数准确性仍须回到 Fig. 8 的终值,并结合附录 E 的场误差。时间与精度是两条独立证据。
08 读懂场映射之前,需要把三件事说清
第一,计算规模从样本维搬到宽度维第一,PFNN 把配点数从样本维搬到了特征维和输出维。隐藏层不再为每个点重复计算,但输入层、输出层、训练参数与内存仍会随网格点数和物理场数增长。论文实验全部是二维规则网格或可映射到规则域的几何,没有三维细网格、内存峰值或网格加密下的扩展曲线。
第二,固定离散求解不等于跨任务泛化第二,它的优势属于单个离散问题的求解,不等于跨任务泛化。更换配点数会改变网络两端宽度,更换几何会改变邻接或坐标变换,更换方程和边界仍要重新构造损失并训练。若要走向多参数快速预测,还需要引入真正的算子学习、网格无关表示或可迁移的局部基。
第三,墙钟时间仍要对齐精度目标第三,墙钟时间是重要证据,却不是脱离实现的算法常数。不同对照使用了随机或规则采样、硬边界或软边界,也可能有不同的激活、网络宽度和代码路径。论文在同一 AMD Ryzen 9 5950X 平台运行,足以说明当前实现的工程潜力;更严格的下一步应统一误差目标、参数量、精度和硬件,并报告内存、编译与数据搬运成本。
什么场景值得借鉴这条路线如果任务是单一方程或一组固定工况、区域能可靠离散、邻接与边界已知,而且传统逐点 PINN 在密集配点和高频局部结构上成本过高,PFNN 的“场输入+宽输出+有限差分”提供了可尝试的求解设计。若任务是跨网格部署、三维超大规模、复杂非结构几何或多参数快速泛化,这篇论文尚未给出直接证据;应先与有限元、差分法和神经算子在同一精度目标下比较。它的主要贡献不是替代全部数值方法,而是重新分配 PINN 的计算与表达职责。
AI 模拟审稿 · 如果从方法贡献、证据边界和后续价值重新审视
① 优点把PINN的点到点接口改成场到场映射,并正面处理了自动微分语义失配;高频、应力集中、电热耦合和带噪反演形成了一条完整而有机械含义的证据链。
② 局限输入输出维度与固定网格绑定,差分依赖邻接和步长,复杂几何还要额外坐标变换;实验尚未覆盖三维细网格、跨离散泛化、内存扩展和严格同预算基准,因此不能把当前加速概括为普遍优势。
③ 下一步启示最值得推进的是网格无关的场编码、局部或稀疏输出、可微分的非结构邻接,以及在统一精度与硬件预算下和有限元、神经算子、域分解PINN进行可复现比较。
关注智核学术 · 看懂方法背后的问题
免责声明:本文为第三方学术解读,并包含 AI 辅助整理与 AI 模拟审稿,仅供学术交流;不构成正式同行评审、工程验证或决策依据。文中观点不代表论文作者、所属机构或期刊立场,论文事实与数据请以原文为准。