ARTICLE · 1126053
AI infra 学习记录(2):从 LayerNorm 算子熟悉常见的算子优化方法
一个公式、四个版本,记录我第一次把一个 CUDA 算子从"能跑"写到"逼近带宽上限"的全过程。
0. 为什么拿 LayerNorm 练手
最近在学习 CUDA 算子优化,我决定先找一个"小而全"的算子,最后选中了 LayerNorm。它的公式只有一行:
说白了就两步:先做 reduce 算出均值和方差,再乘 γ 加 β 做仿射。
选它的原因是麻雀虽小、五脏俱全:
有一次归约(算 sum 和 sumsq,reduction); 有一段逐元素操作(仿射,天然适合向量化); 而且它是典型的 memory-bound 算子——时间花在搬数据上,而不是花在计算上。
在它身上能练到的东西,基本就是所有 memory-bound 算子(各种归一化、激活、逐元素 op)的通用套路。
1. 写 kernel 之前,我先学会判断算子是哪种 bound
这是我这次学习印象最深的一点。以前我写 CUDA 的习惯是"先写了再说,跑出来看快不快",而这次学到的第一件事是:动笔之前先算算术强度。
1.1 算术强度(Arithmetic Intensity)
这个算术强度表示每搬一个字节的数据,能摊到多少浮点计算,这是判断是 compute bound 还是 memory bound 的重要指标之一。
1.2 Roofline 模型和 ridge point
Roofline 模型是一条先上升、后封顶的折线,折点就是 ridge point:左边是 memory-bound 区,右边是 compute-bound 区。
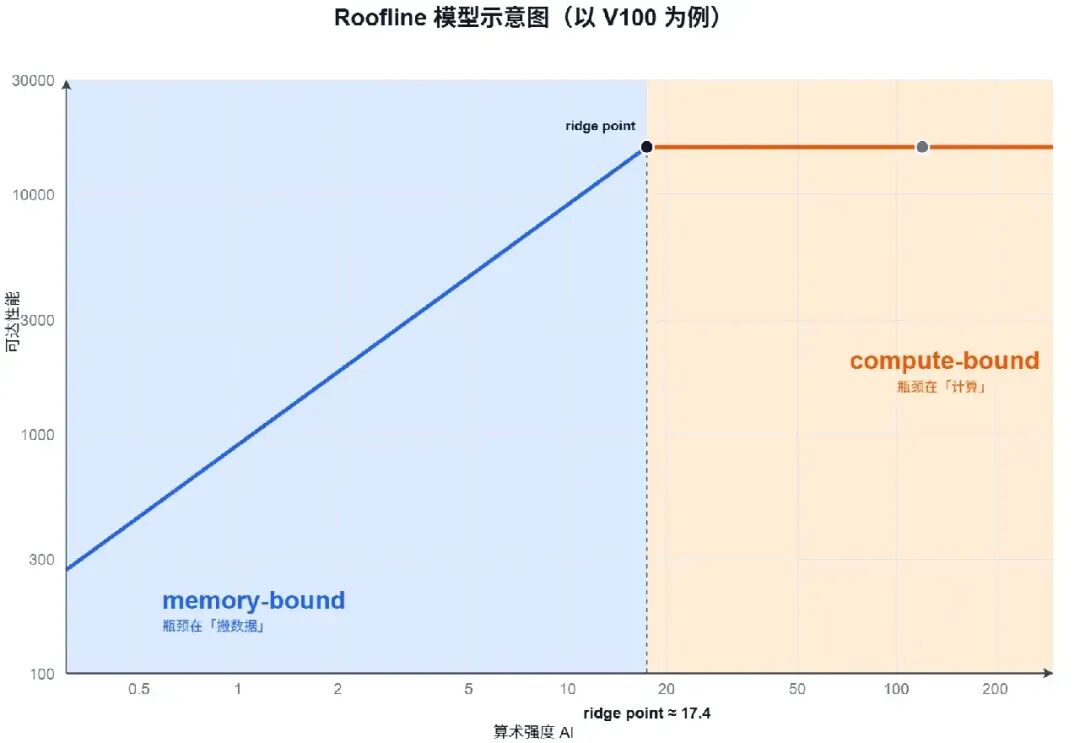
图 1:Roofline 模型示意图
我查了手上两张卡的参数:
每元素约 7 FLOPs、8 Bytes(读一次写一次),AI≈0.87。在两张卡上都远在 ridge point 左边。这一步算完,我就明确了优化方向:想尽办法更快地搬字节,而不是去做更多计算并行。
现在回头看,这一步要是跳过,后面很可能白费力,方向错了其他都是白搭。
2. 四个版本的迭代过程
我一共写了四版,基本是一个版本解决一个当时最明显的问题。
2.1 v1:照 CPU 思路直译的一版
第一版我基本是按照写串行循环的思路写的,一个 block 只起一个线程,让它把一整行扫两遍:
// 启动配置:layernorm_v1<<<rows, 1>>>__global__ void layernorm_v1(float *input, float *output, float *gamma, float *beta, int rows, int cols, float eps) { int r = blockIdx.x; // 第 r 行 float sum = 0.f, sumsq = 0.f; for (int i = 0; i < cols; i++) { // 第一遍:算 sum / sumsq float x = input[r * cols + i]; sum += x; sumsq += x * x; } float mean = sum / cols; float var = sumsq / cols - mean * mean; float inv_std = rsqrtf(var + eps); for (int i = 0; i < cols; i++) { // 第二遍:归一化 + 仿射 float x = input[r * cols + i]; output[r * cols + i] = (x - mean) * inv_std * gamma[i] + beta[i]; }}功能是对的,但我算了一下 occupancy(以V100为例),只有 1.56%。一个 SM 理论上最多驻留 64 个 warp,我只给了它 1 个。换句话说,GPU 赖以隐藏延迟的海量线程切换完全没发生,绝大部分硬件在空转。
2.2 v2:把归约并行化,用上 shared memory
第二版让一个 block 的 256 个线程一起算同一行:每个线程先用 block-stride 的方式累加自己负责的部分,再把局部和写进 shared memory,最后做树状归约。
// 启动配置:layernorm_v2<<<rows, 256>>>__shared__ float s_sum[BLOCK_DIM];__shared__ float s_sumsq[BLOCK_DIM];float l_sum = 0.f, l_sumsq = 0.f;for (int i = tid; i < cols; i += blockDim.x) { // block-stride 分片 float x = input[r * cols + i]; l_sum += x; l_sumsq += x * x;}s_sum[tid] = l_sum; s_sumsq[tid] = l_sumsq;__syncthreads(); // 等所有线程写完for (int offset = blockDim.x / 2; offset > 0; offset >>= 1) { if (tid < offset) { s_sum[tid] += s_sum[tid + offset]; s_sumsq[tid] += s_sumsq[tid + offset]; } __syncthreads(); // 每轮归约后都要同步}occupancy 直接拉到 100%。但写完我注意到,归约每一轮都有一个 __syncthreads(),一共要同步 log2(256)=8 次。这让我开始琢磨:这部分同步开销能不能省掉?
2.3 v3:warp shuffle,warp 内不动 shared memory
查资料时我发现了 __shfl_down_sync:同一个 warp 内的 32 个线程可以直接交换寄存器里的值,既不需要 shared memory,也不需要显式同步(warp 内天然锁步),这样就可以直接通过寄存器完成 warp 内归约。
// warp 内归约:32 个线程 → 1 个值,只需 5 步#pragma unrollfor (int offset = warpSize>>1; offset > 0; offset >>= 1) { l_sum += __shfl_down_sync(0xffffffff, l_sum, offset); l_sumsq += __shfl_down_sync(0xffffffff, l_sumsq, offset);}于是流程变成:先在每个 warp 内部用 shuffle 归约成 1 个值,再把各 warp 的结果写进 shared memory,只在跨 warp 这一步做一次同步。__syncthreads() 从 8 次降到了 1 次,相应地性能也会有一定的提高。
这里还踩了一个小坑:我一开始习惯性地在 shuffle 外面套了 if (tid < offset) 的边界判断,这是 shared memory 归约那里带过来的习惯,但在 shuffle 上会出事。__shfl_down_sync 它要求 mask 里的全部 lane 同时执行到这条指令,第一个参数0xffffffff明确要求 warp 里面全部 32 个 lane 都执行到这条指令、一起完成交换,外面一旦套上if,实际只有部分 lane 执行,其余 lane 根本不来汇合,参与的 lane 会一直等下去,这样导致的后果就是——轻则归约结果失误,重则整个 warp 直接卡死。
正确的做法就是让所有的 lane 都调用,越界的 lane 会返回自己的值,但树状归约的正确结果最终只会落在 lane0 上,其余的 lane 值我们根本不读取,所以它们返回什么都不影响,这也正是 shuffle 归约和 shared memory 归约最不一样的地方。
2.4 v4:float4 向量化,这一版才真正开始打带宽
v2、v3 其实都在优化归约这一小块,但 LayerNorm 是 memory-bound,时间大头在搬数据上。真正冲着带宽去的,是 v4。
思路是让一个线程一次读一个 float4(16 字节即4个连续的float)而不是一个 float(4 字节)。
为什么这对memory-bound算子有用?关键在指令数:
标量版里,一个线程假如要处理 4 个元素,就得发 4 条 load,写回时还要发 4 条 store,每条都要走一遍取指、译码、发射、地址计算,循环本身也有分支和自增开销。 换成 float4后,同样 4 个元素只需要 1 条宽 load,写回 1 条宽 store,处理同样数据的访存指令数直接降到 1/4,线程每趟循环搬的字节数也从 4B 变成 16B。
这里要把一个容易出错的点讲清楚:当访问连续且对齐的时候,warp 里 32 个线程的请求本来就会被硬件合并,float4并不会让 DRAM 少取字节,它真正省下来的,是访存指令的条数,以及数据量小时本来摊不薄的那部分固定开销。核心代码如下:
int vec_cols = cols / 4; // 这一行有几个 float4const float4 *x4 = reinterpret_cast<const float4 *>(input + r * cols);float4 *y4 = reinterpret_cast<float4 *>(output + r * cols);// 第一遍:一次读一个 float4,把 4 个分量展开累加float l_sum = 0.f, l_sumsq = 0.f;for (int i = tid; i < vec_cols; i += blockDim.x) { float4 v = x4[i]; l_sum += v.x + v.y + v.z + v.w; l_sumsq += v.x*v.x + v.y*v.y + v.z*v.z + v.w*v.w;}// ...(归约、求 mean/inv_std 同 v3)...// 第二遍:归一化 + 仿射,同样一次处理一个 float4for (int i = tid; i < vec_cols; i += blockDim.x) { float4 x = x4[i], g = g4[i], b = b4[i], o; o.x = (x.x - mean) * inv_std * g.x + b.x; o.y = (x.y - mean) * inv_std * g.y + b.y; o.z = (x.z - mean) * inv_std * g.z + b.z; o.w = (x.w - mean) * inv_std * g.w + b.w; y4[i] = o;}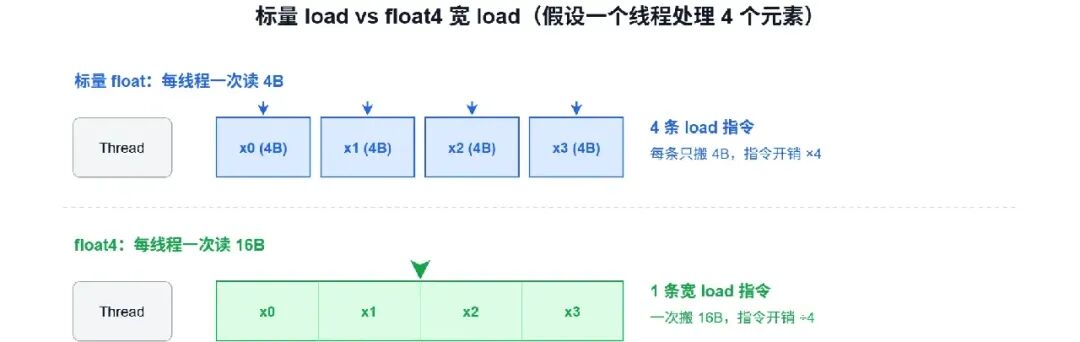
图 2:标量访存与 float4 向量化访存指令对比
3. 一些理解与收获
如果说前面四个版本是"照着套路走",那真正让我觉得学到东西的,是跑完实验后被数据纠正的几个认知。
3.1 float4
写 v4 之前,我以为向量化是无脑提速的大杀器,结果实测被教育了:
cols=256:标量版带宽只跑到峰值的 57%,换成 float4 后到 79%,提升明显(V100);cols=1024:float4 的提升幅度不大(V100),甚至略慢(3080Ti)。
我后来的理解是:float4 的红利,取决于标量版离带宽上限有多远。 每线程搬的数据太少、带宽没打满时,向量化有用;标量版本来就已经把带宽吃得差不多了,再向量化就只剩副作用。这个结论,比"float4 能提速"这个结论本身重要得多。
3.2 occupancy
v2/v3/v4 的 occupancy 都是 100%,但性能仍然有差别。这说明 occupancy 拉满只是"拿到了继续优化的门票":
occupancy 低(如 v1)→ 一定慢,硬件在空转; occupancy 拉满 → 之后拼的,就是每个活跃线程单位时间搬了多少字节。
我以前会把 occupancy 当成优化的终点,现在更愿意把它当成一个"不达标就不用看别的"的门槛。
3.3 手算指标
我本来想全程靠 ncu(Nsight Compute)看指标,但消费卡和云主机经常会锁性能计数器,很多环境根本用不了。被逼无奈之下,我学会了手算这几个指标(以 V100 为例):
有效带宽 = 实际搬运的字节数 ÷ kernel 时间; 带宽占比 = 有效带宽 ÷ 峰值带宽; AI = FLOPs ÷ Bytes; occupancy 上限 = min(2048/blockDim, 65536/(regs×blockDim), 32)×blockDim÷最大线程数。
寄存器数可以通过编译选项 -Xptxas -v 拿到。把这一套算下来,不依赖任何可能被锁的工具,心里对 kernel 的状态就有底了。
3.4 同一份代码,在不同卡上表现不一样
我把 v3/v4 在 V100 和 3080 Ti 上都跑了一遍,为了公平,固定配置 rows=65536,cols=1024,直接对比 v4 相对 v3 的耗时,结果出了一个我一开始以为是代码 bug 的现象:
同一份代码、同样的输入,一张卡上float4小幅领先,另一张卡上却拖后腿。我猜想的原因如下:
在没有带宽红利的情况下, float4展开会多占寄存器、改变指令调度,这部分是赚还是亏,取决于目标架构的编译器和微架构。V100(sm_70) 上它恰好赚一点点,3080Ti(sm_86) 上,连续标量访问的合并已经足够高效,float4的额外展开反而净亏。
我的体会是:判断 bound、盯带宽、一个版本解决一个瓶颈这套方法论是跨卡通用的;但具体到"float4 到底快不快、block 开多大",必须在目标卡上实测。 这也是为什么发布时要为不同架构分别生成 SASS:
# 为 V100(sm_70) 和 3080Ti(sm_86) 分别生成原生 SASSset(CMAKE_CUDA_FLAGS "${CMAKE_CUDA_FLAGS} -gencode arch=compute_70,code=sm_70 -gencode arch=compute_86,code=sm_86")4. 下一步
单算子调到79%(cols=256 float4)左右的带宽占比,我感觉常规手段基本到头了。接下来打算往两个方向走:
寄存器缓存 x:现在归一化和仿射会把 x 读两遍(第二遍大概率命中 L2,没回 DRAM)。如果把 x 先读进寄存器,第二遍直接从寄存器取,能再省一点 L2 带宽和访存指令。 kernel 融合(可能翻倍的方向):LayerNorm 前后往往连着其他算子,融合后中间结果不用写回 DRAM 再读出来——这是唯一能真正砍掉 DRAM 流量的手段,带宽占比才有可能继续往 85% 以上走。
5. 小结
这次写下来,我脑子里算子优化的流程基本成型了:
先算清楚算子是 memory-bound 还是 compute-bound,把精力花在真正的瓶颈上;一次只改一个地方,用手算的指标而不是"感觉",去验证每一步到底有没有用。
对我来说,这套思考方式比"学会了 LayerNorm 怎么写"要重要得多。