ARTICLE · 1132966
多模型 AI 助手:省钱的事交云端,保密的事交本地
缘起
大模型越来越多,线上的DeepSeek 、千问等、本地 Ollama 免费但吃硬件。每次想对比效果,都得开不同的网页或终端,来回切换很麻烦。
于是我用Streamlit + LangChain搭了一个统一入口——ZaneHouChat,一个能自由切换模型、上传文档问答、还能统计每次对话花了多少钱、用了多长时间的聊天机器人。
这篇文章,就把它的功能和技术实现完整整理出来。
一、功能一览
先看它能做什么:
多服务商模型切换:Online 模式走 DeepSeek、千问;Offline 模式走本地 Ollama。 本地模型安全保密:Offline 模式全程在本机运行,对话、文档、向量数据不出本机,不经过任何第三方 API。 模型信息从 CSV 读取:厂商、模型名、BASE URL、API Key、输入/输出价格全部表格化管理。 参数可调:温度(0~2)、最大 Tokens(1024 倍数)实时输入。 文档上传问答:支持 TXT / PDF / DOCX,自动切分、向量化、检索增强。 对话记忆持久化:基于 SQLite 的 checkpointer,关掉浏览器再打开,历史还在。 流式输出:打字机效果,首字时间可量化。 消费统计:每轮 token 数、费用,按模型汇总。 用时统计:总用时 + 首 token 时间(TTFT),按模型算平均响应。 缓存机制:相同问题命中缓存,秒回不花钱。 界面清爽:左侧可折叠侧边栏,右侧固定标题聊天区。
二、为什么本地模型值得单独说:安全与保密
很多人只关注"本地模型免费",其实它更大的价值在数据安全和隐私保护。
1. 数据不出本机
Offline 模式下,模型通过 Ollama 在本机运行,请求发往 http://localhost:11434/v1,不经过任何公网服务器。你输入的每一句话、上传的每一份文档,都只在你的电脑里流转。
2. 文档不上传第三方
上传 PDF / DOCX / TXT 后,文本会被切分并写入本机 Chroma 向量库,Embedding 也由本地 BAAI/bge-m3 计算。整条 RAG 链路完全离线,合同、财报、病历、内部资料等敏感文件不用担心被第三方采集。
3. 无 API Key 泄漏风险
Online 模式需要把 API Key 配到请求头里,一旦环境被入侵或代码被误传,密钥就有暴露风险。Offline 模式不需要任何 API Key,从根上避免这类问题。
4. 对话历史只落本地
SqliteSaver 把对话记录写到本机 zanhou_memory.db,不是云端数据库。你随时可以删掉它,数据完全由自己掌控。
5. 断网也能用
飞机上、内网环境、断网会议室,Offline 模式照样能跑。对经常出差或在高保密环境工作的人,这点非常实用。
一句话总结:Online 模式拼效果和成本,Offline 模式拼安全和隐私。两者互补,场景分明。
三、技术栈选型
核心思路:所有模型都走 OpenAI 兼容接口,无论 DeepSeek、千问还是 Ollama,统一用 ChatOpenAI 调用,只需换 base_url 和 api_key。本地模型甚至连 api_key 都可以不填。
四、核心实现拆解
1. 多模型统一接入
从 CSV 读取模型信息,动态构建 LLM:
def build_llm(row, temperature, max_tokens):return ChatOpenAI(model=row["模型"],base_url=row["BASE URL"],api_key=row["API_key"] or "not-needed",temperature=temperature,max_tokens=max_tokens,streaming=True,stream_usage=True, # 关键:让流式返回 token 用量)
stream_usage=True 是消费统计的前提——没有它,流式响应不会带 usage_metadata。
2. 模型信息表格化
大模型价格.csv 包含七列:厂商、模型、输入价格、输出价格、BASE URL、API_key、说明。
用 pandas 读取,自动尝试 UTF-8 / GBK 等编码,过滤掉不可用行。侧边栏根据模式过滤:
vendor = model_info["厂商"].str.lower()offline = model_info[vendor == "local"] # 本地模型,走 Ollamaonline = model_info[vendor != "local"] # 云端模型,走 API
本地模型的 BASE URL 是 http://localhost:11434/v1,API_key 填 ollama 占位即可。
3. 文档上传与 RAG
上传文件 → 临时保存 → 对应 Loader 解析 → 文本切分 → 写入 Chroma:
splitter = RecursiveCharacterTextSplitter(chunk_size=800, chunk_overlap=100,separators=["\n\n", "\n", "。", "!", "?", ";", " ", ""],)chunks = splitter.split_text(text)vs = Chroma(collection_name=..., embedding_function=get_embeddings(), ...)vs.add_texts(chunks)
Embedding 用本地 BAAI/bge-m3,归一化后更适合余弦相似度。整个链路不上传任何数据到第三方。
检索工具通过 @tool 装饰器暴露给 Agent:
@tooldef search_docs(query: str) -> str:"""当问题涉及文档内容时检索相关片段。"""docs = retriever.invoke(query)return "\n\n---\n\n".join(d.page_content for d in docs)
4. Agent 与记忆持久化
用 LangChain 新的 create_agent(替代已弃用的 create_react_agent):
from langchain.agents import create_agentagent = create_agent(model=llm,tools=tools,system_prompt=sys_prompt,checkpointer=get_checkpointer(),)
Checkpointer 用 SQLite 全局单例:
@st.cache_resourcedef get_checkpointer():conn = sqlite3.connect("zanhou_memory.db", check_same_thread=False)return SqliteSaver(conn)
每个 thread_id 一条独立对话,关掉 Streamlit 再开,历史仍在。数据库文件在本机,数据自己掌控。
5. 消费与用时统计
流式过程中累加 token:
for chunk, _ in agent.stream(...):um = chunk.usage_metadataif um:in_tokens += um["input_tokens"]out_tokens += um["output_tokens"]
费用按 CSV 里的价格(¥/1M tokens)计算:
def calc_cost(in_tok, out_tok, row):return in_tok/1e6*row["输入价格"] + out_tok/1e6*row["输出价格"]
用时用 time.perf_counter():
t_start = time.perf_counter()# ... 流式循环 ...t_end = time.perf_counter()total_time = t_end - t_startttft = t_first_token - t_start # 首 token 时间
每轮结果写入 session_state,侧边栏按模型汇总成表格。本地模型价格为 0,能看到"没花钱但花了时间"的对比。
6. 缓存机制
LangChain 的 InMemoryCache 只对 invoke() 生效,stream() 会绕过。所以做了应用层缓存:
cache_key = (thread_id, prompt, model_name, temperature, max_tokens, collection)if cache_key in st.session_state.reply_cache:# 直接返回缓存,标记 ⚡(缓存)else:# 正常流式调用,写入缓存
命中缓存时秒回,并同步更新 checkpointer,保证下一轮历史完整。
五、界面与交互
左侧边栏:顶部标题、Offline/Online 切换、模型下拉、温度/Max Tokens、上传文档、消费统计表。 右侧主区:固定左上角 ZaneHouChat标题,欢迎语"来聊天",聊天消息流,底部st.chat_input。CSS 微调:压缩侧边栏间距、divider 高度、按钮高度,让一屏容纳更多内容。
关键 CSS:
section[data-testid="stSidebar"] [data-testid="stVerticalBlock"] {gap: 0.5rem !important;}section[data-testid="stSidebar"] hr {margin: 0.1rem 0 0.4rem 0 !important;border-top: 1px solid rgba(128,128,128,0.18) !important;}.app-title {position: sticky; top: 0; z-index: 999;background: var(--background-color);}
六、踩过的坑
create_react_agent弃用 → 换成from langchain.agents import create_agent,参数prompt改为system_prompt。stream()不走 LLM 缓存 → 自建应用层缓存,配合 checkpointer 同步。InMemoryCache 在 Streamlit 中每次 rerun 被重建 → 用
@st.cache_resource包裹成单例。torchvision缺失报错 → 是transformers的可选依赖探测,不影响文本任务,忽略或安装 CPU 版即可。流式响应默认不返回 token 用量 → 加
stream_usage=True。本地模型没有 API Key →
api_key传"not-needed"占位,OpenAI 兼容接口不校验。
七、总结与展望
ZaneHouChat 把多模型调用、文档问答、对话记忆、消费统计、用时统计整合在一个 Streamlit 应用里,代码量不大,但覆盖了 LLM 应用开发的几个核心模块:模型接入、RAG、Agent、持久化、可观测性。
最值得一提的是它的双模式设计:
Online 模式:对接 DeepSeek、千问,效果强、成本透明,适合日常问答和公开资料处理。 Offline 模式:全本地运行,对话、文档、向量、历史都不出本机,适合敏感数据、内网环境和注重隐私的场景。
后续可以继续扩展:
Token 消耗按天/按会话持久化到数据库 多会话管理(下拉切换 thread_id) Rerank 重排序提升检索精度 导出对话为 Markdown 支持更多服务商(Anthropic、Gemini) 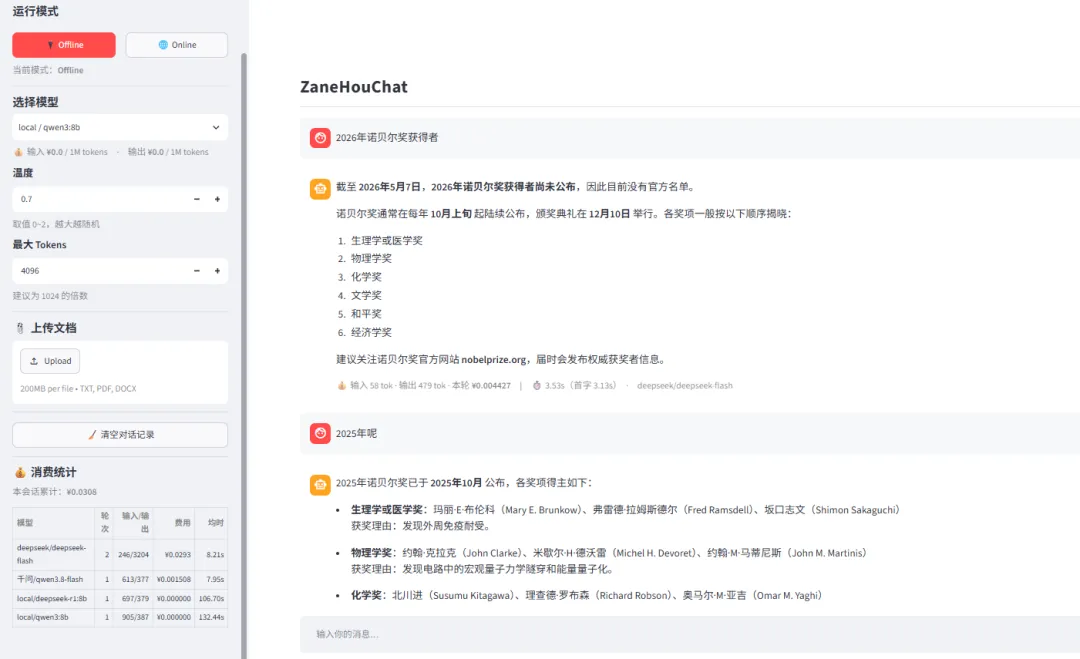
本文基于真实项目整理,代码经过多次迭代,感谢每一次报错和调试。