ARTICLE · 1133985
PDF 的字都识别了,为什么 AI 还是读错表?
把一份费用报告交给 AI,问:“研发部门这个月比上个月多花了多少?”
它回答得很快,数字也像是从报告里抄的。你回去对照原表,才发现它拿预算当实际费用,把另一列当上个月。每个数字都能找到,计算却从第一步就偏了。
遇到这种情况,继续加一句“请仔细阅读”,未必有用。问题可能发生在模型看到报告之前:PDF 转成文字时,列名、行名、单位和数字之间的关系已经散了。
识别出文字,只能证明页面里有什么字。要让 AI 正确读表,还得把“这个数字属于谁”一起交给它。
这篇从一张费用表出发,讲清文档解析、信息检索和回答生成各自该检查什么。以后答案算错,可以先定位环节,再决定是换解析方式、调整切分,还是修改提问。
1. 页面看起来像表,文字流未必像表
人看费用表,会同时用到位置、边框、合并单元格和表头。数字 12 在“研发”这一行、“实际费用”这一列,表顶写着“单位:万元”。这些关系合在一起,才构成一条可用的信息。
PDF 更接近一份页面呈现说明。页面上的文字怎样排列,未必等同于人习惯的阅读顺序。扫描件还需要先识别文字;有文字层的 PDF,也不因此自动拥有正确的表格结构。
假设原表有三列金额:本月预算 10、本月实际 12、上月实际 9,单位都是万元。正确比较应当取 12 和 9,得出增加 3 万元。
转换后如果只剩下“研发 10 12 9”,模型就得猜三个数字分别属于哪一列。它猜中了,看起来像能力强;它猜错了,页面上也没有明显证据提醒系统停下来。
多栏排版还会出现另一类问题:左栏还没读完,文字流就接到右栏;页眉、页脚混进正文。读者眼里的连续段落,转出来可能像几段话被轮流插播。
最近 Docling 的官方更新记录在 2026 年 10 月 1 日的 v2.132.0 中列出了 PDF 阅读顺序算法更新。这个变化值得关注,因为文档进入 AI 之前的排列方式,会影响后续理解。更新记录没有给出本文这张表的测试结果,也不能据此推断所有文档都能准确解析。
选工具时,别只看“支持 PDF”四个字。需要进一步看它如何处理阅读顺序、表格关系和来源位置,以及你的文档是否真的被处理对了。
2. 先给数字补回完整身份
对研发费用这条信息,一份有用的解析结果至少应该能说明:部门是研发,统计期间是什么,本月预算是多少,本月实际是多少,上月实际是多少,金额单位是什么。
其中“本月”还要有上下文。报告标题写着“9 月费用报告”,这条数据就应带上对应统计期间。否则,几个月的报告放进同一个知识库,每张表都叫“本月”,检索回来很容易串台。
金额单位也不能只留在表格上方的一个角落。表被单独拿出来使用时,需要一起带走。12 元与 12 万元都写成数字 12,计算程序不会替你发现数量级变了。
合并表头尤其容易被忽略。上层标题写“本月”,下面分“预算”和“实际”;另一列写“上月实际”。如果只保留第二层短词,“实际”就可能出现两次,字段含义仍然不完整。
把表头的层级展开成完整名称,再保留每一行与这些名称的对应关系。 这里的展开是为了表达原表含义,不能替原文增加没有写过的条件。
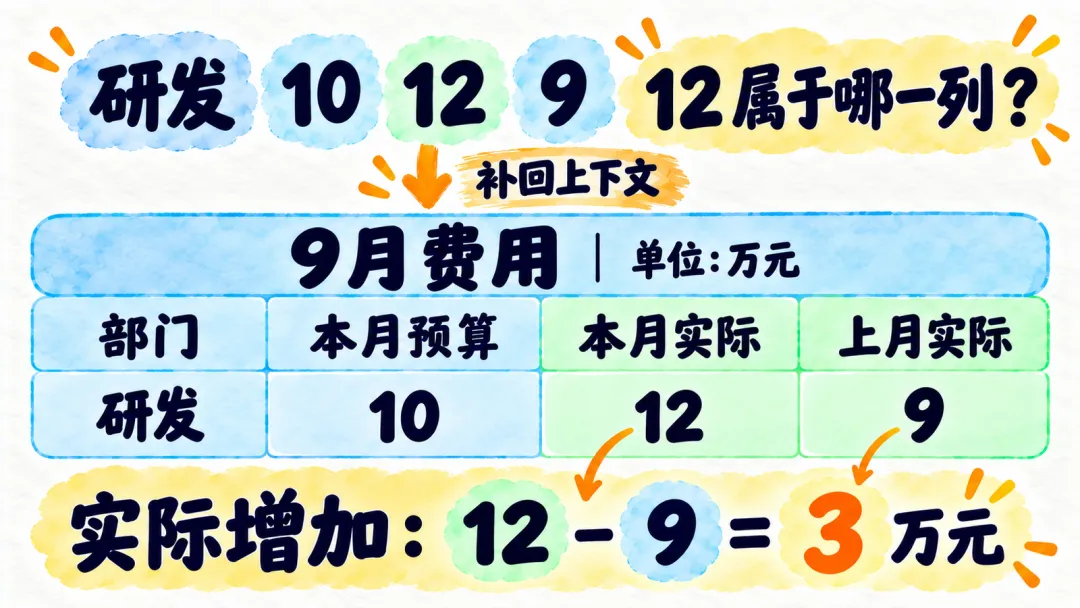
简单表可以用清楚的 Markdown 表格表达;有多层表头、跨行说明或复杂合并的表,适合保留更完整的结构记录。重点是数字与行列关系能否还原,不必为了“结构化”把所有表都塞进同一种模板。
Docling 的固定版本项目说明介绍了阅读顺序、表格结构处理,以及统一文档表示和多种导出方式。它提供的是处理文档的能力与路径。选择具体管线后,仍要检查输出是否保住了本次业务需要的关系。
3. 切分时,别把答案和解释它的东西拆开
表格解析正确,接下来切进知识库时,关系仍然可能再丢一次。
比如按照固定字数切分,第一段包含标题、单位和表头,第二段只剩研发这行数字。检索系统找到了“研发”,把第二段交给模型。模型收到的内容,又变回了“研发 10 12 9”。
这时继续优化回答提示词,往往是在修下游的表现。上游送来的材料本来就缺了一截。
一种更稳妥的做法,是将表格作为一个有身份的内容块,保留所属报告、统计期间、完整列名、单位及必要说明。表太长时可以分成若干行组,每组都带上同一套表头与上下文。
重复一点表头,会增加存储或输入长度;但它能让每个片段独立解释。对需要回答金额、数量和同比环比的问题,这个取舍通常比让模型重新猜列名更可控。
长表跨页时,也不要看到页面换了就自动拼接。需要确认表名、列结构和续表关系一致。两张不同的表恰好列数相同,不足以说明它们可以合并。
脚注要按它的作用处理。“不含税”“暂估”“含上期调整”等说明可能直接改变数字的业务含义,应随相关数据进入检索材料。装饰性页脚则可以过滤。两者都位于页面底部,却不能用同一种规则删除。
这些上下文不一定都由解析工具自动补齐。应用可以在解析后建立关联,但要保留原文依据,避免补关联时又制造一层新的推断。
4. 来源页码要能带人回到那一格
答案后面写“来源:第 7 页”,比完全没有出处好。但第 7 页可能有三张表,表里又有几十个数。复核人员还得重新找一遍。
对数字类回答,可以让来源更具体:文件标识、报告期间、页位置、表格名称、对应行列。如果解析方式能提供区域位置,还可以保存区域与页面的关联,方便回到原表查看。
页码本身也要约定清楚。PDF 文件的第 7 张页面,未必等于印在页脚的“第 7 页”。封面、目录和插页会让它们产生偏差。系统可以同时记录文件页位置与文档印刷页码,不把两个数字混成同一字段。
来源位置解决的是“到哪里检查”。它没有自动证明答案正确。模型即使引用了正确页面,也可能选错列、忽略单位,或把两个月的记录拼到一起。
所以,引用之外还要能复核计算过程。对这个问题,界面最好能展示:本月实际 12 万元,上月实际 9 万元,差额由 12 减 9 得到。读者一眼能看出取数口径,而不必只相信一句“增加了 3”。
如果需求只是比较已提取的数字,可以让程序完成减法,让模型负责解释结果。这样既容易检查,也能避免把数值运算与表格理解混在同一次回答里。
5. 遇到缺表头,系统应该停在哪里
不能因为原表里出现了三个数字,就一定能回答这个问题。
如果解析结果缺少列名,先回到原页面核对或重新解析;如果检索片段缺单位,补取相邻上下文;如果同一部门出现多个统计期间,先依据问题确定期间。条件没补齐时,说明缺哪项信息,比输出一个看起来精确的数字更有用。
扫描件存在另一种风险:某个数字本身识别错了。例如小数点、负号或括号没保住。结构完整只能证明“它被放进了这一列”,不能证明数值一定正确。关键金额需要对照原图检查,无法确认时进入人工复核。
如果准备再用视觉模型核对页面,要保存它拿到的页区域与输出,不把二次识别当成天然正确的答案。一个模型看错,换一个模型继续看,有时确实能补救;也可能只是让错误获得第二票支持。
对业务来说,暂停点可以写得具体:列名缺失不能计算,单位缺失不能换算,期间不唯一不能比较,关键数字无法核对不能形成最终结论。复核完成后再继续,已经确认的数据不必全部重做。
这几条规则不要求系统永远不犯错。它们让系统在缺少依据的时候,不把猜测悄悄包装成已完成的分析。
6. 用一页报告,把错误分成三段查
验收时,先准备一页含费用表的报告,明确期望答案:研发本月实际 12 万元,上月实际 9 万元,增加 3 万元。这是检查目标,不是让模型记住唯一正确句子。
第一段查解析。直接查看转换后的表格,不问模型。确认部门、完整列名、统计期间、单位与三个金额的对应关系。这里错了,就先处理解析或后续结构整理。
第二段查检索。提问后,把实际送给模型的片段拿出来看。它是否包含研发这一行,是否带着正确期间、表头和单位?如果解析结果是对的、输入片段却缺东西,重点处理切分和检索。
第三段才查回答。材料已经完整,模型仍选了预算列,才需要检查字段解释、提问方式和回答约束。差额计算则单独核对,不把选择错误与算术错误混在一个“准确率”里。
还可以故意拿掉单位,观察系统是否暂停;把同一张表拆成跨页形式,检查是否正确保留续表关系;加入另一个月份,检查是否选错期间。这些变化比重复问十次同一个问题,更能暴露系统依赖了什么。
回到文章开头:答案拿预算当实际费用,未必是模型算得差。它也许从一开始就没有拿到完整的表。
如果你正在做 PDF 问答或报告分析,先挑一页最常出错的表,把解析结果、检索片段和最终答案摆在一起。沿着这三段看,往往能比继续堆提示词更快找到问题。
先让数字带着列名、单位、期间和来源进入系统,再让 AI 解释它。这样,“字都识别出来了”才有机会变成“这张表真的读明白了”。