ARTICLE · 1149406
300 万行的表,Excel 根本打不开?这条命令 0.3 秒出结果:免费开源,12MB 免安装
效率工具 · 实测系列 017
300 万行的表,Excel 根本打不开?这条命令 0.3 秒出结果:免费开源,12MB 免安装
你大概率遇到过这种表:系统导出的订单流水、考勤记录、访问日志,几十万行起步,Excel 一打开就转圈,点个筛选卡半分钟。要是行数再多一点——比如 300 万行——Excel 会直接告诉你:装不下。
不是电脑不行,是 Excel 的上限就摆在那:一张工作表最多 1048576 行,第 1048577 行开始它就看不见了。
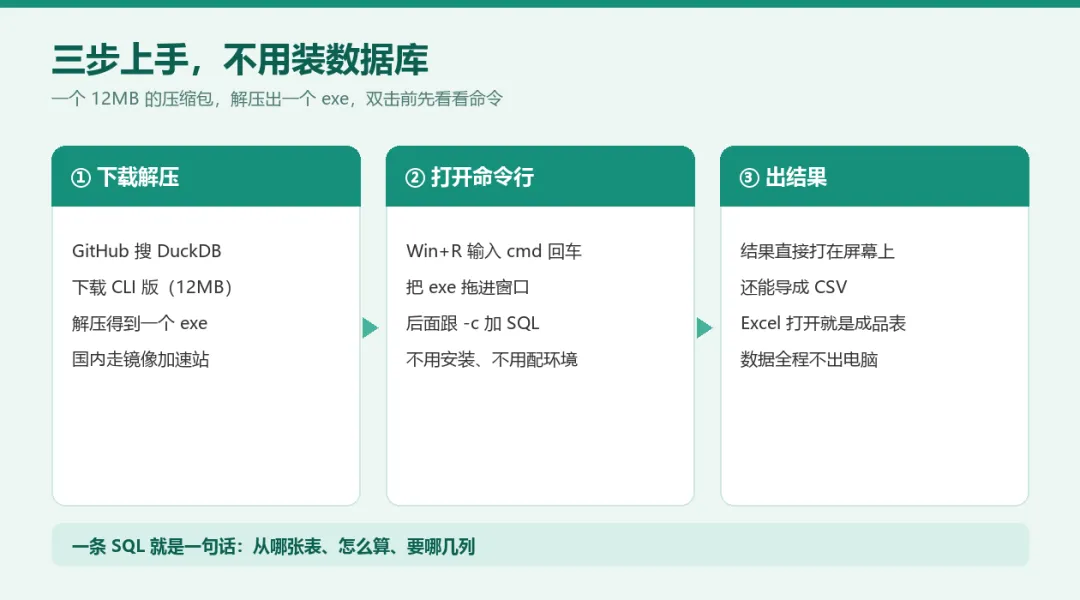
今天这个工具专门治这个:DuckDB,免费开源,整个软件就是一个 12MB 的压缩包,解压出一个 exe 就完事,不用安装、不用配环境、不用装数据库。
一、它是怎么干活的
一句话:把 CSV 当数据库查。
不需要"导入"这一步,命令里直接写文件名,它边读边算。你只需要写一条 SQL——别慌,SQL 就是"从哪张表、怎么算、要哪几列"的一句话,文末有模板直接抄。
二、实测:300 万行,最快的查询 0.25 秒
说明:测试数据为脚本生成的模拟件——300 万行订单流水 CSV(279MB)+ 20 万行客户表,下文耗时均为这台 Windows 电脑上的真实计时。
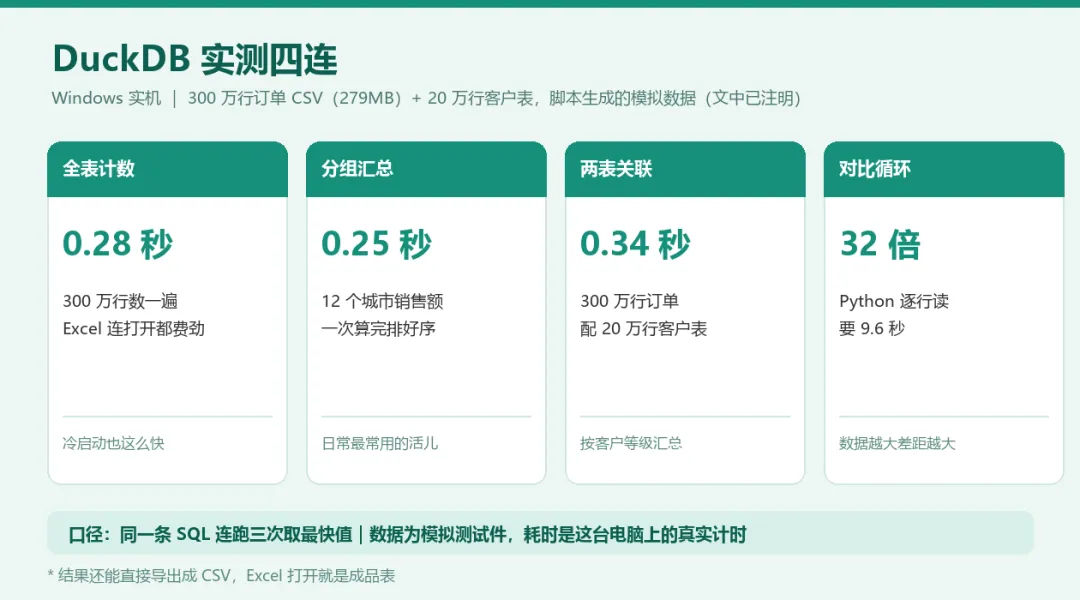
老规矩,直接上真实数据。测试环境 Windows 11,DuckDB v1.5.6 CLI 版,普通办公本。四组实测,每条 SQL 连跑三次取最快:
| 0.28 秒 | ||
| 0.25 秒 | ||
| 0.26 秒 | ||
| 0.34 秒 |
最后一列值得多说一句:同样的"按城市汇总",我用最朴素的 Python 写法——一行一行读、读一行算一行——跑了 9.6 秒,是 DuckDB 的 32 倍。而且数据每翻一倍,逐行的写法就跟着翻倍,DuckDB 基本不动。
结果还能一条命令导出成 CSV,用 Excel 打开就是排好序的成品表——大表在 DuckDB 里算,小结果拿 Excel 看,各干各的活。
三、三步上手
第一步,下载。GitHub 搜 DuckDB,下载 CLI 版(12MB 的 zip,解压出一个 duckdb.exe,免安装)。国内打不开 GitHub 的,用镜像加速站就能下。
第二步,打开命令行。Win+R 输入 cmd 回车,把 duckdb.exe 拖进窗口,后面跟 -c 加你的 SQL:
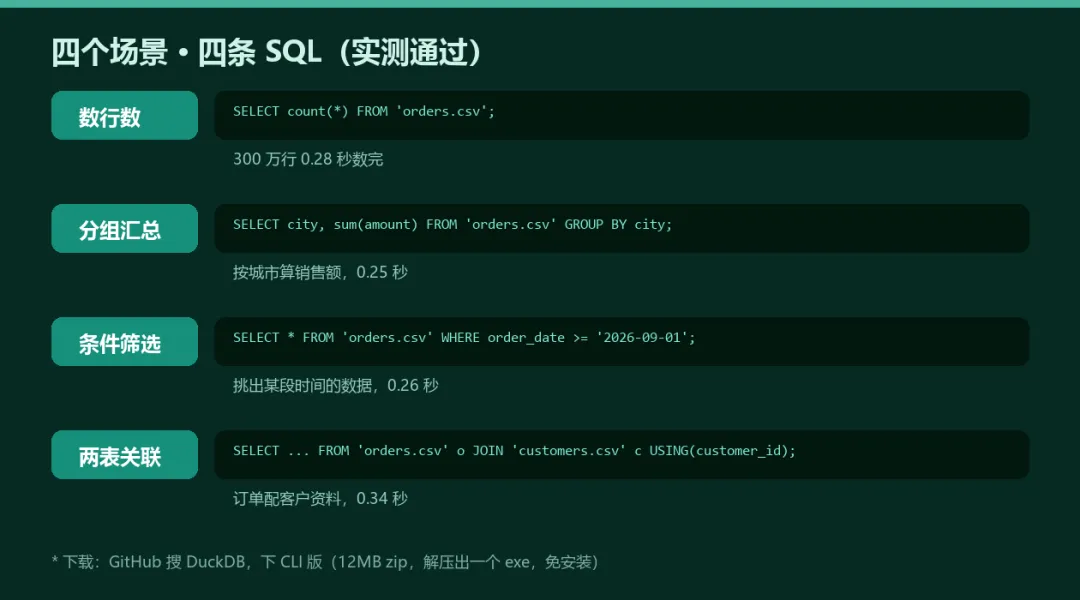
duckdb -c "SELECT count(*) FROM 'orders.csv';"
回车,0.28 秒,300 万行数完。
第三步,认模板。日常 90% 的活儿就这三句:
-- 数行数 SELECT count(*) FROM '订单.csv'; -- 按某列汇总(把 city、amount 换成你的列名) SELECT city, sum(amount) FROM '订单.csv' GROUP BY city; -- 挑某段时间的数据,导出成新 CSV COPY (SELECT * FROM '订单.csv' WHERE order_date >= '2026-09-01') TO '结果.csv' (HEADER);
列名就是 CSV 第一行的表头,改三个词就能用。
四、两个提醒
① 中文乱码。Excel 另存的 CSV 默认是老编码,DuckDB 读出来中文可能变问号。用记事本把文件另存为 UTF-8 就好。
② 它不是表格软件。DuckDB 负责"算",不负责"看"。要排版做图表,把算好的小结果导出 CSV,再回 Excel。
写在最后
写这篇之前我也没意识到,"Excel 打不开的大表"这件事,能被一个 12MB 的小文件解决到这个程度——300 万行,0.3 秒,不用装任何数据库。
工具免费开源:GitHub 搜 DuckDB,下 CLI 版(解压出一个 exe,免安装)。
下次面对打不开的大表,先让 DuckDB 跑一遍再说。
注:文中测试数据为脚本生成的模拟件(非真实业务数据),所有耗时均为本机真实计时,不同电脑会有差异。软件仅作效率工具分享,数据全程在本地处理。