ARTICLE · 1149607
同样是喂文档,为什么别人的 AI 更好用
同样是喂文档,为什么别人的 AI 更好用
上回聊到一个结论:AI 缺的不是脑子,是你公司的那点事。把公司的资料喂给它,它才能从"什么都懂的路人"变成"懂你业务的自己人"。 这话只说对了一半。 同样一堆文档,十家公司喂进去,可能有九家用不起来。 差别不在文档质量,也不在你用的是哪个大模型。真正的差别,藏在几个没人愿意细看的地方。 一、先把一个流行的比喻纠正一下 动手之前,先把说法统一了。 有个流传很广的比喻:RAG 相当于图书馆,Wiki 相当于笔记,本体相当于笔记之间的联系。 方向对,但差了一层。更准的说法是这样: 它们是三层,不是三条路。 你不需要在"图书馆"和"笔记"之间二选一。正常的顺序是:先把书摆上书架,再请管理员,最后定分类法。顺序反了会出事。 下面这几个坑,恰好都在这条路上。 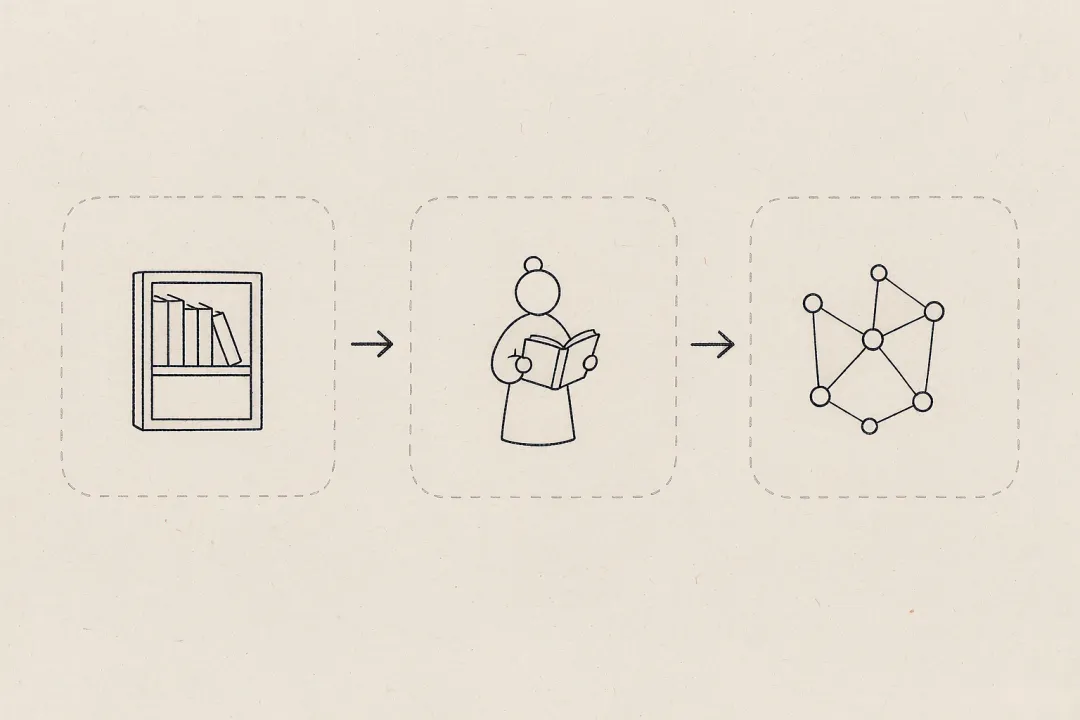
二、坑一:书被剪成了碎纸条 AI 读你文档的方式,不是"打开整本书看一遍"。 它是先把文档切成一小块一小块,再一块一块去读、去记。这个动作,叫分块。 AI 读到的不是你那份文档,是你切完之后的那一小块。 切得好不好,后果很直接: 结果就是:内容明明就在库里面,它就是答不出来,或者答得驴唇不对马嘴。 同一个模型,换一套切法,效果能差出一大截。切得好,AI 拿到的是完整的一段话;切得糙,你等于给了它一堆断章。 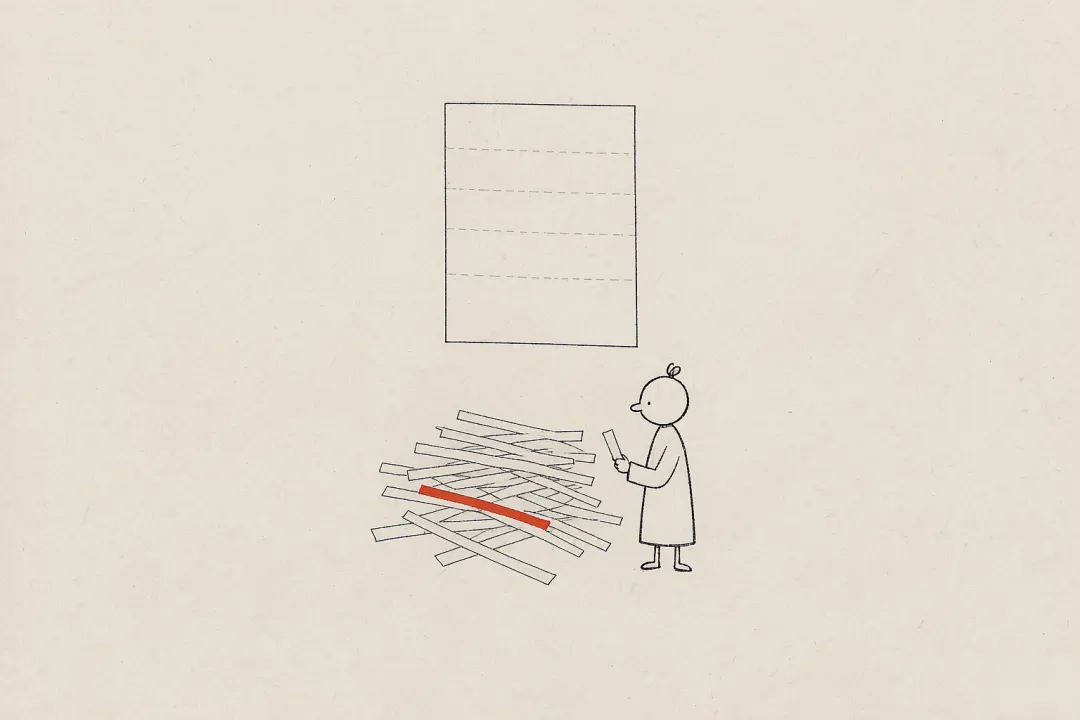
三、坑二:只会认"意思像不像" 假设你要问:"XT-2000 这款设备的维保条款怎么写的?" 那位管理员如果只会按"意思像不像"去找书,他会给你抱来一堆讲"设备保修""售后服务""质保期"的书——意思都很接近,但没有一本是你要的。 因为企业文档里最多的,就是型号、编号、合同号、专有名词。 这些东西必须精确命中,差一个字母都不行。而"意思像不像"这种找法,恰恰对精确词不敏感。 靠谱的做法是两条路一起走: 两条路各找一批,合到一起。然后还要请一位复核员,把候选按相关度重新排一遍,只把最相关的几条递到 AI 手上。 这位"复核员",是整条链路上性价比最高的一笔投入——比换一个更贵的模型管用得多,也便宜得多。 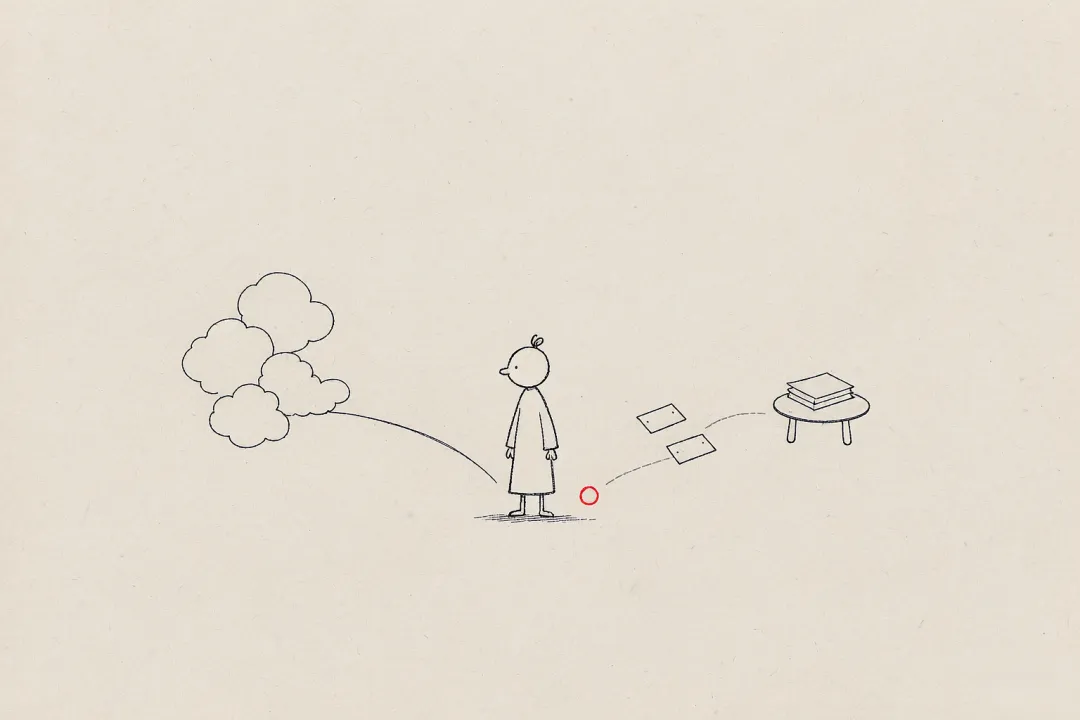
四、坑三:谁都能抽到不该看的书 这条最不起眼,也最要命。 图书馆里的书,是有分区的。高管的薪酬册、招标的底价表、还没公布的人事决定,不是谁都能翻。 这些文档在原来的文件夹里,本来是有权限的。可一旦进了知识库,权限经常就丢了——因为搭知识库的人,往往只关心"能不能搜到",忘了"谁该看到"。 于是就会出现这种情况:一个刚入职的员工,随口一问,就拿到了本该只有总监才看得见的东西。 权限必须在"找的那一刻"就拦住,不能等答案写出来再遮。 因为等答案生成完,那些敏感内容已经写在回答里了。你再遮,遮的是显示,不是泄露。 对政企、金融这类客户,这不是体验问题,是能不能用的问题。 
五、还有一件和技术无关的事 前面三条都是工程问题,这一条不是。 知识是会过期的。 制度改了、产品下架了、价格调了、合同续签了——但旧的那份文档,还躺在库里。 这时候它不是"知识",是"错误的权威"。因为它带着你公司的抬头、用着你熟悉的格式,答得理直气壮。这比 AI 瞎编还危险——瞎编你还能闻出味儿来,这个你闻不出来。 所以一个知识库能不能活过一年,看的不是技术,是有没有这几样东西: 技术解决"能不能查到",机制解决"有没有人写、写的人管不管更新"。 而后一半,才是大多数项目真正栽跟头的地方。 
最后 回头看,这几件事有个共同的规律: 它们全都不在模型那一环。 模型只是整条路中间的一段。前面要把文档切好、放好,中间要检索得准,后面要有人维护、有权限兜着。任何一段掉链子,用户看到的都是同一句话——"这东西不好用"。 所以顺序特别重要: 先把资料收进 Wiki,再让 RAG 答得准,最后才谈本体推理。 这套做法,就是我们做的 易知格|OntoEasy:独立部署在客户自己的环境里,开箱即用;轻量模式先用 Wiki + RAG 快速跑通,真需要跨文档推理了,再叠上本体——不用换系统,往上加一层就行。 易部署,知全局,格万物。 说到底,知识库拼的从来不是模型有多强,是那一圈没人愿意干的细活,有没有人干。
Wiki 是书架——书总得先有个地方放,而且大家都能往里放、能一起改 RAG 是那位读过全部藏书的管理员——你问他,他翻出几本相关的念给你听,还告诉你这话在第几页 本体是图书馆的分类法——它不存书,但它规定了这本书归哪一类、跟哪些书是一套
一张报销标准表从中间被切断,前半截在上一块、后半截在下一块,AI 看到的是"住宿费上限"和"600 元"分了家的两个碎片 一份设备图纸被切掉一半,剩下的那半谁也看不懂 一条完整的操作流程被拆成三段,每一段单独看都不成立
一条按"意思像不像"找——用户问得口语化,也能找到 一条按"字面有没有"找——型号、编号这种精确词,一个字都不放过
每份知识都有人负责,不能是"大家的" 有复审周期,到点提醒 谁写、谁审、谁下架,落到具体的人头上