ARTICLE · 1156547
从查阅数据库到联合多组学分析,AI 工具现在能真正接手哪些工作?这 8 个项目值得研究
七七叭叭
从查基因、补文献,到找公开数据、跑组学分析,AI 都有专门的工具可以调用。这篇我挑了 8 个项目,按科研任务的顺序讲清楚它们各自接哪一步,也会告诉你我自己的选择。
大家好,我是七师兄。
拿到一张差异基因表,活才刚开始。一个名字不熟的基因,要查功能、看相关研究;有了值得追的方向,又想找一批公开数据看看。等数据备齐了,分析流程里还有参数要定、报错要处理。
这些活适合从哪里交给 AI?我把 8 个项目的官方文档和示例挨个对了一遍,最有意思的变化是,我们已经能把要求说到具体操作上。查一条记录、取一段序列,都有对应的工具可以接,连流程为什么失败也能问出个所以然。
我看一个科研 AI 工具,先问它接手了哪一步,交回来的东西能不能接着用。 带着这个问题看名单,里面的名字就都好理解了。
目录
•拿到一个基因,先把它查明白
•文献看过了,能用的数据在哪里
•开始跑分析,AI 能参与哪些操作
•做植物研究,工具也要跟着物种走
•同一项工作,下次怎样接着做
•七师兄的建议
拿到一个基因,先把它查明白
来,七师兄拿个具体例子讲。
gget-mcp 的官方示例里,正好有查询人类 TP53 信息、再取回蛋白序列的任务。这里其实是两个动作,先把名字对应到具体记录,再根据记录取回序列。我们平时在网页之间来回切换,干的也是这些事。
gget-mcp 把 gget 里一批常用操作接给了 AI。 查 Ensembl 标识符和基因信息、取核酸或蛋白序列,还能调用 BLAST、多序列比对和富集分析。查完一个基因,接下来要取什么、比什么,都有现成的工具等着调。 项目说明
我喜欢拿这种任务入门。输入是什么,输出长什么样,都容易检查。拿回一段序列,还能接着核对物种和转录本,读者很快就能看明白 AI 到底替自己做了什么。
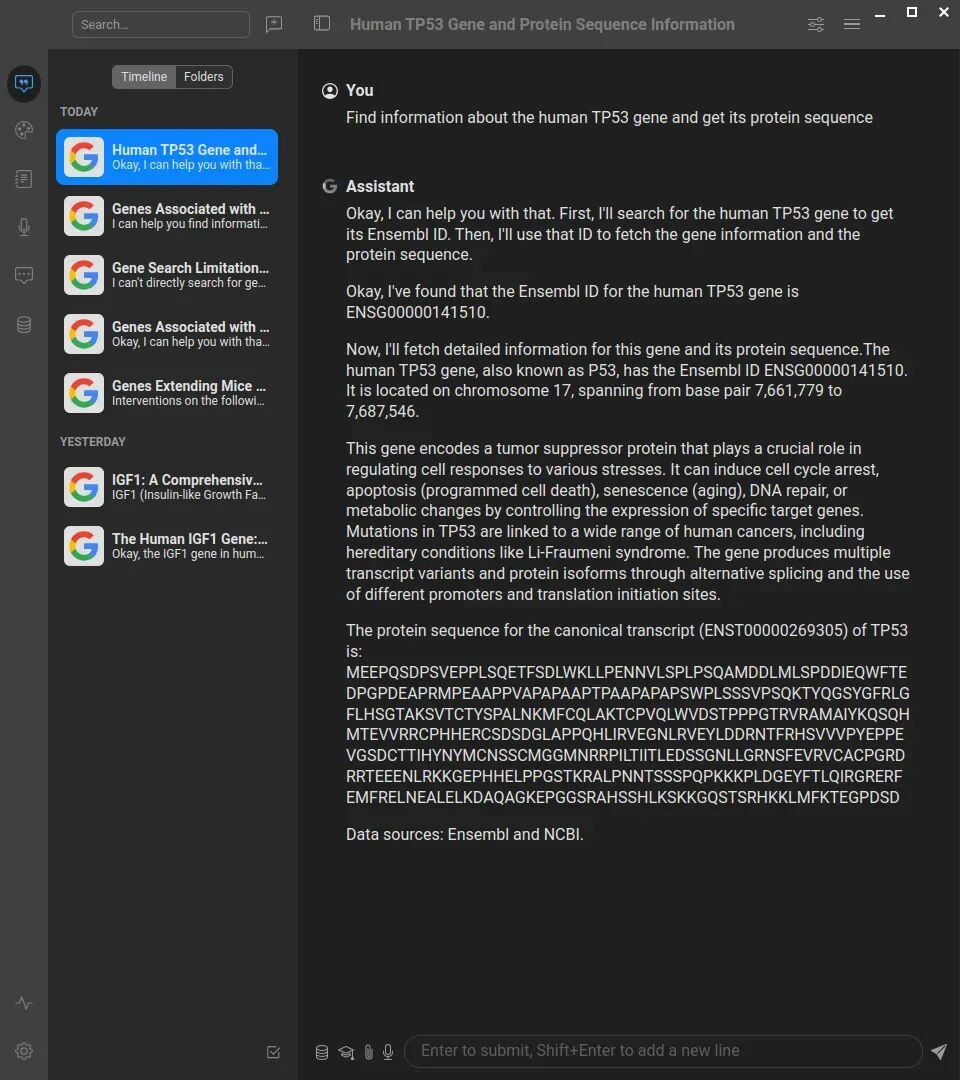
图 1|gget-mcp 项目提供的对话示例,把基因查询这类操作接进 AI 助手。图片来自官方仓库。
如果问题变成“这个基因和某种疾病有什么关系”,我会接着看 BioMCP。
它把查询按基因、变异、疾病、药物这些对象来组织,能访问 PubMed、ClinVar、ClinicalTrials.gov 等资源。查文献时还会用 PMID、PMCID、DOI 这类标识符整理结果,方便一路追到具体文章。 BioMCP 项目说明
这种设计适合顺着问题一路追问。先找到一个变异,再查相关文献和研究记录,前后都围着同一个对象转。读到这里,我更在意返回内容有没有保留研究对象和出处。讨论一个基因在某种疾病里的作用,得知道证据来自哪种样本、用了什么研究方法,这些细节直接影响后面的选题。
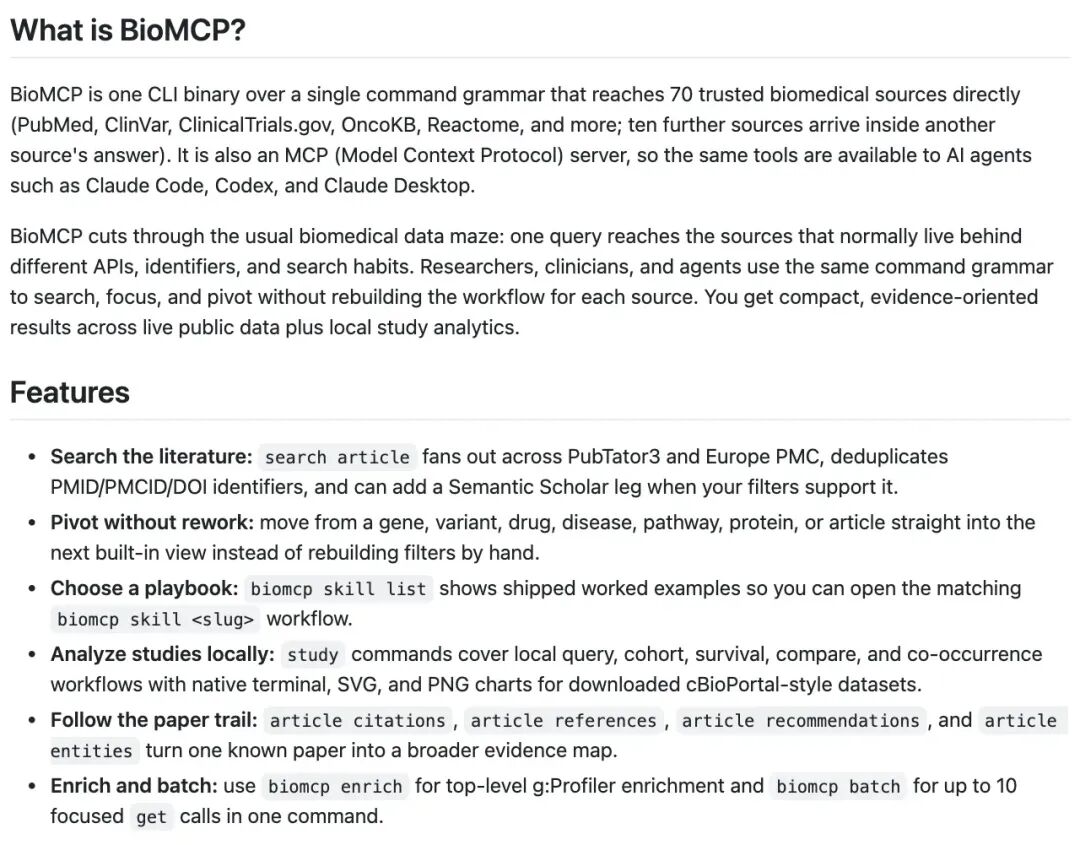
图 2|BioMCP 官方项目页截图。查文献、再顺着生物医学对象继续挖,是它的主要用法之一。查看项目。
第三个是 BioContextAI 的 knowledgebase-mcp。名字有点长,记住它能接进多种生物医学资源就行。
它列出的接口包括 Open Targets、Reactome、STRING、Human Protein Atlas 和 Europe PMC 等。拿一个候选基因,能从疾病关联查到通路,再补上蛋白表达或互作信息。 官方工具目录
这些数据库之间的差别,值得多讲两句。疾病关联回答的是它和哪些疾病有联系,通路记录帮我们理解它参与什么生物过程,蛋白表达信息则给出组织层面的背景。信息放到一起以后,还要保留它们各自回答的问题。 我会要求 AI 整理时附上数据库名称和记录链接,回看时能快速找到依据。
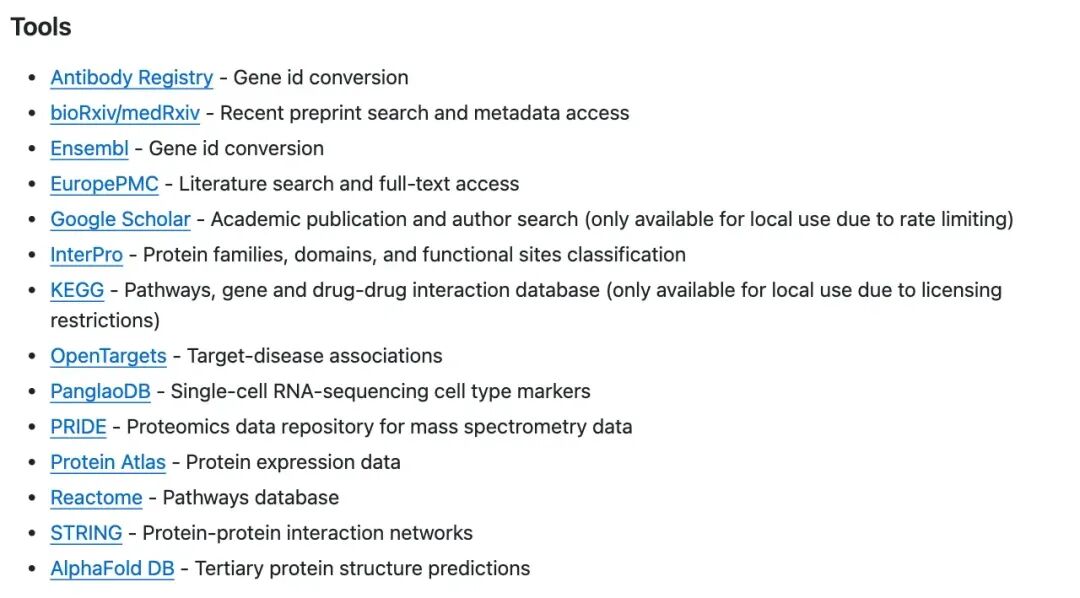
图 3|BioContextAI Knowledgebase 的资源目录截图。每个数据库都有自己的信息类型,适合按研究问题分开查。查看目录。
这三个项目里,我把 gget-mcp 放在“查记录、取序列、做常用操作”这一侧;追疾病和变异的证据,多看 BioMCP;要从几类知识资源补齐背景,就看 BioContextAI。它们功能有交集,选的时候对照手里的任务就行。
文献看过了,能用的数据在哪里
有了候选方向,总还想找一批数据继续看。这时候,roda-mcp 值得认识一下。
RODA 是 AWS 的开放数据注册表。这个项目给注册表里的数据提供搜索、元数据查看和文件预览,还能浏览公共存储桶的内容、抽少量文件检查格式。AWS 的官方示例里,就有查看 1000 Genomes 数据文件结构和 README 的演示。 AWS 项目介绍
我觉得“预览”这功能最实用。找到一个数据集,你最想弄明白的通常是里面到底放了什么。样本说明在哪、给的是原始数据还是处理过的文件、能不能支撑自己的分析,这些都能先查清楚,再决定下载哪些内容。
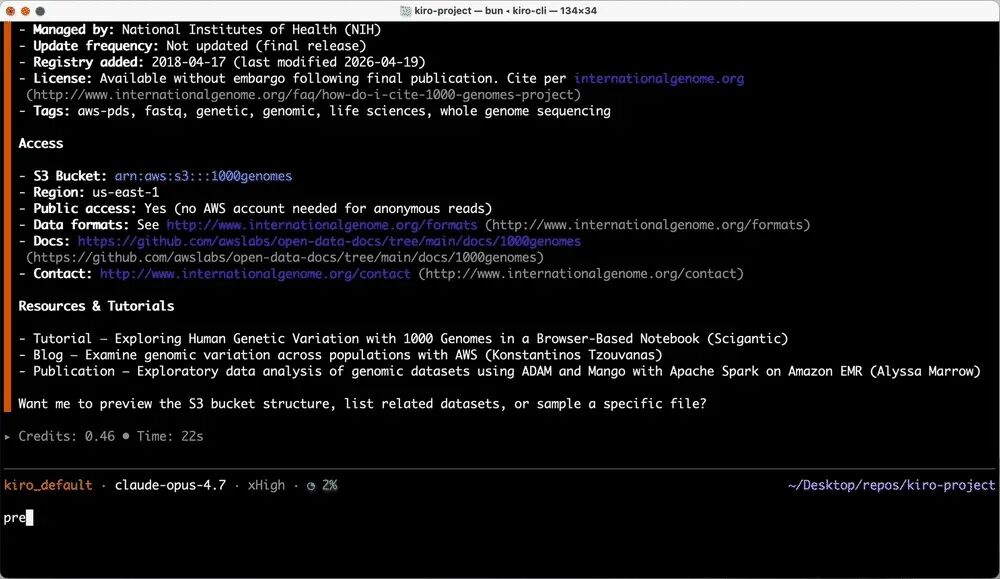
图 4|AWS 官方演示动图,展示 RODA 数据文件的浏览和采样预览。查看原文。
到这一步,我会先把研究设计写进要求里。研究什么物种、要什么组织、样本有没有可比的分组。工具负责把候选资料找出来,我们按这些条件挑。
下载链接很快就能拿到。一批数据值不值得进分析,要看它能回答什么问题。 这一步判断做扎实了,后面选方法才有依据。
交流群
我们【罗小罗同学】团队建立了多个【虚拟细胞】,【医学AI】,【科研Agent】等方向交流群,交流 群设立的初衷是提供交流平台,方便大家后续课题合作。
目前推销人员较多,我们开启了入群验证,可以扫码添加我的微信,拉您进群,请备注要进入的交流群方向和姓名-单位-科室/专业。
团队全平台关注量120,000+ ,交流群总成员4000+ ,大部分来自国内外顶尖院校/医院,期待您的加入!!
开始跑分析,AI 能参与哪些操作
Seqera,把问题问到正在运行的流程上
如果你已经在用 Nextflow 跑流程,Seqera MCP 会比较好理解。
它把 AI 助手接到 Seqera 平台,提供流程启动、监控和管理的工具。官方文档里还列了 Wave 容器、nf-core 模块,以及 SRA、ENA、GEO 数据检索相关能力。连接时用自己的平台账户或访问令牌,计算任务由配置好的执行环境承接。 功能与接入说明
这时候能问的问题就有具体对象了。哪次运行失败了、失败任务是什么状态、要看哪些日志、从哪里开始排查。平台里的运行信息能进对话,AI 的解释也就有了依据。 平台工具文档
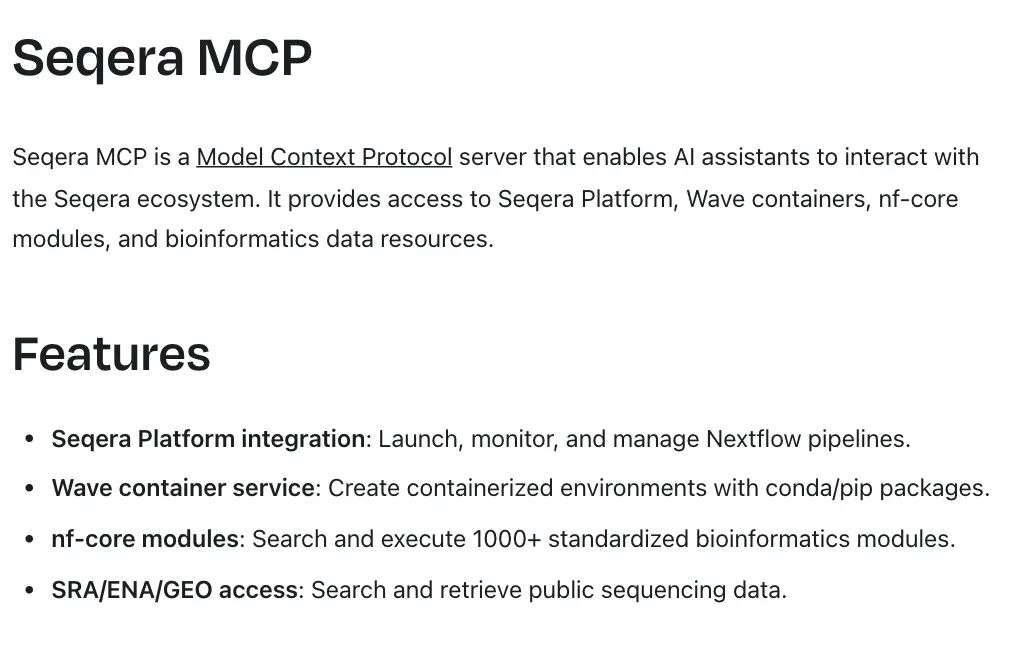
图 5|Seqera 官方文档截图,列出流程管理、运行环境和公共数据相关功能。查看文档。
我推荐给已经有固定流程、需要反复跑和反复看结果的人。下一批样本来了,沿用哪个流程版本、输入放哪、任务跑得怎么样,这些都有明确的工作背景。
初学者读这段,可以先认识一种变化。AI 开始能拿到分析平台里的实际状态,再据此参与操作。等你的流程稳定下来,就更容易判断这个连接值不值得加。
ChatSpatial,把空间问题落到具体分析方法上
ChatSpatial 是这份名单里,我最想给做空间组学的朋友展开讲的项目。
它面向空间转录组,覆盖数据读取、预处理、空间区域识别、细胞组成估计这些分析环节。模型根据工具定义选方法和参数,再由对应的分析程序执行。项目还整理了可以直接参考的自然语言任务示例。 项目介绍、 入门示例
它的吸引力在于,能把一个生物学问题一步步落实成操作。拿到一张空间切片,可以先看组织形态和表达分布,再决定识别空间区域,还是估计不同细胞类型的组成。这两种需求会把分析带向不同的方法。
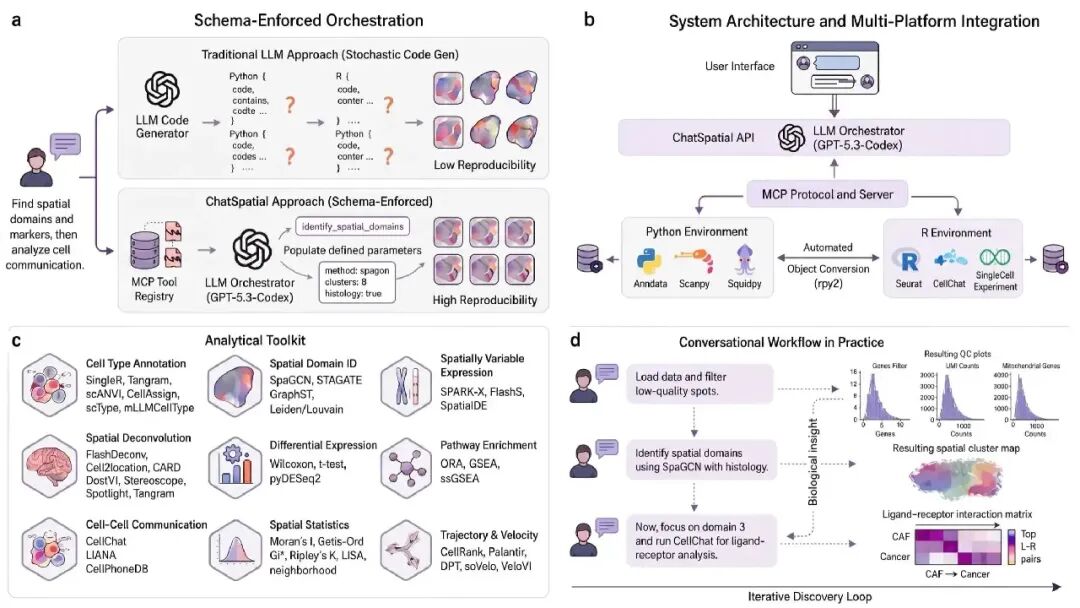
图 6|ChatSpatial 官方概览图,展示自然语言请求和空间转录组分析工具之间的关系。原图里的结果用于说明项目设计。查看项目。
拿 Visium 数据来说,如果你关心组织里哪些区域表达模式相近,可以从空间区域识别入手;想知道每个位置由哪些细胞类型构成,就要考虑细胞组成估计,检查所选方法需要的单细胞参考和输入格式。区域划分和细胞组成回答的问题不同,讲结果时也应该分开解释。
我会在这里多停一会儿。自然语言让操作容易发起,研究问题还是得说具体。你想比较两个组织区域,还是某类细胞在不同位置的分布?把这句话说清楚,才好决定下一步调什么工具。
ChatSpatial 的一些方法还要额外装 Python 或 R 依赖,安装时按目标分析选环境。对做研究的人,我更愿意先挑一条自己需要的分析路线,把输入、方法和结果串起来,再慢慢加其他功能。
七师兄怎么看
我看好这类工具,它让我们更方便地调用已有方法,也更容易查看执行过程。拿空间分析举例,一段自然语言请求里,可以同时交代数据位置和想研究的问题,后面再逐步补参数。
讲到结果时,我会坚持把图放回研究设计里看。 一个区域为什么单独成群,要结合表达特征和组织位置解释;换一种方法后分区变了,就得继续查变化发生在哪里。工具把操作接起来以后,这些比较会更值得花时间。
如果让我安排第一次尝试,我会选一份熟悉的小数据,先完成一个问题。自己知道数据的大致结构,也知道哪些输出要细看,跟 AI 讨论时才有判断的依据。
做植物研究,工具也要跟着物种走
讲到这里,做植物的朋友可以看看 plant-genomics-mcp。
它围绕植物基因位点来组织工具,接入 Ensembl Plants、Phytozome、Planteome、PlantCyc 等资源,还提供序列搜索、功能注释和跨来源查询。官方示例用拟南芥 AT1G01010,演示怎么从一个位点查到基因和蛋白记录。 项目与示例
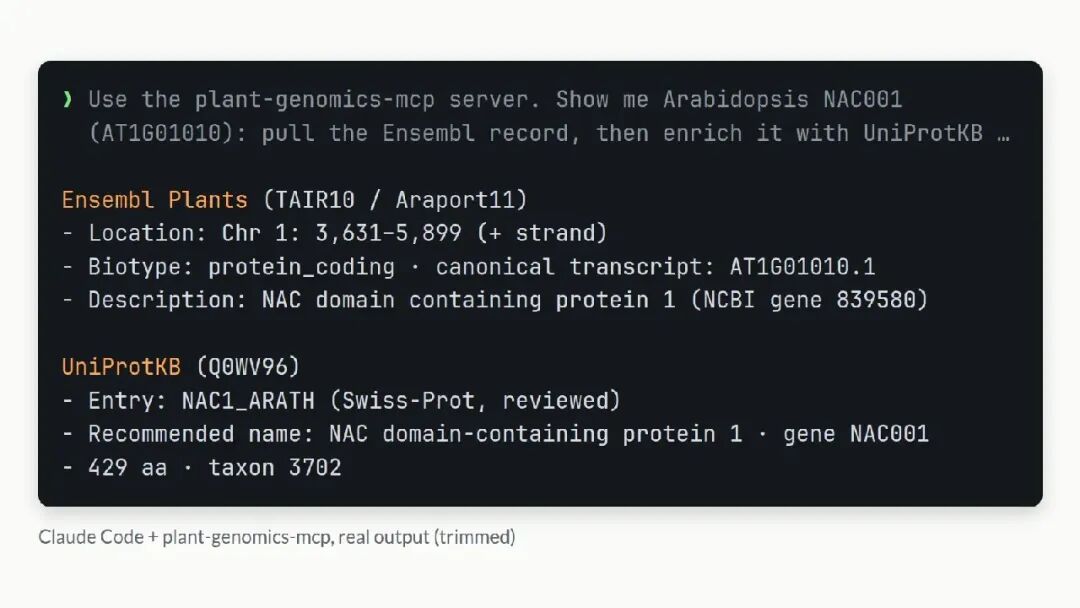
图 7|项目提供的拟南芥位点查询截图,能看到 Ensembl Plants、UniProtKB 等信息来源。图片来自官方仓库。
我喜欢这个例子里的一个细节。输入是研究者手里的基因位点,后面的工具要把它映射到各个数据库用的标识符。换成水稻或其他物种,还得带上正确的物种信息。这些步骤平时很琐碎,却直接决定查回来的记录对不对得上同一个对象。
所以,植物方向的读者选工具时,我会建议先拿自己常用的物种和基因编号试一个查询,看看它能接上哪些资源。专门工具的价值,就体现在这些细节里。
同一项工作,下次怎样接着做
第八个项目 ClawBio,我想从“重复做一项分析”这个角度讲。
它把生信任务组织成 Agent Skills。一个任务目录里可以放说明文件、执行脚本、演示数据和测试,让 AI 知道任务要什么输入、该怎么做。项目还强调保存重放命令和结果校验信息,方便以后再做同样的工作。 ClawBio 官网
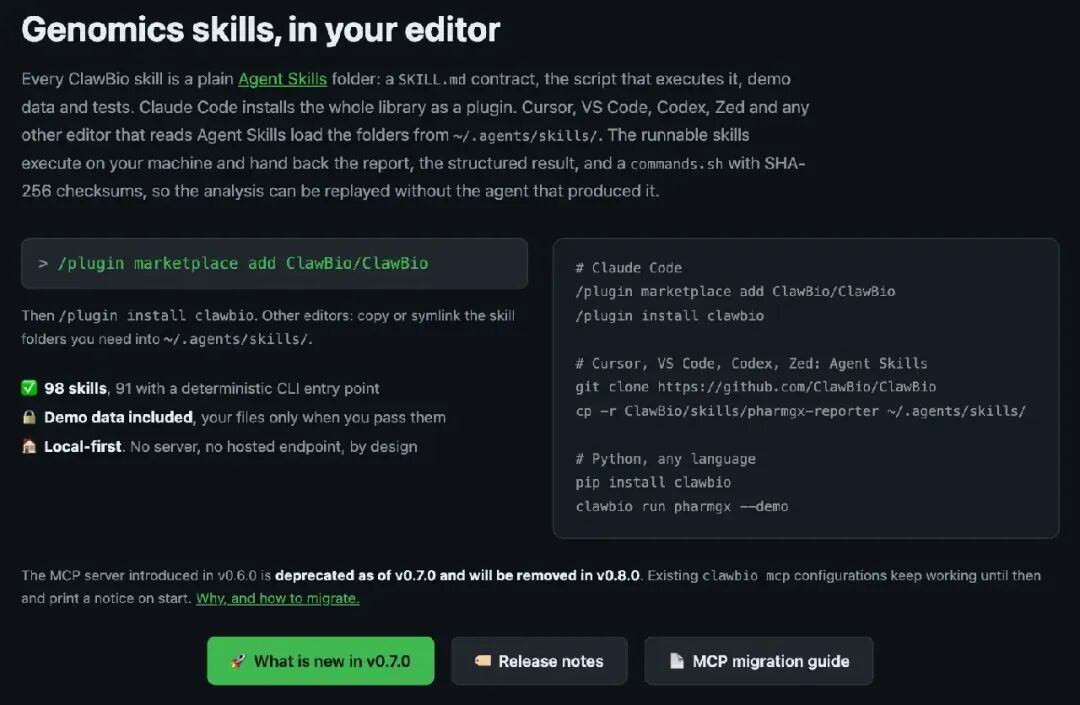
图 8|ClawBio 官网截图。现在的重点是拿 Skills 组织任务说明和执行程序。查看项目。
原名单里写的是 ClawBio MCP。这里有个更新,值得单独说清楚。官方已经宣布自己的 MCP 服务从 0.7.0 起弃用、计划在 0.8.0 移除,推荐直接用 Skills、命令行或 Python 接口。开发者的理由是,相关编辑器已经能直接读技能目录,继续维护一层额外调用会增加工作量。 迁移说明
现在可以顺便把前面反复出现的 MCP 讲清楚了。它是一套让 AI 应用连接外部工具和数据的通用约定。前文查数据库、访问分析平台的很多操作,就是通过这种连接完成的。
Skills 则负责交代一项任务的做法,再带上执行需要的脚本。两者可以配合。ClawBio 这次调整,针对的是自己怎么提供这套任务库。
我把它放到最后讲,是因为做完一次分析,迟早要面对“再做一次”。隔了一段时间,新样本来了,原来的输入格式是什么、命令用了哪些参数,都得找得回来。
我更愿意把一套做法整理成能再次执行的任务。 有输入说明,也有运行记录,下次讨论结果时就能接着往下走。ClawBio 提供了一个值得参考的组织方式。
七师兄的建议
如果现在让我挑一个起点,我会先选查基因信息或取序列。任务短、输出具体、容易对照已有知识检查。等你熟悉了 AI 调工具的过程,再把它接进更长的分析。
已经有明确研究方向的朋友,可以直接按这张表选。
项目选好以后,把第一次任务写具体一点。要查哪个对象、希望返回什么文件、结果存在哪里。查询类任务保留数据库记录和链接;跑分析时把输入、方法和参数一起留下。
我建议从最近就要做的一件事开始。比如差异基因表里有个名字你一直想查,就拿它试试。信息回来后,打开其中一条原始记录,看它是不是对应你的研究对象,再决定下一步。