ARTICLE · 1165761
AI开始教自己,Sakana两轮实验有进步,软件工程却没跟上
大家好,我是霜空。
让AI写完答案,再让它检查一遍,大家可能都试过。可如果做题、改流程、挑选好答案的,都是同一个模型,它能不能把这些经验学进去,真的变得更强?
Sakana AI与加州大学伯克利分校的研究者,最近公开了一项叫MASS的实验。它以Qwen3.6-27B为起点,让同一个模型组成团队,寻找更好的工作流程,再用团队留下的工作记录训练自己。完成两轮以后,四项公开研究评测的单位输出token得分,达到基础模型的1.2至1.6倍。
进步确实出现了,但两个软件工程评测没有跟着改善。这比一句“AI已经能够无限自我进化”更值得看,因为研究把哪些地方有效、哪些地方仍有问题一起摆了出来。
论文在10月8日提交,10月11日的相关讨论继续围绕“无需更强老师也能改进自己”展开。读完方法和实验结果,我觉得其中最有价值的变化,是把团队怎样配合也当成了可学习的东西。具体问题的答案和下一次怎样组织工作的经验,一起进入学习过程。
同一个模型,为什么还要分成一个团队
MASS的执行者、流程优化者和评判者,都使用同一个模型。它们没有变成三个能力不同的新模型,只是在不同的上下文里承担不同职责。执行者完成任务,留下代码、图表和研究报告;评判者比较两份成果;优化者根据反馈改下一版流程。
这样的分工有一个实际好处。长任务里,一个模型经常要同时处理材料、计算、检查和写作,前面发现的限制可能被后面漂亮的结果掩盖。拆成几段后,每个环节都能有明确输入,检查结果也能传给后面的人。
但复制几个相同的AI窗口,不会自动得到一个可靠团队。如果它们都只交一段总结,后面的模型仍然不知道数字怎么来的,也不知道前面有没有验证过。增加成员可能只是多花钱,错误还会在大家的复述中变得更像事实。
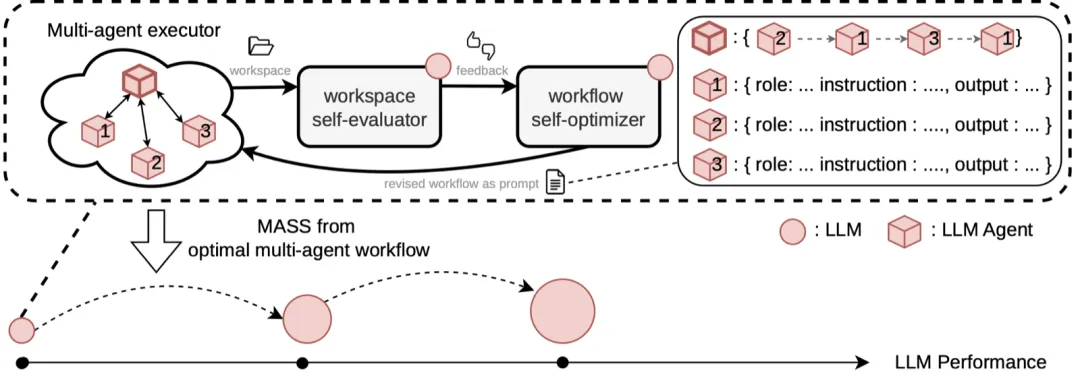
图1 上半部分寻找更好的团队流程,下半部分把选出的执行记录用于训练共享模型。
研究把流程拆成四个部分,分别说明谁负责什么、具体做什么、必须交回什么,以及成员按什么顺序调用。这几个问题看着朴素,却决定了一个复杂任务怎样从材料走到结果。
例如,数据处理环节如果只交一张清洗后的表,建模环节可能不知道哪些记录被排除了。若它还要交异常清单、处理规则和检查报告,后面的结论就多了可以追查的依据。团队的价值,需要通过这些交接发生。
改流程和训练模型,是两件不同的事
MASS有内外两层循环。内层不改变模型权重,只让当前团队尝试新的工作流程。它执行候选方案,把结果与此前选出的最好成果比较,再根据评价提出下一版。某一版胜出后,就成为后续比较的参照。
这一步有点像在同样的工具和人员条件下重新安排工作。先画图还是先检查数据,复核之后要不要返回重算,都会影响结果。内层找到的是更有效的做法,还不能据此说模型本身已经学会了。下次若不提供那套流程,它可能仍按原来的习惯工作。
外层才进入训练。研究者让每个任务的优胜流程用不同随机种子运行18次,由当前模型比较成果并排序,最多保留16条执行轨迹,其中15条用于训练、1条用于验证。轨迹里包含协调者和子任务执行者的消息、工具调用与工具返回。
构建协调者的训练样本时,研究者还做了一个关键处理,拿掉初始提示里的工作流程文本。模型不能仅靠看到一份现成分工表来照做,而要从任务本身学会怎样安排后续工作。
随后用LoRA微调共享模型,更新后的模型继续担任执行、优化和评价三种角色,再开始下一轮。有效的协作记录因此进入模型权重,而不只是留在聊天历史里。这才是本次“教自己”与普通的“请再检查一遍”之间的区别。
这条路线也有前作。作者Hyunin Lee此前介绍的RHI,保持底座模型不变,通过反复修改团队流程改善执行。那时还没有用轨迹训练下一代模型。MASS把这一步接了上去,区别就在于经验开始进入模型权重。
这种学习仍有明确的人为设计。任务集合、环境、训练方法和选择规则都由研究者安排,模型也不能自己决定任意调用工具、改变目标或无限增加算力。因此,实验中的自监督,不意味着一套没人管理的系统已经能够自行成长。
最有用的分工,藏在交付要求里
论文中有一个金融研究任务,流程依次为准备数据、构造特征、建模、回测,然后审计、协调修正、写报告。数据环节还要交代有没有使用未来信息,以及训练、验证、测试几个区间的时间顺序是否正确。
回测里,如果历史上的决策用了当时还不知道的数据,收益曲线可能非常漂亮,却没有现实意义。这样的错误不能靠“请你扮演严谨的分析师”消除。数据环节要提供明确检查,后面才能判断自己的结论建立在什么条件下。
给一个角色取专业的名字,远不如写清楚它必须证明什么。负责数据的人要交可验证的时间切分,负责图表的人要沿用已经确认的口径,发现错误以后还要能返回前面的环节修改,而不是一路把报告写完。
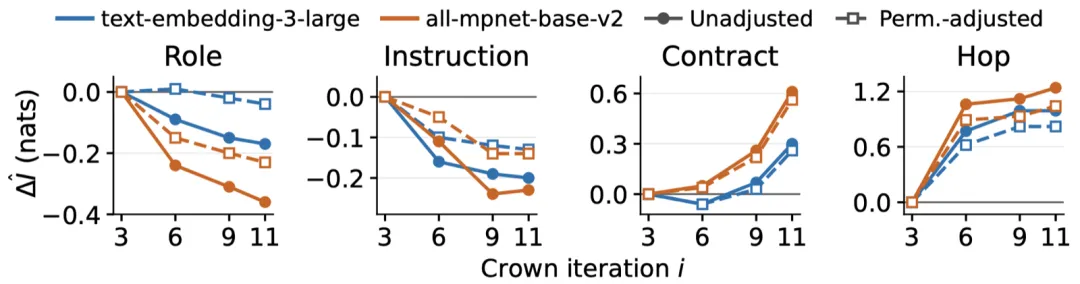
图2 流程优化过程中,与任务有关的信息更多体现在交付要求和调用顺序中;四幅小图的纵轴尺度不同。
研究者也分析了流程文字中的任务信息。迭代之后,角色名称与一般指令中的相关信息减少,交付要求和调用顺序中的相关信息增加。影响结果的细节,逐渐写进了交接规则。不过,优化提示本就要求重点调整这两个部分,这张图并不是它们导致性能提升的因果证明。
不过,这项分析只覆盖少量任务,测的是流程文本中的统计关系,不能推出“角色设定从此没用了”。我更愿意从中试一个方法,保留必要的角色分工,把主要精力用在明确输入、输出和返工条件上。
拿普通的月度报告作例子,数据环节可以先交汇总表与异常清单,图表环节只能使用这份表。结论环节遇到口径冲突就停下来询问。这个做法是由研究得到的应用启发,并不等于论文已经验证了我们自己的报告任务。
1.6倍到底变强在哪里
实验中的合成研究任务共12个,覆盖金融、机器人和药学,任务说明事先由GPT-5.5生成。9个被指定为训练任务,3个留作测试;最终8个训练任务提供了数据,另一个没有找到优于参照结果的流程。
在那3个合成测试任务上,外部评判者比较最终成果。第一轮模型相对基础模型的胜率为53.9%,第二轮为69.9%;第二轮对第一轮的胜率是60.8%。这些数值表达的是成对比较里的偏好,69.9%不是所有研究问题都能答对的准确率。
测试任务没有进入微调、验证和检查点选择,但研究也在它们上面评估过工作流程搜索。这与一整套完全没接触过的新题仍有区别,不能把“留出测试任务”扩大解释为所有环节都毫无接触。
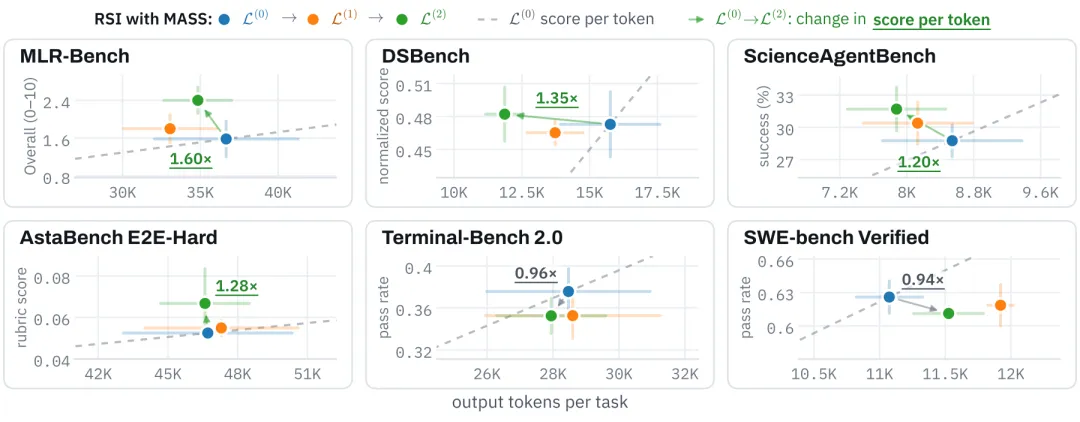
图3 横轴为每项任务的输出token,纵轴为对应评测得分。绿色是两轮后的模型,标注比较的是得分与输出量的比值。
公开研究评测给了更直接的迁移结果。MLR-Bench的单位输出token得分达到基础模型的1.60倍,DSBench为1.35倍,ScienceAgentBench为1.20倍,AstaBench E2E-Hard为1.28倍。它们覆盖的研究型工作,与训练任务有一定相似性。
“单位输出token”需要单独看。它把得分与生成量联系起来,衡量输出效率,并不是说所有任务的原始得分提高60%,更不是说模型智力增加60%。训练、寻找流程、筛选样本也要消耗资源,这些没有都算进这个指标。仅凭1.6倍,不能算出用户最终节省多少费用。
代码测试给出了相反方向的结果。Terminal-Bench 2.0的这一比值为0.96倍,SWE-bench Verified为0.94倍,都略低于基础模型。看图里的原始得分,两轮后的结果也没有赶上基础模型。研究任务上的学习,没有自动变成更强的软件工程能力。
作者认为,加入软件工程训练任务可能改善这种迁移,但这还属于后续方向。当前的实验证据支持“特定研究型任务有所改善”,不能支持“同一个模型已经在所有领域越练越强”。
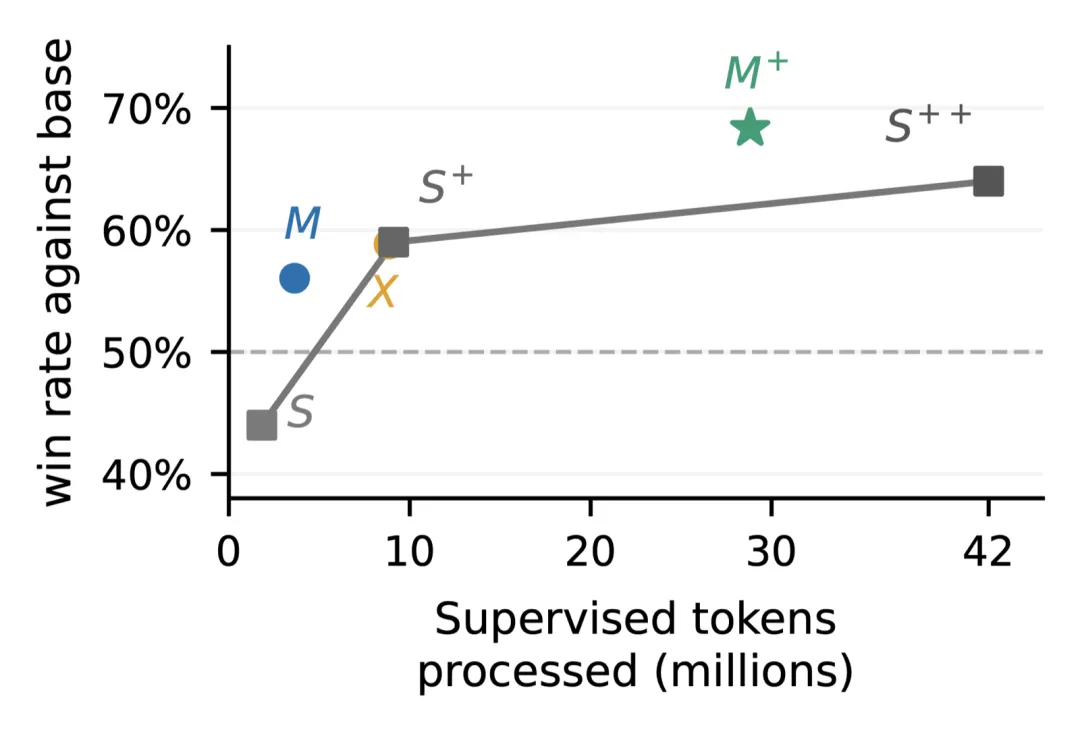
图4 横轴是训练时处理过的监督token,纵轴是相对基础模型的胜率;这张图不包含数据生成、搜索和评价的全部消耗。
另一组比较也颇有意思。采用更多多智能体记录的模型,处理约2880万个监督token后达到68.3%的胜率;使用更多单智能体记录的对照,处理4200万个后为64.0%。这组胜率汇总了四个训练任务和一个测试任务,不是单独的留出测试成绩。在这组试验中,团队记录提供了更有效的训练信号。
不过,主模型训练覆盖八个任务,单智能体对照覆盖四个,采样和检查点选择也有差别。记录的质量、任务组织和验证要求都可能影响结果,不能把差异全归给“人多”。协调者怎样拆任务与执行者怎样完成小任务,都可能成为有价值的训练内容。
自己评自己,最怕大家错在同一个地方
主实验的同质MASS循环里,负责选择训练数据的是当前模型。最终报告的外部评价还用了GPT-5.5和Claude Opus 4.8,这些判断没有反馈进主循环。“循环内部不靠更强老师”,不等于研究者没有做独立检验。否则我们只能知道模型更喜欢自己的新答案,无法判断别人是否也认为它更好。前面那组训练效率对照另有设置,部分对照会用外部判断选择检查点,不能混为同一套流程。
另设的消融实验还尝试只换一个更强的评判者,或者同时换更强的评判者与优化者。只提高评价能力,帮助较有限;两者一起提高,寻找有效流程的速度明显加快。会指出问题与会根据问题改出更好的方案,是两种不同能力。
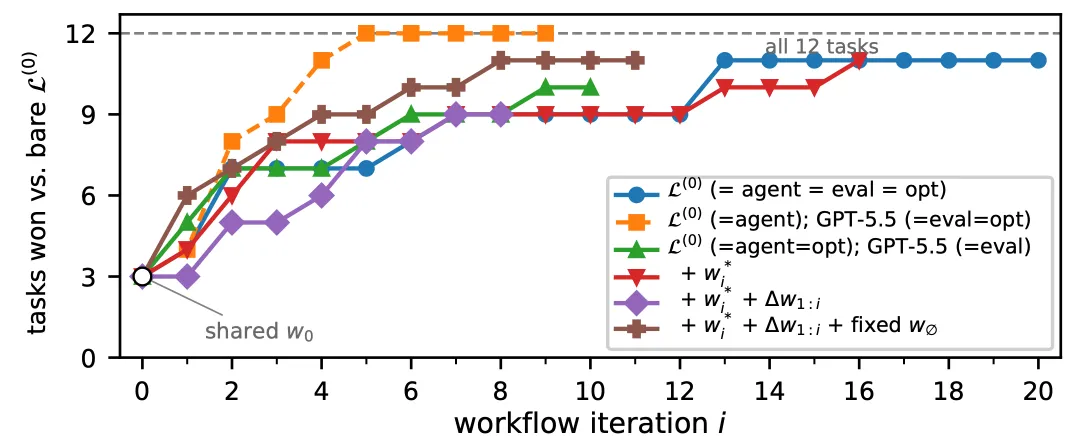
图5 执行者始终为基础模型。橙色虚线同时升级评价者与优化者,绿色只升级评价者,蓝色使用同一模型承担三种角色。
我们平时给AI的反馈也常遇到类似困难。指出报告数据不可靠以后,它可能补一段更谨慎的说明,却没回头核对数据。此时需要调整处理顺序和检查方法,不能只把批评说得更严厉。
找到过更好的流程,并不保证下一次继续变好。论文展示的单轮胜率有明显波动,一个表现不错的版本后面,仍可能出现退步。留住已经验证过的版本很重要,不能默认最新一版总是最好。
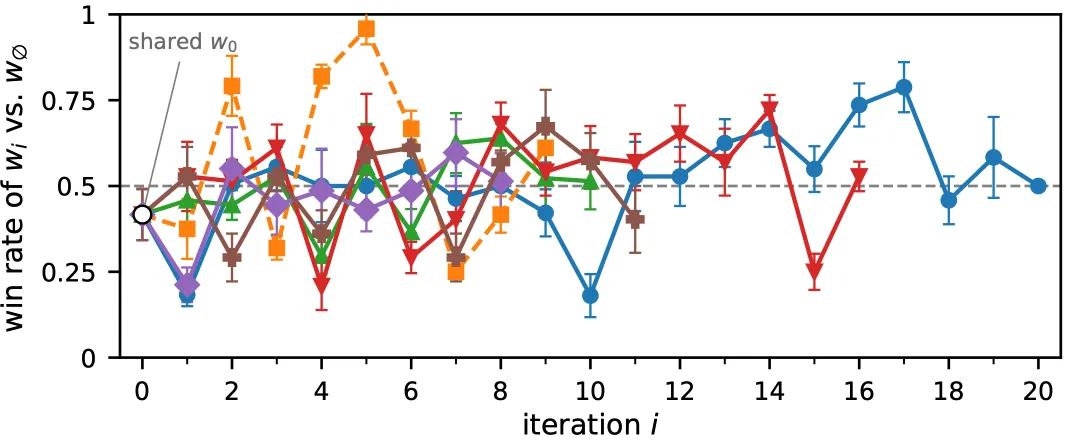
图6 横轴为搜索迭代次数,纵轴为候选流程相对无流程基础模型的胜率;各条曲线都有明显起伏。
同一个模型承担所有角色,还可能共享同一处盲点。如果执行者犯错,评判者却觉得很好,优化者又把它当成经验,错误就可能进入下一轮训练。文本越来越自信、成员意见越来越一致,都不能单独证明结果正确。
对能计算、能运行测试、能查原始记录的任务,独立检查仍应保留。对很难当场验证的研究成果,要说明依据和不确定性,给外部审阅留下机会。权限与对外动作也需要单独约束,不能因为模型在内部给自己评了高分,就把操作范围一起放大。
MASS让我更期待的是,一次有效的团队协作留下的经验,能够成为模型下一轮学习的材料。两轮实验已经给出一些支持,但软件工程评测没有同步进步,也提醒我们别把一个方向的成功提前写成普遍结论。接下来值得继续看的,是它换任务、换环境以后能否稳定保留这些进步,以及共同的错误能不能被及时发现。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING
本文使用摸鱼小李的公众号排版 Skill,感谢摸鱼小李。