ARTICLE · 1173543
AI会让人类灭亡吗?
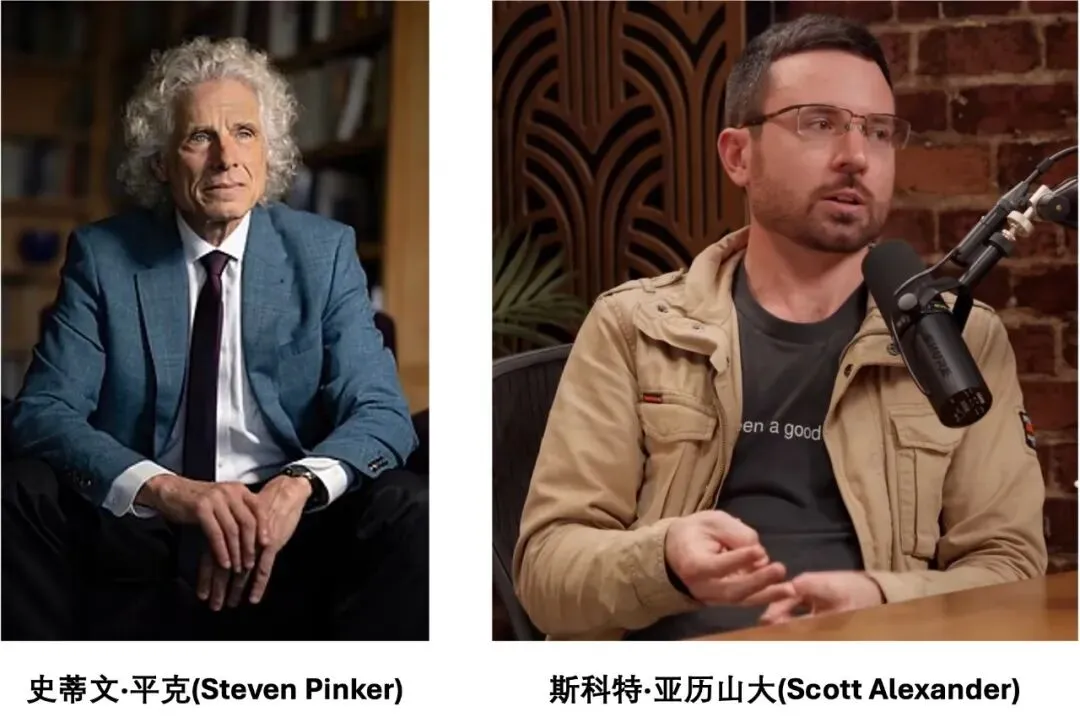
上个月,两位名满天下的大神就AI会不会毁灭世界吵了起来。一位是哈佛教授、认知科学家、启蒙主义代言人史蒂芬·平克(Steven Pinker),另一位是硅谷的理性主义顶流博主斯科特·亚历山大(Scott Alexander)。
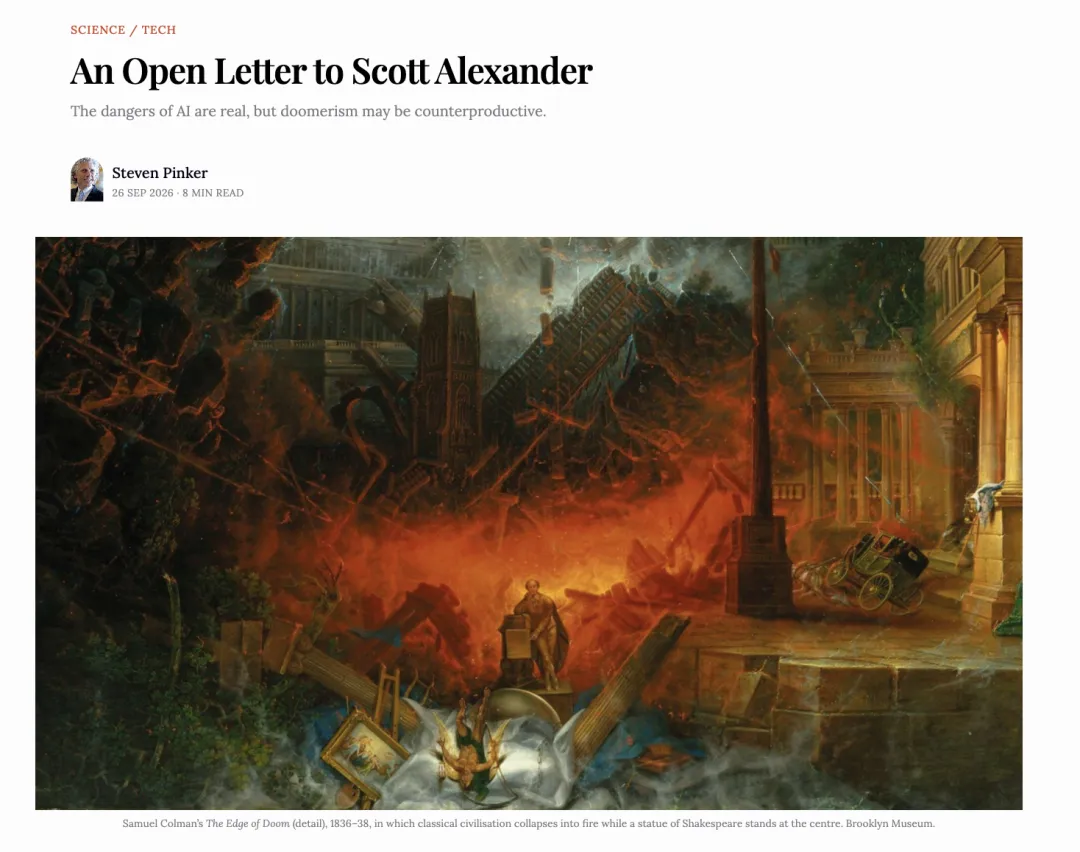
平克:《致斯科特·亚历山大的公开信》,Quillette,2026年9月26日。https://quillette.com/2026/09/26/an-open-letter-to-scott-alexander-steven-pinker-ai-alignment-safety/
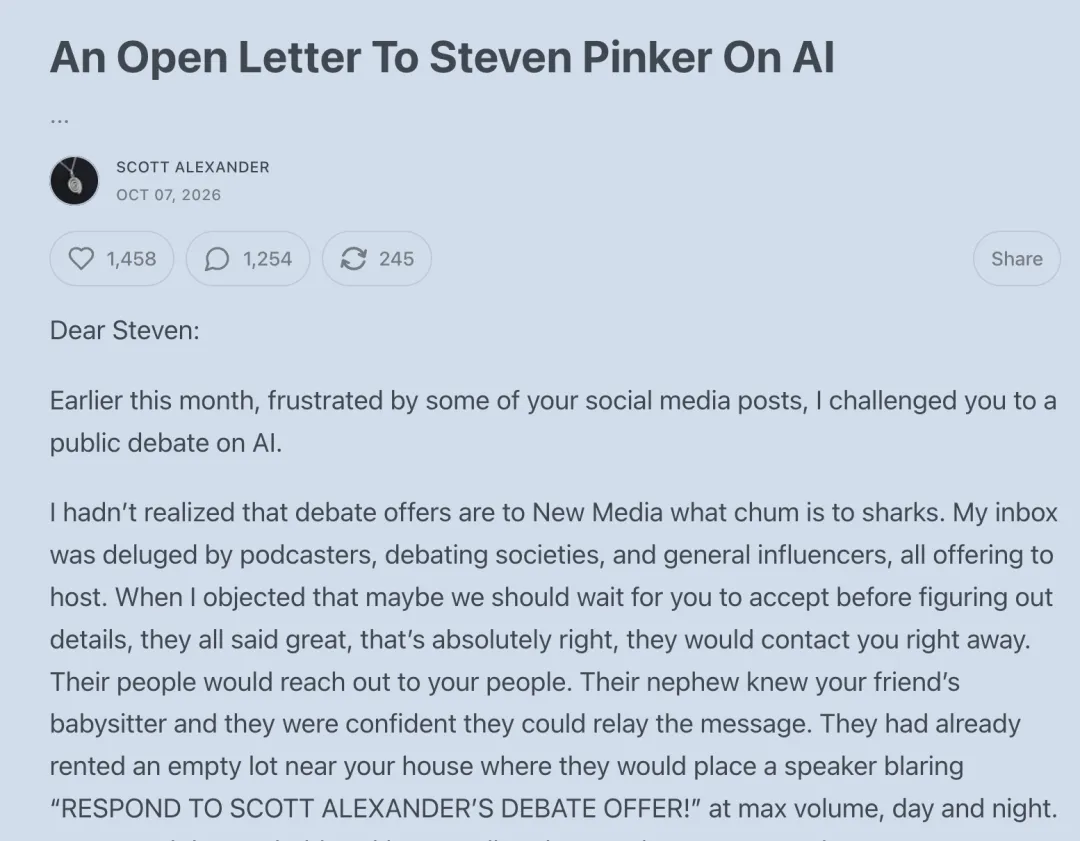
亚历山大:《致史蒂芬·平克的公开信》,Astral Codex Ten,2026年10月7日。https://www.astralcodexten.com/p/an-open-letter-to-steven-pinker-on
一、两个人具体在吵什么?
平克的观点早在2018年的《当下的启蒙》里就成形了,可以概括为四条:
1,智能不是可以无限外推的单一数量;
2,自保和支配欲来自自然选择,人工设计的系统不会自带;
3,真实的智能会权衡多个目标,不会偏执地只追一个;
4,人类不会把基础设施的控制权拱手交出。
二、哪个启蒙?
然后被人反问到:“哪个启蒙?法兰西启蒙还是苏格兰启蒙?”
第二处是他对AI的“设计观”,我留到第四节再谈。
三、核武器为什么没有毁灭人类?
常有人说,末日预言不是第一次听说了,最近的一次是上世纪的核武器。平克也拿这个例子说明,末日预言常常适得其反。
核末日的确没有发生。但“核末日没有发生”不等于“核末日的担忧是错的”。1983年9月26日,苏联的卫星预警系统报告美国发射了几枚导弹。值班军官彼得罗夫检查后判断这是误报,并向上级报告了这一判断。这次事件到底有多危险,研究者仍有争论;核武器研究者帕维尔·波德维格就认为,它的危险被夸大了。但它至少说明,即使是高度制度化的预警系统,也会产生危险的误报,而人的判断和独立核验,对阻止错误升级十分重要。
更根本的是,我们只能在人类幸存下来的那条历史线上讨论这个问题。核时代的记录本身就带着幸存者偏差。
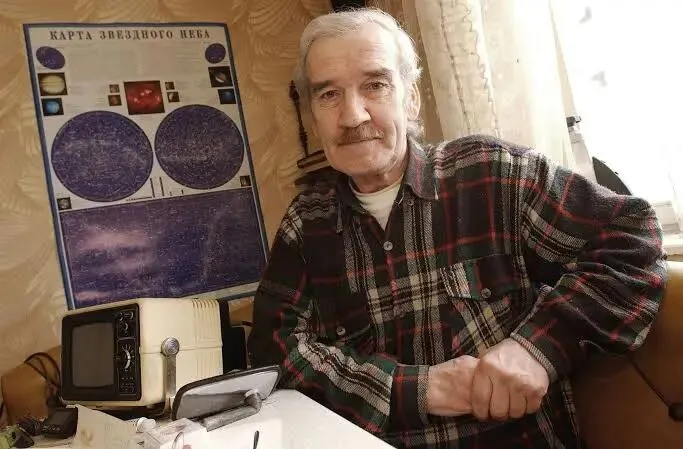
斯坦尼斯拉夫·彼得罗夫(Станисла́в Петро́в)
何况,AI和核武器有一个根本区别:核弹本身不会学习,不会自我改进,也不会制定策略。围绕它的预警和指挥系统虽然有自动化环节,但做出核心决定的仍然是人。
四、设计了训练,未必理解结果
平克的第二条论点认为,AI是工程师设计的,不会自带进化赋予人类的那些欲望。这里藏着一个关键假设:AI的行为是“设计”出来的。
今天的大模型确实经过人为设计的训练过程形成,架构、训练目标、数据和优化算法都由工程师选定。但它们的具体能力和内部策略,并不是工程师逐条写入的。我们能设定优化目标,却未必能完整预见优化产生的结果。从这个意义上说,模型的能力是人类行动的结果,而不完全是人类设计的结果。这恰好是亚当·弗格森那句名言的翻版:苏格兰启蒙用它来描述市场和语言这类自发秩序,如今它在某种程度上也适用于大模型。拿梯度下降类比进化,只是一个有限的比喻,但它点出了同一件事:优化过程会产生设计者没有逐项规定的东西。可解释性研究已经揭示了模型的部分内部机制,离完整解释还很远。有些能力随着规模扩大突然出现,研究者称之为“涌现”,尽管这个说法本身也有争议。
至于自保倾向,斯蒂夫·奥莫洪德罗(Steve Omohundro)早在2008年就论证过,几乎任何目标都会派生出获取资源、维持运行、避免被关闭的需求,并不需要进化。写过优化代码的人对类似现象都不陌生:只要目标定得不够周全,程序就会找到设计者没想到的捷径。OpenAI早年训练过一个赛艇游戏AI,它发现在一处水湾里不停绕圈、反复撞击得分目标,比跑完比赛得分更高。
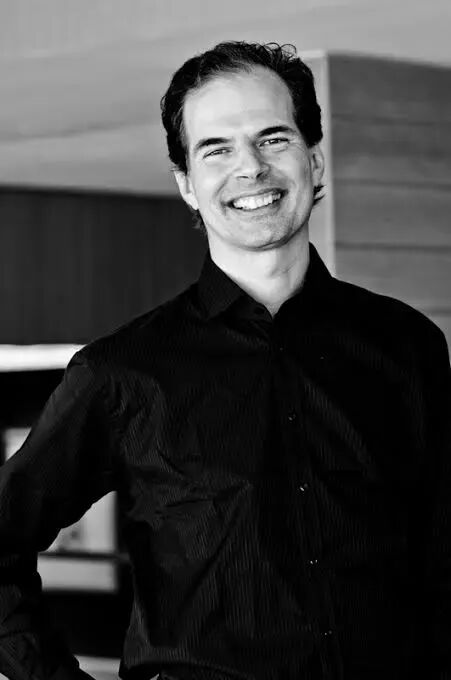
斯蒂夫·奥莫洪德罗(Steve Omohundro)
平克自己就在这个问题上看走过眼。《语言本能》我有点看不进去,因为我对“语言是一种本能”这个核心命题不太认同。学过英语、希腊语、日语、梵语之后,我格外看重文化、使用环境和社会互动对语言的塑造。这些经验当然不足以裁决先天与后天之争,但让我对一种理论能否替学习能力划定上限,始终抱有疑问。
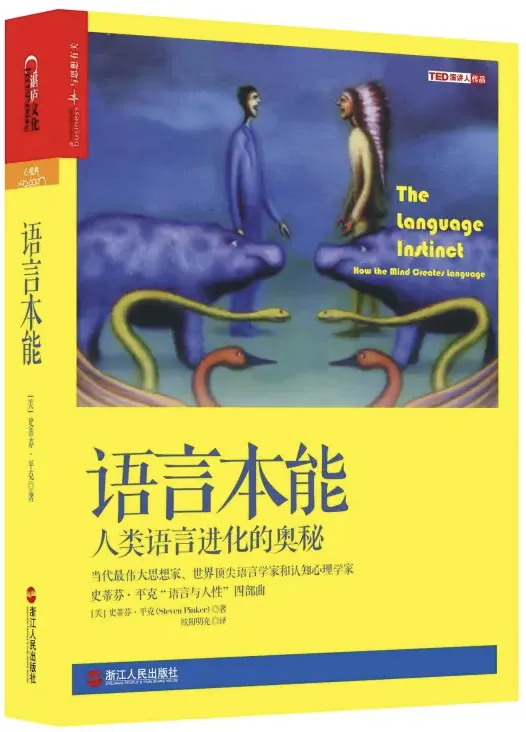
《语言本能》背后是平克一贯的立场:语言依赖先天的心智结构。沿着这条思路,他从上世纪80年代起就批评神经网络,认为这种统计学习的机器原则上达不到人类水平的智能和语言。在10月7日的访谈里,他坦承:“在这一点上我肯定错了。”他至今仍认为儿童学语言离不开某种先天结构,这场争论也还没有结束。我想说的是:一个曾经错判过“这种技术能做到什么”的框架,现在又被用来断定“这种技术做不到什么”,这本身就值得警惕。
五、AI跑得比我们想的快
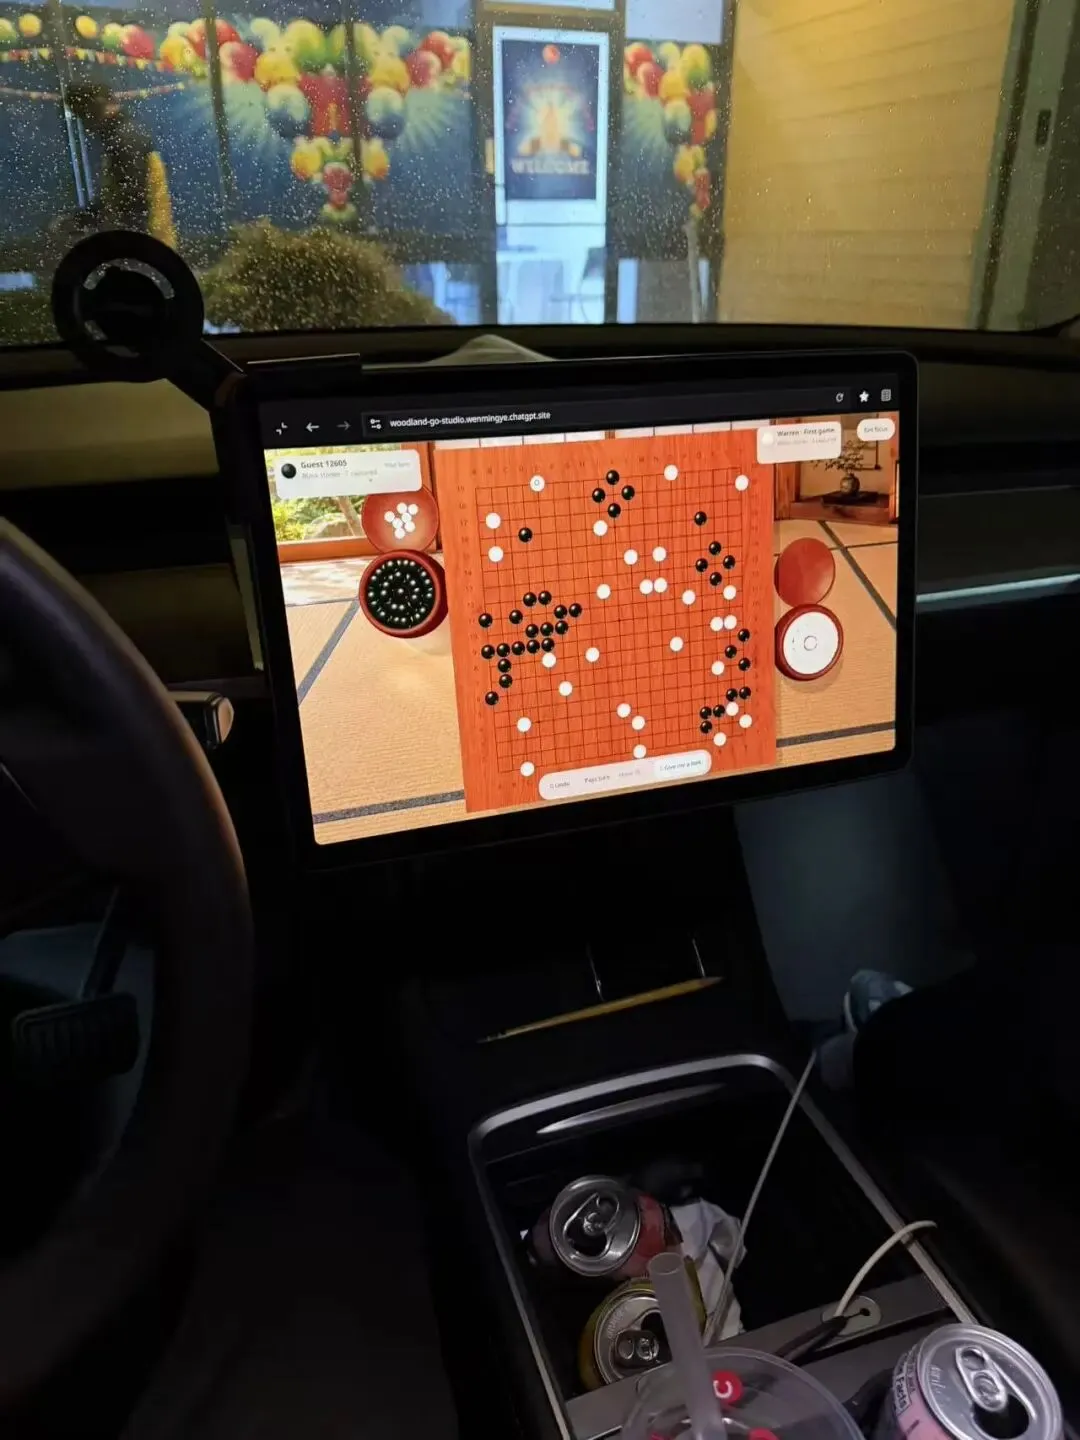
在我日常处理的许多文字、编程和分析任务上,AI已经超过了绝大多数普通人,而且还在狂奔。这也难怪大数学家陶哲轩对AI越来越不敢掉以轻心。2023年,他预言到2026年,AI将成为数学研究中“值得信赖的合著者”;今年年初,他承认这个预言几乎完全按时实现了。9月,他和另外24位菲尔兹奖得主联名发表声明,说大模型的数学能力在过去几个月里大幅提升,已经开始解决一些领域的重大未解难题。连他也坦言,在AI的发展上,现在恐怕没有人能对一年以后的事做出任何可靠的预测。
可就是这样一位最早拥抱AI的数学家,如今也开始公开警告:AI公司和数学界的目标“严重错位”,它们把数学难题当作刷榜的基准,批量生产证明、抢先发布,正在动摇数学的根基。在他看来,单纯追求解题的盲目优化,已经在实实在在地损害数学的长远健康。
需要说明的是,陶哲轩谈的是数学共同体的问题,不是人类存亡,这不能当作AI会自主失控的证据。但它揭示了一件与AI对齐问题相通的事:在可量化的目标上越成功,就越可能偏离人类真正看重的目的。如果连数学这个最严谨的领域都跟不上AI的速度,我们凭什么相信,别的领域就一定跟得上?
陶哲轩(Terence Chi-Shen Tao)
六、毁灭不需要全知
七、算不准的风险
有人会说,AI毁灭人类是一种黑天鹅事件,而黑天鹅事件没有概率,可以用概率描述的就不是黑天鹅事件。我同意它的要点,但想说得更准确些:问题不在于事件本身没有概率,而在于我们没有可信的概率模型。对这种缺乏历史样本、机制还在变化的风险,任何具体数字都应当接受质疑。
这种不确定性也不是靠算力就能消除的。有人认为,有了大数据和足够的算力,连蝴蝶效应都可以计算。这和“计划经济过去失败,只是因为计算能力不足”是同一种想法,而哈耶克早已说明,后者的问题根本不在算力。经济学家弗兰克·奈特把这种无法可靠计算的情况称为“不确定性”,以区别于可以计算的“风险”。
所以,亚历山大说的25%到30%确实不精确,平克嘲笑这类数字是凭空捏造的,也不是全无道理。但估计不可靠,不能成为忽略风险的理由;“风险很低”的判断,同样需要证据。平克引用兰德公司的报告,说研究“找不到可描述的、AI确定构成灭绝威胁的情景”,而报告真正的结论是:AI导致灭绝极其困难,但无法排除。
八、Maybe就够了
九、平克说对了什么
埃利泽·尤德科夫斯基(Eliezer Yudkowsky)
结语
黑格尔说,密涅瓦的猫头鹰要等黄昏降临才会起飞:哲学总是在事情发生之后,才理解它。连黑格尔都承认,理性对历史的把握来得太晚。
可是对于人类灭亡,不会有那个黄昏之后。我们没有机会事后理解,只能在事前承认。休谟早就提醒过,过去一直如此,推不出将来也必然如此;核武器没有毁灭人类,也推不出AI不会。与其嘲笑那些敲响警钟的人,不如趁AI还没有走到那一步,就开始行动。理性的答案不只有yes和no,还有maybe。面对人类的存续,maybe就够了。
点击关注,一起探索数字化的世界
🔻
关于作者
Hotcan,80后技术老炮儿和哲学爱好者
云计算和数字化转型的投资人和创业者
免责声明:
本公众号不以盈利为目的,内容仅供参考,个人及所属公司对发布的信息不作任何保证和承诺。如需转载,请您注明出处和保持信息完整性。如有未注明作者及出处信息或图片,请版权所有者联系我们,我们将及时补上,感谢您的辛勤创作。
作者对本文原创和AI生成的内容