ARTICLE · 1173539
AI 分析短视频,到底是在分析什么?
我们经常听到一种说法:AI 已经能够理解视频了。
但问题是,AI 能描述视频里发生了什么,就代表它真正看懂了这条视频吗?
比如,一条视频里,一个男人在小院里休息,周围有树林、溪流和木屋,画面穿插着几句关于安静、生活和情绪的文字。
AI 可以很轻松地告诉你:这是一个展现自然生活、传递宁静情绪的视频。
但这只是描述。
如果我们进一步追问:
为什么视频开头要说“小院只有两间房”? 为什么不直接告诉观众答案? 画面和文字之间有什么关系? 这条视频是怎样一步步推动观众情绪的? 如果想借鉴它的创作方式,究竟有什么可以复用?
这时,我们才真正开始研究一个问题:
AI 分析短视频,到底是在分析什么?
为了弄清楚这一点,我把同一条短视频分别交给了 ChatGPT、Gemini 和 Grok,让它们在相同条件下进行分析。
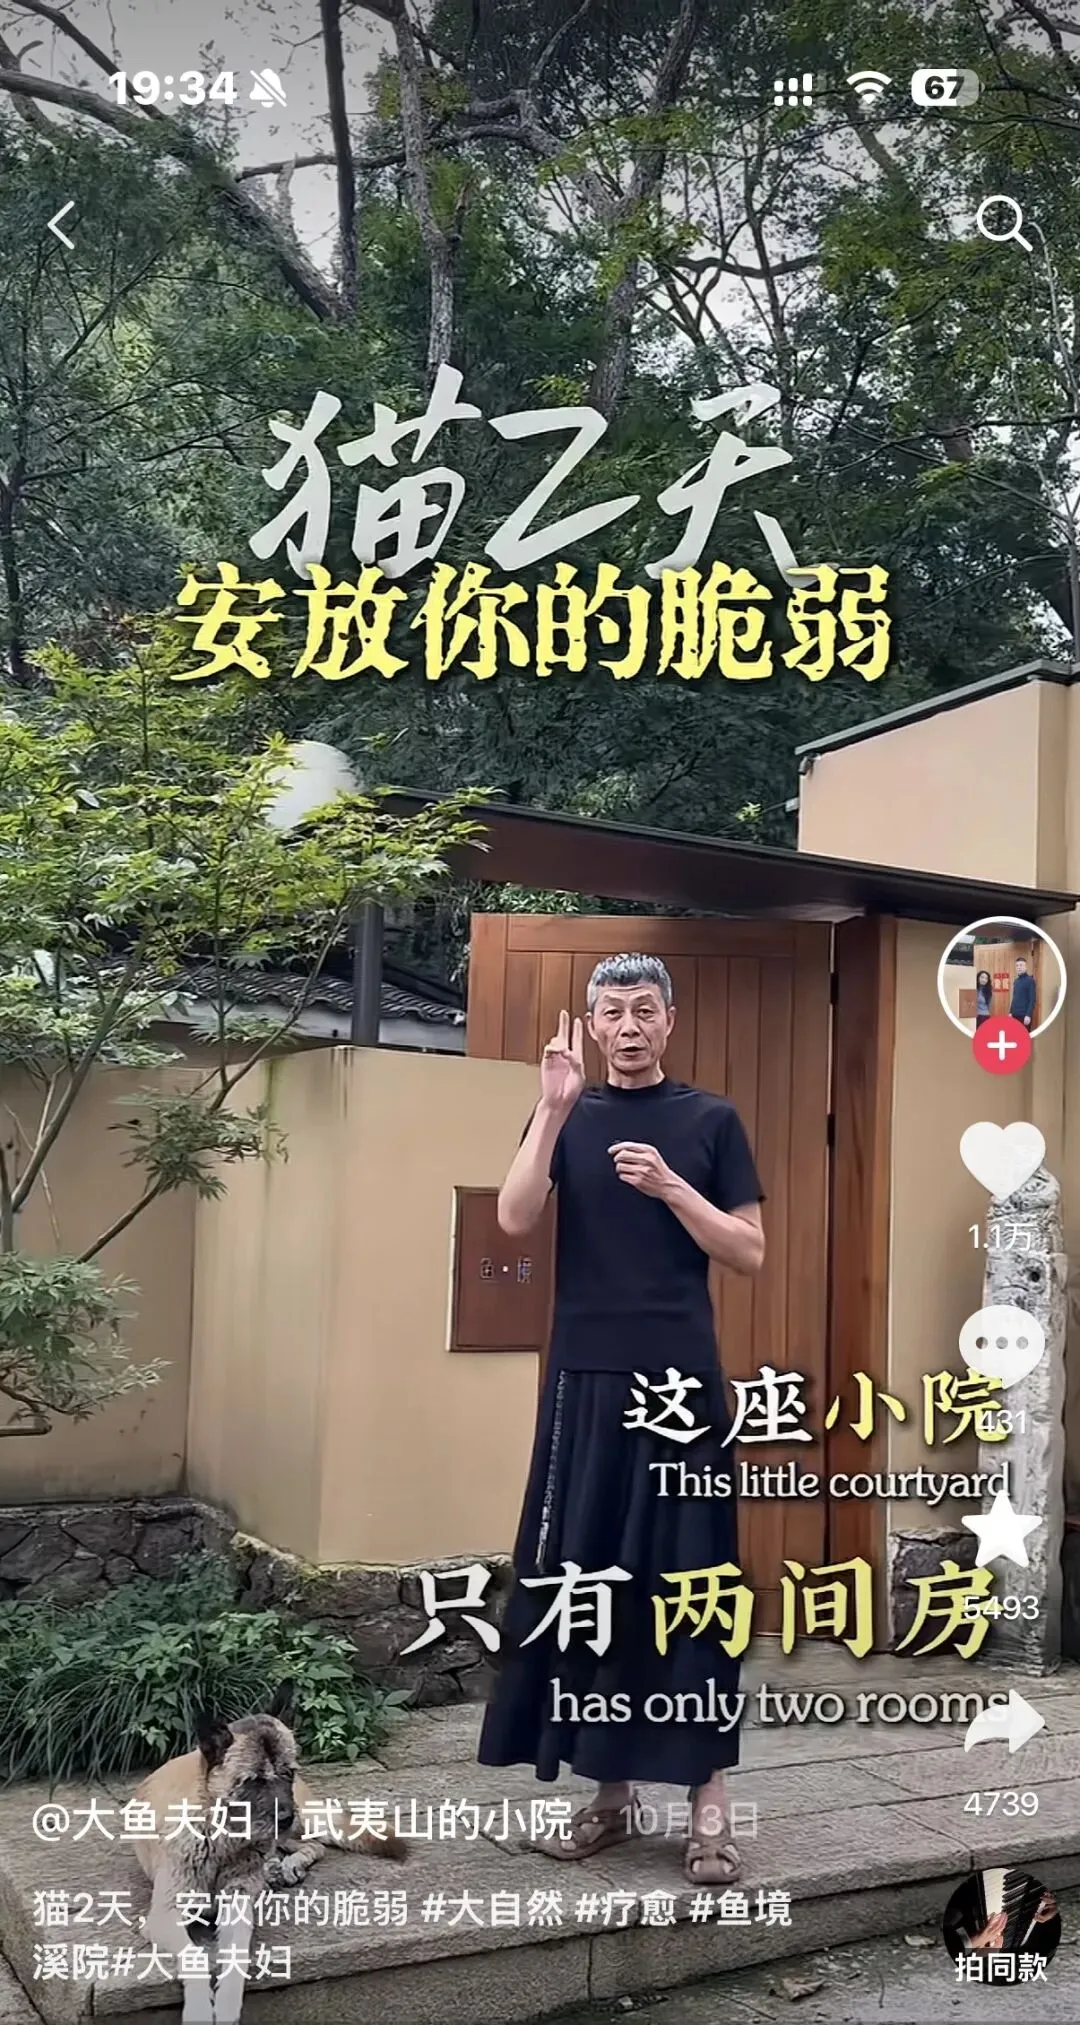
这次实验,我不打算简单评选谁最强,而是想看看:当我们要求 AI 深入分析一条视频时,它们究竟能分析到什么程度。
一、先确定实验规则:不让 AI 提前知道答案
如果想测试 AI 是否真正理解一条视频,就需要尽量减少外部信息的干扰。
因此,这次实验设置了几条规则:
三个 AI 分析的是同一条视频。 使用相同的分析要求。 不提供视频标题、创作者背景等额外信息。 不允许搜索互联网或参考其他资料。 不假设创作者的真实意图。 视频中没有明确出现的信息,不得直接当作事实。
最后一条尤其重要。
分析视频时,我们很容易把自己的理解当成创作者的真实想法。
例如,看到一个人在小院里休息,我们可以分析画面营造了怎样的情绪,却不能直接断定这个人是谁、为什么来到这里,或者这个场景背后有什么故事。
分析视频,不仅要看 AI 能推断出什么,还要看它能否区分事实、推测和未知信息。
规则确定后,三个 AI 开始分析。
二、第一层:AI 能否准确说清楚,视频里发生了什么?
这是最基础的一层:内容理解。
视频里出现了什么人物、场景、动作和文字?这些元素如何组成一条完整的视频?
三个 AI 都能够识别出这条视频的基本内容。
画面围绕一处小院展开,出现了木屋、树林、雨水、溪流等自然环境,也记录了人物在院子里休息、活动的状态。
与此同时,视频通过文字表达关于安静、脆弱以及城市生活的感受。
如果分析到这里,AI 已经完成了基本的内容概括。
但这还不足以解释视频为什么这样拍、为什么这样剪,以及为什么可能吸引观众继续观看。
因为,知道视频里有什么,与理解这些内容是如何组织起来的,是两回事。
我们需要继续追问。
三、第二层:AI 能否发现视频中的信息差?
这次实验中,一个值得注意的发现是:三个 AI 都抓住了视频开头的一个关键设计。
视频先提出一个事实:
“这座小院,只有两间房。”
接着又补充:
“不是因为小。”
这两句话放在一起,会产生什么效果?
如果视频直接告诉观众,这是一处安静、舒适的小院,观众大概能够立即理解它想表达什么。
但“只有两间房”是一个具体事实,“不是因为小”又否定了一种直观解释。
观众自然会产生疑问:
既然不是因为小,那为什么只有两间房?
视频没有立即回答,而是把答案留到了后面。
随后,视频给出的解释是:
“为了守护安静。”
这时,前面看似只是介绍房间数量的信息,获得了新的意义。
它不再只是描述一个空间有多大,而是被赋予了关于生活方式和情绪价值的解释。
ChatGPT、Gemini 和 Grok 都注意到了这段内容的作用:先提出一个容易引发疑问的事实,再延迟解释,最后给出答案。
三个模型的具体表述并不完全相同,但都识别出了相近的信息组织方式。
这说明,AI 的分析可以超越对画面的简单复述,进一步识别内容是如何引发观众疑问的。
当然,这并不能证明每一位观众都会产生同样的疑问,也不能证明这就是创作者唯一的创作意图。
更准确地说,这是对视频表达机制的一种合理分析。
而这,正是我们想从 AI 视频分析中得到的东西。
四、第三层:AI 能否看懂文字和画面之间的关系?
一条短视频通常由多个元素共同构成:
画面; 文字; 人物动作; 环境声音或背景音乐; 剪辑顺序; 情绪变化。
如果只分析其中一个元素,就很容易遗漏视频真正的表达方式。
以这条视频为例。
文字表达的是安静、脆弱,以及对生活状态的感受。
画面则不断呈现自然环境:雨水、溪流、树林、木屋,以及人物在其中休息和活动的状态。
文字负责提出感受,画面则提供与这种感受相对应的视觉体验。
可以把这种关系概括为一句话:
文字负责定义感受,画面负责提供感官证据。
如果视频只用文字告诉观众“这里很安静”,它是在直接表达一个观点。
但当文字与自然环境的画面结合时,观众不仅能读到“安静”这个词,还能通过视觉内容形成自己的感受。
当然,我们不能仅凭这些画面就断定现实环境一定安静,也不能确认每一位观众都会产生相同的情绪。
我们能分析的是:视频如何通过文字与画面的配合,尝试传递某种感受。
ChatGPT、Gemini 和 Grok 都注意到了视频中自然环境与情绪表达之间的联系,只是分析的展开方式有所不同。
这也是视频分析与单纯文字分析的重要区别。
文字告诉我们说了什么。
视频还需要我们理解:为什么在这里出现这样的画面,以及画面和文字共同产生了怎样的表达效果。
五、第四层:AI 能否拆解整条视频的内容结构?
如果说前面分析的是局部,那么这一层分析的就是整条视频如何推进。
把这条视频的表达过程整理出来,可以得到一条相对清晰的路径:
第一步:提出事实。
小院只有两间房。
第二步:制造疑问。
不是因为小。
第三步:给出解释。
为了守护安静。
第四步:通过画面强化感受。
树林、雨水、溪流、木屋,以及人物在其中休息和活动的状态,共同构成自然、安静的视觉环境。
第五步:把环境感受转向人的情绪。
视频不再只是介绍一处小院,而是开始表达人在生活中可能需要的情绪空间。
第六步:用对照完成表达。
视频最后用一句话收束:
“城市安放你的野心,这里安放你的脆弱。”
这句话将城市与小院放在两个不同的情绪位置上。
城市对应野心,小院对应脆弱。
前者更接近奋斗、目标与外部生活,后者则指向休息、放松和情绪上的容纳。
整条视频由此形成了一条表达路径:
事实 → 疑问 → 解释 → 视觉体验 → 情绪共鸣 → 价值表达。
ChatGPT、Gemini 和 Grok 都识别出了视频中从开头设问到最后情绪收束的结构。它们对具体环节的命名和解释有所差异,但整体判断比较接近。
这里需要区分两件事。
我们能够从视频中识别出内容的组织结构,但不能因此断言创作者一定按照这个顺序进行策划。
前者是对作品的分析,后者是对创作过程的推测。
在没有更多证据的情况下,我们应该停留在前者。
六、第五层:AI 能否进一步解释,为什么这条视频可能吸引观众?
这也是最值得研究的一层。
内容分析可以告诉我们视频讲了什么,结构分析可以告诉我们内容如何推进。
但如果我们想借鉴一条视频的创作方式,还需要进一步理解:
哪些表达设计,可能影响观众的观看行为?
结合这条视频,可以提出几个值得验证的判断。
1. 开头没有一次性说完所有信息
“这座小院,只有两间房,不是因为小。”
这段表达没有直接给出完整解释,而是留下了一个需要继续了解的问题。
对于部分观众来说,这种信息上的缺口可能促使他们继续观看,以寻找答案。
2. 后续内容回应了开头的问题
视频随后给出“为了守护安静”的解释。
前面提出的问题得到回应,观众可以把开头的信息与后面的价值表达联系起来。
如果视频提出问题却始终没有回应,效果可能完全不同。
3. 文字与画面承担不同的表达任务
文字提供明确的情绪和价值表达,画面则持续展示与这些表达相关的环境和人物状态。
两者并不是简单重复,而是在共同构建视频的整体感受。
4. 结尾把具体场景提升为情绪表达
“城市安放你的野心,这里安放你的脆弱。”
这句话将一个具体的小院,转化为关于生活状态和情绪需求的表达。
观众不再只是看到一处环境,也可能把自己的生活经历、压力或情绪需求联系进来。
这几个环节组合在一起,就构成了这条视频值得分析的表达机制:
通过信息差引发兴趣,通过画面与文字建立感受,再通过结尾完成情绪表达。
不过,这里必须强调一个边界。
我们可以分析这些设计为什么可能有效,却不能只凭视频本身,就确定它实际获得了多少观看、观众为什么点赞,或者它传播成功的真正原因。
要回答这些问题,还需要播放完成率、停留时长、互动数据,以及真实观众反馈等证据。
因此,AI 对视频传播机制的分析,更适合被视为一组有依据、可进一步验证的解释,而不是已经被证明的因果结论。
七、一个容易被忽略的问题:AI 会不会脑补?
前面几个层次,主要考察 AI 能否从视频中提取信息,并对表达方式进行分析。
但这次实验还让我注意到另一个问题:
一个看起来分析得很深入的答案,不一定每句话都有充分依据。
例如,视频里出现了一处小院。
我们可以确认画面展示了小院,却不能仅凭画面就确定它的具体位置、经营价格、预订方式,或者创作者的商业模式。
同样,视频里出现一个男人,也不代表我们知道他的身份和真实经历。
因此,分析结果至少应该区分三个层次。
第一类:视频明确呈现的事实
例如:
画面中出现小院和木屋; 视频出现关于房间数量的文字; 画面中出现雨水、溪流等自然环境; 视频使用了“城市安放你的野心,这里安放你的脆弱”这样的表达。
这些信息可以直接从视频中确认。
第二类:有依据的分析与推测
例如:
开头的表达可能制造了信息差; 自然环境的画面与文字共同强化了安静的感受; 结尾通过城市与小院的对照,强化了情绪表达。
这些不是简单复述,而是建立在视频内容之上的分析。
它们具有合理性,但不应被当作已经证实的事实。
第三类:视频无法确认的信息
例如:
小院的真实位置; 人物的身份; 真实经营情况; 创作者的具体创作动机; 观众实际观看后的心理变化。
如果没有额外证据,就不应该直接下结论。
在这方面,三个模型的回答都涉及了对信息边界的处理,但不能仅凭这一次输出,就认定它们在所有场景中都能可靠地区分事实与推测。ChatGPT 的回答明确讨论了事实、推断和未知信息的区别,Grok 也列出了无法从视频直接确认的内容。
对于 AI 视频分析来说,这一点非常重要。
如果我们只是想获得灵感,适度推测可能有帮助。
但如果我们要把分析结果用于创作、商业判断,甚至自动生成脚本,就必须知道哪些内容有依据,哪些只是推断。
否则,分析得越详细,反而可能把错误信息包装得越像事实。
八、ChatGPT、Gemini、Grok,谁分析得更好?
回到这次实验。
如果只是比较三个模型的表达风格,很容易得出一些主观结论:谁写得更长、谁的语言更有感染力、谁使用的术语更多。
但这些并不一定代表分析能力更强。
这次更值得关注的是它们对同一条视频的核心判断。
说明:表格根据这次实验中的具体回答整理,不代表三个模型在所有视频任务中的总体能力排名。
从这次结果看,三个模型对视频核心表达机制的判断比较接近。
它们都没有停留在“这是一个表现田园生活的视频”这一层,而是进一步识别了开头的信息差、内容推进方式、文字与画面的关系,以及结尾的情绪表达。
但这不意味着三个模型的能力完全相同。
它们在分析展开方式、细节组织和具体解释上仍然存在差异。
更重要的是,这次实验只涉及一条视频。它不足以证明哪个模型总体上更强,也不能代表它们面对剧情复杂、信息密集或镜头快速变化的视频时,依然会得到类似结果。
这次实验真正有价值的发现,不是选出了冠军,而是帮助我们看到了视频分析应该关注哪些层次。
九、如果要用 AI 分析短视频,应该分析什么?
经过这次实验,我认为可以把 AI 短视频分析整理成五个层次。
第一层:内容——视频里发生了什么?
识别人物、场景、动作、文字和主要事件。
这是理解视频的基础。
第二层:结构——内容是如何组织起来的?
分析开头如何引入信息,内容如何推进,关键解释何时出现,以及结尾如何收束。
这是从描述走向结构分析的关键。
第三层:节奏——信息和情绪如何变化?
关注镜头切换、画面变化、文字出现的时机,以及不同内容之间的衔接。
需要注意的是,真正准确的节奏分析,应当结合视频的时间信息、镜头边界和音频等证据,而不能仅凭一段文字概括就断定剪辑节奏。
第四层:机制——哪些设计可能影响观看?
分析信息差、反差、悬念、视觉配合和情绪表达,解释它们可能如何影响观众的注意力与理解。
这里的重点不是简单贴标签,而是说明具体内容为什么可能产生相应效果。
第五层:方法——哪些创作经验可以复用?
这是面向实际创作的一层。
例如,从这条视频中,我们可以提炼出一种可供尝试的表达方法:
从一个具体事实切入; 通过补充信息制造疑问; 延迟给出解释; 用画面强化文字表达的感受; 在结尾将具体场景提升为情绪或价值表达。
这不是保证视频成功的公式,也不是要求所有视频都照此制作。
它只是从一条具体视频中提炼出的结构方法,可以用于创作新内容,再通过实际发布效果进行验证。
至此,AI 视频分析才真正与内容创作建立起联系。
因为我们不只是知道一条视频为什么可能有效,还尝试把分析结果转化为可以测试、修改和复用的创作方法。
写在最后:AI 是真的看懂了,还是只是说得像看懂了?
这次把同一条视频交给 ChatGPT、Gemini 和 Grok,我原本更关注三个模型之间的差异。
但实验结束后,我觉得另一个问题更值得继续研究:
我们应该用什么标准,判断 AI 是否真正理解了一条视频?
仅仅能够描述画面,不够。
能够说出“信息差”“情绪价值”“反差”等术语,也不够。
更值得关注的是,AI 能否从具体画面和文字中找到依据,解释内容之间的关系,拆解整条视频的结构,并提出可以进一步验证的判断。
与此同时,它还需要知道自己的边界:哪些是视频明确呈现的事实,哪些是基于事实的推断,哪些信息根本无法从视频中确认。
这次实验至少给出了一个方向:
评价 AI 的视频理解能力,不应该只看它说得有多漂亮,而应该看它能否提供有依据、可检验、能指导创作的分析。
当然,一条视频还不足以回答所有问题。
下一步,我更想把同样的方法用于不同类型的视频:剧情类、知识类、口播类,以及依靠快速剪辑推进内容的视频。
看看当视频的内容、结构和表达方式发生变化时,AI 是否依然能够准确分析。
也看看它能否进一步把分析结果转化为真正可用的创作方案。
毕竟,理解一条视频只是起点。
能够解释它如何表达,并把这种理解转化为新的创作能力,才是 AI 视频分析更值得探索的方向。
互动话题:
如果让你判断 AI 是否真正看懂了一条短视频,你最看重什么?
A. 能不能准确描述视频内容
B. 能不能拆解视频结构
C. 能不能解释视频为什么可能吸引观众
D. 能不能把分析结果转化为可复用的创作方法
欢迎在评论区说说你的看法。