ARTICLE · 1177142
NVIDIA RTX Spark 软件生态就绪:1 petaflop 算力的个人 AI 超级计算机,10 月 16 日笔记本上市
NVIDIA RTX Spark 软件生态就绪:1 petaflop 算力的个人 AI 超级计算机,10 月 16 日笔记本上市
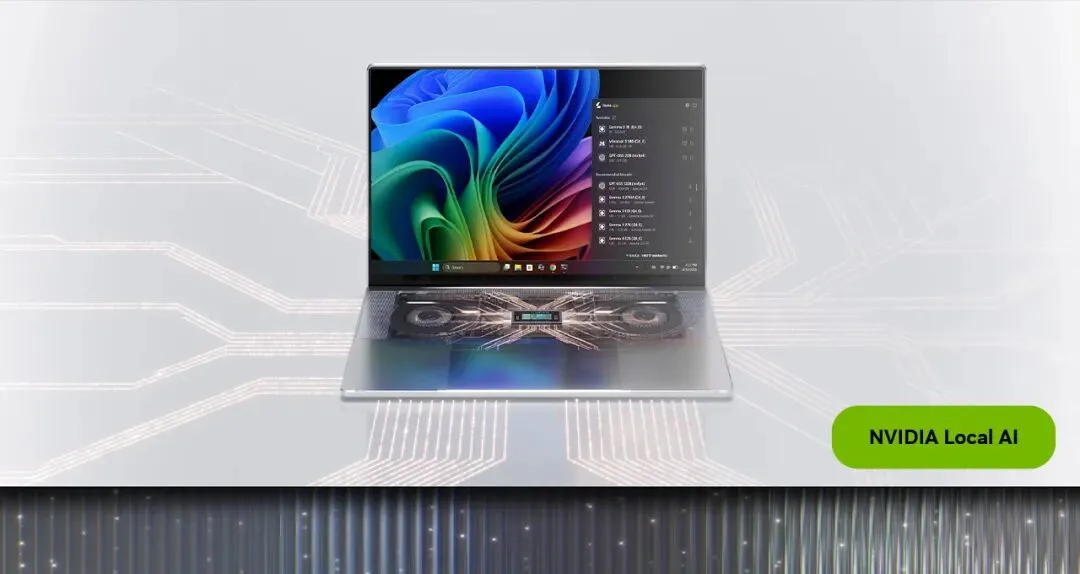
NVIDIA 官宣 RTX Spark 软件生态全面就绪——10 月 16 日笔记本上市前,已获得从本地智能体、创意应用到开发者工具的完整生态支持。最高 128GB 统一内存、1 petaflop AI 算力,配合 Nemotron 3.5 Bolt 74B 模型和 DLSS 5 神经渲染,一台"个人 AI 超级计算机"开箱即用。
一、事件速览
NVIDIA 官宣 RTX Spark 软件生态全面就绪——作为融合游戏、创意与本地 AI 的超级芯片平台,在 10 月 16 日笔记本上市前,已获得从智能体、创意应用到开发者工具的全生态软件支持。
硬件规格:
最高 128GB 统一内存; 1 petaflop AI 算力; 搭载完整 RTX 和 CUDA 技术栈。
二、关键时间节点
| 10 月 16 日(周五) | RTX Spark 笔记本上市 |
三、本地 AI 智能体生态
安全沙箱
NVIDIA OpenShell + Microsoft Execution Containers (MXC):
Hermes Agent 月底前集成细粒度 OpenShell 控制和 MXC; OpenClaw、GitHub Copilot 现已支持 MXC。
模型路由
NVIDIA Switchyard 开源库:实现本地/云端 LLM 智能路由;Hermes 10 月晚些加入。
智能体应用
GitHub Copilot、Hermes、OpenClaw、Perplexity、Pi、WorkBuddy 均优化设置流程;首发预装"入门"界面,一键选择安装智能体应用。
MCP 支持
NVIDIA 为自家应用提供 MCP(NVIDIA App、Broadcast、PAIR、Omniverse、RTX Remix 及 CUDA-X Skills 库)。
四、Nemotron 3.5 Bolt 74B:本地大模型
规格:74B 参数、9B 激活的 MoE 模型,2-bit 量化压缩至 24GB; 特点:"比大多数流行的稠密模型更快,同时比大多数具有相似内存占用的流行 MoE 模型更智能"; 支持运行时:llama.cpp、vLLM、Ollama、Unsloth、LM Studio; 开源:训练数据、权重、配方全部开放。
五、创意应用优化
Adobe 全家桶(最高 2 倍性能提升)
Photoshop:GPU 加速合成、改进移除工具和漏光效果; Premiere:加速播放、渲染、调色、增强语音和对象蒙版; Substance 3D Painter:加快纹理烘焙、项目打开/保存/导出。
NVIDIA Broadcast 2.3(现已可下载)
新增 RTX Video Super Resolution、视频帧生成、Studio Voice 配置文件; 新增离线文件处理器(对预录内容应用高质量效果); 新增 MCP 服务器,智能体可直接控制 Broadcast。
ComfyUI 与 Blender
ComfyUI:新增 RTX Video Frame Generation 和 RTX Video HDR 节点,支持 EXR 导出; Blender 5.3:测试版已支持 RTX Spark;下月新增 DLSS Ray Reconstruction。
六、开发者工具
与 Microsoft 合作的多项"首个"
首个 Windows on Arm 的 PyTorch-CUDA 构建; 首个 Windows on Arm 默认原生的 Python 3.15 构建; 首个 Windows on Arm 原生 Conda 安装程序(含 2,000+ 包); 前 15,000 个 Python wheels 中 97% 已就绪。
编码智能体
GitHub Copilot:新增 MXC 支持,更新 HydraFusion 路由以支持本地模型; Microsoft MAI 1.1 Coding Flash:可在本地使用,llama.cpp 成为 Windows ML 后端; Llama.cpp:新增决策模型支持(速度比传统智能体快达 200 倍)、发布 Llama Windows 原生应用。
NVIDIA Skills
开源仓库,无需 CUDA 知识即可开发加速应用。
七、游戏与 DLSS 5
首发游戏数百款:Cyberpunk 2077、Fortnite、Gears of War: E-Day、Genshin Impact、Hogwarts Legacy、Honkai: Star Rail、Marvel Rivals、NBA 2K27、World of Warcraft 等; DLSS 5:3D 引导神经渲染,AI 增强光照和材质——全新 AI 模型速度提升 2 倍,帧率提升最高 1.4 倍;首发于 NBA 2K27,11 月 5 日 Hogwarts Legacy。
八、游戏智能体(NVIDIA ACE)
Nemotron 3.5 Bolt E4B 4GB(第三代 SLM,10 月 23 日发布):自然对话 + 多轮工具使用 + 指令遵循,专为低内存占用和快速首 token 时间设计; SkyrimNET(AI NPC 模组):兼容 RTX Spark,支持云/本地混合推理。
九、怎么读这次发布
1. 本地 AI 的生态拐点
本地 LLM 下载量已是去年全年的 5 倍,且本地模型能力已赶上数月前的云端前沿——"个人 AI 超级计算机"从概念进入"开箱即用"阶段。RTX Spark 的意义在于:把"本地跑大模型"从极客玩法变成标准化产品。
2. 软硬一体才是护城河
RTX Spark 不只是芯片——它把**本地智能体(沙箱+路由)、创意应用(Adobe 2 倍加速)、开发者工具(PyTorch 原生)**打包成一个完整生态。硬件决定上限,生态决定体验——这正是 NVIDIA 想建立的新护城河。
3. 游戏与 AI 的融合加速
DLSS 5 神经渲染 + ACE 游戏智能体(AI NPC)——游戏正在成为 AI 端侧能力的最大展示场。一台机器同时跑得起 3A 大作和 74B 本地模型,"游戏本"和"AI 工作站"的界限正在消失。
4. 对开发者的实际意义
Windows on Arm 的 PyTorch/Python/Conda 原生支持、97% wheels 就绪——RTX Spark 想消灭"本地 AI 开发环境搭建"的痛点。对做本地 AI 应用的开发者,这可能是今年最值得关注的端侧平台。
十、结语
128GB 统一内存、1 petaflop 算力、数百款游戏、全套创意应用、本地智能体沙箱——10 月 16 日,RTX Spark 笔记本上市时,带的是一个 "开箱即用"的完整 AI 生态。
NVIDIA 的打法很清晰:不只是卖一块强大的芯片,而是卖一套"个人 AI 计算"的标准。当本地大模型、AI 创意工具、神经渲染游戏在同一台笔记本上流畅运行,"PC"的定义,正在被改写成"个人 AI 超级计算机"。
技术来源
NVIDIA Blog:All Systems Go: Global PC App Ecosystem Ready for NVIDIA RTX Spark(原文) NVIDIA RTX Spark 操作手册 NVIDIA Personal-AI-Router(GitHub)
本文基于 NVIDIA 官方博客公开资料整理,产品信息与时间表以 NVIDIA 官方发布为准(可能随版本调整)。仅作客观信息分享,不构成购买或投资建议,配图版权归 NVIDIA 所有,转载请注明出处。