ARTICLE · 1177504
同一个学生,两份试卷, 一个80,一个95——问题出在哪?
同一个学生,两份试卷,一个80,一个95——问题出在哪?
“我上学期期末做了一件事:把同一套试题,给同一个学生考了两次,间隔一周。结果你猜怎么着?第一回80分,第二回95分。学生自己都懵了——‘老师,我是不是运气变好了?’”
这是我在一次教研沙龙上听到一位老师分享的“实验”。在场的老师们都笑了,但笑完之后,好几个人陷入了沉思。
考试分数不稳定,到底是学生的问题,还是“试卷”的问题?如果换一个老师来判卷子,分数会不会不一样?我们考的东西,真的是我们想考的东西吗?
这些问题,其实指向了评估的两个核心质量指标——效度和信度。
🎯 效度:你测的,真的是你想测的吗?
书里对“效度”有一个特别简洁的定义:“评估是否真的测量了它声称要测量的东西。”
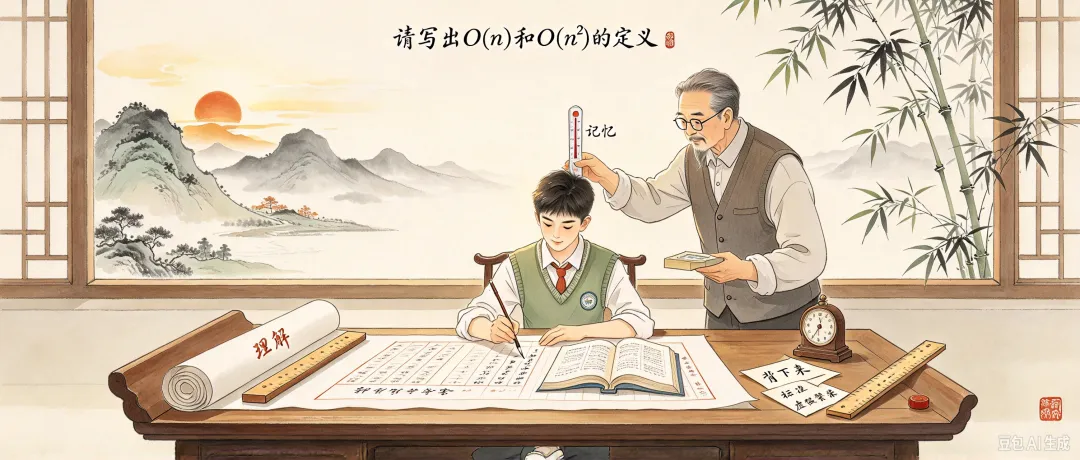
我举个例子你就明白了。你想测的是“学生是否理解算法的效率”。你出了一道题:“请写出O(n)和O(n²)的定义”。学生答上来了——但这真的说明他“理解”了吗?不一定。他可能只是背下来了。这道题“效度”不高——因为它在测“记忆”,而不是“理解”。
📌 效度低,数据就是“虚假的繁荣”
你看到的高分,可能只是“背诵能力”的分数,而不是“理解能力”的分数。
你看到的及格率,可能只是“运气”的及格率,而不是“掌握程度”的及格率。
——这就像用一把温度计去量身高,读数再精确,也跟你要的“身高”没关系。
书里第七章其实提过一个经典的“效度陷阱”故事:杜威问学生“如果在地球上挖一个洞,你会发现什么?”没人回答。老师纠正说“地心的状态是什么?”全班齐声答“岩浆”。——学生“知道答案”,但根本不“理解”自己在说什么。那道题的“效度”是零。
💡 一个简单的“效度自检”方法:
出一道题之后,问自己三个问题:
① 学生如果“不理解”,能不能靠“记忆”答出来?
② 学生如果“真理解”,有没有可能因为“没读懂题目”而答错?
③ 这道题的答案,跟“理解”本身的关系有多大?
如果第①个问题的答案是“能”,那这道题效度就有问题。
📐 信度:你的评估“稳”吗?
如果说效度是“对不对”,那信度就是“稳不稳”。书里给的定义是:“评估结果的一致性——在不同时间、不同评分者之间,结果是否能保持稳定。”
❌ 信度低的信号
· 同一份卷子给不同老师判,分数差十几分
· 同一份作文,过一周再批改,分数变了
· 选择题多猜几道,分数就大起大落
· 学生说“这次题我都会,就是没发挥好”
✅ 信度高的特征
· 不同老师评分结果基本一致
· 同一老师前后评分一致
· 评估结果不是靠“猜”出来的
· 评估结果是“稳定的”,不是“波动的”
信度这件事,在“主观题”和“表现性任务”的评估中尤其是个挑战。因为你觉得“好”的作品,另一个老师可能觉得“一般”。如果没有清晰的量规,信度就无从谈起。
💡 书里的原话:
“信度是效度的前提——如果评估结果都不可靠(今天A得90、明天A得70),那‘效度’根本无从谈起。你没办法说‘这个分数反映了理解’——因为分数本身就在飘。”
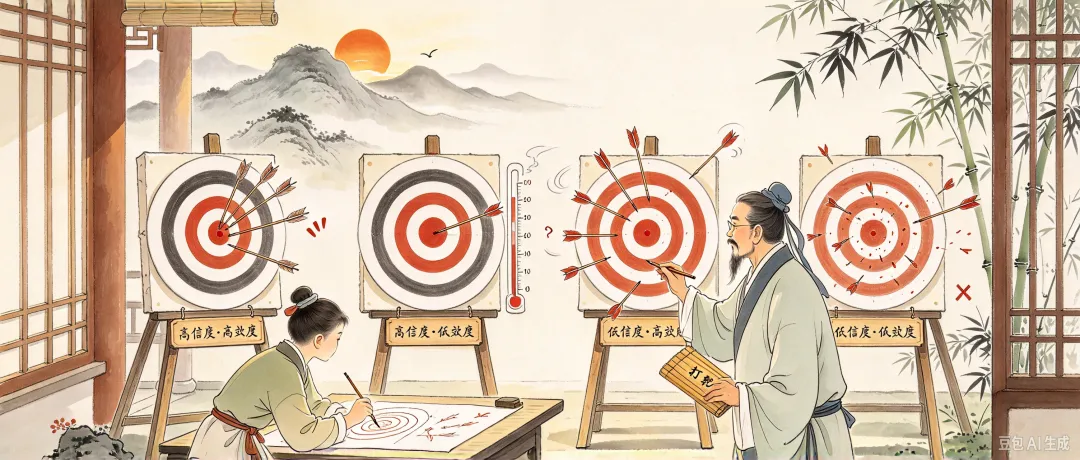
🎯📐 效度与信度:打靶的比喻
我经常用一个“打靶”的比喻来跟老师们解释这两个概念,特别直观:
🎯 靶心 = 你要测量的“理解”
高信度 + 高效度:每一枪都打在靶心附近 —— 评估稳、且测对了。
高信度 + 低效度:每一枪都打在同一个地方,但那个地方不在靶心 —— 评估很稳,但测偏了(比如稳定地测到了“记忆”而不是“理解”)。
低信度 + 高效度:偶尔能打中靶心,但大部分时候飘忽不定 —— 偶尔测准了,但不可靠。
低信度 + 低效度:完全乱打 —— 评估既不稳也不准。
所以,好的评估 = 高信度 + 高效度。 缺一个都不行。
💻 信息科技学科里,怎么判断效度和信度?
🔹 效度问题示例
目标:学生能“用循环结构解决实际问题”。
你出的题:“请写出for循环的基本语法。”
❌ 效度低——这是在考“语法记忆”,不是“问题解决”。
✅ 效度高——给一个实际场景(如“计算全班同学的平均身高”),让学生写出完整代码。
🔹 信度问题示例
任务:“设计一个App界面原型”。
问题:两个老师评分相差20分——一个看“视觉好看”,一个看“交互逻辑”。
❌ 信度低——评分标准太模糊。
✅ 信度高——有明确的量规(布局、色彩、交互反馈、用户流等指标,每个指标有等级描述),两个老师按同一标准打分,结果相近。
📋 给你的评估方案做一个“质量体检”
我整理了一份“评估质量自检清单”,每次设计完评估方案之后花10分钟过一遍,就能发现大部分问题:
🔍 效度自检:
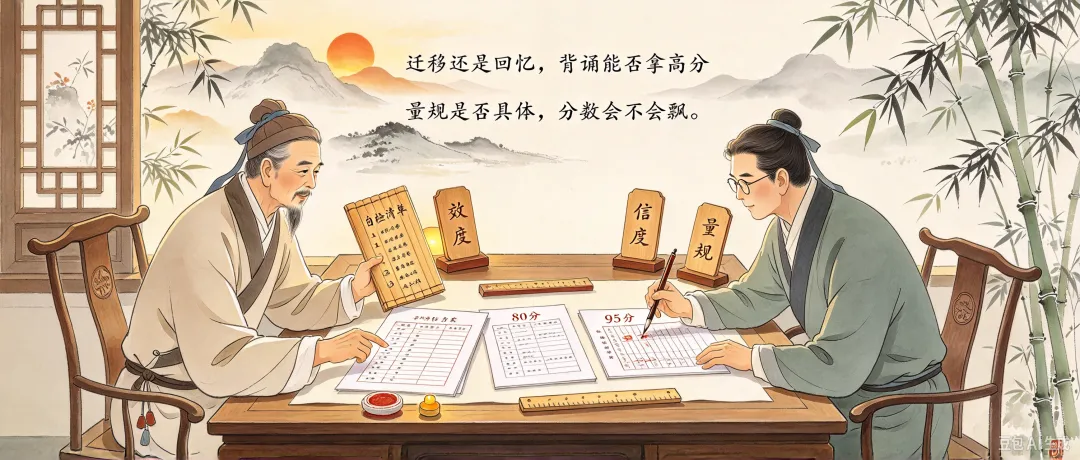
✅ 我的评估任务,需要学生“迁移”知识,还是只需要“回忆”?
✅ 如果学生不理解,但“背得好”,能拿高分吗?
✅ 如果学生真理解了,但“没发挥好”,有可能被低估吗?
✅ 我的评估任务,跟“大概念”和“理解目标”之间的关联是直接的还是间接的?
📐 信度自检:
✅ 换一个老师来评,分数会差很多吗?
✅ 同一个学生做两次,分数会不会“飘”?
✅ 我的量规描述是否足够具体,能让人“看到同一件事情”?
✅ 有没有“运气成分”影响结果(比如选择题蒙对)?
💡 一个“立竿见影”的做法
设计完一个评估方案之后,找一个没教过这门课的同事,把你的任务和量规给他看,让他用这个量规去评三份学生作品。然后你用自己的量规也评一遍。对比一下——如果分数差距在5分以内,说明量规信度不错;如果差十几分,说明量规还需要细化。
这是我自己用过最有效的“信度测试”方法,屡试不爽。
📬 写在最后
回到开头那个“同一学生同卷不同分”的故事。那个老师后来仔细分析了一下:两次最大的差距在“问答题”上——第一回评分标准太模糊,第二回他做了一份详细的量规,按量规重新打分,两回的差距就从15分降到了3分。问题不在学生,而在评估工具本身。
效度和信度,听起来是两个“学术词”,其实就是两件事:
第一,你到底想测什么?测准了吗?——效度。
第二,你测出来的结果靠谱吗?稳吗?——信度。
下次你出题、出任务、用量规的时候,不妨多问自己一句:“我这个评估,经得起‘效度’和‘信度’这两个问题的拷问吗?”
“分数不是目的,真相才是。我们追求的不是‘让学生得分’,而是‘让分数反映真相’。”—— 这句话我写在每一份评估方案的开头。
🔜 下期预告: 第九章——“设计学习”。评估想清楚了,终于要回到“怎么教”了。但我们的教,跟以前有什么不同?WHERETO这个“教学设计导航仪”怎么用?下期见!
💬 今日互动
你最近用过的一个评估任务,有没有想过“它的效度怎么样”——它真的测到了你想测的东西吗?
欢迎在评论区分享你的“效度自检”结果,咱们一起看看有没有“测偏了”的评估!
📖 本文内容整理自《追求理解的教学设计(第二版)》第八章