ARTICLE · 1177497
别再硬啃源码!我做了个 Skill,让 AI 帮你拆明白开源项目
看到一个开源项目,我们想知道的往往是同几件事:它能做什么?核心功能怎么实现?License 能不能商用、能不能私有化交付?手上的需求,它能满足几条?
不同角色关心的侧重点不同,过程却差不多:
开发者想读懂源码,学习好的设计; 架构师要做技术选型,给出有依据的判断; 产品经理要看清竞品的功能设计; 方案和售前要给客户一份能落到纸面的评估结论。
这些问题回答起来,得在文档、代码和运行环境之间来回切换:功能清单要核对,架构图要自己梳理,重要结论还得留下出处,方便后续讨论和复查。几天下来,常常还只看了个大概。
AI Agent 已经能帮我们读代码。但只说一句"分析一下这个项目",输出的范围、深度和证据质量往往不够稳定,代码位置也经常对不上。
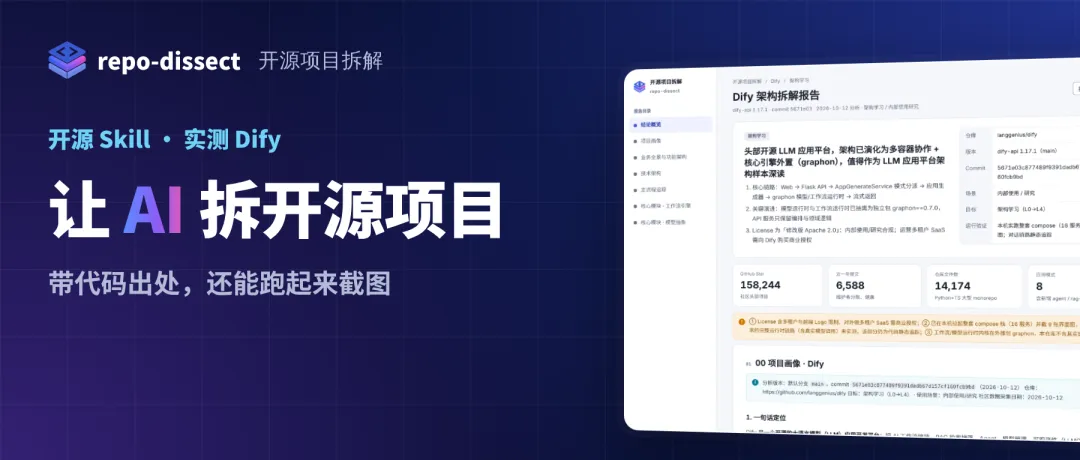
所以我做了 repo-dissect:一个把开源项目拆解整理成固定流程的 Skill,采用 MIT 协议开源。它给 Agent 提供分析步骤、证据规则和配套脚本,让结果既容易看,也方便回到代码里查。
一、先说目标,再决定拆多深
给它一个仓库地址或本地路径,说明你想解决什么问题,它会从外到内逐层分析:
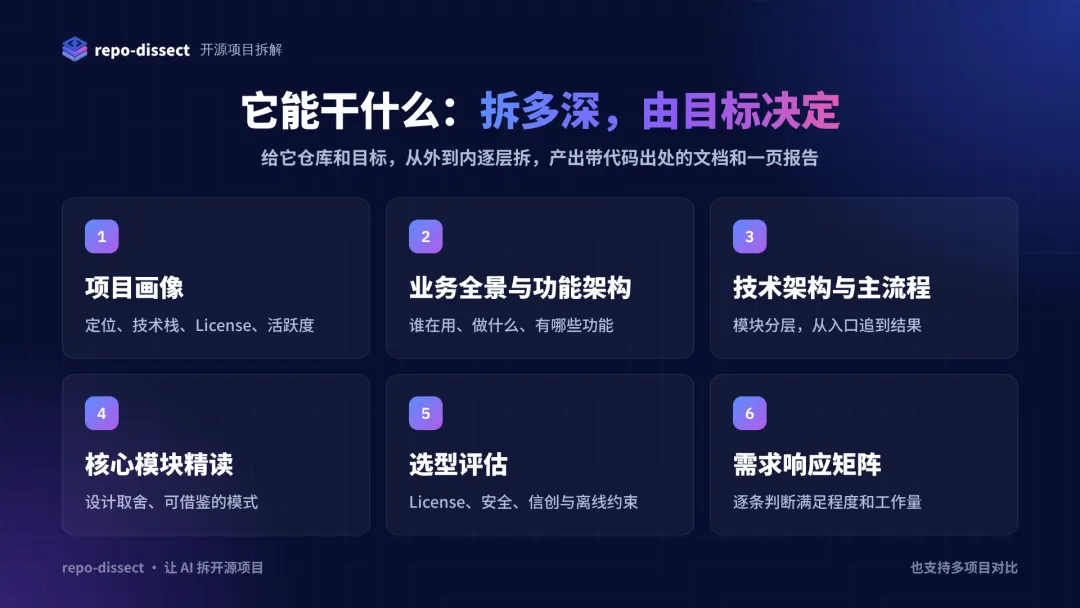
项目画像:定位、技术栈、目录职责、License 初判和社区活跃度,先判断值不值得继续研究。 业务全景与功能架构:梳理使用角色、场景和功能,标注社区版、企业版等版本归属。 技术架构与主流程:看清模块分层和核心抽象,选一个关键场景,从入口追踪到结果。 核心模块精读:分析设计取舍、可借鉴的模式和潜在技术债。 选型评估:整理 License、项目健康度、安全,以及信创、离线等部署约束,给出替代方案和需要进一步验证的问题。 需求响应矩阵:提供需求清单后,逐条判断满足程度、对应实现和二次开发工作量。
拆多深由目标决定:想学习架构,就重点看主流程和核心模块;要做选型,就补上约束评估;有需求清单,就增加响应矩阵。也可以把多个项目放在一起对比。
二、你只做两件事,其余交给 Agent 和脚本
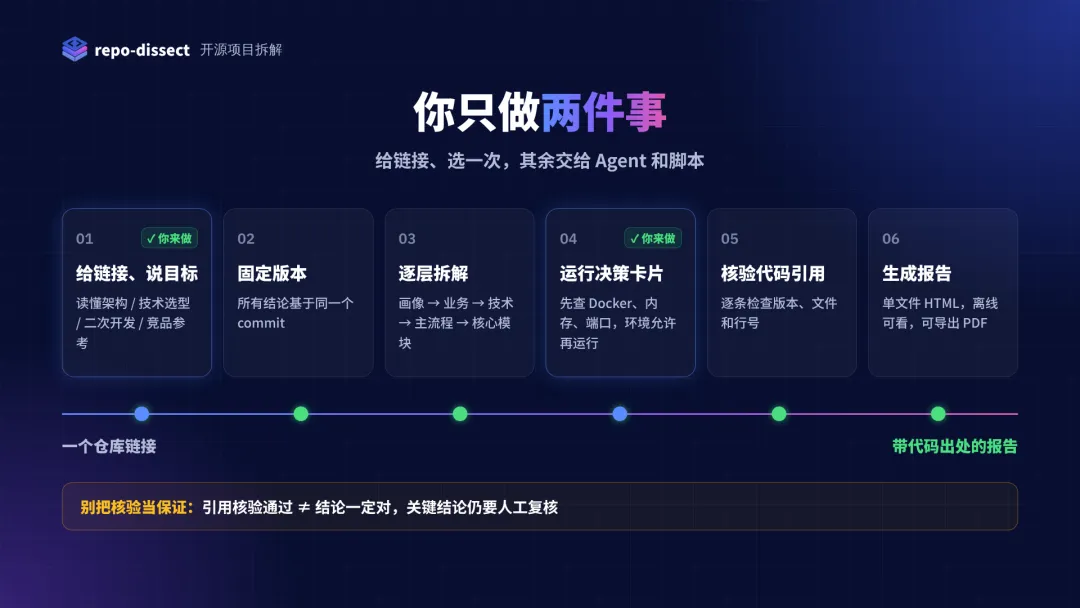
整个流程里,你只需要给链接、说目标,以及在运行决策卡片上选一次。其余步骤由 Agent 和内置脚本完成:
固定版本:所有结论基于同一个 commit,项目更新后也能增量更新。 逐层拆解:每一层写成独立文档。 环境允许就跑起来:先检查 Docker、镜像能否下载、内存与磁盘、端口,以及项目是否要求超出容器的宿主机权限,然后给出运行决策卡片。你确认运行后,它在项目副本中启动服务,按功能清单截图,结束后清理本次创建的容器、网络和数据卷,下载的镜像保留,方便下次使用。当前环境跑不了(比如在云端沙箱里),可以继续做静态分析,或生成一句接力指令交给你电脑上的 Agent。 核验引用:结论分三类:✅ 代码事实、🔍 推断、❓ 待确认。代码事实必须附上具体代码行。交付前,脚本检查每条引用的版本、文件和行号,并识别"指向文件第一行"这类说明不了问题的占位引用,核验不通过就不交付。 生成报告:单文件 HTML,离线可看,图表可下载,也可以通过浏览器打印成 PDF。
需要说明的是,"选一次"指的是正常流程。遇到需要首次初始化管理员账号、登录的项目,会多出相应步骤;端口冲突、内存不够这类问题,会给出原因和处理建议。另外,引用核验通过,能减少引用错位、方便复核,但不代表分析结论一定正确。
三、实测:用 WorkBuddy 拆 Dify
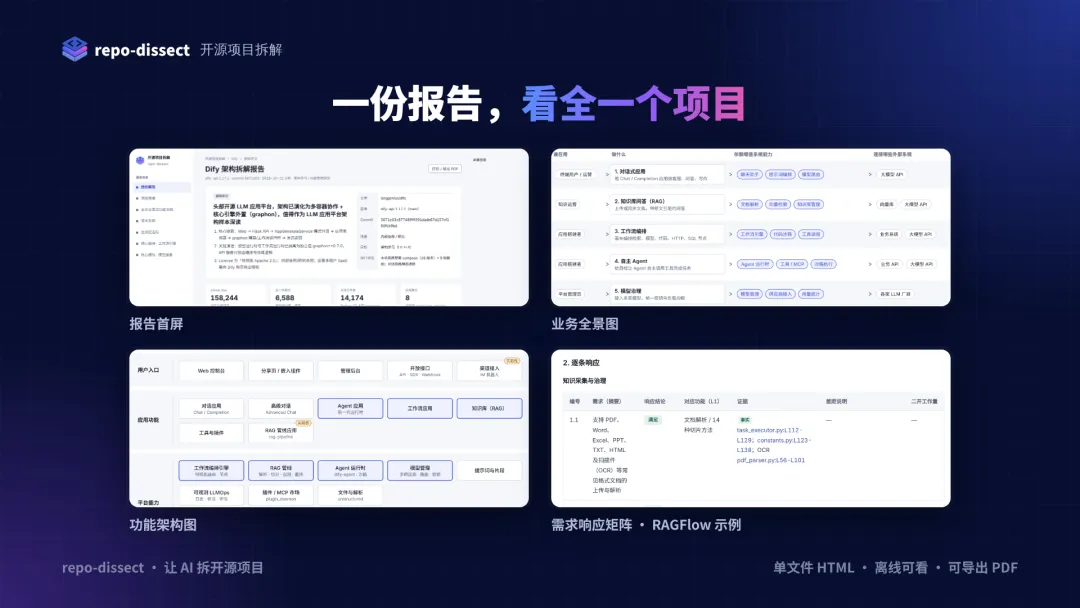
这次我在 Mac + OrbStack(Docker) 环境下,用 WorkBuddy 拆解 Dify,模型是 DeepSeek-V4.1-Flash,目标是架构学习。
最终完成了:
5 层分析:项目画像、业务全景、技术架构、主流程和核心模块精读,核心模块精读了工作流引擎和模型抽象; 6 份分层文档,共 122 条代码引用,全部通过核验,问题数为 0; 16 个服务(含一个一次性初始化任务)自动拉起,从执行运行命令到全部就绪约 5 分钟; 9 张运行页面截图,包括应用列表、知识库、模型供应商、工具插件等,已嵌入 HTML 报告。
耗时是这台机器、这个版本和当时网络条件下的结果,只能作为一次实例参考。
一个 Flash 级的模型就能跑完整套流程,原因在于流程控制、引用核验和截图出图都交给了脚本,模型主要负责把代码读对。当然,模型和 Agent 的选择仍会影响分析质量和执行效果。
四、最终拿到的是一份可以复查的报告
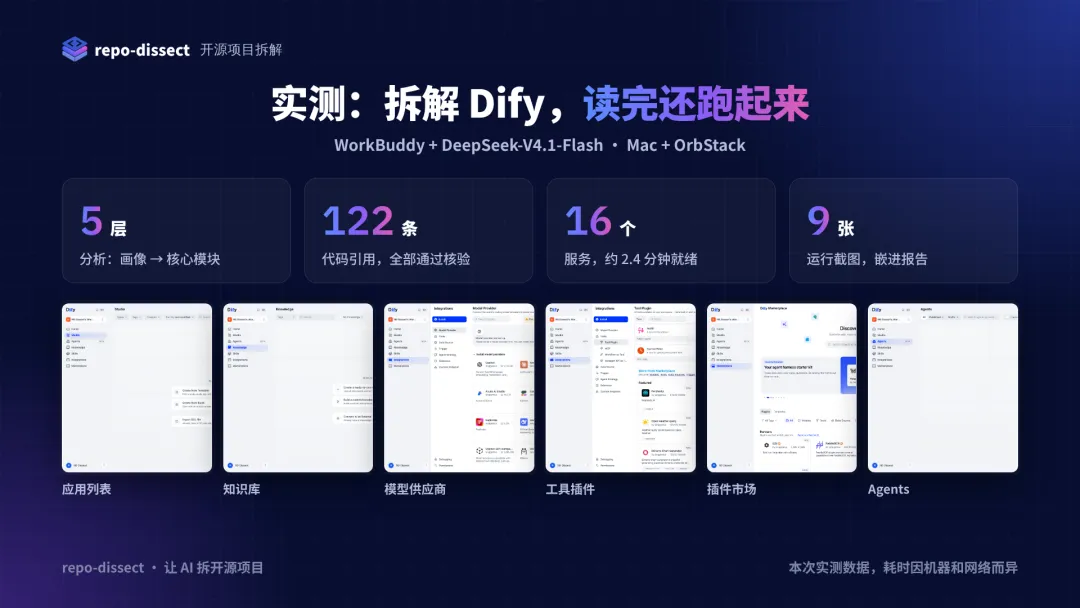
报告里有结论卡片和关键数字、业务全景图、功能架构图、主流程时序图,以及各层分析的汇总;运行成功时,还会包含页面截图。
提供需求清单后,会增加需求响应矩阵。比如仓库里附带的 RAGFlow 私有化选型示例,对 28 条示例需求逐条给出判断、对应功能和代码证据(这是另一个项目的示例,不是这次 Dify 实测的产物)。
报告可以离线打开,不必一直留在 Agent 的对话里,转给同事或客户也方便。
五、怎么开始用
repo-dissect 支持 Codex、Claude Code、WorkBuddy 等Agent。运行截图还需要 Docker 和浏览器自动化等条件,没有也能做静态分析。
把这句话发给你的 Agent 即可安装:
请从https://github.com/ReyYoung/repo-dissect安装 Skill,名称为 repo-dissect;安装完成后运行 scripts/check_env.py 校验,并告诉我安装路径。
装好后这样用:
用 repo-dissect 拆解 <仓库地址或本地路径>。目标:技术选型。场景:内部使用,需要内网离线部署。请结合附带的需求清单评估,并标出待验证项。
目标也可以换成"读懂架构"“二次开发"或"竞品参考”。目标和使用场景说得越具体,分析越能对准你真正关心的问题。
六、边界与局限
硬件与网络:大型多容器项目需要足够的内存和磁盘,镜像也要下得来(国内一般要开代理,或给 Docker 配镜像加速)。 静态代码看不出的东西:性能、吞吐量和真实部署效果需要实际测试,会标为"待确认"并给出压测建议。 人工复核:它适合帮你快速整理第一轮研究结果。License、信创和离线约束等关键结论,用于正式选型或交付前,仍需结合具体场景复核。
项目开源地址:
https://github.com/ReyYoung/repo-dissect
欢迎试用、贡献更好的想法与实现。
你在开源项目拆解过程中,都遇到哪些问题?欢迎留言聊聊。