ARTICLE · 1185944
给AI编程助手装上"省流模式":2万Star的context-mode,我把93万字节日志塞进去只回了500字节
标题:给AI编程助手装上"省流模式":2万Star的context-mode,我把93万字节日志塞进去只回了500字节
用 Claude Code 写代码写到一半,它突然开始胡言乱语、前言不搭后语——多半是它的"脑子"满了,不是出了 bug。
AI 编程助手的上下文窗口就像一张小桌子,工具输出、报错日志、文件内容全往上堆,堆满了就只能把最早的东西扫进垃圾桶,然后它就"失忆"了。今天 GitHub trending 第 3 名的 mksglu/context-mode(2 万 Star),干的就是给这张桌子"省地方"的事。
它到底省了什么
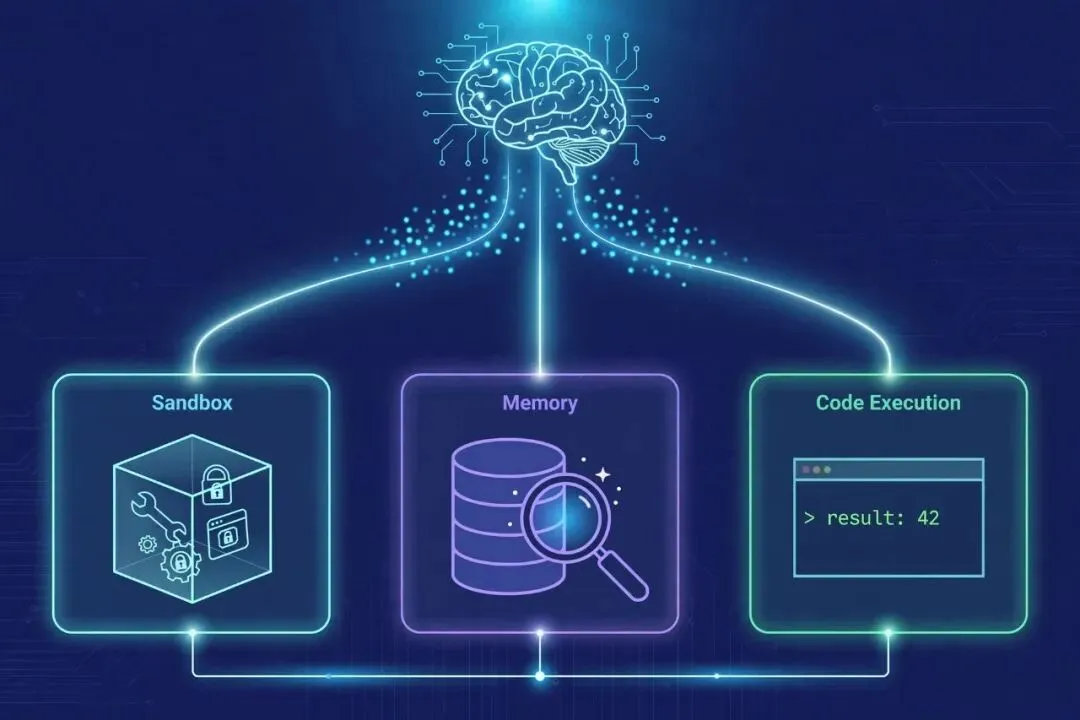
这个项目是个 MCP server,装上之后挂在 Claude Code、Codex、Cursor、Gemini CLI 等 12 个平台下面。思路就一个:别让垃圾进脑子。具体有三招,招招都冲着省地方去。
最狠的一招叫工具输出沙盒。平时你让 AI 读个日志、查 20 个 GitHub issue,几十 KB 的原始数据直接灌进上下文,半小时能吃掉 40% 的窗口。context-mode 把原始数据关进沙盒,只把摘要递出来。官方 README 写的是 315KB 压到 5.4KB,省 98%。
另一块是会话记忆。文件改了什么、git 提交了什么、你做过哪些决定,它都记成事件存进 SQLite。压缩对话时不搞全量倾倒,而是用 FTS5 全文检索加 BM25 排序,只把相关的捞回来。
还有一招挺有意思,叫 Think in Code。别让 AI 把 50 个文件读进脑子再分析,让它写一段脚本去算,只把 console.log 的结果拿回来。README 里的例子:47 次 Read 花了 700KB,改成一次脚本执行只要 3.6KB。
我亲手跑了一遍,数字比广告还夸张
光看 README 容易被营销话术带跑,我直接把它 clone 下来装上测。安装就一行 npm 命令,MCP server 走 stdio,本地 2 秒就起来了,一共 12 个工具。
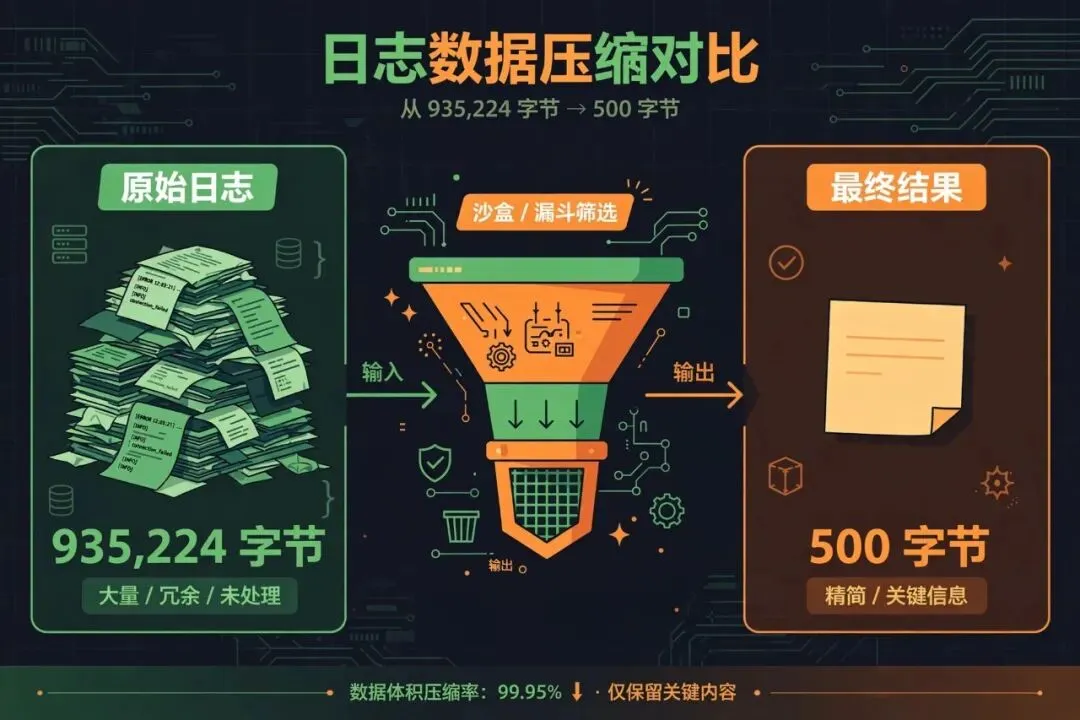
我先造了个 93 万字节(935,224 字节)的真实访问日志,1.2 万行。然后调它的 ctx_index 把整个目录索引进知识库——返回的结果只有 142 个字节,一句"已索引 1 个文件"。内容确实没进上下文,压缩率 99.99%。
接着测"Think in Code"。我在沙盒里跑了一段 JS:读进这 93 万字节,算出总请求数、5xx 错误数、P50/P99 延迟,只把一行 JSON 打印出来。返回 510 字节(含代码回显),算出来的数字是 12000 条请求、1169 个 5xx、P99 延迟 2377ms。传统做法是把 93 万字节全塞给模型,现在 500 字节搞定。
检索也试了,BM25 搜"500 错误",1884 字节就把相关日志片段捞回来了。自带的 doctor 命令把存储、6 种代码 runtime 全查了一遍,一路 PASS。
先别急着吹,泼两盆冷水
先说 license。这个项目是 Elastic-2.0,不是 MIT/Apache。代码确实公开在 GitHub 上,但 Elastic 协议对商用有限制。公司想魔改了拿去卖,得先看条款。2 万 Star 里有多少人注意到了这个,不好说。
再看 README 徽章上那个"68 万+用户"。这个数字是我亲手从它仓库的 stats.json 里 cat 出来的,项目自己填的,没有第三方审计。信几分,自己掂量。
另外它的 hooks 机制依赖平台配合,README 自己也承认:Cursor 上 hook 的额外上下文透不出来;Codex 的 PreToolUse 目前只支持拒绝规则,改不了输入。12 个平台适配器听着唬人,体验并不齐平。
谁适合装
天天跟 Claude Code、Codex 长会话死磕的人——一次会话跑一两个小时、动不动就被"上下文压缩"打断的,这个能实打实续命。偶尔写两行代码的人,感知不会太强。
项目地址:https://github.com/mksglu/context-mode
省下来的上下文,最终都会变成更长的有效工作时间。这笔账,至少对重度用户是划算的。