ARTICLE · 1191667
提供二进制文件,就能让 AI 重新实现软件功能?这个开源项目值得关注
大家好,我是aric。
遇到过这种情况吗:某个闭源软件里有个功能正好解决了你的痛点,你想知道它到底怎么实现的,好照着做一遍;或者手头有个没文档、没源码的老程序,出了 bug 只能靠猜。传统做法是开 IDA、Hopper 或 Ghidra 一点点读汇编,对非安全背景的开发者来说门槛不低,也极耗时间。
REA(ReverseEngineerAnything)做的事,是把这套逆向分析能力接到了 AI 编程智能体(ClaudeCode、Codex、Cursor、GeminiCLI 等)上。你用自然语言提一个问题,智能体通过 REA 去检查目标程序、追踪相关代码,再把结果和证据带回来。
下面基于它的官方仓库和文档,说说它到底能做什么、怎么用、边界又在哪里。
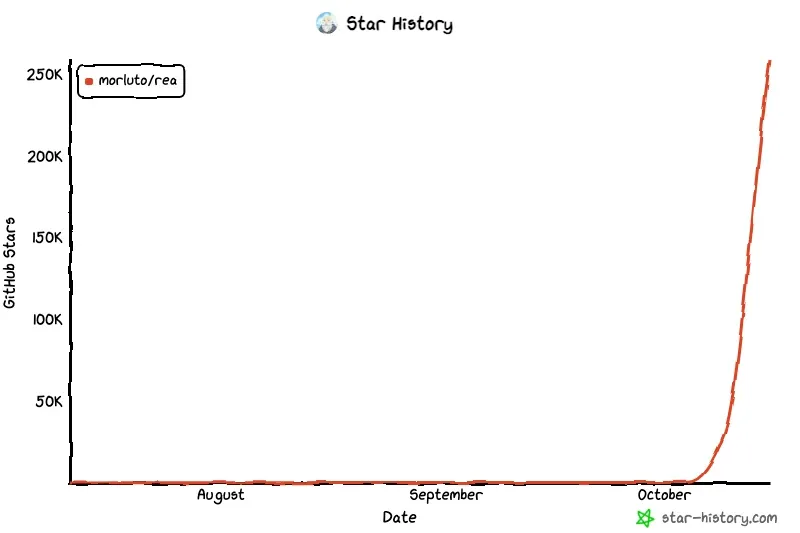
它解决什么问题?
逆向分析的麻烦不在“能不能做”,而在“太慢、太碎”。一个功能可能分散在预加载脚本、IPC 通道和主进程好几层里,手动追一遍要切好几个工具。REA 把这些工具统一成一套 MCP 工具,让智能体替你去翻、去追,并且每条结论都带着证据(以及它没把握的地方)一起返回。
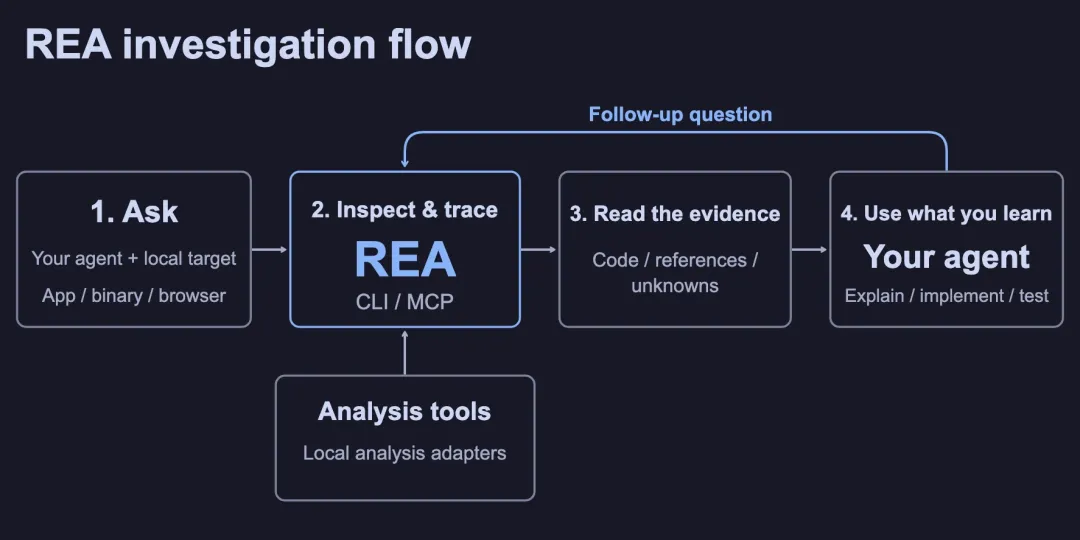
需要先说清一个定位:REA 没有把逆向“全自动”。它更像一个把分析引擎暴露给智能体的中间层,最终的解释、复现代码和测试,还是由你的智能体完成。
核心能力
REA 能分析的目标类型不少,挑几个有代表性的说。
原生二进制文件
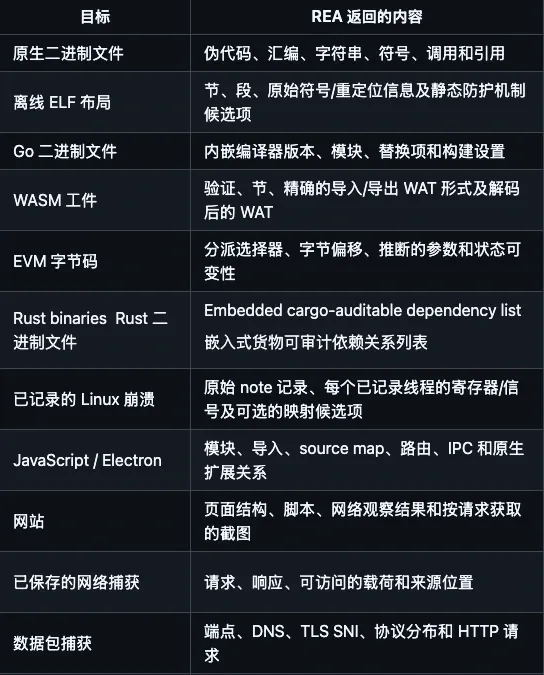
对没有源码的 .exe、.so、Mach-O 等,REA 借助你本机的 Hopper、Ghidra 或 IDA,返回伪代码、汇编、字符串、符号、调用和引用关系。官方文档提到,分析比较大的二进制时,可以调大启动超时:
export REA_GHIDRA_STARTUP_TIMEOUT_MS=120000# 或 Hopper 场景export REA_HOPPER_STARTUP_TIMEOUT_MS=120000JavaScript / Electron 应用
这类静态分析不需要本地原生分析引擎。REA 能还原模块、导入、source map、路由,以及渲染进程和主进程之间的 IPC 关系。文档里的 Notion 案例,就是顺着渲染进程的剪贴板 API,一路追到 preload 和 IPC 进入主进程,看清它的富文本剪贴板格式。
.NET 程序集与 Go / Rust 二进制
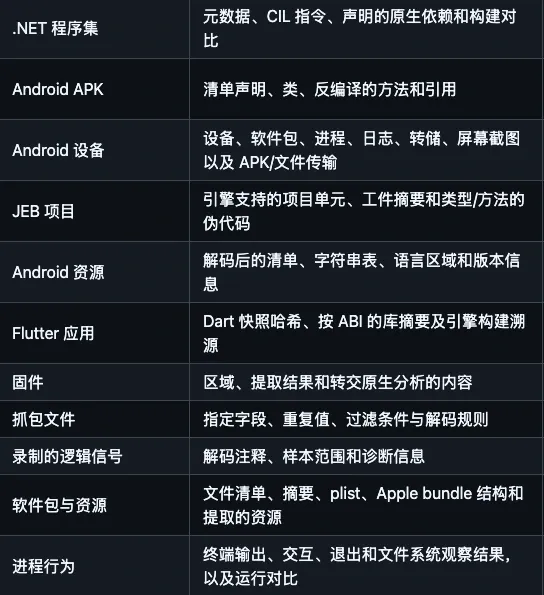
.NET 程序集可以做纯静态分析,返回元数据、CIL 指令和声明过的原生依赖,不需要额外引擎。Go 和 Rust 二进制则靠内置的静态检查,能挖出内嵌的编译器版本、模块、以及 cargo-auditable 的依赖信息——不需要你本机装 Go 或 Rust。
其他目标
文档还列了:离线 ELF 布局、WASM 制品、EVM 字节码、SQLite 数据库、Linux 崩溃记录、网站(需要 Chrome 系浏览器)、网络抓包(HAR / FiddlerSAZ)、AndroidAPK(需要 headlessJADX 和 JDK)。不同目标对外部工具有不同要求,不是开箱全包。
官方文档把这些目标整理成了一张对照表,标明每类目标能拿到什么结果,挑主要的看:
放到实际场景怎么用?
安装就一条命令:
npx rea-agents setup它会把 REA 的 MCP 服务注册到你的智能体上,并写入对应的工作流指令(会备份原有配置),重启智能体即可。之后直接在智能体里用中文提问就行。
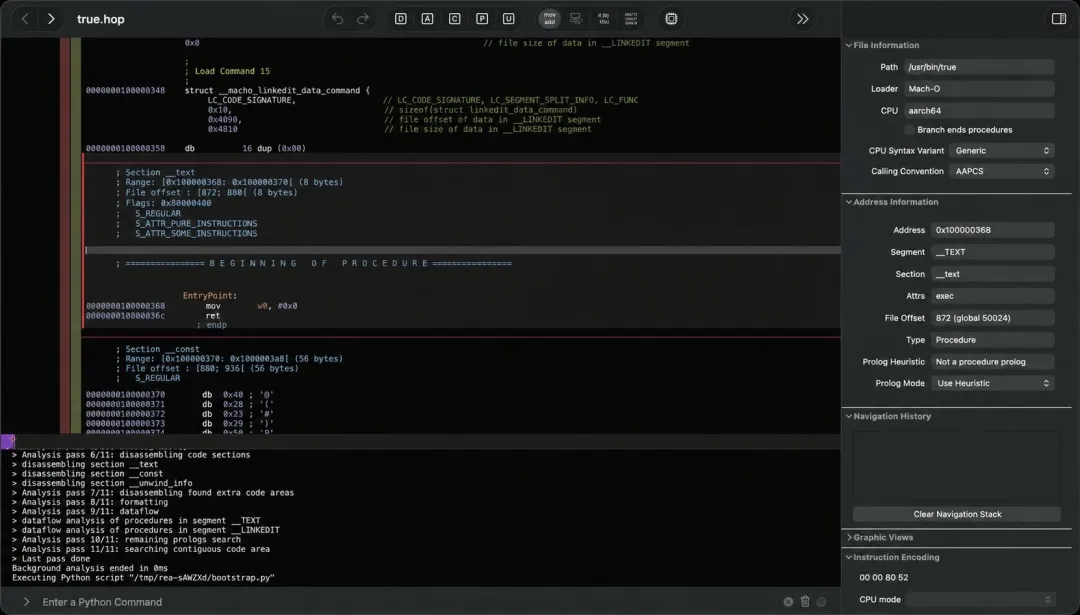
官方给了三个比较实在的案例:
DX-Ball 音效定位:顺着一次声音调用追到“位置转声像”的辅助函数,把不完整的伪代码补成 C,复现通过了 3,205 个原始 x86 用例,且和编译出的 63 个函数字节完全一致。
Notion 剪贴板桥:从渲染进程的剪贴板 API 出发,经 preload 和 IPC 追进主进程,看清富剪贴板格式。
TH04 弹幕环计算:分析一款 PC-98 老游戏的 16 位指令,复原固定角和瞄准角的计算,还能和当年编译器的输出对照。
这几个案例的价值在于,它们都附带了可验证的结果,而不是“看起来分析了一下”。
有什么限制?
把边界说清楚,免得抱着不切实际的期待去试。
深度原生分析依赖专业工具。Hopper、Ghidra、IDA 三选一;其中 Ghidra 免费开源,IDA 和 Hopper 需要你合法持有授权,REA 不提供任何授权或激活。想先上手,用 Ghidra 成本最低。
不是所有目标都自带引擎。WASM 要 WABT,EVM 要本地原始载体,AndroidAPK 要 headlessJADX 和完整 JDK,网站要 Chrome 系浏览器。缺对应工具就跑不了这一类分析。
运行环境有要求。Node.js 需要 22.19+ / 24.11+ / 26+ 外加 npm;Linux 上做进程归属检查还需要 ps(procps 兼容)。
数据留在本机,但模型有自己策略。REA 在本地分析,结果交给你的智能体;智能体背后的模型服务方有它自己的数据处理政策,敏感目标要自己评估。
REA 不安装也不更新商业分析器(Hopper、IDA 等),这些得你自己管。
另外官方特别提醒:只从 morluto/rea、rea.tools 或 npm 的 rea-agents 包获取,名字相近或照搬 README 的仓库不代表官方。
适合什么团队?
适合这几类场景:
想复用某个闭源软件里的具体功能,需要先把它“读明白”;
安全研究、CTF、恶意样本分析,需要快速从二进制里提取线索;
老程序没有源码和文档,需要理解或迁移某段逻辑;
游戏模组、复古平台(如 16 位 DOS)代码复原这类爱好者项目。
不太适合把它当成“一键反编译出完整可读源码”的工具——它返回的是带证据的分析结果,复现实现仍要靠人(和你的智能体)完成。如果你的日常工作只是普通应用开发、不需要逆向第三方目标,那它基本用不上。
总结
REA 把逆向分析工具接到了 AI 智能体上,降低了“看懂一个没有源码的程序”的门槛。它对多种目标类型都有支持,原生分析依赖 Hopper / Ghidra / IDA,而 JS、.NET 这类可以纯静态完成。要不要引入,取决于你手里有没有需要逆向分析的真实目标,以及是否愿意为深度原生分析准备好相应授权和工具。
项目地址:
https://github.com/morluto/rea
— 完 —
想加入交流群? 关注公众号后 ➡️ 添加作者微信。
关 于 作 者
一个每天泡在 GitHub 上挖开源项目的科技作者、一个专把复杂技术讲成人话的盘点爱好者、一个仍然希望 40 岁退休的懒人。