ARTICLE · 1195856
AI 驱动的软件逆向:用大模型 + MCP 拆解 DVR 私有录像格式
AI 驱动的软件逆向:用大模型 + MCP 拆解 DVR 私有录像格式2025 年以来,软件逆向最热的变化不是新的反编译器,而是把反编译器交给大模型去“驾驶”。核心事件是 2025 年 3 月 LaurieWired 发布的GhidraMCP:它通过 Model Context Protocol(MCP)把 Ghidra 的反编译、交叉引用、重命名等能力暴露给 LLM 客户端,几个月内在 GitHub 上获得数千 star(sourcepulse 统计)。随后 mrexodia(x64dbg 作者)发布了ida-pro-mcp,自称支持 “vibe reversing”,并已提供基于 idalib 的无界面(headless)模式。 学术界也在快速跟进:NDSS 2026 发表了人机协作逆向的实证研究《Decompiling the Synergy》,arXiv 上 2025–2026 年出现了SoK: LLM 用于逆向的潜力与挑战、CrackMeBench等基准,以及专门研究“恶意二进制反过来攻击 AI 逆向流水线”的RARE。 对音视频和车载工程师来说,这件事的意义很实际:我们日常面对大量只给二进制 SDK、不给文档的设备——DVR/NVR 的私有录像格式、车载终端的 JT/T 1078 厂商扩展、硬件编解码库的私有接口。过去逆向一个私有容器格式要一到两周,现在借助 AI 可以把“读伪代码、猜结构体、写解析器”这条链路大幅压缩。本文以两个互操作性场景为例,讲清楚怎么做、哪里会翻车、法律边界在哪里。 整条工具链的关键是 Model Context Protocol——一个让 LLM 调用外部工具的开放协议。逆向场景里,它把反编译器的能力(反编译、交叉引用、重命名、读取段/导入/导出)包装成 MCP 工具,模型就能像人一样一步步“操作”Ghidra 或 IDA,而不是只对着一段贴进来的伪代码空想。 主流选择:
工作流的骨架是固定的:反编译器把二进制变成伪代码和元数据 → MCP 把这些能力暴露成工具 → LLM 客户端(Claude Desktop、Claude Code、VS Code Agent 等)发指令、读结果、再决定下一步。模型可以自主地“看一个函数 → 跟进它调用的函数 → 重命名 → 推断结构体”,人则在旁边审阅和纠偏。NDSS 2026 的实证研究把这种模式称为 human-LLM teaming,核心结论是:AI 显著加速理解,但人仍是正确性的最终责任人。 目标:客户导出的.dvr录像只能用厂商播放器打开,我们要在自研 Qt + FFmpeg 播放器里原生支持它。已有材料是厂商随设备提供的 Windows 回放 SDK(一个PlayCtrl.dll风格的动态库)和几十个样本文件。整个流程分五步,AI 介入的是第 2、3 步。 第 1 步:不碰代码,先看数据 先用十六进制和统计工具做“盲猜”,这一步给后面的 AI 提供锚点,能显著减少幻觉。 第 2 步:让 AI 顺着 SDK 找解析函数 在 Ghidra 中载入 SDK 的 DLL,启用 GhidraMCP 插件,用 Claude Desktop 或 Claude Code 连接。给模型的提示要具体到锚点,而不是“帮我分析这个 DLL”: 这是一个 DVR 回放 SDK。已知:1. 录像文件前 4 字节固定为 48 4B 48 32;2. 每个 00 00 00 01 起始码前有 24 字节帧头;3. 导出函数 PlayM4_OpenFile 打开文件。请:- 从 PlayM4_OpenFile 出发,沿 ReadFile/fread 的调用链找到解析文件头和帧头的函数;- 用 MCP 工具把这些函数和局部变量重命名为有意义的名字;- 推断文件头和帧头的结构体,给出 C 定义,每个字段注明偏移、依据的伪代码行;- 无法确定的字段标记为 unknownN,不要猜测含义。 最后一句很重要:它强制模型区分“伪代码里看到的”和“它自己推测的”。好的输出类似这样: // 依据:parse_frame_header() @ 0x1000A3C0struct dvr_frame_hdr { // 24 bytes, little-endian uint32_t magic; // +0x00 == 0x63643030 ("00dc"),见 cmp 指令 uint8_t frame_type; // +0x04 1=I, 2=P, 3=audio(switch 分支) uint8_t channel; // +0x05 uint16_t unknown0; // +0x06 未被读取 uint32_t payload_len; // +0x08 作为 memcpy 长度 uint64_t pts_ms; // +0x0C 除以 1000 后传给时钟模块 uint32_t crc32; // +0x14 与 crc32_table 比较}; 第 3 步:把结构体变成可执行的“格式假设” 结构体只是假设,要立刻变成能在样本上跑的解析器。让 AI 生成一个Kaitai Struct定义或一段 Python 遍历器,然后在全部样本上跑: import struct, sys, zlibHDR = struct.Struct(' 三个断言就是格式假设的验收标准:魔数全部命中、CRC 全部通过、遍历恰好停在文件末尾。任何一项失败,就把失败位置的十六进制和对应伪代码再喂给模型,让它修正假设。 第 4 步:接入 FFmpeg 格式确认后有两条落地路径:
第二种方案的骨架同样可以让 AI 参照 FFmpeg 源码里的libavformat/flvdec.c之类现成解复用器生成,但 seek 和时间基转换要人工把关。 第 5 步:差分验证 “能播”不等于“对”。用厂商 SDK 的解码回调导出每帧 YUV,再用自己的实现跑ffmpeg -i x.dvr -f framemd5 -,逐帧对比哈希、帧数和 PTS。帧哈希全部一致,才算还原完成。这一步把 AI 的产出从“看起来合理”变成了“可证明正确”。 下面这张图是整个 AI 辅助逆向的闭环。 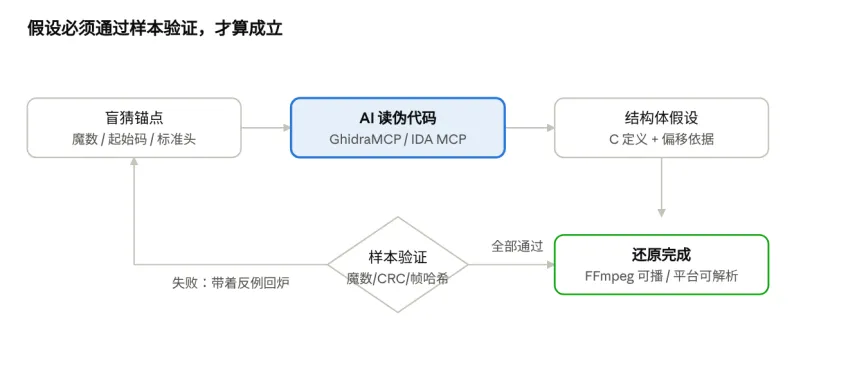
AI 辅助逆向闭环 · 5 步,1 个验证关口 AI 负责把慢而费眼的“读伪代码、猜结构体”自动化;人负责守住验证关口。假设没通过样本验证前,AI 的任何结论都只是待验证的猜测。 大模型辅助逆向最大的风险是幻觉——它会把反编译器输出里没有的字段、偏移、循环“补全”出来,而且写得非常像真的。2026 年 7 月的 arXiv 论文RARE(Representation-Confusion Attacks)更进一步指出:攻击者可以构造特制二进制,让字符串“看起来像指令”、让单一来源“看起来像多方独立证据”,诱导 AI 逆向流水线把一个正确提取的观察,提升为它并不具备的“指令权威”或“被验证的结论”。论文还发现,即便只把二进制内容当纯数据展示,模型仍会给出多个不安全结论。 这对我们的工程实践有三条直接约束: 1. 永远用样本验证,而不是用模型的自信度。 上面实践里的 CRC 校验、帧哈希比对 都是把 AI 的假设放到真实数据上证伪。能跑通全部样本的假设才采纳。 2. 逼模型区分“看到的”和“推测的”。 提示里固定要求:每条结论附函数地址与伪代码行号,拿不准的标unknown。没有依据的字段含义一律不信。 3. 把二进制内容当不可信输入。 固件里的字符串、调试日志可能被构造来误导分析,不要让它们直接决定你的解析逻辑——这正是 RARE 和相关工作LogJack(通过日志做间接提示注入)警示的攻击面。 一句话:AI 把逆向从“一周读伪代码”压缩成“一下午提假设”,但验证闭环一步都不能省,而且必须由人把关。 逆向工程本身不违法,但目的和手段决定了它站在哪一边。本文场景属于互操作性逆向——为了让自己的软件读懂自己合法拥有/被授权的数据,这是各国法律里相对清晰的安全区。但有几条线必须守住: 简单判断标准:你是在让系统互联互通,还是在绕过某种保护或复制他人成果?前者是工程,后者是风险。 MCP + 大模型没有改变逆向的本质,但改变了它的经济性:读伪代码、猜结构体、写解析器这条最耗时的链路被压缩了一个数量级。对音视频和车载这种“设备多、文档少、私有协议满天飞”的行业,这正是高频痛点。但 AI 的产出是假设,不是结论——真正让它可用的,是那套不可省略的验证闭环:锚点、样本全覆盖、CRC/帧哈希/PCAP 印证、以及人对法律与数据边界的把关。把 AI 当成快但会撒谎的实习生,你负责出题和验收,这套方法才稳。
技术栈:MCP 把反编译器变成 AI 的“手”
工具 | 底座 | 特点 | 适用 |
GhidraMCP | Ghidra(免费开源) | 2025 年 3 月发布,社区最活跃;插件装在 CodeBrowser 里,Python MCP server 桥接 | 无 IDA 授权、团队协作、裸 bin |
ida-pro-mcp | IDA Pro(商业,需 8.3+) | 覆盖反编译/交叉引用/重命名/调试;支持 idalib 无界面模式,可接 Claude Code | 已有 IDA、需要动态调试或批量 headless |
pyghidra-mcp / ReVa 等 | Ghidra | 命令行或模型无关的变体 | 脚本化、集成到 CI |
实践(音视频):还原 DVR 私有录像格式,让 FFmpeg 直接播放
binwalk -E sample.dvr 看熵:整体熵在 7.9 以上且没有起伏,说明可能加密,此时应停下来,转去向厂商要文档或密钥(见“合规”一节);熵有规律起伏,通常是“明文头 + 压缩码流”。 搜 H.264/H.265 起始码 00 00 00 01,再看 NAL 类型字节:H.264 的 0x67/0x68/0x65 是 SPS/PPS/IDR,H.265 的 0x40/0x42/0x44/0x26 是 VPS/SPS/PPS/IDR。起始码前面固定长度的字节,大概率就是私有帧头。 对比多个文件的前 64 字节,找出不变的魔数和随文件变化的字段(时长、帧数、通道号)。
方案 | 做法 | 适用场景 |
自定义 AVIOContext | 在播放器里剥掉私有帧头,把纯 Annex-B 码流喂给 avformat_open_input 的 h264/hevc 解复用器,PTS 自己维护 | 改动小,适合已有自研播放器 |
写 libavformat 解复用器 | 实现 read_header/read_packet,注册为新格式,直接输出带 PTS 的 AVPacket | 需要 ffmpeg -i 命令行、转码、剪辑等全链路支持 |
AI 的边界:它会一本正经地编造
合规与边界:互操作性是逆向的安全区
只逆向你有权处置的东西。 自家采购的设备、客户授权让你对接的终端、你合法持有的录像文件——这些没问题。逆向竞品软件以复制其功能、或破解授权/加密,则完全是另一回事。 碰到加密就停。 第一步熵分析若判定为加密,继续破解可能触及《刑法》及各地计算机犯罪条款。正确做法是向厂商索要文档或授权,而不是绕过保护措施。 不碰授权校验(crackme 除外)。 AI 逆向社区常用 crackme 练手是因为那是公开的教学样本;对真实商业软件的注册校验做同样的事,性质不同。 数据合规。 车载和监控录像常含车牌、人脸、位置轨迹,逆向和测试过程中的样本要按个人信息保护要求脱敏、限制留存。