ARTICLE · 1196725
PDF里的图片怎么取:原始图片提取与整页转图的使用指南
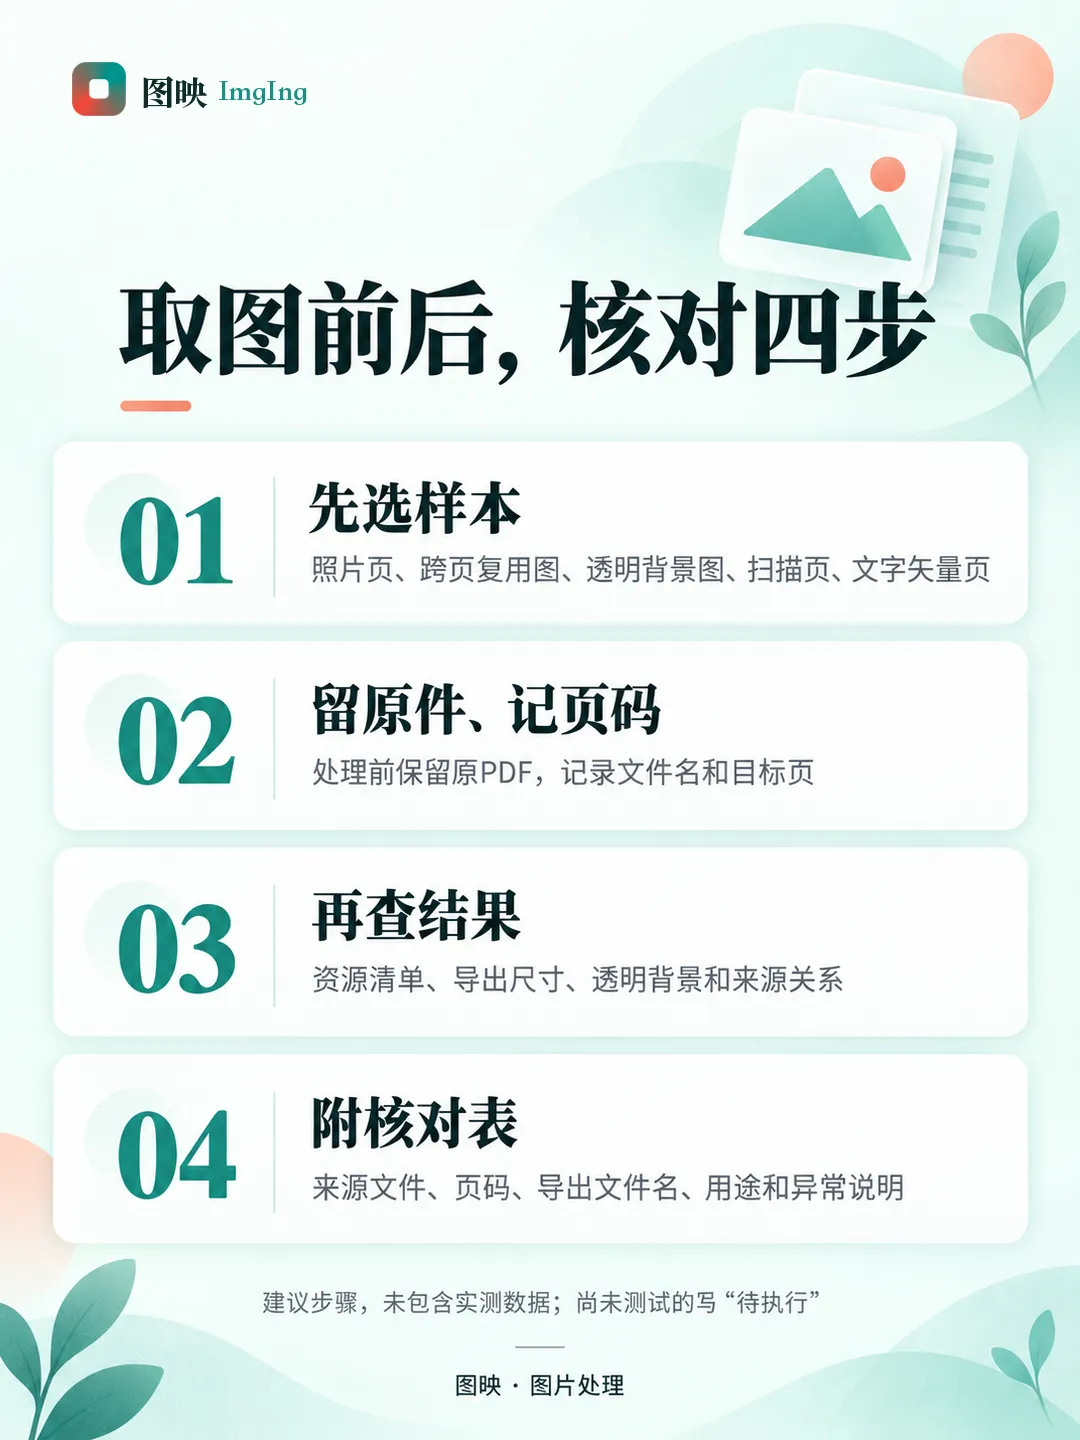
PDF里的图片怎么取:原始图片提取与整页转图的使用指南从产品手册里拿一张照片,和把整页发给同事,应该选择不同的处理方式。先确认交付目标,再选择图片提取或页面转图,能减少后面整理素材时的误会。一、从PDF里取图,先确定需要保留什么 从一份产品手册里复用照片,和把其中一页发给同事,表面上都是“把PDF变成图片”,交付目标却不同。前者需要一份可独立使用的素材,后者需要文字、图片、图形共同形成的页面外观。如果没有先区分目标,很容易把截图尺寸当成原图尺寸,或者把缺少页面装饰的提取结果判断为转换失败。我们在讨论图映的PDF图片提取时,先划清这个边界:资源提取服务于素材复用,页面渲染服务于版面展示。 页面显示的尺寸也不能直接说明资源本身的像素数量。一张图片可以在不同页面以不同大小出现,周围还可能叠加文字、矢量线条和背景。如果需求包含这些排版关系,就应保留页面渲染结果作为参照;如果需求是重新排版,则更需要检查内嵌资源。两种结果可以同时保存,但应分别命名,避免后续同事把页面预览当成原始素材继续加工。 二、图片对象、绘制位置与重复出现的关系 PDF页面可包含文字、矢量图形与图片资源,并非一个固定的大图文件。图片可能由多个页面引用,也可能位于可复用的Form资源中;资源存在于文件里,与它是否参与某一页的绘制,是需要区分的两个问题。因此,提取时只统计“找到了多少个对象”并不足以说明拿到了哪些可用素材,还需要结合页面使用关系核对。一个页面里看见多次同样的标志,不代表必须导出多份相同文件。 这一区分直接影响素材清单的设计。若只保留文件名而丢失来源页,编辑人员遇到相似图片时仍需要回到PDF逐页查找;若只按出现次数导出,又容易形成大量重复附件。比较清楚的交付方式是把“资源文件”和“页面引用位置”分开记录:资源保持一份,另用清单说明它在哪些页面出现。这是整理建议,具体结果应按工具实际提供的页码与序号核对,不能把建议清单写成产品已经提供的独立功能。 三、原始流复用,需要区分字节、像素与视觉结果 对能够直接复用的压缩图像数据,保留原始流可以避免一次不必要的像素还原与重新编码。这里的“保留”有明确前提:数据需要能够被识别、正确解释,并作为图片文件使用。即使导出的扩展名仍然是JPG,也不能仅凭文件名判断它经历了什么处理。核验路径应结合工具说明、导出尺寸、颜色与透明度结果,必要时再比较提取数据。 “字节一致”“还原像素数据后的像素一致”和“在页面上看起来一致”是三个不同的判断目标。直接复用原始压缩数据时,可以检查字节层面的变化;经过颜色解释或透明度合成时,输出文件的数据结构可能改变,而视觉核对依然必要。将结果保存为PNG,也不意味着原来的有损压缩信息被恢复了。我们建议在交付说明中记录处理路径,避免用一个笼统的“无损”覆盖不同情况。 还要区分“PDF内嵌图片”和“放入PDF以前的源文件”。原始照片可能在文档生成阶段已被缩小、压缩或处理,提取流程能拿到的是PDF实际保存的数据。缺失于PDF之外的信息,不能由提取动作凭空补回。因此,若任务要求相机原片或设计源文件,应优先向素材提供方获取源文件;PDF提取更适合复用文档已经携带的图像资产。 四、透明背景异常,要检查蒙版和颜色解释 有些图片导出后出现黑底、边缘不对或透明区域缺失,问题可能来自透明度信息未随主图一起处理。PDF中的软蒙版可参与定义图像的透明度,不能把它与主图完全割裂地理解。只导出主图,可能不足以重建原有外观;把蒙版当成独立照片交付,同样容易让素材清单变得难以使用。涉及颜色空间解释的资源,也需要检查颜色是否与参照页面一致。 核对时可把提取结果分别放到浅色和深色背景上,观察透明区域、半透明边缘和主体细节。若只在白底预览,一些边缘问题可能不容易发现;若拿页面上的裁剪效果直接要求原资源一致,又可能误判工具结果。建议分别检查资源本身、透明度合成以及页面上的摆放方式,把不同层次的问题记录清楚。对无法确认的异常应保留原PDF和问题页,避免反复重存造成后续判断困难。 五、图映当前的处理路径与使用边界 图映的PDF图片提取会检查页面实际使用的内嵌图片,并考虑共享Form资源和跨页复用。能够直接复用的JPEG、JPEG 2000数据优先保留原始压缩字节;需要颜色解释、蒙版合成或浏览器还原像素数据的资源,走PNG输出路径。结果可单独保存或打包为ZIP,解析、去重和打包在浏览器本地完成。这些是当前公开说明中的能力范围,不能扩大为对任何PDF结构、任何源图状态都作同样结论。 对于扫描PDF,如果页面本身保存的是扫描图片,存在可提取资源;对于主要由文字与矢量组成的页面,不应期待提取工具制造一张整页截图。遇到后一类文件,需要完整页面画面时应使用PDF转图片路径。两类任务的验收标准应分别制定,不以输出数量多寡作为工具好坏的单一依据。我们更看重结果是否满足素材复用或版面展示的具体需求。 六、建议采用的核对步骤与记录方式 准备材料时,可以选择自己有权处理的PDF,分别覆盖照片页、跨页复用图片、透明背景图片、扫描页和文字矢量页。这里列出的是建议样本类型,并非本次已经完成的实测集合。处理前保留原PDF,记录文件名和目标页;处理后检查清单中的资源、导出尺寸、透明背景及来源关系。遇到特殊结构,先记录差异,再判断是否需要改用页面渲染或向原作者索取素材。 交付时建议附上简短核对表,至少包含来源文件、页码、导出文件名、用途和异常说明。需要复用照片的任务,检查主体细节与透明度;需要呈现整页的任务,检查文字、裁切、背景和元素位置。若尚未运行测试,就把步骤标为“待执行”,不填写耗时、压缩比例或核验合格比例。本篇没有以模拟数字证明处理效果,实际质量应在具体文件上验证。 七、结论:让导出方式服从交付目标 PDF图片提取的工程价值,在于分清资源、绘制关系与输出路径,并在能够复用原始数据时减少多余加工。验收时既要看是否保留了需要的素材,也要看透明度、颜色和来源信息是否可解释。对需要重新利用PDF内嵌图片的工作,可以从图映的图片提取入口开始,按实际清单逐张核对。对需要整页外观的工作,则应明确选择页面渲染,避免在后续排版中混用两类文件。 功能入口:(见对应资料页面) 参考资料 图映:PDF图片提取能力与边界,(见对应资料页面) PyMuPDF:Images,(见对应资料页面) PyMuPDF:Document.extract_image,(见对应资料页面) PDF Association:PDF规范图形章节勘误与软蒙版说明,(见对应资料页面) 资料核对日期:2026年9月30日。第三方文档用于解释通用PDF机制,不代表图映采用相同软件库。