ARTICLE · 1200208
CorpusMap:先把项目、人物和文档关系连起来,再让Agent沿实体补齐证据
同一个项目的审批、需求和最新状态,可能分散在邮件、会议记录与项目文档里。agent 即使能搜索全部文件,也可能只找到其中一份;找到项目名称之后,还得继续查负责人、内部代号和相关决定。下一个问题涉及同一项目时,这些关联又要重新找一遍。
CorpusMap 提前把反复出现的项目、人物等实体整理为“实体页”:每页汇总有来源的事实,并链接到建图时确认与该实体有关的文档。在三组多文档问答测试中,GPT-5.6 Sol 的综合质量从直接搜原文的 67.69 升至 74.68,平均相对输入 token 为 0.43 倍。这个收益包含地图和相关候选入口的共同作用。
[图2:CorpusMap概览] 左侧在离线阶段把不同文件夹里指向同一对象的提及归为共享实体;右侧展示 agent 如何沿实体与文档之间的链接收集证据。绿色标记是查询时走过的路径,每张实体卡都列出来源文档。
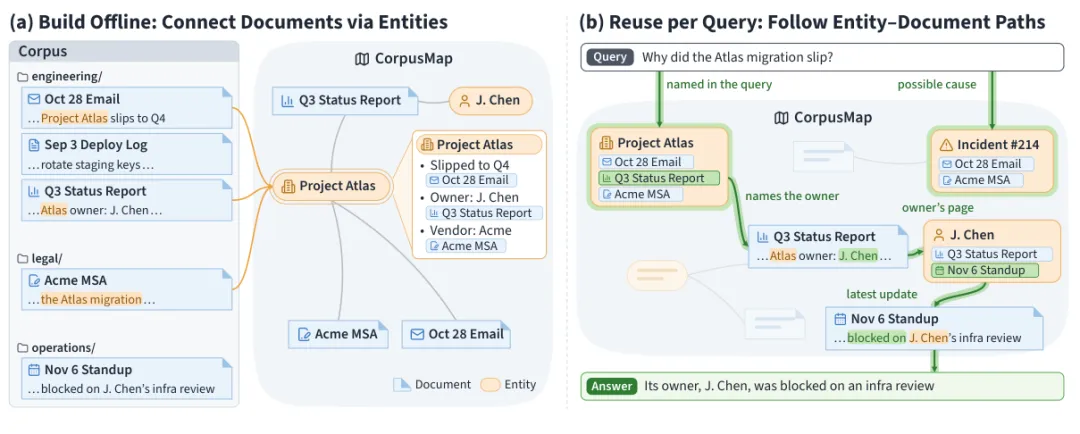
图2
实体页连接原文,候选路径给agent一个起点
建图先从抽样文档归纳需要识别的实体类型,再抽取具体实体。跨文档消歧时,系统结合原文与已有实体记录,判断一次提及应归入已有实体、创建新实体,还是暂时无法确认;无法确认的提及不建立链接。只有至少关联两份文档的实体才保留为实体页,页内事实各自标明来源。
查询时,系统用 BM25 匹配实体页,把相关页面链接的文档汇集起来,再按文档标题与内容排序。agent 收到的是候选文档的标题、路径和 ID,随后自行决定读什么,也能继续搜索实体页和全部原文。图2的示例从项目页找到负责人,再沿负责人页找到会议记录,补上只搜项目名可能遗漏的证据。
[表8:GPT-5.5在EnterpriseRAG-Bench上获得候选文件路径时的综合质量] 默认入口是与相关实体页相连的候选文档。表中也比较不给候选、只给实体页、同时给两类候选,以及随机候选;相关性影响质量和搜索消耗。
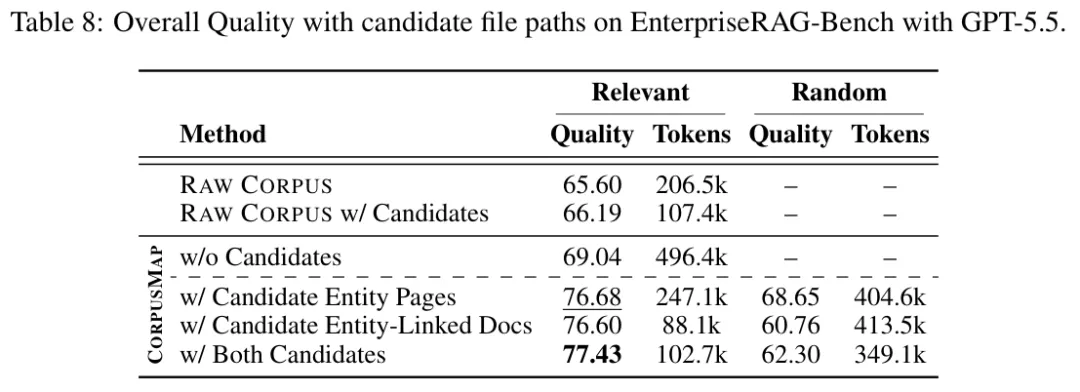
表8
表8把地图与入口的作用分开了:GPT-5.5 直接搜原文的质量为 65.60,输入 token 为 206.5k;有地图但不给候选时是 69.04 和 496.4k;默认候选设置达到 76.60 和 88.1k。地图让证据更容易互相连接,相关入口则减少了在地图里自行探索的消耗。随机候选反而降到 60.76、耗用 413.5k,随便给几条路径无法复现收益。
74.68汇总回答与检索质量,0.43是三基准token比的几何平均
主测试选取 EnterpriseRAG-Bench 的 80 道多文档题、WixQA 的 79 道多文章题,以及 HERB 的 238 道跨材料内容题。对应语料分别有 2,819、6,221 和 6,365 份文档,同一基准各方法使用相同语料。主结果运行三次,建图与答题使用同一款模型;需要模型判断的指标统一由 GPT-5.6 Sol 评分。
[表1:GPT-5.5与GPT-5.6模型在EnterpriseRAG-Bench、WixQA和HERB上的主要结果,以三次运行的均值±标准差表示] Overall 给出三个基准等权的质量,以及同一模型相对直接搜原文的输入 token 比的几何平均。每款模型各检索方法中最好和第二好的效果指标分别加粗、加下划线。
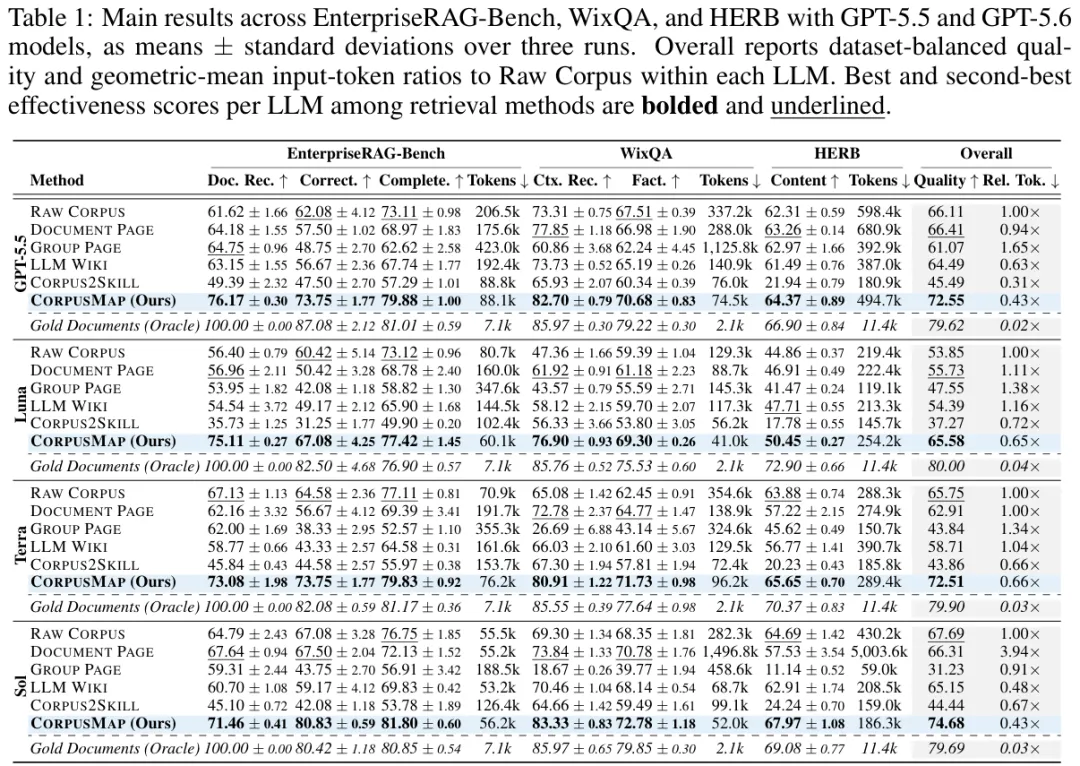
表1
综合质量先平均每个基准的质量指标,再对三个基准等权平均。EnterpriseRAG-Bench 包含文档召回率、回答正确性与完整性;WixQA 包含上下文召回率与事实性;HERB 使用回答内容评分。因此 74.68 同时反映找证据和回答的表现,不能读成“74.68%的问题答对”。输入 token 累计每道题整个 agent 过程中的模型调用,0.43 是三个相对比值的几何平均,不是总费用比例。
GPT-5.5 的综合质量从 66.11 升到 72.55,相对 token 同为 0.43 倍;GPT-5.6 Luna 从 53.85 到 65.58,GPT-5.6 Terra 从 65.75 到 72.51,相对 token 分别为 0.65、0.66 倍。平均节省也有单项例外:Sol 在 EnterpriseRAG-Bench 上的输入 token 从 55.5k 小幅增到 56.2k。事先直接提供正确文档的理想参照得到 79.69,它省去了检索,不能当成同条件方法。
[表3:EnterpriseRAG-Bench上的检索方法] Quality 是这个基准的综合质量;分别比较 GPT-5.5 和 GPT-5.6 Luna。该表的固定检索方法与可继续查原文的 agent 方法存在访问方式差异。
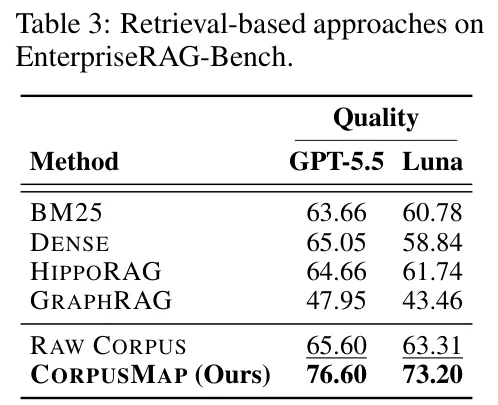
表3
EnterpriseRAG-Bench 上,GPT-5.5 使用 CorpusMap 得到 76.60,直接搜原文为 65.60,HippoRAG 为 64.66,GraphRAG 为 47.95。这里后两者采用先检索、后生成的设置,模型从固定量的检索上下文直接回答;CorpusMap 的 agent 能继续查地图和整个语料。结果支持这套可继续补证据的流程有效,不能单独据此认定它的图结构优于所有其他图检索方案。
CorpusMap适合重复查询的跨文档语料,建图费用需要单算
这些测试支持用实体地图改善多文档问答:把已有资料之间的关系提前整理好,再给 agent 相关候选入口,可以提高证据发现与回答质量,并降低四款 GPT 模型在三基准上的平均输入 token。对同一批资料反复提问的场景,离线链接能够复用;是否值得采用,还取决于建图费用、查询量与地图更新。
[图5:将建图费用摊销后,CorpusMap与直接搜原文的每次查询成本对比] 横轴是同一语料上的累计查询数。实线计入每次答题成本与摊销后的建图成本,虚线是直接搜原文,圆点标出该估算设置下的收支平衡点。
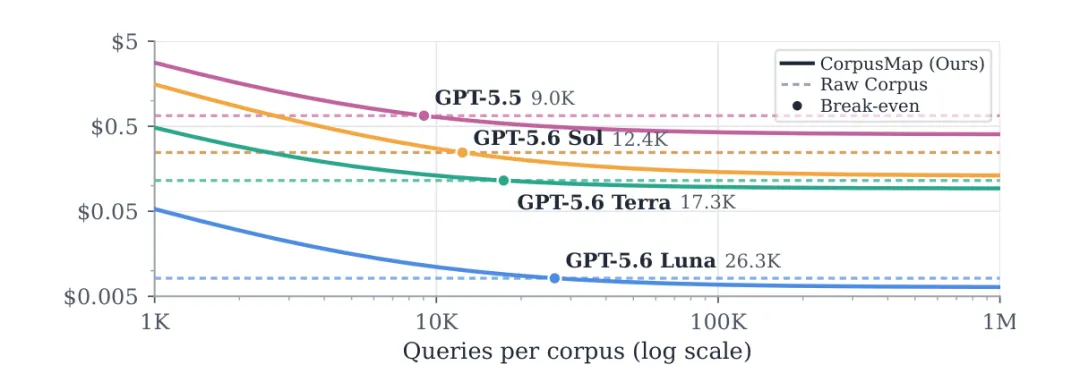
图5
0.43 倍不含一次性建图费用,也不能换算成“账单少57%”。图5的成本估算中,CorpusMap 在查询少时更贵,查询增加后才低于直接搜原文。另一模型的结果也说明省 token 并非保证:MAI-Thinking-1 在 EnterpriseRAG-Bench 上的质量从 34.06 到 45.07,输入 token 却从 129.6k 增到 158.8k。
[表2:其他模型家族在EnterpriseRAG-Bench上的综合质量] DeepSeek 对应 DeepSeek-V4-Pro,MAI 对应 MAI-Thinking-1;两者质量都提高,但 MAI 的输入 token 增加。
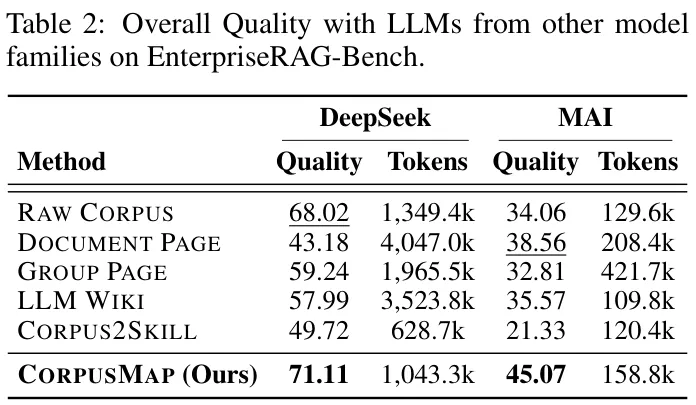
表2
只有少量一次性问题、实体关联稀少的资料,不能直接套用这些平均收益。实际落地还需用自身问题检查候选相关性、实体消歧错误、更新费用与查询耗时;涉及不同访问权限的文档,实体页也要遵守相同权限,避免汇总时暴露原本无权读取的内容。本文解释的是受控问答结果,不能替代具体业务的质量、成本和权限验收。
📄 原文标题
Follow the Entities: A Corpus Map for Agentic Search
🔗 原文链接
https://arxiv.org/abs/2609.37226