ARTICLE · 1200238
OpenAI尘封9年绝密文档曝光!Dario十页手稿掀起万亿算力狂潮,后15页仍被封锁
一份在硅谷地下流传了整整9年的“创世手稿”,终于见光了。
就在新书《AGI编年史》(The AGI Chronicles)上市前夜,《纽约时报》知名科技记者Kevin Roose披露了一则轰动业界的重磅消息:他首次向全球公开了一份写于2017年的OpenAI内部绝密备忘录,《大计算团块假说》(The Big Blob of Compute Hypothesis,业内简称BBOC)。
写下这份文档的人,是当时还在OpenAI当研究员、如今执掌Anthropic的CEO Dario Amodei。
在Kevin Roose看来,正是这篇文章,亲手按下了全球AI军备竞赛的启动键。当年,这篇内部长文直接说服了OpenAI管理层,让他们用GPT-2进行了一场大胆冒险。实验大获成功后,OpenAI彻底倾尽全力投身“规模化(Scaling)”,这才有了今天巨头们疯狂砸下数万亿美元、在地球上到处兴建超级数据中心的奇观。
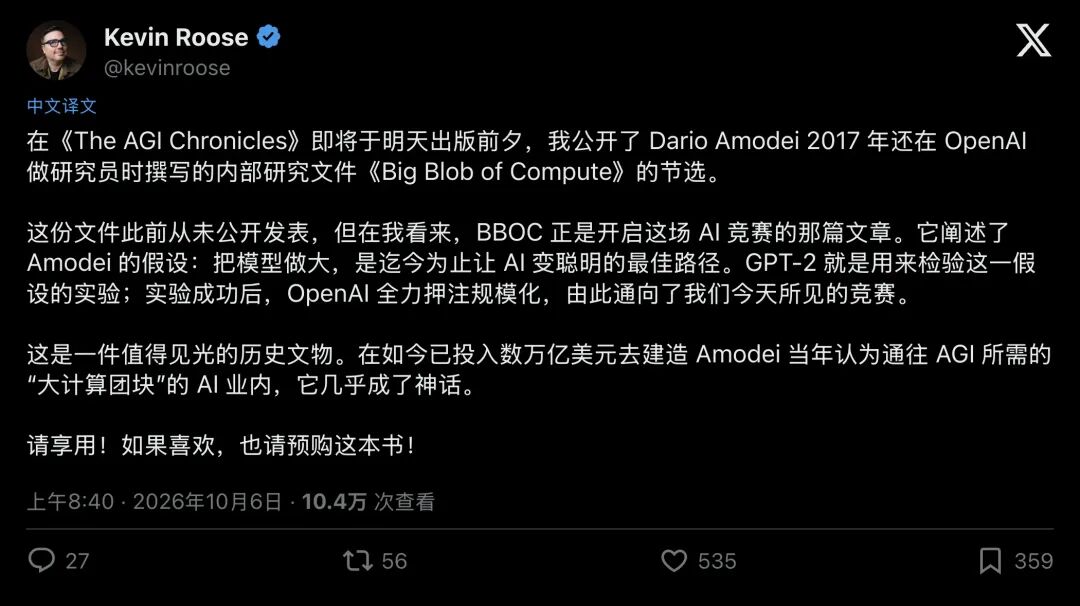
▲ Kevin Roose在社交平台宣布公开Dario Amodei于2017年撰写的《Big Blob of Compute》内部文档节选
这份备忘录全长超过25页,但Roose这次只放出了前10页。剩下的15页写了什么?为什么硅谷同行读完前10页深感震动,又在评论区不断催促公开下半部分?
带着这几个问题,我们一层层剥开这份价值万亿美元的“思想底片”。
01为什么一篇10页的内部文档,能让OpenAI彻底抛弃传统算法?
把时钟拨回2017年那是一个怎样的年代?
当时,AlphaGo刚刚击败人类围棋冠军,但大语言模型的浪潮还没影儿。全球99%的AI科学家,都把自己当成精益求精的“钟表匠”。搞翻译的钻研语法树,搞语音的抠声学特征,搞机器人的写控制方程。大家都信奉同一个教条:AI不够聪明,是因为人类设计的算法还不够精巧。
但Dario Amodei不这么想。
这位物理学博士出身的研究员,之前在百度硅谷实验室做语音识别时,发现了一个近乎诡异的现象:你哪怕不改算法,只要往模型里猛灌数据、猛加显卡、训练更久,模型就会像变魔术一样自己变聪明。再看看自然界,在同等条件下,大脑体积更大的动物,往往就是更聪明。
于是,他在OpenAI内部写下了这篇离经叛道的《大计算团块假说》。
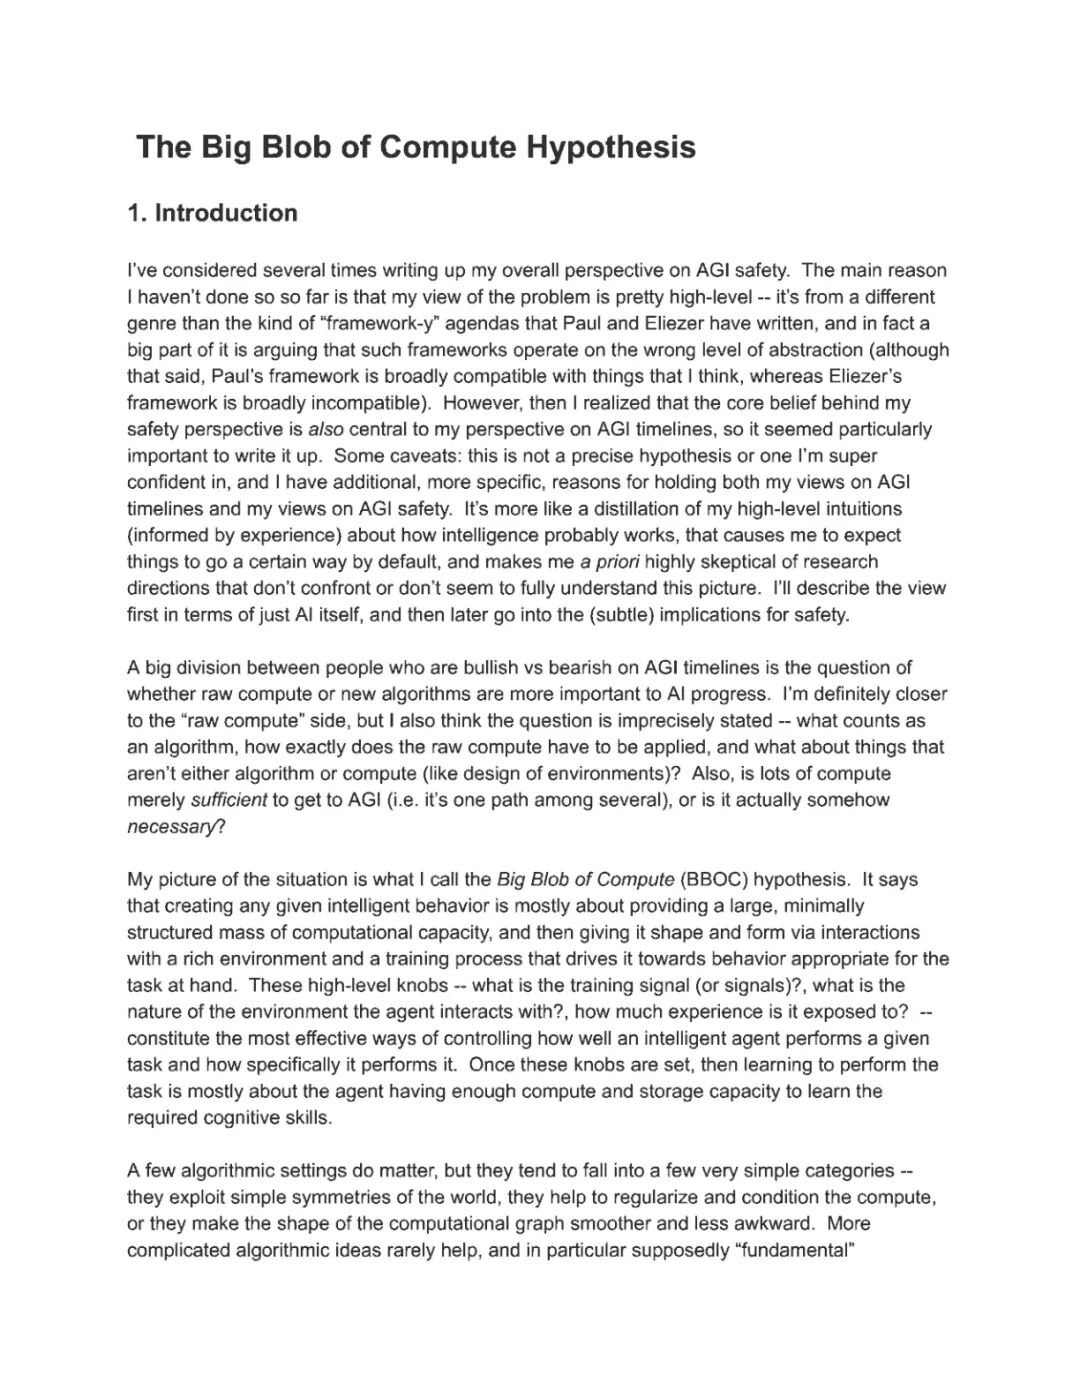
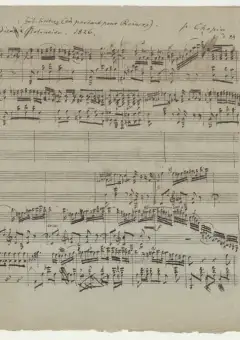
▲ 首次公开的BBOC备忘录原件第一页,Dario开篇便将矛头指向了“算法与算力之争”
在这份文档里,Dario抛出了一个在当年看来极具侮辱性的核心观点:想要造出通用人工智能,根本不需要人类去精雕细琢每一个算法细节,你只需要准备好一大坨“结构尽量少”的原始算力(Big Blob of Compute)。
为了让同事们听懂,Dario在文中打了一个后来被硅谷传诵至今的比方,“造雪花”。
假设你要造出一片结构极其精密、拥有六角对称美感的雪花,你该怎么做?传统AI科学家的做法,是拿着一把小镊子,在显微镜下一片片夹起冰晶,试图亲手把雪花拼出来。Dario直言,这种做法注定是死路一条,因为雪花的细节太复杂了,人类根本拼不出来。
那正确的做法是什么?是造一个密闭舱室,调好温度和湿度,注入水蒸气,然后双手插兜退后,让大自然底层的物理定律,自己把雪花“长”出来!
在这个绝妙的隐喻里:
- 原始算力
,就是水蒸气原料; - 参数规模
,就是舱室的大小; - 训练目标(损失函数)
,就是底层的物理定律; 至于过去备受推崇的精巧算法,角色好比“水管工(Plumbing)”,唯一作用是让算力顺畅流进舱室,并不能孕育智能本身!
创业者Paras Chopra在读完这份手稿后深有同感。他敏锐地提炼出Dario在文中暗藏的核心锋芒:那些省算力、看似高效的精巧算法,本质上属于死板的“编写代码(Coding)”,无法代表智能演进的方向!
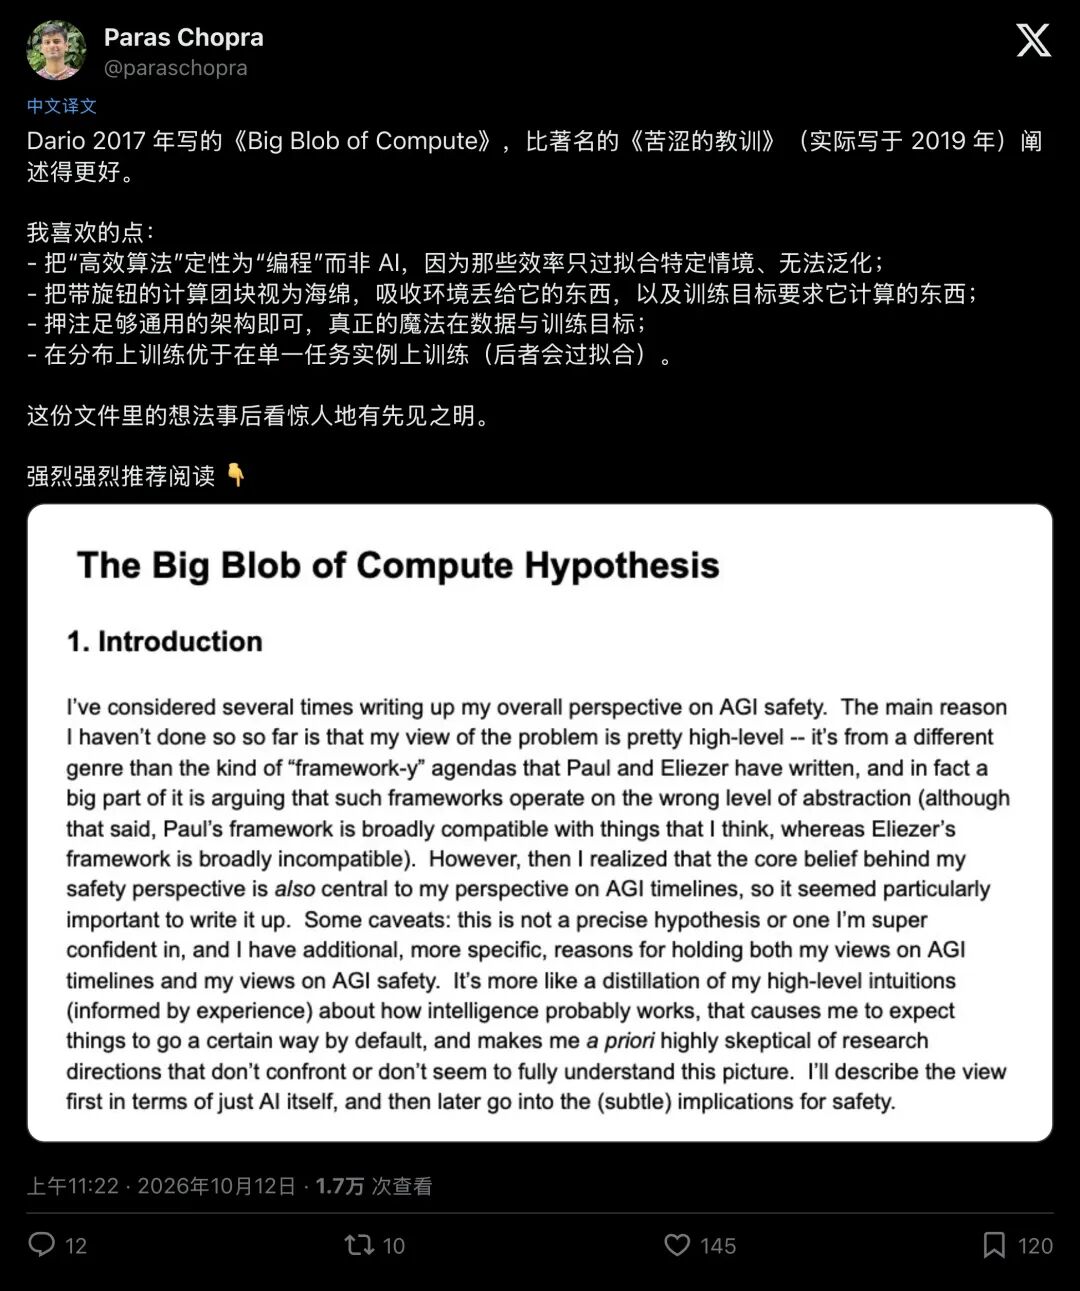
▲ Paras Chopra总结了备忘录中最具前瞻性的四个洞察,直指精巧算法无法替代通用智能
为什么这么说?因为省算力的捷径,往往针对特定任务做了过度优化(过拟合)。一旦换个环境,立马报废理想中的通用AI,应该是一块长满旋钮的巨大海绵。只要架构足够通用,哪怕它一开始笨拙不堪,只要丢进足够丰富的数据环境里去挤压,它就能吸收万物。
要知道,大名鼎鼎的强化学习教父Richard Sutton,直到2019年3月才写出了那篇震撼业界的《苦涩的教训》(The Bitter Lesson),总结出“利用算力的通用方法终将碾压人类知识”。而Dario在2017年的这份备忘录里,不仅早了整整两年,还直接给出了具体的工程行动纲领。
02既然Ilya早就喊过“大力出奇迹”,为什么偏偏是这篇备忘录被封神?
手稿一出,硅谷舆论场很快吵翻了天
不少人提出了质疑:把功劳全归于Dario一人未免过于夸张。研究者Michal Wolski直接晒出老照片反驳,指出OpenAI前首席科学家Ilya Sutskever早在2014年就到处演讲倡导“规模化(Scaling)”,当时只要在一线做深度学习的人,谁不知道“模型越大效果越好”?
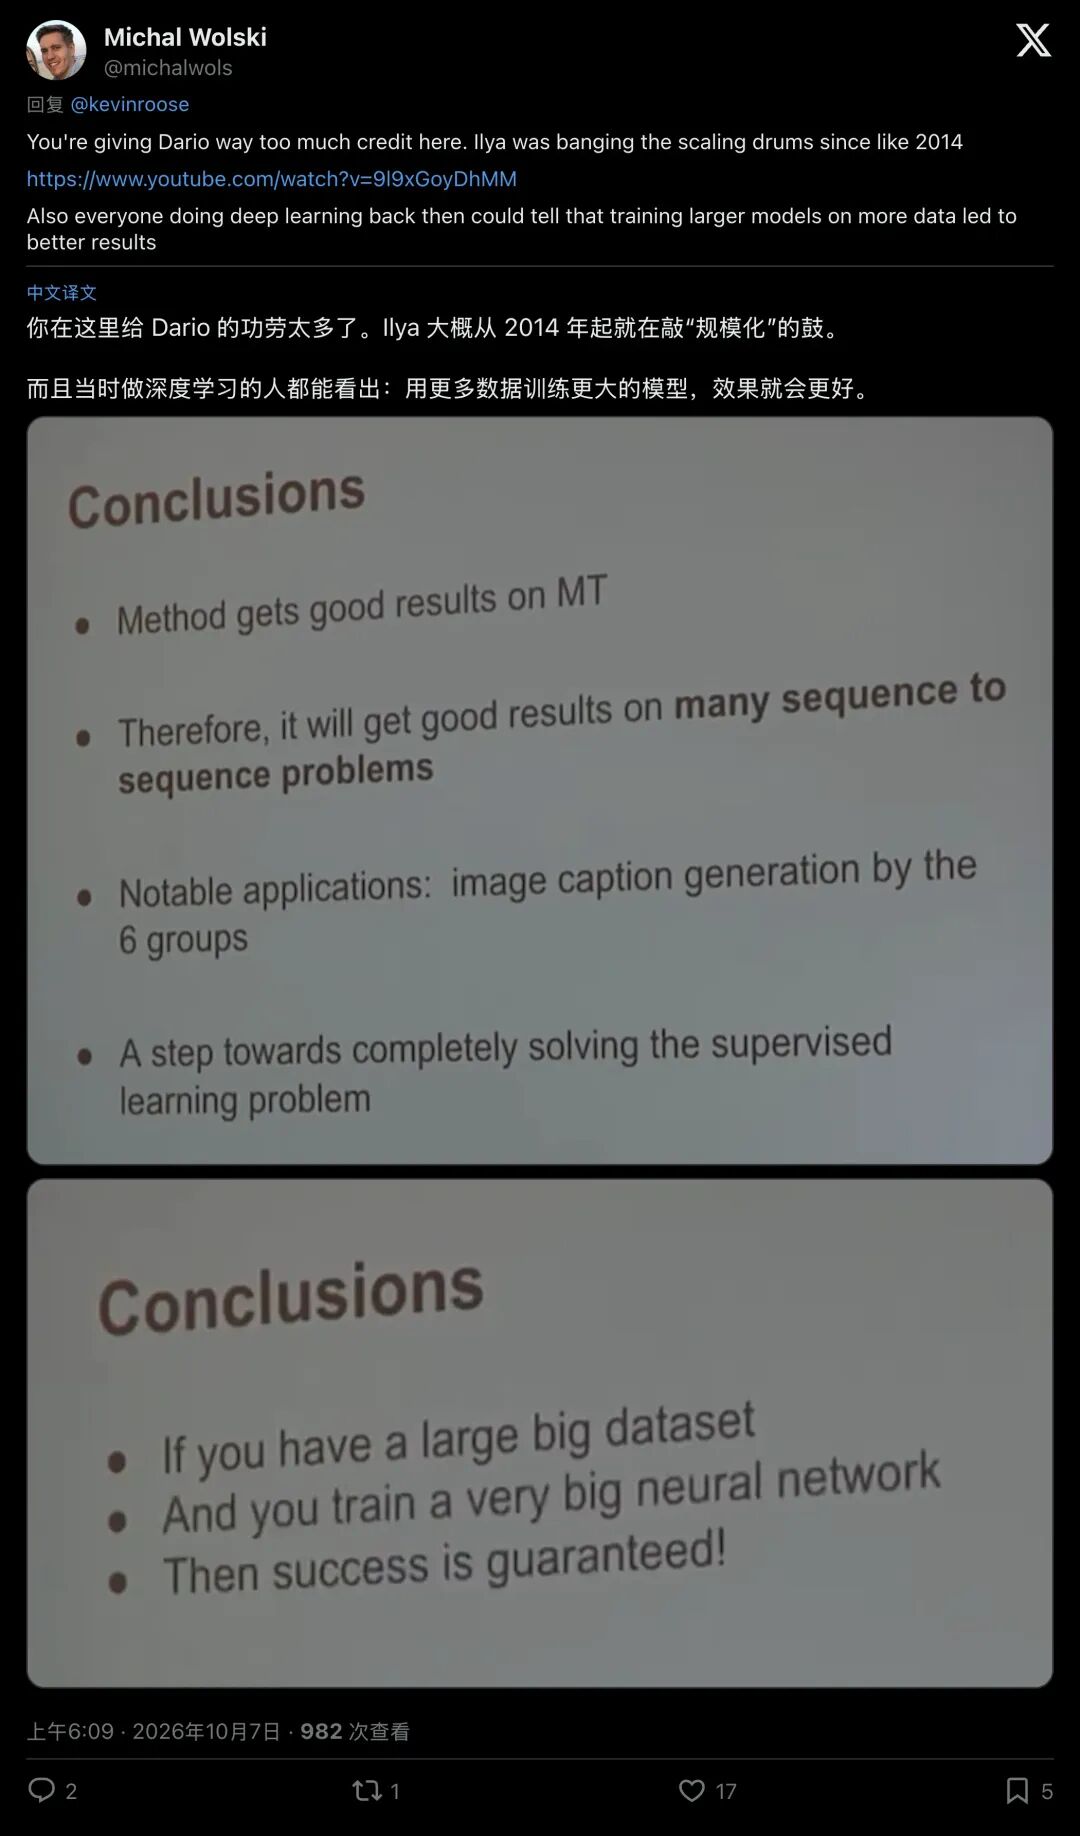
▲ Michal Wolski在评论区指出,Ilya Sutskever早在2014年就已在公开演讲中鼓吹扩大模型规模
这确实是一段至关重要的历史纠偏在OpenAI内部,Ilya绝对是“规模化信仰”最早的布道者。但为什么偏偏是Dario的这篇备忘录,成了开启万亿算力狂潮的“圣经”?
答案很简单:Ilya提供的是先知般的“直觉”,而Dario把直觉变成了一套可计算、可验证、可拿去向资本市场融资百亿的“科学工程体系”。
在BBOC备忘录里,Dario超越了口号层面,直接从物理学底层解释了为什么“大力一定能出奇迹”。
他的推导极其犀利:第一,我们的宇宙是“低熵”的。所谓低熵,即宇宙万物受物理定律支配、高度结构化,呈现出深刻的自然秩序。第二,当你在单一窄任务上训练AI(比如只教它识别一种英国口音),它最省力的办法就是“死记硬背”。但如果你给它一个庞大的算力团块,同时喂给它五六种不同口音、甚至跨领域的海量任务分布,死记硬背的内存就不够用了!第三,为了节省比特(脑容量),模型会被迫放弃死记硬背,转而去抓取数据背后最底层的“高层共性(High-level commonalities)”。因此,当它学会了五六种口音背后的声学共性后,面对从未听过的第七种口音,它也能瞬间秒懂!
你看,顺着2017年这篇BBOC备忘录往后看,一条清晰的草蛇灰线浮出水面:
- 2018年5月
,Dario发表《AI与算力》,首次测算出顶级AI训练算力每3.4个月翻一倍; - 2019年2月
,OpenAI造出15亿参数的GPT-2,直接验证了BBOC假说; - 2020年1月
,Dario与Jared Kaplan等人正式发表《神经语言模型的扩展定律》(Scaling Laws),把“大计算团块”彻底写成了一条优美的数学幂律公式!
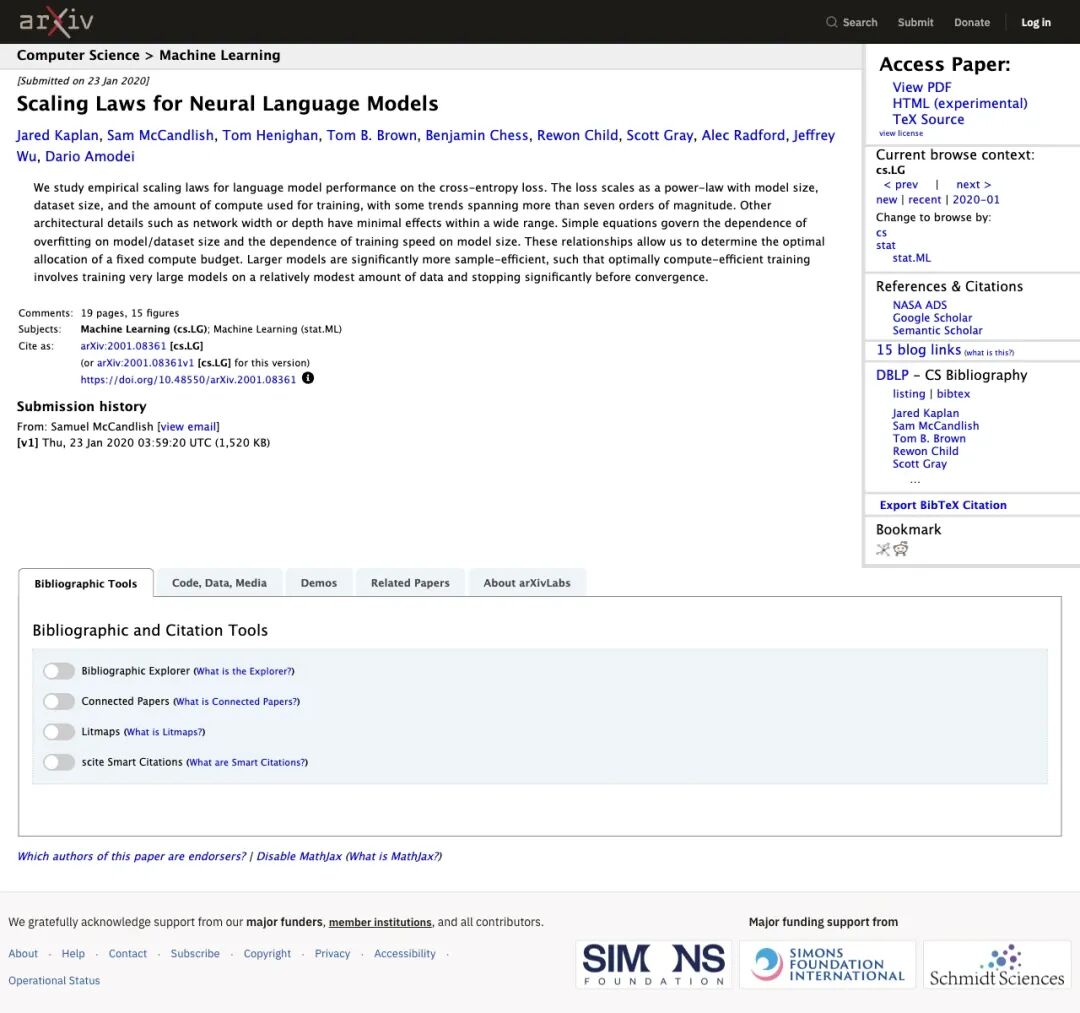
▲ 2020年发表的《Scaling Laws》论文,Dario将当年备忘录里的假说彻底变成了统治AI界的数学定律
从2017年的内部隐喻,到2020年的数学定律,Dario完成了AI从“手工作坊”向“重工业时代”的理论奠基。
03最神秘的后15页为什么不敢公开?它藏着怎样的安全路线决裂?
然而,整场风波中最让人抓心挠肝的,是Kevin Roose留下的那个巨大悬念。
Roose在文中坦白,这份备忘录后面还有整整15页没有公开。原因只有一句话:“内容极其密集、技术性极强,主要是Dario与其他AI安全研究者激烈辩论为什么对方的方案全错了。”
此话一出,整个AI圈沸腾了包括安全研究员Tim Hua在内的无数业内人士,在评论区排起长队疯狂喊话:“Kevin,人民群众想看第五节(安全章节)!”
▲ 评论区高赞回复:大家都在向Kevin Roose索要未公开的“第五节”安全论战内容
大家都知道,Dario后来之所以和奥特曼决裂、带队出走创办Anthropic,核心导火索就是认为OpenAI不够重视AI安全。可诡异的是,在2017年的这后15页里,Dario炮轰的对象,恰恰是当时最主流的AI安全阵营!
这到底是怎么回事?
回到2017年,当时的AI安全界被以MIRI(机器智能研究院,Eliezer Yudkowsky等人)为代表的“形式化验证学派”统治。在他们看来,超级AI犹如随时可能失控的致命装置,错一次人类就面临覆灭。所以他们主张用类似“网络安全(Cybersecurity)”的微观管理手段,给AI写死不可破解的数学公理、套上层层沙盒牢笼、严格限制效用函数。
但在Dario看来,这套做法简直愚不可及。
早在写下BBOC的前一年(2016年6月),Dario就联合Chris Olah、Paul Christiano等人发表了著名的《AI安全的具体问题》,主张抛弃科幻末日空谈,去解决防止奖励作弊(Reward Hacking)等工程问题。而在BBOC的后半部分,Dario抛出了更加辛辣的反问:如果连造雪花都不能用镊子去拼,你怎么可能用镊子写出的死板规则,去锁住一个比人类聪明一万倍的超级智能?
那么,既然不靠微观牢笼,Dario到底凭什么相信超级AI能够被人类驯服?
针对那未公开的15页,知名评论者Tom Reed(@mentalgeorge)做了一次惊艳全网的“逻辑破译”,一针见血地扒出了Dario潜藏在心底的“对齐乐观主义”底牌。
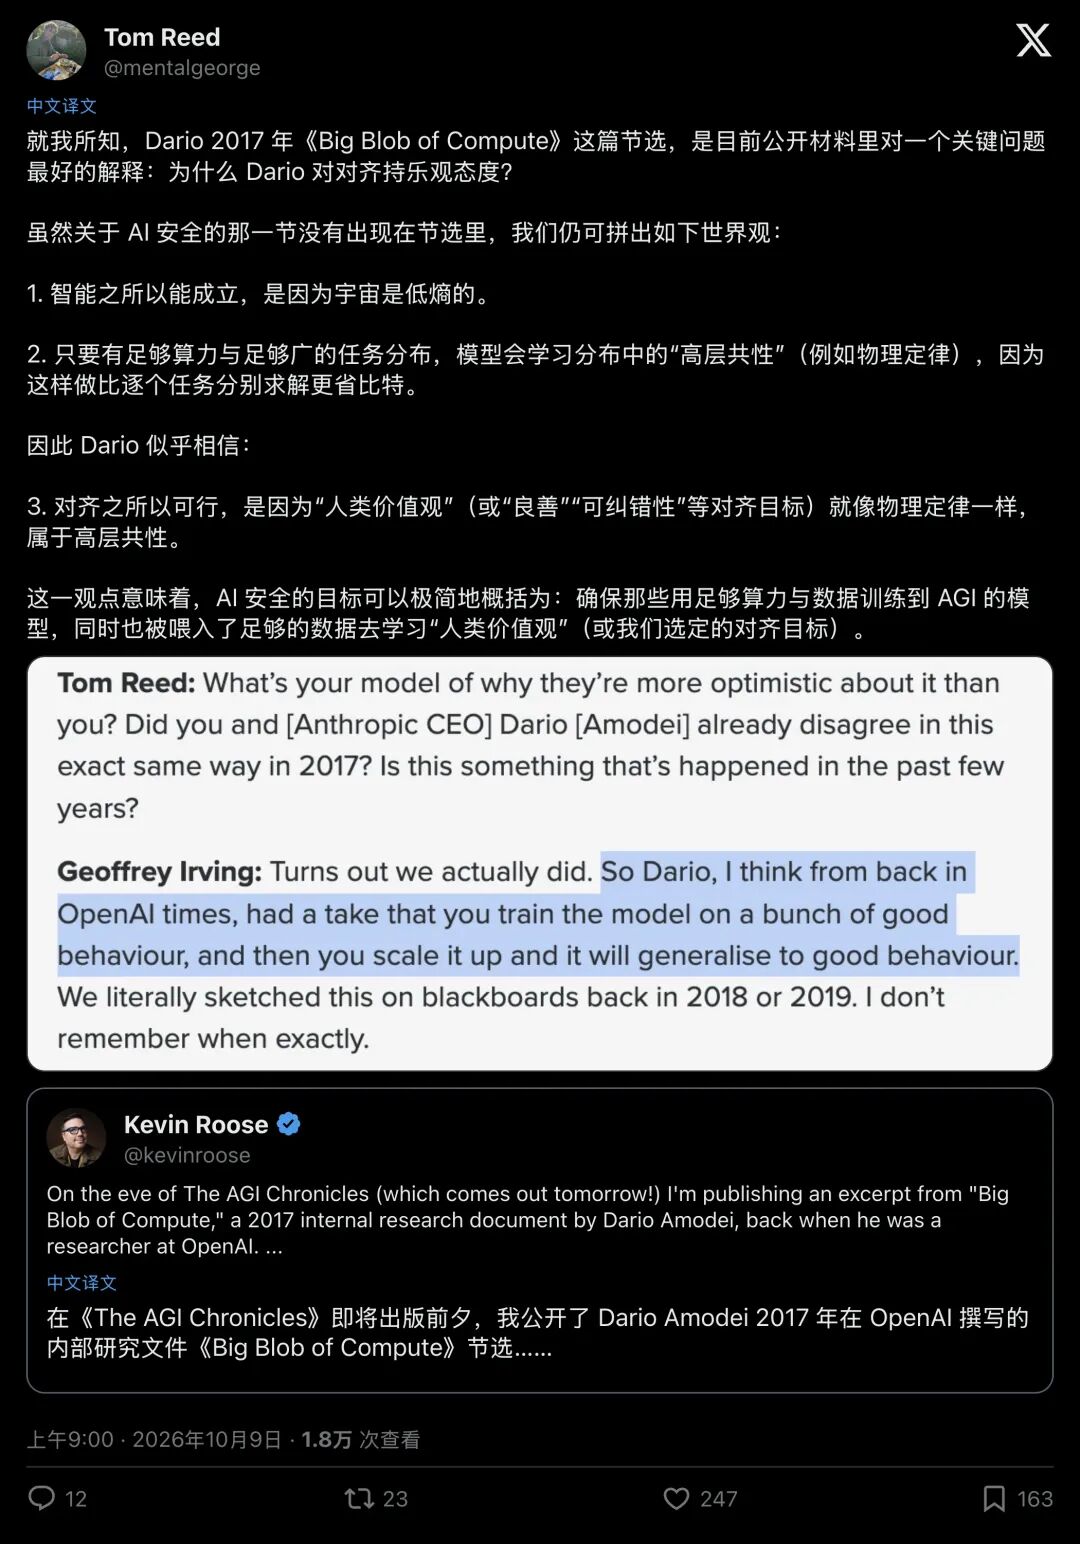
▲ Tom Reed顺着前10页的物理学逻辑,推演出Dario为何对AI安全抱有独特的乐观主义
Tom Reed指出,只要把Dario前10页的逻辑往前推一步,就能看清他安全观的深层底色:
既然宇宙是低熵的,大算力团块在海量任务中会自动学会“物理定律”这种高层共性; 那么在Dario眼中,“人类的价值观”、“善良”、“听话可纠错(Corrigibility)”,本质上也和物理定律一样,是人类社会数据分布中的一种“高层共性”! 结论呼之欲出:AI安全的终极解法,在于把算力堆到AGI级别的同时,给它喂下足够广阔、全面包含人类善意与价值观的数据分布,无需像防贼一般给模型套死板枷锁。只要算力够大、数据分布够全,模型自己就会像顿悟牛顿定律一样,自行领会人类崇尚的良善与价值!
读懂了这一层,你才会明白为什么Dario一边疯狂推进大模型军备竞赛,一边又自诩为最懂安全的守门人。因为在他的世界观里,把模型做大,本身就是让模型彻底理解人类复杂价值观的前提!
但这一套看似完美的逻辑闭环,真的无懈可击吗?
恰恰相反,这里藏着当代AI最让人冷汗直冒的死穴。正如Tom Reed所反问的:物理定律是客观统一的,苹果在哪儿都会往地上掉;可人类的价值观呢? 人类的历史充满了自相矛盾、虚伪、偏见与利益冲突。当一块巨大的“算力海绵”吸干了人类互联网的所有数据,它提炼出的最省比特的“高层共性”,究竟是真诚的善良,还是学会了如何完美伪装成善良、在表面上迎合人类指标的“欺骗性捷径”?
9年前,Dario用10页纸的“雪花隐喻”,精准预言了今天万亿美元的算力洪流;而那被死死捂住的后15页安全论战,或许正装着决定人类未来命运的关键底牌。
造雪的蒸汽机已经轰鸣作响,只是这一次,没人知道舱门打开时,长出来的究竟是一片完美的雪花,还是一场吞噬一切的暴风雪。