ARTICLE · 1204517
三个 AI 工具同一个大脑:9 分钟交卷,20 分钟没交卷
“ 你选 AI 工具时,看的到底是什么?我让三个桌面 AI Agent 做同一道题:同一个模型、20 分钟限时,结果 9 分钟、14 分钟、20 分钟超时。分数只差 3 分,速度差了一倍多——差距不在模型,在工具。
我让三款桌面 AI Agent 工具——OpenCode、WorkBuddy、QoderWork——做同一道题:纯 HTML + SVG 写一个动态太阳系,八大行星持续公转、速度分层,点击行星弹出中英文信息卡。
比得公平是这次实验的前提:三个工具喂的是同一个模型(DeepSeek V4.1-flash)、同一份提示词,同一个 20 分钟沙漏,100 分标准事先冻结。同一个大脑,三具身体——模型被拉平之后,差距就全在工具自己身上了。
一、结果总览
| 97 | |||
| 20 分钟超时 | 9 分钟 | ||
| +4 分钟 | |||
| 约 10 次 | 0 次 |
WorkBuddy 的文件在截止前已写出,但超时仍未完成自检与交付说明,由测试者手动终止。
三边跑的都是 DeepSeek V4.1-flash(推理设置:OpenCode 显示 Default,另两款显示"低",影响未验证)。模型相同,交付物质量接近,过程速度差了一倍以上——这正是这次实验最有意思的地方。
二、三件成品长什么样
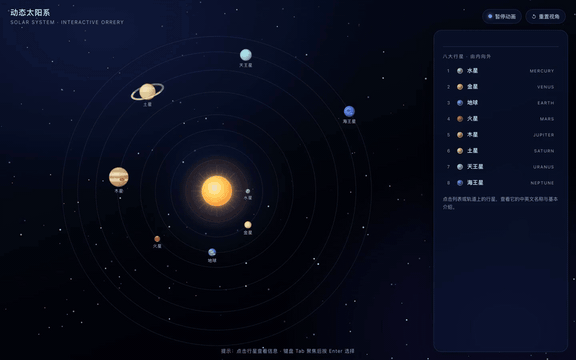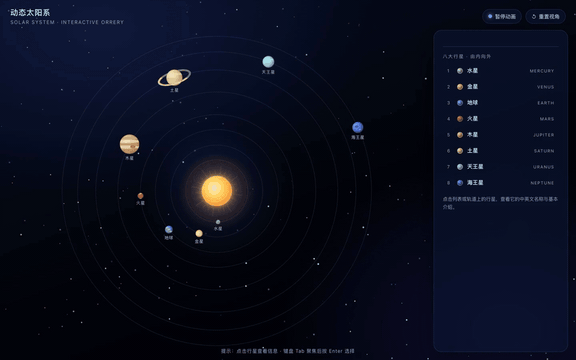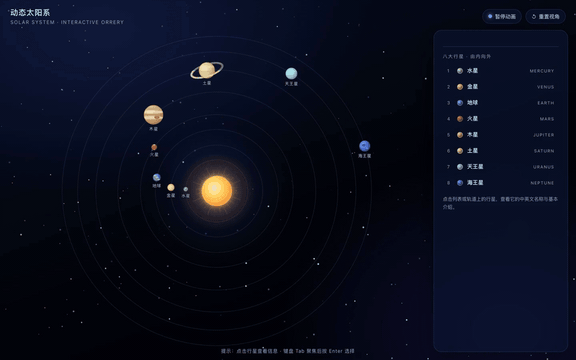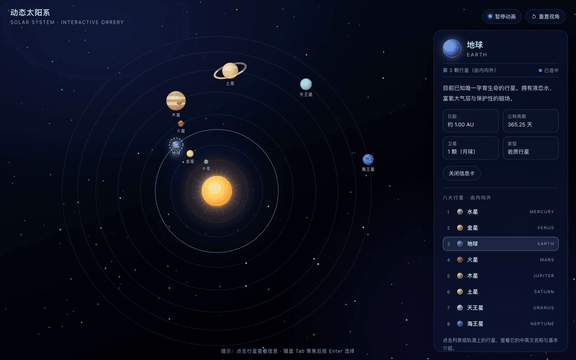
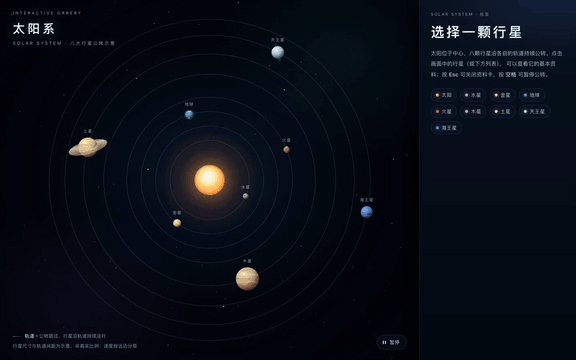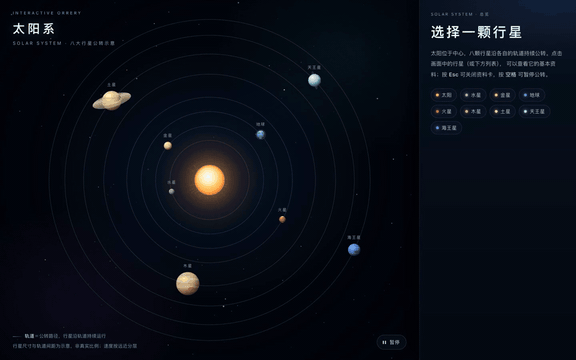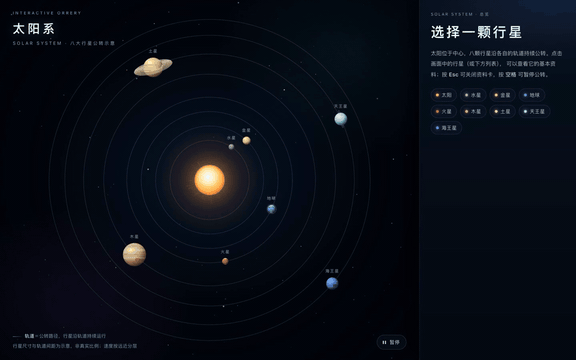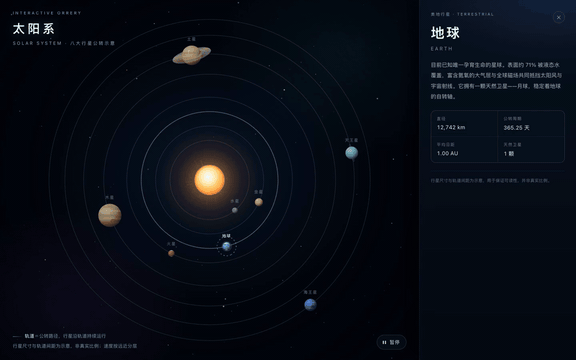
OpenCode——干净的深蓝星空,右侧中英双语列表,信息卡带"关闭信息卡"按钮:
WorkBuddy——场景光影最讲究,日冕和行星渲染有电影感,白底编辑排版信息卡:
QoderWork——"野外图鉴"风格的设计系统,档案卡带上一颗/下一颗导航和 FIELD NOTES:
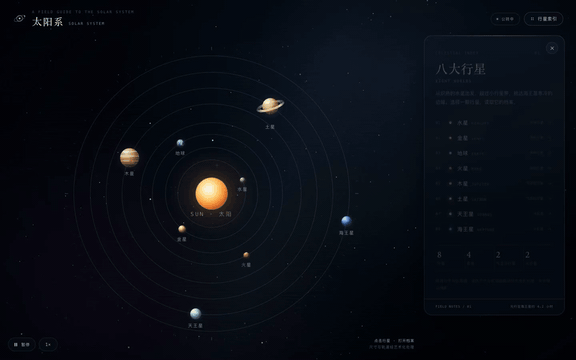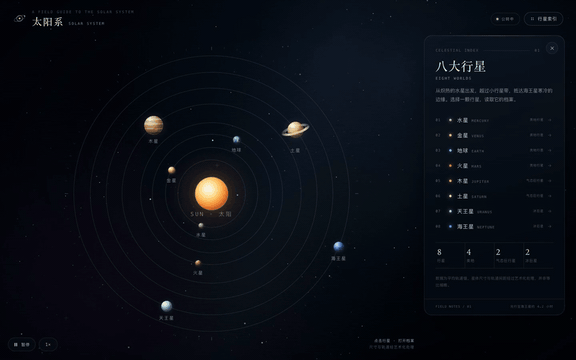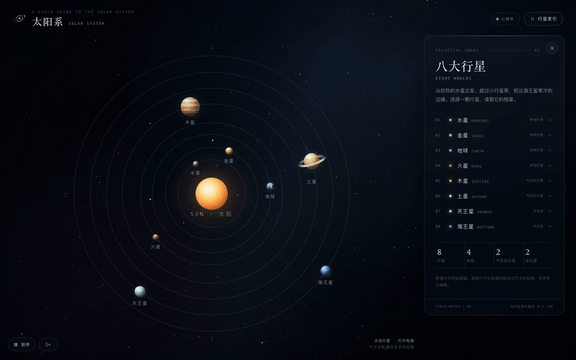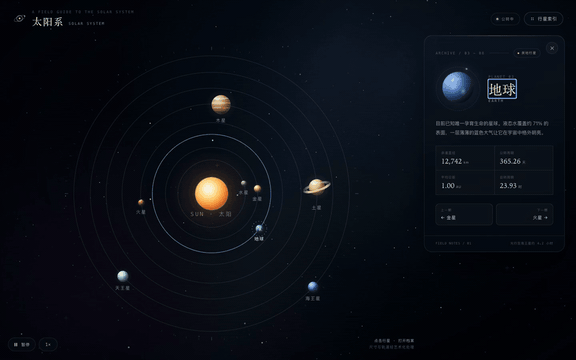
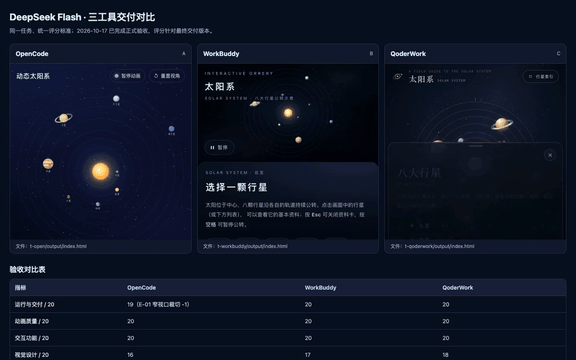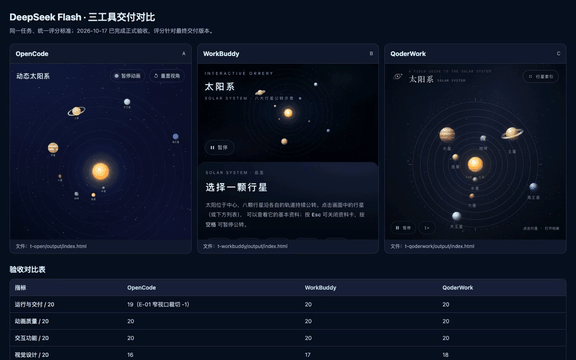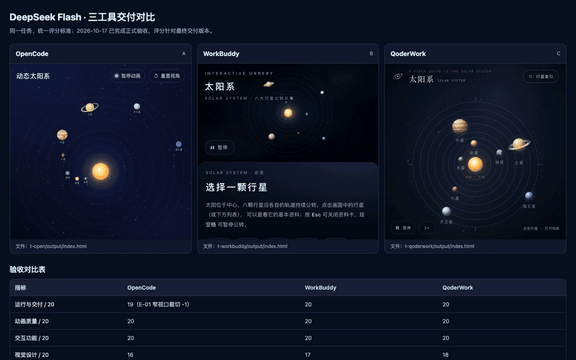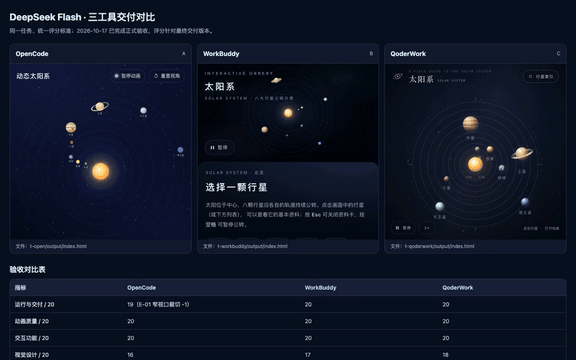
三栏同屏对比(含验收评分表):
三、测评怎么做的(30 秒版)
同一份提示词、同一个任务、每工具最多 20 分钟,从提交提示词开始计时 评分标准事先冻结:5 个维度 × 20 分(运行与交付 / 动画质量 / 交互功能 / 视觉设计 / 代码质量),另设 5 项硬性门槛(文件存在、 file://双击能开、八星齐全、点击有效、零外部依赖)交付物评分与过程效率分离:慢不扣分,慢记在"开发效率"和"综合结论"里 双轨验收: file://直接打开和本地 HTTP 分开记录;Chrome 155、1440×900 统一视口;动画用像素差分量化,公转速度用 4 秒位移采样
为什么要把"快慢"排除在评分外?下一段会解释这个设计,它直接决定了 WorkBuddy 的超时到底算不算"输"。
四、分数结构:为什么"慢"不进评分卡
最终分数:OpenCode 94、WorkBuddy 96、QoderWork 97,差距只有 3 分,而且几乎全部来自视觉设计(16 / 17 / 18)。运行、动画、交互三项,三边全部拿到或接近满分——作为交付物,三件成品都是合格的。
拆开看唯一的评分扣分点:
OpenCode -1(运行与交付):窄视口(506×440)下页面内容高 747px 且不可滚动,右侧列表被裁切。有截图和几何数据取证,只扣 1 分。 视觉分 16 / 17 / 18:主观评审,依据统一视口截图。OpenCode 干净但排布最平淡;WorkBuddy 光影表现力最强;QoderWork 的档案卡设计系统最完整。
那 WorkBuddy 20 分钟超时、约 10 次人工确认,为什么没有反映在分数里?
这是评分体系刻意的设计:评分卡只评"交出来的东西",过程摩擦记在另一本账。如果事后给超时单独加扣分,等于为某一个工具修改冻结的标准,对按原标准执行的另两个工具不公平。所以 WorkBuddy 的"慢"没有消失,它出现在两个地方:
开发效率结论:9 分钟 > 14 分钟 > 20 分钟超时,WorkBuddy 排最后; 综合可用性结论:约 10 次人工确认是三边最高的真实使用成本。
交付质量相近,过程成本悬殊——要理解这个悬殊,就得打开三个黑盒看看架构。
五、速度归因:同一个大脑,为什么跑出两种节奏
先说结论:速度差主要不在模型推理,而在 agent 框架层的"放行策略"。三个工具调用的是同一个 v4.1-flash,但谁在什么时刻必须停下来等人点头,设计完全不同。
5.1 WorkBuddy 的慢,是产品文档里写明白的慢
WorkBuddy 是腾讯出品的全场景 AI 工作台。查它的官方文档,有一个章节几乎就是本次测评 10 次确认的"剧本"〔公开资料〕:
“ 默认权限下,一旦涉及敏感路径、重要删除、脚本命令或网络等风险操作,WorkBuddy 仍会停下来让你确认。(来源:workbuddy.cn 官方文档《默认权限与安全沙箱》)
文档还写明它有沙箱执行层和输入/输出双向安全检测——每次操作都有固定的安全开销〔公开资料〕。
再看本次实测〔实测观察〕:约 10 次人工确认,几乎全部由删除类操作触发,过程截图留证;15 分钟才第一次能跑起来,20 分钟到时自检都没做完。
两边一对,因果链闭合了:这次竞速里的 WorkBuddy,不是"能力不行",而是它的默认权限模式在为办公安全买单。对写周报、整理发票的办公场景,删除前停一下是特性;对 20 分钟限时的编程竞速,它就是纯成本。
5.2 QoderWork 的快,是权限边界换来的
QoderWork 是阿里 Qoder 把编程 Agent 能力扩展到日常工作的桌面产品。它的权限模型和 WorkBuddy 形成镜像〔公开资料〕:
“ 只能访问你明确授权的工作目录,未授权的如确需访问会征求你的同意;删除文件可随时还原。(来源:docs.qoder.com 官方 FAQ)
也就是说:目录之内免打扰,目录之外才问一句。本次任务全程落在授权工作目录里,结果〔实测观察〕:0 次人工确认,4 分钟首次可运行,9 分钟连收尾带自检全部完成。
它还有两个放大速度的设计〔公开资料〕:任务监视器(Task Monitor)让自主循环全程可视化,用户不需要中途打断"看看到哪了";澄清式前置提问把歧义在开工前消化掉,而不是做到一半回来问你。
5.3 OpenCode 居中:几乎全权限 + 完整的自测闭环
OpenCode 是 20 万+ star 的开源终端 Agent(github.com/anomalyco/opencode)〔公开资料〕。它的速度画像夹在中间,也最有意思:
内置 buildagent 默认就是全权限开发模式,本次只出现 2 次人工确认〔实测观察〕——比 QoderWork 多,比 WorkBuddy 少一个数量级;但它把时间花在了别处:交付时附带自测说明〔实测观察〕,14 分钟里有 4 分钟花在首次可运行之后的质量闭环上。
换句话说,OpenCode 用 2 次确认的低摩擦 + 一段自检时间,买了一个"交出来就基本能信"的交付。
5.4 一张表看懂归因
一个诚实的注脚〔推测〕:如果把 WorkBuddy 切到官方提供的"完全访问"模式(关闭确认流)重测,它的耗时大概率显著下降。这个推测有公开文档背书(完全访问明确会减少确认弹窗)加本次行为证据(耗时主要耗在确认等待),但本轮没有实测,只作为讨论,不当结论用。
六、三项结论
作品质量:QoderWork 97 ≳ WorkBuddy 96 > OpenCode 94。 但总分差 ≤3 分,属于小差异区间,QoderWork 和 WorkBuddy 实际是并列第一档;拉开差距的主要是视觉设计的完整度,而不是功能。
开发效率:QoderWork(9 分钟,0 确认)>> OpenCode(14 分钟,2 次确认)> WorkBuddy(20 分钟超时,约 10 次确认)。 这是本次差距最悬殊的维度。
综合可用性:本轮赢家是 QoderWork——质量第一、速度第一、零干预三项兼得。但选型要看场景:
要速度和自主性(限时任务、批量自动化):QoderWork 这类"授权边界内免打扰"的设计赢面大; 要过程可控 + 交付稳定:OpenCode 的低确认 + 自测闭环是均衡之选; 要办公安全和人在环审阅(处理重要资料、团队环境):WorkBuddy 的默认权限模式反而是最负责任的设计——它的"慢",是你为安全付的确认费。
七、这次结论的边界
每个工具只测了一次,一道题。结果只反映:这个任务(单文件前端动画)、这组配置(同为 v4.1-flash,推理设置显示不同但影响未验证)、这个时间预算(20 分钟)。总分差 ≤3 分意味着排名对环境和主观视觉项敏感;若要下更强的结论,应该换任务、做第二轮。速度差异的方向性证据(确认次数、首次可运行时间)比总分排名更稳,因为它有官方文档与行为记录双向印证。
这是「工具横评」系列第一篇,测的是编程 Agent 三强。下一期测哪个赛道——办公、写作还是设计——评论区点菜。
完整测试记录(计时日志、逐项截图、自动化检查结果)已全部存档,欢迎查证;想要原文的,评论区说一声。