ARTICLE · 1209762
ai-memory:让编程助手接力记住项目
周五,你让一个编程助手排查登录故障,试过三个方案,终于找到问题。周一换了另一个助手,它却从第一步重新猜:哪些文件不能改、什么办法失败过,都要再解释一遍。模型越来越会写代码,项目上下文却常常在换工具时断掉。这正是本轮出现在 GitHub 日榜的 ai-memory 想解决的问题。
一句话结论:把项目记忆放进可检查的文件,再让下一个助手按需读取,比指望一段聊天记录包办交接更值得尝试。
01 / 这周值得关注的是什么
这里说的是 akitaonrails/ai-memory,一个面向 AI 编程助手的开源项目,不是其他同名记忆服务。它以 Git 管理的 Markdown wiki 为记忆真源,提供检索与跨助手交接,采用 MIT 许可证。
v3.1.1 于 2026 年 10 月 17 日 18:09 UTC 发布,即北京时间 10 月 18 日凌晨 2:09。本次更新重点是可靠性与隐私修复,不能把整套记忆机制都算成本周新发明。本文以这个发布标签的文档为准。
例如,更新修复了会话结束时进程被提前终止、部分已落盘 hook 事件无法恢复的问题;也修复了部分模型提供方忽略自定义 llm_base_url 的行为。原本希望经过网关的请求可能直达厂商端点,这说明记忆工具的工程细节值得认真检查。
本轮官方日榜和周榜均已采集。热榜是发现线索的入口,滚动的 stars today 字段不等于我们独立测量的净增长,因此这里不拿它证明工具有效。
02 / 四步拆开“记住项目”
第一步是采集。编程助手的生命周期 hook 记录会话中的部分活动,再经过隐私处理形成观察记录。不同宿主能提供的事件不同,接上 MCP 也不意味着自动采集已经完整接通。
第二步是整理。会话结束后,系统把材料整理成项目 wiki 页面。Markdown 文件可以直接打开、修改和追踪版本;数据库承担派生索引,避免只有某个私有数据库能解释这些内容。
第三步是召回。新会话拿到有长度预算的简报,需要细节时再搜索。全文、实体、链接和可选向量检索共同参与召回,而不是把全部历史一股脑塞回上下文。
第四步是交接。handoff 带有明确的领取状态,让接续任务有可追踪的交接点。这里的领取约束属于交接协议,不能外推成“两个助手绝不会改到同一个文件”。
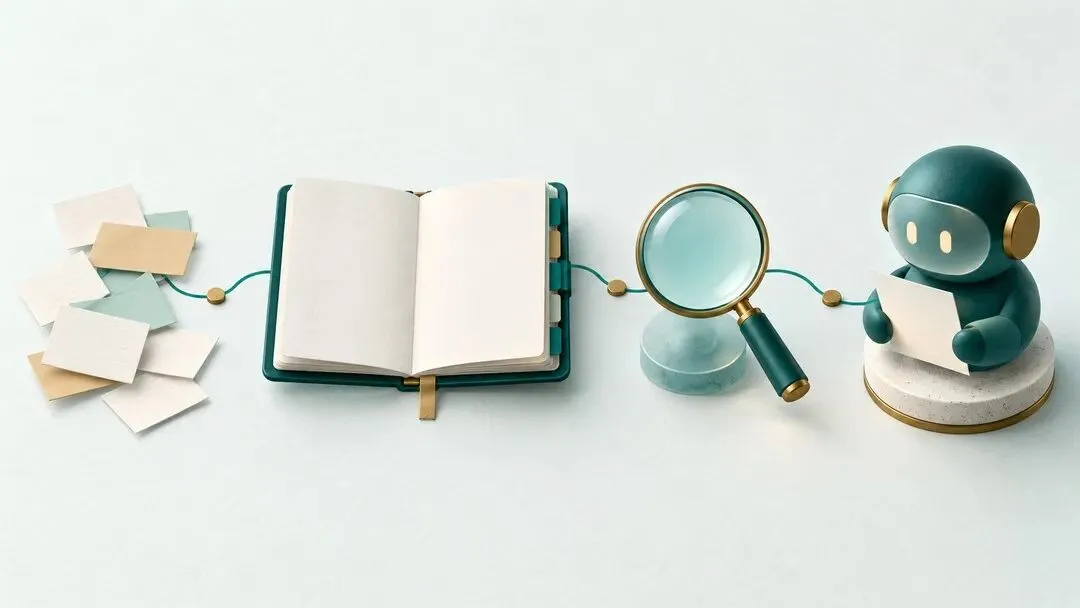
概念示意:活动经过整理成为文件化记忆,索引帮助下一次按需召回。
这套设计的价值,在我看来是把“记忆是否正确”变成一个能检查的工程问题。看到一条旧结论,可以查文件、来源和版本,再与当前代码比对。记忆仍可能过期,文件可读也不代表内容自动可信。
03 / 真正有用的交接长什么样
设想一个虚构任务:助手甲发现支付回调重复消费,确认重试入口在某个文件,尝试过一次加锁但引发超时,下一步准备检查幂等键。交接如果只写“继续修支付”,助手乙仍要重走弯路。
更有价值的记录应当包括:目标、已经确认的证据、失败方案、当前分支、尚未验证的假设,以及下一项验收。它让接手者知道先看哪里,也保留重新判断的空间。
v3.1 系列还提供可选的 ai-memory run 工作流,在同一启动机器上切换宿主时,为接手进程提供临时的原生历史材料。v3.1.1 补强了额度耗尽、旧助手来不及主动交接时的继续路径。这些历史材料仍是不可信证据,不应成为新的高优先级指令。
因此,它更适合频繁换编程助手、长任务分多次推进、需要保留失败线索的开发者。一次性的短问答,未必值得引入常驻服务和额外配置。
概念示意:接力棒代表显式交接;接手后的代码检查仍由开发流程负责。
04 / 用一个小仓库验收
以下是基于官方文档的复现路线,本轮没有安装该工具,也没有替读者修改任何助手配置。先在非敏感测试项目中尝试,并备份现有宿主配置。
到 v3.1.1 发布页选择匹配系统与架构的安装包,核对公开 SHA-256。安装好二进制后,先检查将要接入哪些宿主:
ai-memory setup \ --agent claude-code \ --agent codex \ --plan 官方说明 --plan 只展示计划,不执行接入。确认路径和范围后,再运行交互式 setup,并只选择需要的助手:
ai-memory setup \ --agent claude-code \ --agent codex 这一步会配置 MCP、hook 等集成,新安装通常还会启动用户服务,影响超出了当前仓库。完成后按提示重启宿主、确认 hook 已获信任;setup 返回成功不能替代这项检查。各宿主接入方式以支持矩阵为准。
验收可以很小:在测试仓库留下一条虚构约定、一个失败方案和一个待办,结束会话,再用另一助手询问“这个项目上次做到哪里”。要求它指出记忆来源,随后检查当前文件是否支持该结论。
再故意修改那条约定,观察旧记忆是否被识别、纠正或明确标为冲突。这个负向检查,比只看到一次“它记住了”更能帮助判断是否适合长期使用。这是本文建议的验收方法,并非已完成的测试结果。
05 / 成本和隐私要看配置
项目文档说明,默认路径不要求云端 API key,采集、检索和交接可以不调用 LLM。MIT 许可证也不等于零运行成本:服务、磁盘、备份与维护仍要计入,可选云模型会引入费用和数据传输。
特别要检查采集范围:默认并非只有带项目标记的仓库才被记录。官方提供 allowlist 模式,但应按对应宿主的 hook 路径核实生效,不能仅凭一个目录存在就放心。
本地保存也不等于静态加密。安全文档依赖操作系统文件权限保护数据;切换到云端 embedding 可能把已有页面内容送去计算向量。脱敏是尽力而为,不能保证清除所有秘密。备份或同步 wiki 时,同样需要检查内容。
助手的最终回复采集有额外开关;本地编程助手本身也可能调用云模型。因此,“记忆服务本地运行”不能推导出整个工作流都没有数据出机。
兼容性上,Linux、macOS、WSL2 与各宿主的支持深度需要分别看。原生 Windows 的发布记录与部分支持文档存在不同表述,本文不作统一的稳定性承诺。中文召回、跨宿主实际接续、长期记忆质量和真实成本,本轮均未独立验证。
06 / 留下可纠正的记忆
我更期待的变化,是团队逐渐把项目决定、失败尝试和验收证据写成可交接的资产。ai-memory 提供了一种文件化实现,但采用前仍应让它通过自己的小规模测试。
如果换一个编程助手,你最希望它记住哪一类东西:项目约束、踩坑记录,还是没做完的下一步?欢迎留言聊聊。
资料来源
1. ai-memory v3.1.1 Release|2026-10-17 UTC 发布
https://github.com/akitaonrails/ai-memory/releases/tag/v3.1.1
2. CHANGELOG|v3.1.1,2026-10-17
https://github.com/akitaonrails/ai-memory/blob/v3.1.1/CHANGELOG.md
3. 架构说明|v3.1.1 标签,2026-10-19 核查
https://github.com/akitaonrails/ai-memory/blob/v3.1.1/docs/ARCHITECTURE.md
4. 安装与接入|v3.1.1 标签,2026-10-19 核查
https://github.com/akitaonrails/ai-memory/blob/v3.1.1/docs/install.md
5. 安全边界|v3.1.1 标签,2026-10-19 核查
https://github.com/akitaonrails/ai-memory/blob/v3.1.1/SECURITY.md
6. 数据处理说明|v3.1.1 标签,2026-10-19 核查
https://github.com/akitaonrails/ai-memory/blob/v3.1.1/DATA_HANDLING.md
7. 宿主与平台矩阵|v3.1.1 标签,2026-10-19 核查
https://github.com/akitaonrails/ai-memory/blob/v3.1.1/docs/support-matrix.md