ARTICLE · 1216818
CCF软件大会2026|大模型辅助软件开发能力评测技术论坛
大模型辅助软件开发能力评测技术论坛
一、论坛介绍
软件开发是大模型应用范围最广、最具价值应用方向之一,大模型辅助开发能力评测技术是推动模型能力提升和产业健康发展的关键一环。科学规范的评测体系不仅能够发现各类模型和工具在复杂工程场景中的能力边界与薄弱环节,指导模型优化方向,减少算力资源浪费,还能够防止“唯排行榜”论导致指标失真的问题,促进模型能力的真实对比与良性竞争。
本论坛邀请了来自中国信通院、华为公司、北航、中科院计算机网络信息中心、新加坡南洋理工大学、北京硅心科技有限公司从事大模型能力评测和智能化软件开发运维的专家学者,分享AI开发能力评测体系设计、最新大模型评测结果洞察,以及在智能化软件开发运维的多种任务上对大模型和Agent进行科学评测的方法、技术以及思考。
二、论坛组织委员会
- 秦思思(中国信息通信研究院)
- 吴毅坚(复旦大学)
- 茹炳晟(腾讯研究院/复旦大学)
三、论坛安排
日程安排:
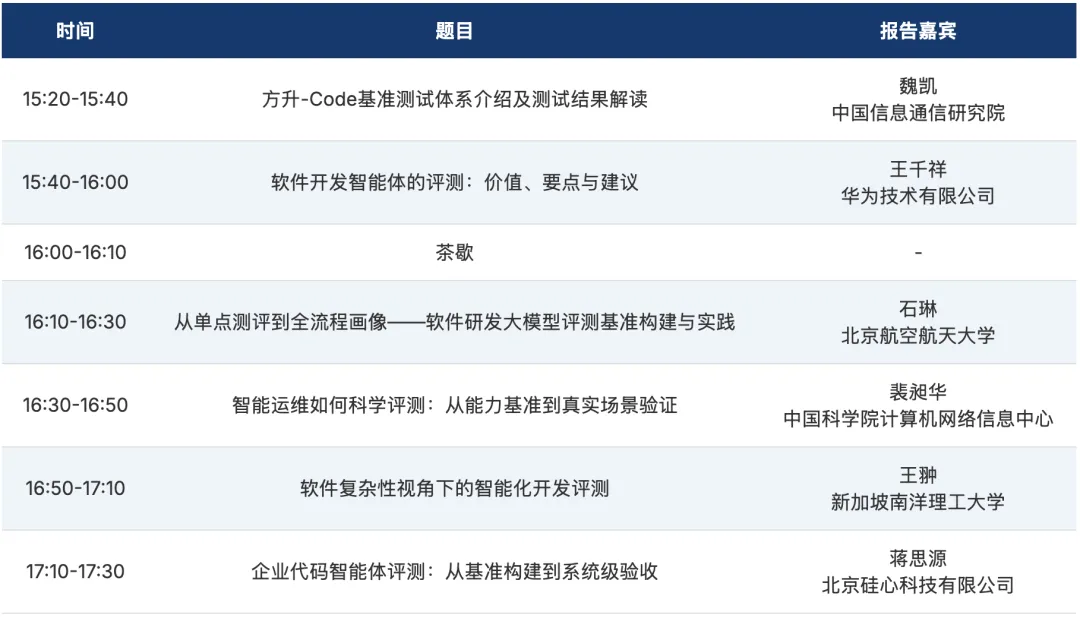
时间:2026年11月7日,15:20-18:20
地点:天津市社会山国际会议中心酒店,二层17号会议室
论坛议程:
四、论坛报告嘉宾简介
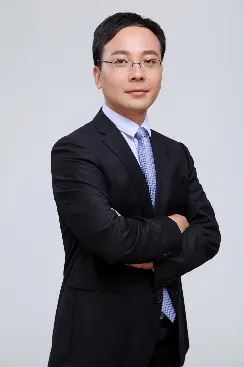
1. 报告人:魏凯 所长
题目:方升-Code基准测试体系介绍及测试结果解读
摘要:随着大模型代码能力由局部代码生成向复杂软件工程任务拓展,如何准确刻画模型能力边界、客观衡量工程可用性,成为评测体系建设的重要课题。本报告围绕"方升-Code"基准测试体系的建设思路与测试结果展开,介绍以构念清晰、任务真实、测量稳定和有效性验证为核心的评测方法,以及真实工程任务构建、难度分级与多维评价的实践。结合代码生成、代码问题解决、单元测试和研发问答等研发过程中典型任务,分析主流大模型在任务完成、代码质量、工程适配与资源消耗等方面的表现,揭示综合得分背后的能力差异、失败成因与应用局限。进一步探讨面向工程闭环的任务拓展、动态更新与模型及智能体分层评价,推动基准测试从结果排名走向能力诊断,为模型研发、工具选型与工程应用提供参考。
简介:中国信通院人工智能研究所所长,正高级工程师。工业和信息化部人工智能标准化技术委员会(MIIT/TC1)秘书长、全国网络安全标准化技术委员会人工智能组(TC260 WG9)副组长。研究方向为人工智能技术,发表论文20多篇,牵头完成40多项国内国际标准,参与多项国家重大政策文件起草。
2. 报告人:王千祥 高级技术专家
题目:软件开发智能体的评测:价值、要点与建议
摘要:首先介绍软件开发智能体的评测价值,包括测、评、估的含义,当前的学术价值、面临的挑战以及现实意义;然后分析当前评测的局限性,软件开发智能体的特点,以及需要评测的主要对象;最后对当前的评测给出若干建议。
简介:王千祥,华为公司智能化软件研发首席专家,中国计算机学会软件工程专委副主任委员,系统软件专委常务委员,开源发展技术委员会常务委员。曾任华为公司2012研发能力中心软件分析实验室主任、华为云PaaS技术创新实验室主任。加入华为之前,为北京大学计算机系教授。
3. 报告人:石琳 教授
题目:从单点测评到全流程画像——软件研发大模型评测基准构建与实践
摘要:大语言模型已全面渗透软件研发各核心环节,需求解析、架构设计、代码开发、测试运维、研发问答等场景的智能化落地呈爆发式增长,研发智能化改造已进入全面普及、快速泛滥的阶段。行业各类研发大模型层出不穷、落地场景持续扩容,但配套的评测体系却严重滞后、形成明显短板,成为制约研发AI技术迭代落地、提质增效的核心瓶颈。并且当前业界主流的大模型代码能力评测体系高度单一化、碎片化,仅聚焦基础代码生成、简单程序修复等浅层单点任务,而忽视研发场景中至关重要的复杂需求理解、全维度测试赋能、专业研发知识灵活运用等核心能力维度。整体评测工作普遍存在任务场景覆盖不全、真实工业级工程适配性不足、任务难度无标准化刻画、模型能力层级区分模糊、开放式研发任务无统一评价规范等一系列突出问题,严重制约了软件研发领域人工智能技术的规范化、高质量、规模化发展。本次报告围绕软件研发全流程的大模型能力评测需求,介绍面向需求、设计、测试及研发问答的多任务 Benchmark 构建方法与阶段性研究实践。以真实软件项目及研发过程数据为基础,结合具体代码版本与工程上下文,构建覆盖需求理解与分析、软件架构与详细设计、测试点识别与测试用例生成、研发知识理解、工程分析与问答等典型场景的分层评测任务体系;通过多维度难度建模与分级样本构造,系统刻画不同任务的工程复杂性与模型能力边界;结合结构化评价指标、自动化评分与人工校准机制,兼顾任务结果、支撑依据与求解过程,提升开放式研发任务评测的准确性、一致性与可复核性;进一步探索跨阶段任务链评测与错误传播分析,识别模型在复杂研发流程中的能力短板与关键瓶颈。
简介:石琳,北京航空航天大学软件学院教授,院长助理,空天软件智能测试北京重点实验室副主任。研究方向为智能软件工程,包括仓库级代码智能、智能需求工程、开源软件、可信AI等。在软件工程、人工智能领域的高水平国际会议ICSE,FSE,ASE等发表论文70余篇,获CCF软件工程青年科技奖,三次获杰出论文奖。主持GF基金重点项目、多项国家自然科学基金项目、企业合作项目20余项。研究成果落地华为、阿里、中国航空工业集团、招商银行等知名企业。
4. 报告人:裴昶华 副研究员,博导
题目:智能运维如何科学评测:从能力基准到真实场景验证
摘要:随着大模型与智能体技术融入运维流程,如何客观衡量智能运维系统的能力及其实际价值,成为学术研究与产业应用共同关注的问题。本报告聚焦智能运维评测,围绕异常检测、故障诊断、根因定位与处置决策等典型任务,探讨评测场景、数据集、指标体系及实验方法的设计。报告将重点讨论离线测试与真实运维环境之间的差距,以及复杂系统中评测的真实性、可复现性与结果可解释性等挑战,并分析如何将准确性、效率、成本与可靠性纳入统一的评价框架,为智能运维技术的研究、选型与落地提供参考。
简介:裴昶华,中国科学院计算机网络信息中心副研究员,博士生导师,负责国家重点研发计划青年科学家,中国科学院青年人才等项目10余项。在SIGCOMM,ICML,SIGKDD,WWW,FSE,INFOCOM等国内外顶级会议及期刊发表论文50余篇,Google Scholar总引用7500(截止2026年10月)。其中IEEE ISSRE 2025论文获得最佳论文提名奖,IEEE ISSRE 2026,2023论文获得最佳论文奖,ACM RecSys 2019论文获得Best Paper Honorable Mention Award,INFOCOM 2017论文被MIT Technology Review 和Hacker News等科技媒体报道,ACM CIKM 2019论文是CIKM历史上被引用次数最多的三篇论文之一,和字节、阶跃星星辰等产业界有密切合作,和中兴合作项目获得2025年度产学研优秀合作项目(10/130+)。
5. 报告人:王翀 博士后
题目:软件复杂性视角下的智能化开发评测
摘要:基于大模型的开发智能体在 SWE-bench 等基准上表现快速提升,但软件开发的核心挑战不只是功能正确,更在于驾驭软件系统的本质复杂性。长期演化的软件中积累了大量设计约束与权衡取舍,这些知识往往隐含在代码评审和社区讨论中。只看测试通过率的评测很难反映智能体是否真正理解并遵循了这些设计知识。本报告将从软件复杂性的视角出发,重新审视开发智能体的评测问题。报告将介绍我们近期在这一方向上的一些探索,即如何将设计权衡与决策知识引入开发智能体的评测,从而在功能正确性之外考察智能体的设计意识与设计能力。在此基础上,报告还将分享我们对基于智能体的开发能力评测的一些思考。
简介:王翀,新加坡南洋理工大学博士后研究员,2018年和2023年分别于复旦大学获得学士和博士学位。主要从事智能化软件工程研究,致力于将大模型、智能体与知识工程等技术应用于软件开发与维护,研究成果发表于ICSE、FSE、TSE、TOSEM等软件工程领域国际顶级会议和期刊。现为《Journal of Software: Evolution and Process》编委,并多次担任ICSE、FSE等国际会议程序委员会委员。曾获ACM SIGSOFT杰出论文奖、上海市计算机学会优秀博士论文奖。
6. 报告人:蒋思源 算法专家
题目:企业代码智能体评测:从基准构建到系统级验收
摘要:企业希望在真实代码库上评估大模型与编码智能体的软件开发能力,但测试覆盖不足、历史运行环境难以恢复,以及脱网条件下的依赖约束,使现有评测方法难以直接应用。本报告围绕企业研发资产如何转化为可信的评测依据,展开三个方面的讨论:首先,介绍从需求、缺陷和代码变更历史中自动构建 SWE 评测任务与可重复执行环境的方法,并分析脱网环境下的依赖准备、任务验证和评测隔离;其次,结合企业实践,讨论在历史参考修复可得、测试或执行环境缺失时,如何通过代码结构分析与行为推理开展无执行补丁评估;最后,展望从单次补丁修复走向完整应用实现的长程评测,探讨如何组合接口、数据状态和用户流程等多层行为证据进行系统验收。报告重点分析任务质量、评分有效性、迁移误差及方法的适用边界。
简介:蒋思源,硅心科技(aiXcoder)算法专家,长期从事代码模型与行业大模型研发。2020年以来,围绕代码生成、端侧部署、结构化表示、项目级上下文和推理加速,持续推进从4M到百B参数、从百亿到万亿级语料的训练实践,完成国产于英伟达大规模分布式训练、数据处理、模型蒸馏、OPD、RL和多LoRA推理系统建设。近年来聚焦垂直领域的后训练,包括通信网络、芯片设计验证、SWE与Agent专用模型,形成从数据、模型、训练到推理部署的完整技术积累。
五、论坛组织委员会简介
1. 论坛组委会:秦思思 副主任
简介:中国信息通信研究院人工智能研究所平台与工程化部副主任,中国人工智能产业发展联盟(AIIA)智能化软件工程(AI4SE)工作组组长、人工智能关键技术与应用评测工信部重点实验室的人工智能研发运营组组长。主要研究方向为智能化软件工程、大模型工程化、MLOps、MaaS、Token服务等,牵头系列标准的编制、评测等工作。
2. 论坛组委会:吴毅坚 副教授
简介:复旦大学计算与智能创新学院副教授,博士生导师,CCF软件工程专委会执行委员,上海市计算机学会软件工程专委会副主任。主要研究方向为软件演化分析、智能化软件开发、缺陷库构建和缺陷分析、软件开发质量与效能分析等。曾作为负责人承担国家863、973子课题、国家自然科学基金青年和面上项目、全军共用信息系统装备专用技术预研项目子课题、上海市科技计划项目子课题等多项国家级及省部级科研任务,承担多项企业合作研究项目,并开展成果应用。相关研究成果发表在ICSE、ISSTA、ASE、FSE、中国科学、软件学报等软件工程领域重要国际国内会议和期刊上。曾获CCF科学技术奖技术发明二等奖(2021)、ACM SIGSOFT杰出论文奖(ICPC 2022)和上海市教学成果二等奖(2009)。
3. 论坛组委会:茹炳晟 高级技术顾问
简介:茹炳晟,腾讯研究院高级技术顾问、复旦大学CodeWisdom团队首席技术专家、中国计算机学会TF多智能体系统SIG副主席、中国商业联合会互联网应用技术委员会智库专家,中国通信标准化协会TC608云计算标准和开源推进委员会云上软件工程工作组副组长、腾讯云架构师技术同盟入会主席、前腾讯集团技术委员会委员、年度IT图书最具影响力作者,三十余本技术畅销书的作者和译者,国内外各大技术峰会的联席主席,出品人和Keynote演讲嘉宾。公众号"茹炳晟聊软件研发"主理人。